

De Capacity Tier (of zoals wij het intern noemen - kaptir) werd geïntroduceerd in Veeam Backup and Replication 9.5 Update 4 onder de naam Archive Tier. Het idee hierachter is om gebruikers de mogelijkheid te bieden om back-ups te verplaatsen die buiten het zogenaamde operationele herstelvenster vallen naar objectopslag. Dit hielp gebruikers met beperkte schijfruimte om hun opslagruimte vrij te maken. Deze optie werd Move Mode genoemd.
Om deze schijnbaar eenvoudige actie uit te voeren, waren er twee voorwaarden: alle punten van de te verplaatsen back-up moesten zich buiten het eerder genoemde operationele herstelvenster bevinden, dat duidelijk in de UI is ingesteld. En ten tweede: de keten moest zich in een zogenaamde 'verzegelde staat' bevinden (sealed backup chain of Inactive Backup Chain). Dit betekent dat er in de loop van de tijd geen wijzigingen in deze keten plaatsvinden.
Maar in VBR v10 is het concept uitgebreid met nieuwe functies - Copy Mode, Sealed Mode en een item met de moeilijk uit te spreken naam Immutability.
Laten we het vandaag over deze fascinerende zaken hebben. Eerst over hoe het werkte in VBR9.5u4 en daarna over de wijzigingen in de tiende versie.
En vergeef me, aanhangers van de pure taal, maar te veel termen zijn onmogelijk te vertalen.
Dus hier zullen veel anglicismen zijn.
En veel GIF's.
En foto's.
- Zonder enige spijt. Auteur van het artikel.
Hoe het was
Laten we beginnen met het uitleggen van het operationele herstelvenster en de verzegelde back-up (of zoals ze worden genoemd in de documentatie Inactive Backup Chain). Zonder hun begrip zal verdere uitleg niet mogelijk zijn.
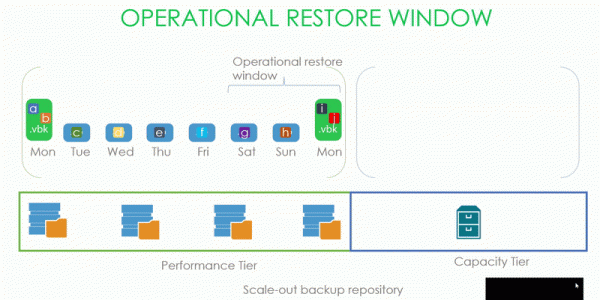
Zoals we op de afbeelding zien, hebben we een back-upketen met datablokken die zich op het Performance tier SOBR-repository bevindt, waaraan de Capacity Tier is verbonden. Ons operationele back-upvenster is drie dagen.
Bijgevolg verzegelt een op maandag gemaakte .vbk de eerdere keten, waarvan het venster op drie dagen is ingesteld. Dit betekent dat we zonder problemen alles wat ouder is dan deze drie dagen naar de Capacity Tier kunnen verplaatsen.
Maar wat werd precies bedoeld met een verzegelde keten en wat kon er naar de Capacity Tier worden gestuurd in update 4?
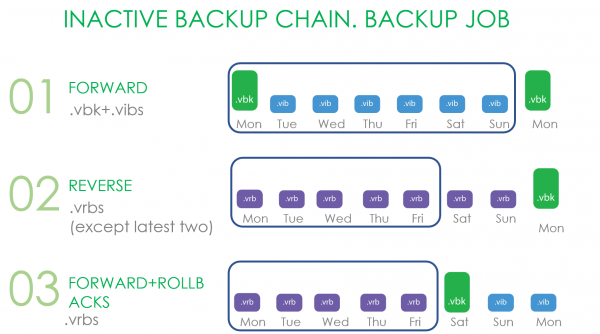
Voor Forward Incremental is de indicator voor het verzegelen van de keten de creatie van een nieuwe volledige back-up. Het maakt niet uit hoe deze volledige back-up tot stand komt: zowel synthetische volledige als actieve volledige back-ups worden meegerekend.
In het geval van Reverse zijn dit alle bestanden die niet in het operationele venster vallen.
In het geval van Forward increment met rollbacks zijn dit alle rollbacks en .vbk, als er op de performance extent nog een andere .vbk aanwezig is.
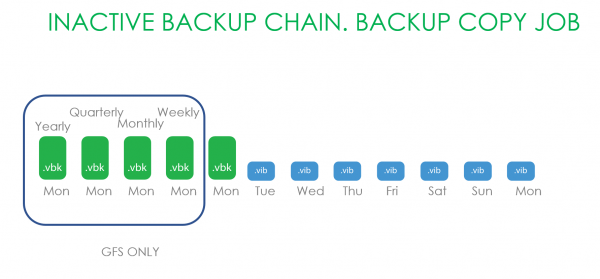
Laten we nu de werkwijze met Backup Copy-ketens bekijken. Hier werd alleen de data afgeleverd die onder GFS-retentie valt. Omdat alles wat in recentere backup copy-ketens zit, op een of andere manier kan zijn gewijzigd.
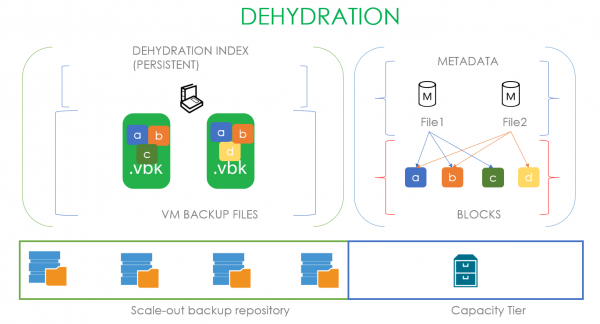
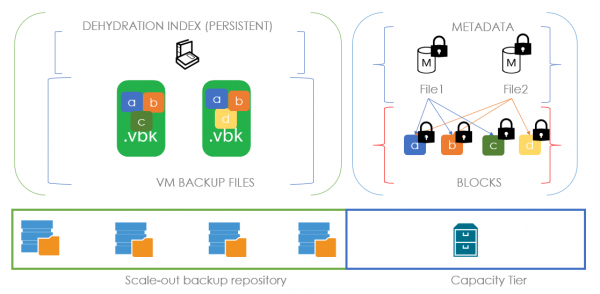
Laten we onder de motorkap kijken. Daar vindt een proces plaats dat dehydratatie wordt genoemd — het achterlaten van lege backupbestanden op de extent en het verplaatsen van blokken uit deze bestanden naar de capacity tier. Voor het optimaliseren van dit proces wordt een zogenaamde dehydratatie-index gebruikt, die ervoor zorgt dat blokken die al naar de capacity tier zijn gekopieerd, niet opnieuw worden gekopieerd.
Laten we bekijken hoe dit eruitziet aan de hand van een voorbeeld: stel dat we een .vbk hebben dat uit het operationele venster is gekomen en behoort tot een verzegelde keten. Dat betekent dat we het recht hebben om het naar de capacity tier te verplaatsen. Op het moment van verplaatsen wordt er een metadata-bestand aangemaakt in de capacity tier en worden de blokken van het verplaatste bestand verplaatst. In het metadata-bestand op het niveau van verwijzingen staat beschreven uit welke blokken ons bestand bestaat. In het geval op de afbeelding bestaat ons eerste bestand uit de blokken a, b, c en in de metadata zijn verwijzingen naar deze blokken geplaatst. Wanneer we een tweede .vbk-bestand hebben dat klaar is om te verhuizen en bestaat uit de blokken a, b en d, begrijpen we door de dehydratatie-index te analyseren dat we alleen blok d hoeven te verplaatsen. En zijn metadata-bestand zal verwijzingen naar de twee eerdere blokken en één nieuw blok bevatten.
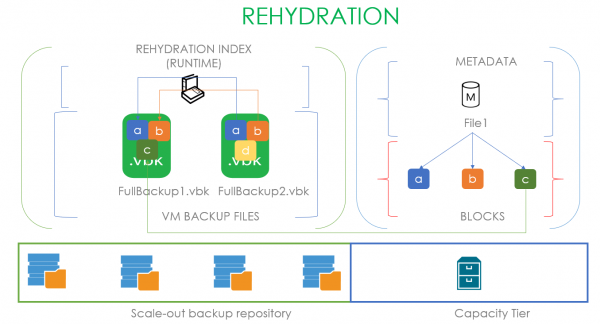
Het proces van het opnieuw vullen van deze lege blokken met gegevens wordt rehydratatie genoemd. Hier wordt al een eigen rehydratatie-index gebruikt, die gebaseerd is op het oudste .vbk-bestand op de lokale performance extent. Dit betekent dat als een gebruiker een bestand uit de capacity tier wil terughalen, we eerst een index van de blokken van de oudste volledige backup aanmaken en alleen de ontbrekende blokken uit de capacity tier verplaatsen. In het geval dat op de afbeelding wordt getoond, om FullBackup1.vbk te rehydratatie volgens de rehydratatie-index, missen we alleen blok C, dat we uit de capacity tier halen. Als de capacity tier wordt uitgevoerd door cloud object storage, kan dit aanzienlijke kostenbesparingen opleveren.
Het kan lijken alsof deze technologie identiek is aan die gebruikt in WAN Accelerators, maar dat is slechts schijn. In accelerators is de deduplicatie globaal, hier daarentegen wordt lokale deduplicatie binnen elk bestand gebruikt op basis van een specifieke offset. Dit komt voort uit de verschillende taken die moeten worden opgelost: we moeten grote back-upbestanden kopiëren, en uit ons onderzoek blijkt dat zelfs als er een lange periode tussen zit, deze deduplicatie-algoritme betere resultaten oplevert.
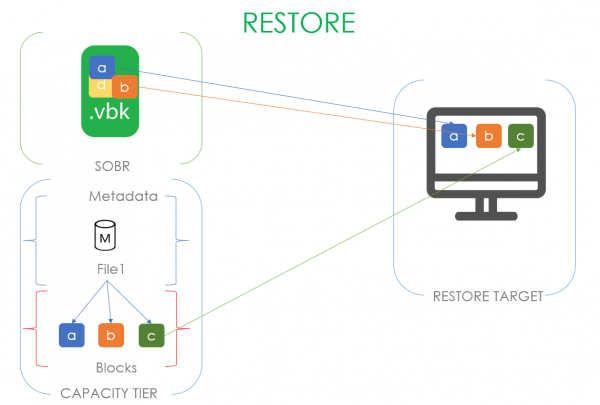
Maar er zijn meer indexen dan alleen indexen! Er is ook een index voor gegevensherstel! Wanneer we een herstel van een machine uitvoeren die in een capaciteit-tier ligt, lezen we alleen unieke datablocks die niet in de performance-tier zijn.
Hoe het geworden is
Dat was het voor het inleidende gedeelte. Het is vrij gedetailleerd, maar zoals eerder gezegd, zonder deze details kunnen we niet uitleggen hoe de nieuwe functies werken. Dus zonder verdere inleidingen, gaan we naar de eerste.
Kopiemodus
Is voor een groot deel gebaseerd op bestaande technologieën, maar heeft een totaal andere logica van gebruik.
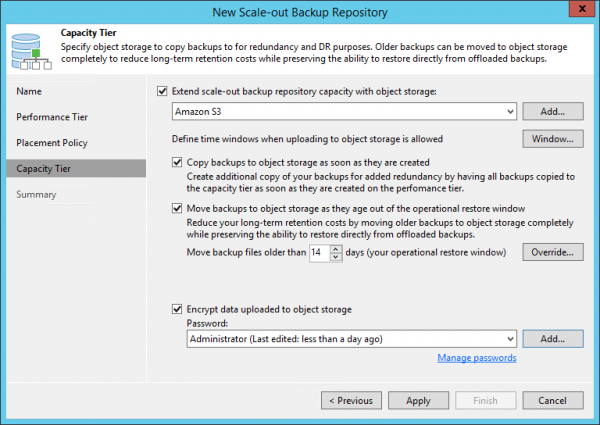
Het doel van deze modus is om te garanderen dat alle gegevens op de lokale extent een kopie hebben in de capaciteit-tier.
Als we de Move- en Copy-modus rechtstreeks vergelijken, ontstaat het volgende:
- Je kunt alleen een verpakte keten verplaatsen. In het geval van de kopiemodus wordt alles vervoerd, ongeacht wat er in de back-up job gebeurt.
- Verplaatsen gebeurt wanneer bestanden de grenzen van het operationele back-upvenster overschrijden, terwijl kopiëren onmiddellijk gebeurt zodra er een back-upbestand beschikbaar is.
- Nieuwe gegevens voor kopiëren worden continu gevolgd, terwijl verplaatsen eens in de 4 uur werd uitgevoerd.
Bij de overweging van de nieuwe modus stel ik voor eenvoudig voorbeeldmateriaal te gebruiken en geleidelijk aan naar complexere voorbeelden over te gaan.
In het meest basale geval komen er gewoon nieuwe bestanden met incrementele wijzigingen, en kopiëren we deze naar de capaciteit-tier. Dit ongeacht welke modus wordt gebruikt in de back-up job, ongeacht of deze tot het verpakte deel van de keten behoort of niet, en ongeacht of onze operationele venster is verlopen. Gewoon genomen en gekopieerd.
Het proces erachter is nog steeds dehydratie zoals hierboven beschreven. In de kopieermodus zorgt het er ook voor dat we geen blokken kopiëren die al op onze opslag zitten. Het enige verschil is dat we in de verplaatsingsmodus echte bestanden vervingen door lege bestanden, terwijl we ze hier helemaal met rust laten en alles zo laten als het is. Verder is dit precies dezelfde dehydratie-index die zorgvuldig probeert uw geld en tijd te besparen.
De vraag komt op — als we naar de UI kijken, is er de mogelijkheid om beide opties tegelijkertijd te kiezen. Hoe zal zo'n gecombineerde modus werken?
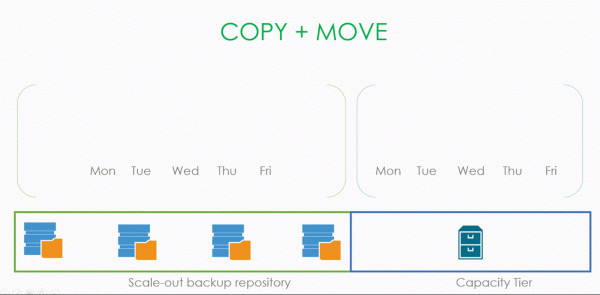
Laten we dit uitzoeken.
Het begin is standaard: er wordt een back-upbestand aangemaakt en onmiddellijk gekopieerd. Er wordt een incrementele back-up gemaakt en ook gekopieerd. Dit gaat door totdat we begrijpen dat de bestanden buiten ons operationele venster zijn geraakt en er een verzegelde keten is ontstaan. Op dat moment voeren we de dehydratie-operatie uit en vervangen we deze bestanden door lege bestanden. Uiteraard kopiëren we niets opnieuw naar de capaciteitstier.
Voor al deze fascinerende logica is er slechts één vinkje in de interface: Copy backups to object storage as soon as they are created.
Waarom hebben we deze Copy-modus nodig?
Het is beter de vraag zo te herformuleren — van welke risico's beschermen we ons ermee? Welk probleem helpt het ons op te lossen?
Het antwoord is vanzelfsprekend: natuurlijk is het dataverlies. Als we een volledige kopie van de lokale gegevens op object storage hebben, maakt het niet uit wat er met onze productieomgeving gebeurt, we kunnen altijd de gegevens herstellen van de bestanden die zich in de veronderstelde Amazon bevinden.
Laten we daarom de mogelijke scenario's doornemen, van het meest eenvoudige tot het meer complexe.
De eenvoudigste tegenslag die ons kan overkomen, is de onbeschikbaarheid van een van de bestanden in de back-upketen.
Een triestiger verhaal is dat een van de extents van onze SOBR-repository kapot is gegaan.
Het wordt nog erger wanneer de hele SOBR-repository niet meer toegankelijk is, maar de capaciteitstier nog steeds werkt.
En het is helemaal erg als de backupserver faalt en je eerste verlangen is om in tien minuten naar de Canadese grens te rennen.
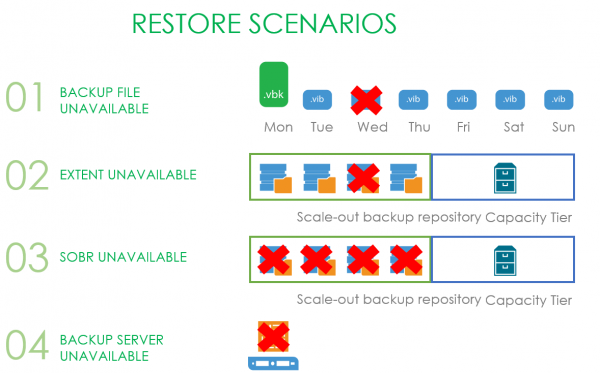
Laten we nu elke situatie afzonderlijk bekijken.
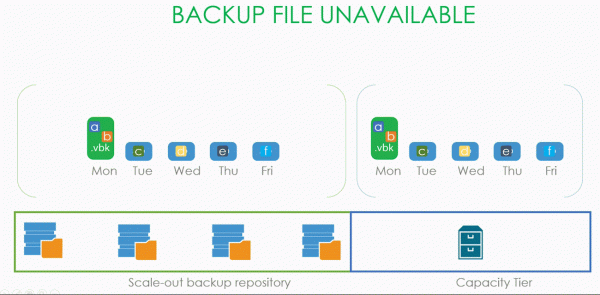
Wanneer we één (ja, zelfs meerdere) back-upbestanden verliezen, hoeven we alleen het herkansingsproces van de repository te starten, en het verloren bestand zal worden vervangen door een leeg bestand. En met behulp van het rehydratatieproces (waarover in het begin van het artikel werd gesproken) kan de gebruiker gegevens uit de capaciteitslaag naar de lokale opslag downloaden.
De situatie is nu ingewikkelder. Stel dat onze SOBR bestaat uit twee extents die in de Performance-modus werken, wat betekent dat onze .vbk en .vib nogal ongelijkmatig over hen zijn verspreid. En op een bepaald moment wordt een van de extents onbereikbaar, terwijl de gebruiker snel de machine moet herstellen waarvan een deel van de gegevens zich precies op deze extent bevindt.
De gebruiker start de herstelwizard, kiest het punt waarop hij wil herstellen, en terwijl de wizard werkt, beseft deze dat niet alle benodigde gegevens voor herstel lokaal bij hem aanwezig zijn, en dus moeten deze worden gedownload uit de capaciteitslaag. De blokken die nog op de lokale opslag staan, zullen niet vanuit de cloud worden gedownload. Loof de restore-index (ja, daarover werd ook in het begin van het artikel gesproken).
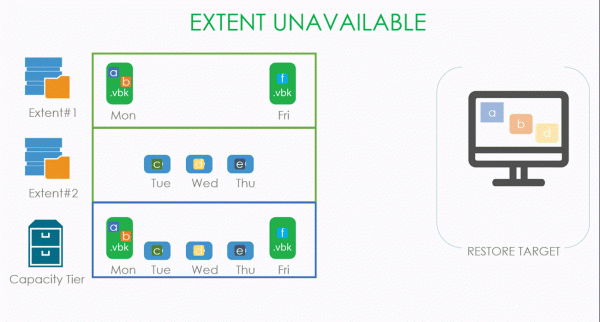
Een sub-type van deze situatie is wanneer de hele SOBR-repository onbereikbaar wordt. In dat geval hebben we niets te kopiëren van lokale opslag en worden alle blokken vanuit de cloud gedownload.
En de meest interessante situatie is wanneer de back-upserver is uitgevallen. Hier zijn twee opties: de admin is een goede en heeft configuratie-back-ups gemaakt, of de admin is zelf een boosaardige Pinokkio en heeft geen configuratie-back-up gemaakt.
In het eerste geval is het voldoende om ergens een schone installatie van VBR uit te rollen en zijn database te herstellen vanuit de back-up met behulp van de standaardtools. Aan het einde van dit proces zal alles weer terugkomen zoals het was. Of het wordt hersteld volgens een van de eerdere scenario's.
Maar als de beheerder of zichzelf vijand is, of de back-upconfiguratie de legendarische mislukking heeft gehad, zullen wij hem hier niet aan zijn lot overlaten. Voor dit geval hebben we een nieuwe procedure ingevoerd, genaamd Import Object Storage. Hiermee kan het handmatige proces van het reconstrueren van de SOBR-repository en het koppelen van de capaciteit naar een TIR worden overgeslagen, en in plaats daarvan kan object storage eenvoudig aan de VIMA-interface worden toegevoegd en kan de procedure Import Storage Repository worden gestart. Het enige dat tussen u en uw back-ups kan komen, is het verzoek om een wachtwoord in te voeren, als uw back-ups zijn versleuteld.
Dat was het dan voor de Copy Mode, en we gaan verder met
Sealed Mode
Het belangrijkste idee is dat er in de geselecteerde extent van de SOBR-repository geen nieuwe back-ups kunnen worden gemaakt. Tot v10 hadden we alleen Maintenance Mode, waarbij alle werkzaamheden met de repository volledig verboden waren. Een soort van hardcore modus voor het offline halen van de opslag, waar alleen de knop Evacuate beschikbaar was, om tijdelijk back-ups naar een andere extent te verplaatsen.
Sealed mode is een soort 'zachte' versie: we verbieden het maken van nieuwe back-ups en verwijderen geleidelijk oude volgens de geselecteerde retentie, maar verliezen in het proces de mogelijkheid niet om te herstellen uit de opgeslagen punten. Een zeer nuttig ding, wanneer de levensduur van de hardware ten einde loopt en deze moet worden vervangen, of wanneer deze gewoon moet worden vrijgemaakt voor iets belangrijkers, en het niet mogelijk is om alles in één keer te verplaatsen. Of het kan niet worden verwijderd.
Het principe van werking is daarom vrij eenvoudig: alle schrijfoperaties moeten worden verboden (het verschijnen van nieuwe gegevens), terwijl lees- (herstels) en verwijder- (retentie) operaties zijn toegestaan.
Beide modi kunnen gelijktijdig worden gebruikt, maar het moet worden opgemerkt dat Maintenance prioriteit heeft.
Laten we als voorbeeld een SOBR overwegen, bestaande uit twee extents. Stel je voor dat we de eerste vier dagen back-ups hebben gemaakt in de modus Forward Forever Incremental, en daarna verzegelen we de extent. Dit leidt ertoe dat we de creatie van een nieuwe actieve full op de tweede beschikbare extent initiëren. Als onze retentie vier is, dan wanneer de hele keten op de verzegelde extent zijn termijn overschrijdt, wordt deze met een schoon geweten verwijderd.
Er zijn situaties waarin verwijdering eerder plaatsvindt. Bijvoorbeeld, dit is het geval bij Forward incremental met periodieke full backups. Als we de eerste twee dagen full backups hebben gemaakt en op donderdag besluiten we het repository te sluiten, dan zal op vrijdag, wanneer er een nieuwe full backup wordt gemaakt, het bestand van maandag worden verwijderd omdat er geen afhankelijkheden zijn van dat punt. En dat punt zelf is van niemand afhankelijk. Daarna wachten we tot er vier punten zijn gemaakt op de beschikbare extent en verwijderen we de overige drie, die onafhankelijk van elkaar niet kunnen worden verwijderd.
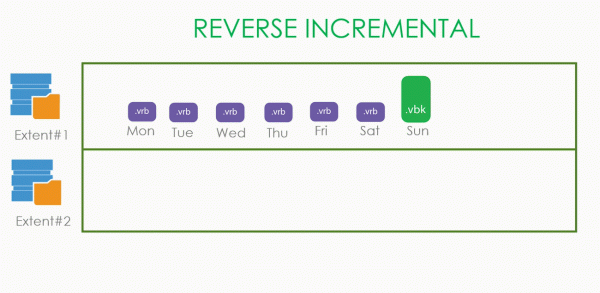
Het is eenvoudiger bij Reverse Incremental. Daar hangen de oudste punten nergens van af en kunnen ze eenvoudig worden verwijderd. Dus, zodra er een nieuwe .vbk op een nieuwe extent is gemaakt, zullen de oude .vrb één voor één worden verwijderd.
Overigens, waarom maken we steeds een nieuwe .vbk aan: als we deze niet zouden maken en de oude reeks incrementals zouden voortzetten, zou de oude .vbk eindeloos vast blijven zitten in welke toestand dan ook, waardoor verwijdering werd verhinderd. Daarom werd besloten dat zodra een extent wordt afgesloten, we een full backup maken op een vrije extent.
Bij capacity tier is het ingewikkelder.
Laten we eerst de copy mode bekijken. Stel dat we vier dagen actief backups hebben gemaakt en daarna de capacity tier is afgesloten. We verwijderen niets, maar wachten geduldig op de retentie, waarna we de gegevens van de capacity tier verwijderen.
Ongeveer hetzelfde gebeurt bij move mode — we wachten de retentie af, verwijderen het oude in de lokale opslag, verwijderen wat in de object storage is opgeslagen.
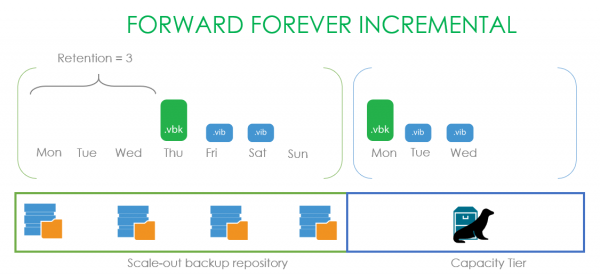
Een interessant voorbeeld betreft Forever forward incremental. We stellen de retentie in op drie punten en beginnen op maandag met het maken van backups, die trouw naar de cloud worden gekopieerd. Na het afsluiten van de opslag blijven de backups worden gemaakt, met behoud van drie punten, maar de gegevens opgeslagen in de capacity tier blijven afhankelijk en kunnen niet worden verwijderd. Daarom wachten we tot donderdag, wanneer onze .vbk de retentie overschrijdt, en pas dan verwijderen we de gehele opgeslagen keten.
En een kleine opmerking: alle voorbeelden hier zijn gegeven met één machine. Als je er meerdere in de backup hebt, zal de retentie verschillen afhankelijk van of er een Active Full is gemaakt of niet.
In principe is dat alles. Laten we nu overgaan naar de meest hardcore functie —
Immutability
Zoals met de vorige punten, laten we eerst bespreken welk probleem deze functie oplost. Zodra we onze back-ups ergens voor opslag exporteren, komt er een sterke wens om hun integriteit te waarborgen, dat wil zeggen, fysiek te verhinderen dat ze worden verwijderd of op enige manier worden gewijzigd tijdens de vastgestelde retentieperiode. Dit geldt ook voor beheerders, ook onder hun root-accounts. Dit helpt hen te beschermen tegen per ongeluk of opzettelijk kwaad. Wie met AWS werkt, kan dergelijke functies tegenkomen onder de naam Object Lock.
Laten we nu de modus in grote lijnen bespreken, en daarna in detail ingaan. In ons voorbeeld wordt Immutability ingeschakeld voor onze capaciteitstier met een retentieperiode van vier dagen. En in de back-up is de modus Kopiëren ingeschakeld.
Immutability heeft geen interactie met de algemene retentie. Bijvoorbeeld, het voegt geen extra punten of iets dergelijks toe. Gewoonlijk kan iemand gedurende vier dagen de back-upbestanden niet verwijderen. Als er op maandag een back-up wordt gemaakt, kan het bestand pas op vrijdag worden verwijderd.
Alle eerder uitgelegde concepten van dehydratie, indexen en metadata blijven precies hetzelfde functioneren. Maar met één voorwaarde: de blokkering wordt niet alleen voor de gegevens ingesteld, maar ook voor de metadata. Dit is gedaan voor het geval dat een slinkse aanvaller besluit onze metadata-database te wissen, zodat de datablokken niet in nutteloze binaire rommel veranderen.
En nu is het een uitstekend moment om onze block generation-technologie uit te leggen. Laten we hiervoor de situatie bekijken die heeft geleid tot de ontwikkeling ervan.
Laten we een tijdlijn van zes dagen nemen en onderaan de verwachte eindtijd van de immutability markeren. We creëren op de eerste dag een bestand dat bestaat uit datablok a en de bijbehorende metadata. Als de immutability is ingesteld op drie dagen, is het logisch aan te nemen dat op de vierde dag de gegevens ontgrendeld en verwijderd zullen worden. Op de tweede dag voegen we een nieuw bestand bestand2 toe, dat bestaat uit blok b met dezelfde instellingen. Blok a moet op de vierde dag nog steeds worden verwijderd. Maar op de derde dag gebeurt er iets ergs — er wordt een bestand Bestandsnaam3 aangemaakt, dat bestaat uit een nieuw blok d en een verwijzing naar het oude blok a. Dit betekent dat het immutability-vlag voor blok a opnieuw moet worden ingesteld op een nieuwe termijn, die naar de zesde dag verschuift. En hier ontstaat het probleem — in echte backups van dergelijke blokken ontstaat er een enorme hoeveelheid. En om hun immutability-periode te verlengen, moet bij elke keer enorm veel verzoeken worden gedaan. En feitelijk wordt dit een vrijwel eindeloos dagelijks proces, omdat we met een grote waarschijnlijkheid bij elke kopieeractie enorme stapels gededupliceerde blokken zullen vinden. En wat betekent een grote hoeveelheid verzoeken voor object storage providers? Juist! Een enorme rekening aan het einde van de maand.
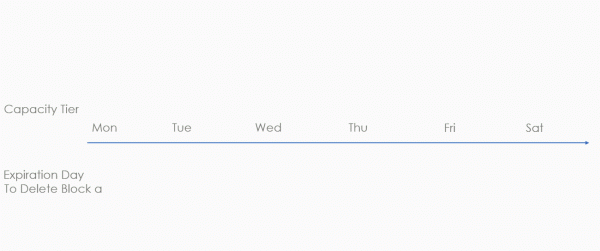
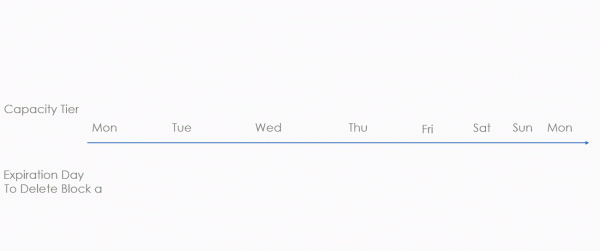
En om niet zomaar een hoop geld te vragen van onze geliefde klanten, is er een mechanisme voor block generation uitgevonden. Dit is een extra periode die we toevoegen aan de vastgestelde immutability-periode. In het onderstaande voorbeeld is deze periode twee dagen. Maar dit is alleen ter illustratie. In de praktijk wordt er een eigen formule gebruikt die ongeveer tien extra dagen geeft bij een maandelijkse lock.
Laten we dezelfde situatie bekijken, maar nu met block generation. Op de eerste dag creëren we file1 uit blok a en metadata. We stapelen de generatieperioden en immutability — dit betekent dat de mogelijkheid om het bestand te verwijderen er pas op de zesde dag is. Als we op de tweede dag File2 aanmaken, bestaande uit blok b en een link naar blok a, dan verandert de verwachte verwijderdatum niet. Die blijft op de zesde dag staan. We proberen op deze manier kosten te besparen op het aantal aanvragen. De enige situatie waarin de termijn kan worden verschoven, is als de generatieperiode is verstreken. Dit betekent dat als op de derde dag nieuwe File3 een link naar blok a bevat, generatie 2 zal worden toegevoegd omdat Gen1 al verlopen is. De verwachte verwijderdatum van blok a verschuift dan naar de achtste dag. Dit stelt ons in staat om het aantal verzoeken voor het verlengen van de levensduur van deduplicated blocks dramatisch te verminderen, wat aanzienlijke kostenbesparingen voor klanten oplevert.
De technologie zelf is beschikbaar voor gebruikers van S3 en S3-compatibele hardware, waarvan de fabrikanten garanderen dat hun implementatie niet verschilt van de Amazons. Vandaar het legitieme antwoord op de vraag waarom Azure niet wordt ondersteund — zij hebben een vergelijkbare functie, maar deze werkt op het niveau van containers in plaats van op afzonderlijke objecten. Overigens is er bij Amazon zelf object lock in twee modi: compliance en governance. In het tweede geval is het nog steeds mogelijk dat de grootste admin boven de admins en root boven roots, ondanks object lock, de gegevens alsnog verwijdert. In het geval van compliance is alles stevig vastgenageld en kan niemand back-ups verwijderen. Zelfs nicht eens de Amazon admins (volgens hun officiële verklaringen). Wij ondersteunen juist deze modus.
En, traditioneel, een paar nuttige links:
- Over in detail.
- Alle informatie over op zijn best
- groot aantal partitions. in detail
Bron: habr.com
