

Tegenwoordig zijn er 100500 cursussen in Data Science en het is al lang bekend dat je het meeste geld kunt verdienen in Data Science met cursussen in Data Science (waarom graven als je schoppen kunt verkopen?). Het grootste nadeel van deze cursussen is dat ze niets te maken hebben met het echte werk: niemand zal je schone, verwerkte gegevens in het juiste formaat geven. En wanneer je van de cursussen komt en echte problemen begint op te lossen, komen er veel nuances naar boven.
Daarom beginnen we een serie artikelen "Wat kan er misgaan met Data Science", gebaseerd op echte gebeurtenissen die mij, mijn vrienden en collega's zijn overkomen. We zullen typische Data Science-taken aan de hand van echte voorbeelden analyseren: hoe het er in werkelijkheid aan toe gaat. We beginnen vandaag met de taak van gegevensverzameling.
En het eerste waar mensen over struikelen wanneer ze met echte gegevens gaan werken, is de eigenlijke verzameling van de relevante gegevens. De belangrijkste boodschap van dit artikel is:
We onderschatten systematisch de tijd, middelen en moeite die nodig zijn voor het verzamelen, opschonen en voorbereiden van gegevens.
En bovenal, we zullen bespreken wat je kunt doen om dit te voorkomen.
Volgens verschillende schattingen nemen opschoning, transformatie, data processing, feature engineering, enz. 80-90% van de tijd in beslag, terwijl analyse slechts 10-20% vergt, terwijl praktisch al het studiemateriaal zich uitsluitend richt op analyse.
Laten we een typische analytische taak in drie varianten bekijken en zien welke "verzwarende omstandigheden" er zijn.
En als voorbeeld zullen we wederom vergelijkbare variaties van de gegevensverzamelingstaak en het vergelijken van gemeenschappen bekijken voor:
- Twee subreddits van Reddit
- Twee secties van Habr
- Twee groepen van Odnoklassniki
De hypothetische aanpak in theorie
Open de website en lees bijvoorbeeld de voorbeelden. Als het begrijpelijk is, plan dan een paar uur in voor het lezen, een paar uur voor de code op basis van de voorbeelden en debugging. Voeg een paar uur toe voor de verzameling. Voeg een paar uur extra toe (vermenigvuldig met twee en tel N uren erbij op).
Het belangrijkste punt is: de tijdsinschatting is gebaseerd op aannames en gissingen over hoeveel tijd dit zal kosten.
Begin met het analyseren van de tijd door de volgende parameters voor de hypothetische taak hierboven te schatten:
- Wat is de grootte van de gegevens en hoeveel moet daarvan fysiek verzameld worden (*zie hieronder*).
- Hoeveel tijd kost het om één record te verzamelen en hoe lang moet je wachten voordat je het tweede kunt verzamelen.
- Leg de code vast die de staat behoudt en opnieuw begint wanneer (en niet als) alles faalt.
- Bepaal of we authenticatie nodig hebben en reken de tijd voor toegang via de API.
- Leg het aantal fouten vast als een functie van de datacomplexiteit — beoordeel dit op basis van de specifieke taak: structuur, hoeveel transformaties, wat en hoe we extraheren.
- Neem netwerkfouten en problemen met onconventioneel gedrag van het project op.
- Beoordeel of de benodigde functies in de documentatie staan en als dat niet zo is, hoe en hoeveel er nodig is voor een workaround.
Het belangrijkste punt is dat je voor het inschatten van de tijd daadwerkelijk tijd en moeite moet besteden aan ‘verkenning op de bodem’ — alleen dan zal je planning adequaat zijn. Dus hoe vaak je ook wordt gevraagd te zeggen ‘hoeveel tijd is er nodig voor het verzamelen van gegevens’ — reserveer tijd voor een voorlopige analyse en argumenteer dat de tijd zal variëren afhankelijk van de werkelijke parameters van de taak.
En nu zullen we specifieke voorbeelden tonen waarin dergelijke parameters zullen veranderen.
Een sleutelpunt: de schatting is gebaseerd op de analyse van de belangrijkste factoren die van invloed zijn op de omvang en complexiteit van het werk.
Een schatting op basis van giswerk is een goede benadering wanneer de functionele elementen klein genoeg zijn en er niet veel factoren zijn die de structuur van de taak aanzienlijk kunnen beïnvloeden. Maar in het geval van verschillende Data Science-taken worden er zoveel factoren betrokken dat deze benadering niet meer adequaat wordt.
Vergelijking van gemeenschappen op Reddit
Laten we beginnen met het eenvoudigste geval (zoals later zal blijken). Over het algemeen, als we heel eerlijk zijn, hebben we hier praktisch een ideaal geval, laten we onze checklist van complexiteit controleren:
- Er is een nette, duidelijke en gedocumenteerde API.
- Er is bijna geen moeite voor, en het is belangrijk dat de token automatisch wordt verkregen.
- Er is — met veel voorbeelden.
- De gemeenschap die zich bezighoudt met analyse en gegevensverzameling op Reddit (tot zelfs YouTube-video's die uitleggen hoe je de python wrapper gebruikt) .
- De methoden die we nodig hebben, bestaan waarschijnlijk in de API. Bovendien ziet de code er compact en schoon uit, hieronder een voorbeeld van een functie die opmerkingen verzamelt voor een post.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Gehaald uit een selectie van handige hulpprogramma's voor wrappers.
Hoewel we hier met de beste situatie voor ons staan, zijn er toch een aantal belangrijke factoren uit de echte wereld om rekening mee te houden:
- API-limieten — we zijn genoodzaakt om gegevens in batches op te halen (en tussen verzoeken te wachten, etc.).
- Verzameltijd — voor een volledige analyse en vergelijking moet er aanzienlijke tijd worden ingepland om de spider door de subreddit te laten lopen.
- De bot moet op een server draaien — je kunt hem niet gewoon op je laptop starten, in je rugzak stoppen en verder gaan met je zaken. Daarom draai ik alles op een VPS. Met de promokode habrahabr10 kun je nog eens 10% op de kosten besparen.
- Fysieke onbereikbaarheid van bepaalde gegevens (ze zijn zichtbaar voor beheerders of zijn te moeilijk te verzamelen) — dit moet in overweging worden genomen; niet alle gegevens kunnen binnen redelijke tijd worden verzameld.
- Netwerkfouten: werken met netwerken is pijnlijk.
- Dit zijn echte, levende gegevens — ze zijn nooit schoon.
Natuurlijk moeten deze nuances in de ontwikkeling worden meegenomen. Specifieke uren/dagen zijn afhankelijk van de ervaring met ontwikkeling of ervaring met soortgelijke taken; desalniettemin zien we dat deze taak uitsluitend engineeringtechnisch is en geen extra inspanningen zou vereisen voor de oplossing — het kan allemaal zeer goed worden ingeschat, uitgeschreven en uitgevoerd.
Vergelijking van de secties van Habr
Laten we overgaan naar een interessanter en minder triviaal geval: het vergelijken van stromen en/of secties van Habr.
Laten we onze checklist voor complexiteit controleren — hier, om elk punt te begrijpen, moet je al een beetje aan de taak zelf knoeien en experimenteren.
- In het begin denk je dat er een API is, maar die is er niet. Ja, Habr heeft een API, maar deze is alleen niet toegankelijk voor gebruikers (en werkt misschien helemaal niet).
- Daarna begin je gewoon HTML te parsen — 'import requests', wat kan er misgaan?
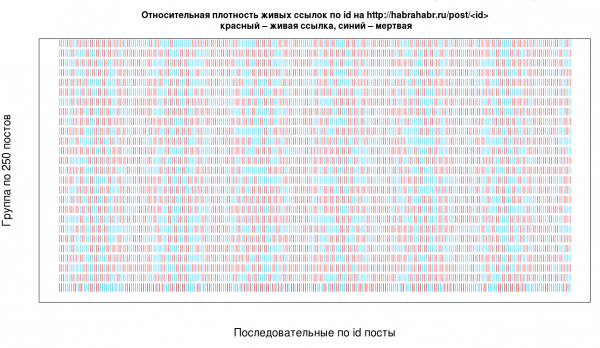
- En hoe parse je eigenlijk? De eenvoudigste en meest gebruikte aanpak is itereren over ID's; laten we opmerken dat dit niet de meest efficiënte methode is en dat we met verschillende gevallen rekening moeten houden — ter illustratie de dichtheid van echte ID's onder alle bestaande.

Gehaald uit van het artikel gaan. - Ruwe gegevens, verpakt in HTML over het netwerk, zijn een probleem. Stel je voor, je wilt de beoordeling van een artikel verzamelen en opslaan: je hebt de score uit de HTML gehaald en besloot deze als een getal op te slaan voor verdere verwerking.
1) int(score) geeft een foutmelding: omdat op Habr het minteken, zoals in de regel "–5", een kort streepje is en geen minteken (verrassend, toch?), moest op een gegeven moment de parser weer tot leven worden gebracht met zo'n verschrikkelijke fix.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
Er kunnen helemaal geen datums, plus- of mintekens zijn (zoals we hierboven in de functie check_date zien).
2) Ongescapte speciale tekens – ze zullen komen, je moet er klaar voor zijn.
3) De structuur verandert afhankelijk van het type bericht.
4) Oude berichten kunnen een **vreemde structuur** hebben.
- Eigenlijk moet je de foutenafhandeling en wat er kan of niet kan gebeuren beheren, en je kunt niet met zekerheid voorspellen wat er mis zal gaan of hoe de structuur eruit kan zien en waar iets zal wegvallen – je zult gewoon moeten proberen en de fouten in rekening moeten brengen die de parser geeft.
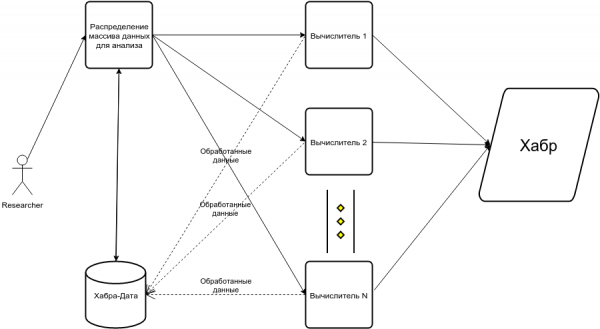
- Dan besef je dat je in meerdere threads moet parseren, anders duurt een een-threadige pars ongeveer 30+ uur (dat is puur de uitvoertijd van een werkende een-threadige parser, die slaapt en niet onder eventuele bans valt). In het artikel leidde dat op een gegeven moment tot een dergelijk schema:
Dus hier is een checklist qua moeilijkheidsgraad:
- Werken met het netwerk en het parseren van HTML met iteratie en synchronisatie op ID.
- Documenten met een heterogene structuur.
- Vele plaatsen waar de code gemakkelijk kan falen.
- Het is noodzakelijk om || code te schrijven.
- De benodigde documentatie, voorbeelden van de code en/of gemeenschappen ontbreken.
De geschatte tijd voor deze taak zal 3-5 keer hoger zijn dan voor het verzamelen van gegevens van Reddit.
Vergelijking van groepen van Odnoklassniki
Laten we overgaan naar het technisch interessantste geval dat is beschreven. Voor mij was het interessant omdat het op het eerste gezicht vrij triviaal lijkt, maar dat helemaal niet is – zodra je er met een stokje naar wijst.
Laten we beginnen met onze checklist voor moeilijkheidsgraad en opmerken dat veel van hen veel moeilijker blijken te zijn dan ze in het begin lijken:
- De API is beschikbaar, maar er ontbreken bijna volledig de benodigde functies.
- Voor bepaalde functies moet je toegang per e-mail aanvragen, dat wil zeggen dat toegang niet onmiddellijk wordt verleend.
- Het is verschrikkelijk gedocumenteerd (om te beginnen worden overal Russische en Engelse termen door elkaar gebruikt, en dat volstrekt inconsistent — soms moet je gewoon raden wat er ergens van je verwacht wordt) en bovendien is het qua ontwerp niet geschikt voor het verkrijgen van gegevens, bijvoorbeeld, .
- Vereist sessies in de documentatie, maar in de praktijk wordt deze niet gebruikt — en er is geen manier om de nuances van de API-modi te begrijpen, behalve op goed geluk klikken en hopen dat iets zal werken.
- Er ontbreken voorbeelden en de gemeenschap, het enige aanknopingspunt voor informatieverzameling is een kleine in Python (zonder veel gebruiksvoorbeelden).
- De meest werkbare optie lijkt Selenium te zijn, omdat veel benodigde gegevens onder slot en grendel staan.
1) Dat wil zeggen, er is autorisatie via een fictieve gebruiker (en registratie met de hand).2) Echter, met Selenium zijn er geen garanties voor correcte en herhaalbare werking (in elk geval met ok.ru precies).
3) De site Ok.ru bevat JavaScript-fouten en gedraagt zich soms vreemd en inconsistent.
4) Er moet gepagineerd worden, elementen moeten worden geladen, enzovoort ...
5) API-fouten die door de wrapper worden gegeven, moeten op een klungelige manier worden verwerkt, bijvoorbeeld als volgt (een stukje experimentele code):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#makes sense to keep track of already processed discussions
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Mijn favoriete fout was:
OdnoklassnikiError("Error(code: 'None', description: 'HTTP error', method: 'discussions.getComments', params: …)")6) Uiteindelijk lijkt de combinatie van Selenium + API de meest redelijke optie te zijn.
- Het is noodzakelijk om de status te behouden en het systeem te herstarten, met verwerking van vele fouten, waaronder het inconsistente gedrag van de site — en die fouten zijn behoorlijk moeilijk voor te stellen (tenzij je natuurlijk professioneel parsers schrijft).
De geschatte tijd voor deze taak zal 3-5 keer hoger zijn dan voor het verzamelen van gegevens van Habr. Ondanks het feit dat we in het geval van Habr een directe aanpak gebruiken met HTML-parsen, kunnen we in kritieke situaties met de API werken in het geval van OK.
Conclusies
Zelfs als men van u zou vragen om de tijdsinschatting "ter plekke" (we zijn tenslotte bezig met plannen!), is het praktisch onmogelijk om de uitvoeringstijd van een omvangrijke dataverwerkingspipeline kwalitatief te schatten zonder analyse van de taakparameters.
Als we het iets filosofischer bekijken, zijn inschattingsstrategieën in agile goed toepasbaar op technische taken, maar bij meer experimentele en in zekere zin 'creatieve' en onderzoekstaken, die minder voorspelbaar zijn, ontstaan er moeilijkheden, zoals in de voorbeelden die we hier hebben besproken.
Zeker, gegevensverzameling is een prachtig illustratief voorbeeld — meestal lijkt deze taak ongelooflijk eenvoudig en technisch niet ingewikkeld, en het zijn vaak de details waar de duivel verborgen zit. Dit is precies de taak waar het mogelijk is om de hele range van mogelijkheden te laten zien die mis kunnen gaan en hoezeer het werk kan worden vertraagd.
Als je vluchtig naar de taakparameters kijkt zonder aanvullende experimenten, lijken Reddit en OK op elkaar: er is een API, een Python-wrapper, maar in feite is het verschil enorm. Beoordeeld op deze parameters, lijkt het parseren van Habr ingewikkelder dan OK — maar in de praktijk is het precies omgekeerd, en dit kan worden vastgesteld door eenvoudige experimenten rondom de taakparameters.
Volgens mijn ervaring is de meest effectieve benadering een ruwe tijdsinschatting van de tijd die je nodig hebt voor de voorbereidende analyse en eenvoudige eerste experimenten, evenals het lezen van de documentatie — dit stelt je in staat om een nauwkeurige schatting te geven voor het gehele werk. In termen van de populaire agile-methodologie vraag ik om een ticket aan te maken voor "parameterinschatting van de taak", op basis waarvan ik kan beoordelen wat mogelijk uitvoerbaar is binnen de "sprint" en een nauwkeurigere schatting kan geven voor elke taak.
Daarom lijkt het het meest effectief om een argument te hebben dat aan een 'niet-technische' specialist laat zien hoe sterk de tijd en middelen kunnen variëren afhankelijk van de parameters die nog moeten worden ingeschat.
Bron: habr.com
