

Op 9 januari is de release van Pandas 1.0.0rc aangekondigd. De vorige versie van de bibliotheek was 0.25.
De eerste belangrijke release bevat tal van geweldige vernieuwingen, waaronder verbeterde automatische samenvatting van dataframes, meer uitvoerformaten, nieuwe gegevenstypen en zelfs een nieuwe documentatiesite.
Alle wijzigingen kunnen worden bekeken , in dit artikel beperken we ons tot een beknopt, minder technisch overzicht van de belangrijkste punten.
De bibliotheek kan zoals gebruikelijk worden geïnstalleerd met pip, maar aangezien op het moment van schrijven Pandas 1.0 nog steeds release candidate, moet je expliciet de versie opgeven:
pip install --upgrade pandas==1.0.0rc0Wees voorzichtig: omdat dit een grote release is, kan de update oude code breken!
Trouwens, met deze versie wordt de ondersteuning voor Python 2 volledig stopgezet (wat een goede reden kan zijn — opmerking van de vertaler.). Pandas 1.0 vereist minimaal Python 3.6+, dus als je niet zeker bent, controleer dan welke versie je hebt geïnstalleerd:
$ pip --version
pip 19.3.1 van /usr/local/lib/python3.7/site-packages/pip (python 3.7)

$ python --version
Python 3.7.5
De versie van Pandas controleren gaat het makkelijkst zo:
>>> import pandas as pd
>>> pd.__version__
1.0.0rc0
Verbeterde autosamenvatting met DataFrame.info
Mijn favoriete vernieuwing is de update van de methode DataFrame.info. De functie is veel leesbaarder geworden, wat het proces van gegevensverkenning nog eenvoudiger maakt:
>>> df = pd.DataFrame({
...:   'A': [1,2,3],
...:   'B': ["goodbye", "cruel", "world"],
...:   'C': [False, True, False]
...:})
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (totaal 3 kolommen):
 #   Kolom  Non-Null Aantal  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      object
 2   C       3 non-null      object
dtypes: int64(1), object(2)
memory usage: 200.0+ bytes
Tabeluitvoer in Markdown-formaat
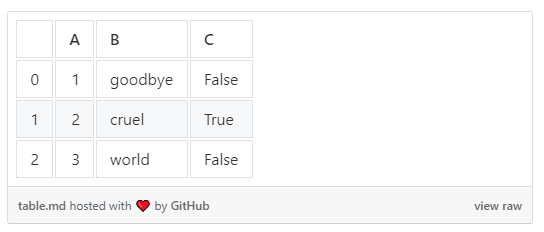
Een even leuke vernieuwing is de mogelijkheid om dataframes te exporteren naar Markdown-tabellen met behulp van DataFrame.to_markdown.
>>> df.to_markdown()
|    |   A | B       | C     |
|---:|----:|:--------|:------|
|  0 |   1 | goodbye | False |
|  1 |   2 | cruel   | True  |
|  2 |   3 | world   | False |
Dit maakt het publiceeren van tabellen op websites zoals Medium met gebruik van GitHub gists veel eenvoudiger.
Nieuwe types voor strings en booleans
In de release van Pandas 1.0 zijn ook nieuwe experimentele types toegevoegd. Hun API kan nog veranderen, dus gebruik het met voorzichtigheid. Maar over het algemeen raadt Pandas aan om nieuwe types overal te gebruiken waar het zinvol is.
Tot nu toe moet typeconversie expliciet worden uitgevoerd:
>>> B = pd.Series(["goodbye", "cruel", "world"], dtype="string")
>>> C = pd.Series([False, True, False], dtype="bool")
>>> df.B = B, df.C = C
>>> df.info()

RangeIndex: 3 entries, 0 to 2
Data columns (total 3 columns):
 #   Column  Non-Null Count  Dtype
---  ------  --------------  -----
 0   A       3 non-null      int64
 1   B       3 non-null      string
 2   C       3 non-null      bool
dtypes: int64(1), object(1), string(1)
memory usage: 200.0+ bytes
Let op hoe de kolom Dtype nieuwe types weergeeft — string en bool.
Een van de handigste features van het nieuwe string-type is de mogelijkheid om alleen string-kolommen uit dataframes te selecteren. Dit kan de analyse van tekstuele data aanzienlijk vereenvoudigen:
df.select_dtypes("string")Eerder was het niet mogelijk om string-kolommen zonder expliciete naamgeving te selecteren.
Meer over de nieuwe types kun je lezen .
Bedankt voor het lezen! De volledige lijst met wijzigingen is, zoals eerder vermeld, te vinden op .
Bron: habr.com
