

10 augustus ging de videoreeks over Docker van start in Slërm In dit artikel bespreken we de geschiedenis van Docker en zijn belangrijkste abstracties: Image, Cli, Dockerfile. De lezing is bedoeld voor beginners, dus het zal waarschijnlijk niet interessant zijn voor ervaren gebruikers. Er zal geen bloed, blindedarm of diepgaande informatie zijn. Alleen de basisprincipes.
Wat is Docker
Laten we de definitie van Docker uit Wikipedia bekijken.
Docker is software voor het automatiseren van de implementatie en het beheer van applicaties in omgevingen die containerisatie ondersteunen.
Van deze definitie wordt niets duidelijk. Vooral niet wat wordt bedoeld met "in omgevingen die containerisatie ondersteunen". Om dit te begrijpen, keren we terug in de tijd. Laten we beginnen met het tijdperk dat ik de "Monolithische Era" noem.
Monolithische Era
De monolithische era is het begin van de jaren 2000, toen alle applicaties monolithisch waren, met veel afhankelijkheden. De ontwikkeling nam veel tijd in beslag. Er waren toen niet veel servers, we kenden ze allemaal bij naam en hielden ze in de gaten. Er is een leuke vergelijkingen:
Huisdieren — dat zijn huisdieren. In de monolithische era behandelden we onze servers als huisdieren, die we verzorgden en koesterden, stof van hun afbliezen. En voor een beter beheer van bronnen gebruikten we virtualisatie: we namen een server en verdeelden deze in meerdere virtuele machines, waarmee we isolatie van omgevingen verzekerden.
Virtualisatiesystemen op basis van hypervisors
Iedereen heeft vast gehoord van virtualisatiesystemen: VMware, VirtualBox, Hyper-V, Qemu KVM, enz. Ze zorgen voor isolatie van applicaties en resourcebeheer, maar ze hebben ook nadelen. Om virtualisatie mogelijk te maken, is er een hypervisor nodig. En een hypervisor brengt resource-overhead met zich mee. Een virtuele machine is meestal ook een grote klus — een zwaar image met daarop een besturingssysteem, Nginx, Apache en wellicht MySQL. Het image is groot, en werken met virtuele machines kan onhandig zijn. Dit kan leiden tot traagheid in de werking. Om dit probleem op te lossen, zijn er virtualisatiesystemen op kernel-niveau ontwikkeld.
Virtualisatiesystemen op kernel-niveau
De virtualisatie op kernel-niveau wordt ondersteund door systemen zoals OpenVZ, Systemd-nspawn, LXC. Een goed voorbeeld van dergelijke virtualisatie is LXC (Linux Containers).
Kernel-level virtualisatie wordt ondersteund door systemen zoals OpenVZ, Systemd-nspawn en LXC. Een opvallend voorbeeld van deze virtualisatie is LXC (Linux Containers).
LXC — een virtualisatiesysteem op applicatieniveau voor het draaien van meerdere geïsoleerde exemplaren van het Linux-besturingssysteem op één knooppunt. LXC maakt geen gebruik van virtuele machines, maar creëert een virtuele omgeving met een eigen procesruimte en netwerkstack.
In wezen creëert LXC containers. Wat is het verschil tussen virtuele machines en containers?
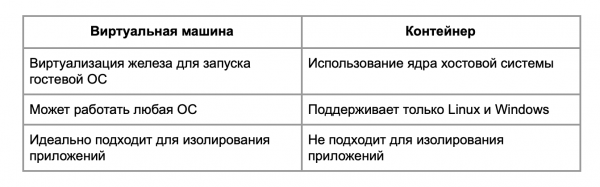
Een container is niet geschikt voor het isoleren van processen: in virtualisatiesystemen op kernniveau worden kwetsbaarheden gevonden die het mogelijk maken om uit de container op de host te ontsnappen. Dus als je iets wilt isoleren, is het beter om een virtuele machine te gebruiken.
De verschillen tussen virtualisatie en containerisatie kunnen op de diagram worden gezien.
Er zijn hardware-hypervisors, hypervisors bovenop OS en containers.
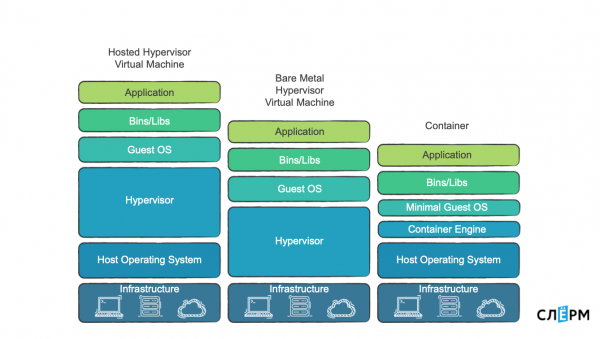
‘Harde’ hypervisors zijn een geweldige optie als je echt iets wilt isoleren. Want dan is er de mogelijkheid om te isoleren op paginaniveau van geheugen en processors.
Er zijn hypervisors als programma, en er zijn containers, waar we het verder over gaan hebben. In containerisatiesystemen is er geen hypervisor, maar is er een Container Engine die containers creëert en beheert. Dit is een lichtere aanpak, waardoor er minder overhead is dankzij de interactie met de kernel.
Wat wordt gebruikt voor containerisatie op kernniveau
De belangrijkste technologieën die het mogelijk maken om een container te creëren die van andere processen is geïsoleerd, zijn Namespaces en Control Groups.
Namespaces: PID, Networking, Mount en User. Er zijn er nog meer, maar voor de eenvoud van begrip blijven we bij deze.
PID Namespace beperkt processen. Wanneer we bijvoorbeeld een PID Namespace creëren en een proces daarin plaatsen, krijgt dit de PID 1. Gewoonlijk is de PID 1 in systemen systemd of init. Dus wanneer we een proces in een nieuwe namespace plaatsen, krijgt het ook de PID 1.
Networking Namespace stelt ons in staat om netwerken te beperken/isoleren en daarbinnen onze eigen interfaces te plaatsen. Mount is de beperking op het bestandssysteem. User is de beperking op gebruikers.
Control Groups: Geheugen, CPU, IOPS, Netwerk — in totaal zijn er ongeveer 12 instellingen. Anders worden ze ook wel Cgroups (C-groepen) genoemd.
Control Groups beheren de middelen voor de container. Via Control Groups kunnen we aangeven dat de container niet meer dan een bepaalde hoeveelheid middelen mag verbruiken.
Om containerisatie volledig te laten functioneren, worden aanvullende technologieën gebruikt: Capabilities, Copy-on-write en anderen.
Capabilities zijn wanneer we een proces vertellen wat het wel en niet mag doen. Op het niveau van de kernel zijn dit gewoon bitmaps met veel parameters. Bijvoorbeeld, de rootgebruiker heeft volledige privileges en kan alles doen. Een tijdserver kan de systeemklok aanpassen: hij heeft capabilities voor Time Capsule, en dat is het. Met privileges kunnen we de beperkingen voor processen flexibeler instellen en onszelf daarmee beveiligen.
Het Copy-on-write-systeem stelt ons in staat om met Docker-images te werken en deze efficiënter te benutten.
Op dit moment heeft Docker problemen met de compatibiliteit van Cgroups v2, daarom worden in dit artikel specifiek Cgroups v1 behandeld.
Maar laten we terugkeren naar het verhaal.
Toen virtualisatiesystemen op kernel-niveau verschenen, werden ze actief toegepast. De overhead van de hypervisor was verdwenen, maar enkele problemen bleven bestaan:
- grootte van de images: in OpenVZ worden besturingssystemen, bibliotheken en allerlei software samengevoegd, en uiteindelijk blijft de image toch behoorlijk groot;
- er is geen goede standaard voor verpakking en distributie, wat het probleem van afhankelijkheden met zich meebrengt. Er zijn situaties waarin twee codefragmenten dezelfde bibliotheek gebruiken, maar met verschillende versies. Tussen hen kan een conflict ontstaan.
Om al deze problemen op te lossen, kwam het volgende tijdperk.
Het tijdperk van containers
Toen het tijdperk van containers begon, veranderde de filosofie voor het werken ermee:
- Eén proces — één container.
- Alle benodigde afhankelijkheden voor het proces worden in zijn container geleverd. Dit vereist het opdelen van monolieten in microservices.
- Hoe kleiner de image, hoe beter — minder potentiële kwetsbaarheden, sneller uitrollen, enzovoort.
- Instanties worden efemeer.
Herinner je de vergelijking tussen huisdieren en vee? Vroeger waren instanties als huisdieren, nu zijn ze als vee. Vroeger was er één monolith — één toepassing. Nu zijn er 100 microservices, 100 containers. Sommige containers kunnen 2-3 replicas hebben. Het wordt minder belangrijk om elke container te controleren. Wat belangrijker wordt, is de beschikbaarheid van de service zelf: wat deze set containers doet. Dit verandert de monitoringsaanpak.
In de jaren 2014-2015 vond de bloei van Docker plaats — de technologie waarover we nu gaan praten.
Docker heeft de filosofie veranderd en de verpakking van applicaties gestandaardiseerd. Met Docker kunnen we een applicatie verpakken, deze naar een repository sturen, en het daar vandaan downloaden en in gebruik nemen.
In een Docker-container leggen we alles vast wat nodig is, waardoor het probleem van afhankelijkheden wordt opgelost. Docker garandeert reproduceerbaarheid. Ik denk dat velen de reproduceerbaarheid hebben ervaren: alles werkt, je duwt naar productie en daar stopt het met werken. Met Docker verdwijnt dit probleem. Als jouw Docker-container opstart en doet wat het moet doen, dan zal het hoogstwaarschijnlijk ook op productie opstarten en hetzelfde doen.
Een zijstap over overhead
Er zijn constante discussies over overhead. Sommigen menen dat Docker geen extra belasting met zich meebrengt, omdat het de Linux-kernel en alle benodigde processen voor containerisatie gebruikt. Ze zeggen: "Als je zegt dat Docker overhead is, is de Linux-kernel dan ook overhead."
Aan de andere kant, als we dieper ingaan, zijn er inderdaad enkele dingen in Docker die we met een beetje moeite als overhead kunnen beschouwen.
Het eerste is de PID-namespace. Wanneer we een proces in een namespace plaatsen, krijgt het PID 1. Tegelijkertijd heeft dit proces nog een andere PID, die zich in de host-namespace bevindt, buiten de container. Bijvoorbeeld, als we Nginx in de container starten, wordt het PID 1 (de master-proces). En op de host heeft het PID 12623. Het is moeilijk te zeggen hoezeer dit overhead is.
Het tweede punt zijn Cgroups. Laten we Cgroups voor geheugen nemen, wat de mogelijkheid is om een container in geheugen te beperken. Wanneer dit is ingeschakeld, worden er tellers geactiveerd, memory accounting: de kernel moet begrijpen hoeveel pagina's zijn toegewezen en hoeveel er nog vrij zijn voor deze container. Dit kan overhead met zich meebrengen, maar ik heb geen exacte studies gezien over de impact daarvan op de prestaties, en ik heb zelfs niet opgemerkt dat een applicatie die in Docker draait, plotseling aanzienlijk in prestaties verliest.
En nog een opmerking over prestaties. Sommige kernelparameters worden van de host naar de container doorgestuurd. Vooral enkele netwerkinstellingen. Dus als je iets hoogschaalbaars in Docker wilt draaien, zoals iets dat actief gebruikmaakt van het netwerk, dan moet je deze parameters minimaal aanpassen. Bijvoorbeeld nf_conntrack.
Over het concept van Docker
Docker bestaat uit verschillende componenten:
- Docker Daemon — de Container Engine; start containers.
- Docker CII — een hulpmiddel voor het beheren van Docker.
- Dockerfile — instructies voor het bouwen van een image.
- Image — de image waarvan de container wordt uitgerold.
- Container.
- Docker registry — opslagplaats van images.
Schematisch ziet het er ongeveer zo uit:
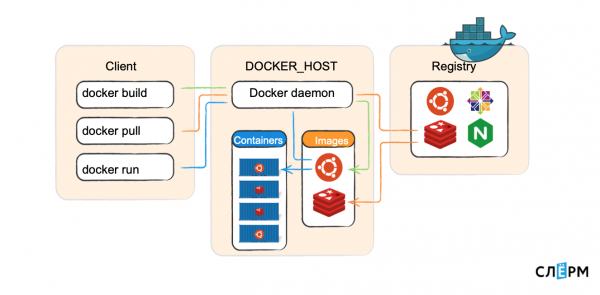
Op Docker_host draait de Docker daemon, die containers start. Er is een Client die opdrachten doorgeeft: bouw image, download image, start container. De Docker daemon gaat naar de registry en voert deze uit. De Docker-client kan lokaal (via de unix-socket) of via TCP vanaf een externe host communiceren.
Laten we elk onderdeel bekijken.
Docker daemon (daemon) — dit is het serverdeel, dat draait op de hostmachine: het downloadt images en start containers, creëert netwerken tussen containers, verzamelt logs. Wanneer we zeggen "maak een image aan", wordt dit ook door de daemon gedaan.
Docker CLI — het clientgedeelte van Docker, een console-hulpmiddel voor interactie met de daemon. Ik herhaal, het kan niet alleen lokaal werken, maar ook via het netwerk.
Basiscommando's:
docker ps — toont de containers die momenteel draaien op de Docker-host.
docker images — toont de images die lokaal zijn gedownload.
docker search — zoekt naar een image in de registry.
docker pull — downloadt een image uit de registry naar de machine.
docker build <> — bouwt een image.
docker run — start een container.
docker rm — verwijdert een container.
docker logs — logs van de container.
docker start/stop/restart — beheer van de container.
Als je deze commando's onder de knie hebt en ze zelfverzekerd kunt gebruiken, dan kun je stellen dat je 70% van Docker als gebruiker beheerst.
Dockerfile — instructies voor het maken van een image. Bijna elke opdracht in de instructies is een nieuwe laag. Laten we het voorbeeld bekijken.
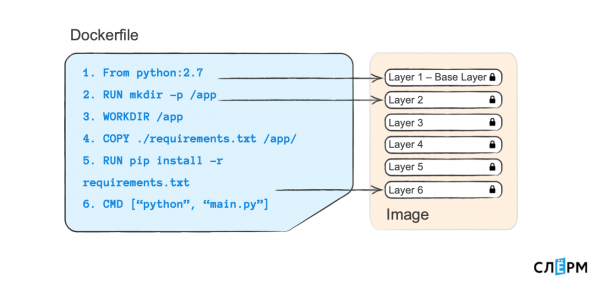
Zo ziet een Dockerfile eruit: aan de linkerkant de commando's, aan de rechterkant — de argumenten. Elke opdracht die hier staat (en die over het algemeen in Dockerfile wordt geschreven) creëert een nieuwe laag in de Image.
Zelfs als je naar de linkerzijde kijkt, kun je ongeveer begrijpen wat er aan de hand is. We zeggen: "maak een map aan" — dat is één laag. "Maak de map werkend" — dat is nog een laag, enzovoorts. De gelaagdheid vereenvoudigt het leven. Als ik nog een Dockerfile maak en in de laatste regel iets wijzig, zoals het starten van iets anders dan "python" "main.py", of afhankelijkheden vanaf een ander bestand installeer, dan zullen de voorgaande lagen worden hergebruikt als cache.
Afbeelding — dit is de containerafbeelding waaruit de containers worden gestart. Als je naar Docker kijkt vanuit het perspectief van een pakketbeheerder (alsof we met deb of rpm-pakketten werken), dan is de image in feite een rpm-pakket. Via yum install kunnen we een applicatie installeren, verwijderen, in de repository vinden en downloaden. Hier is het ongeveer hetzelfde: uit de afbeelding worden containers gestart, ze worden opgeslagen in de Docker registry (vergelijkbaar met yum, in de repository), en elke image heeft een SHA-256 hash, een naam en een tag.
De image wordt opgebouwd volgens de instructies in de Dockerfile. Elke instructie in de Dockerfile creëert een nieuwe laag. Lagen kunnen hergebruikt worden.
Docker registry — is een repository van Docker-afbeeldingen. Vergelijkbaar met besturingssystemen heeft Docker een openbaar standaardregister — dockerhub. Maar je kunt ook je eigen repository maken, je eigen Docker registry.
Container — datgene wat uit de afbeelding wordt gestart. Volgens de instructies in de Dockerfile hebben we de afbeelding samengesteld, en dan starten we deze uit die afbeelding. Deze container is geïsoleerd van andere containers, hij moet alles bevatten wat nodig is om de applicatie te laten draaien. Daarbij is één container — één proces. Soms is het nodig om twee processen te draaien, maar dat is enigszins in strijd met de ideologie van Docker.
De eis «één container — één proces» is verbonden met de PID Namespace. Wanneer er in de Namespace een proces met PID 1 wordt gestart en dit sterft, dan sterft de hele container ook. Als er echter twee processen draaien: de ene leeft, terwijl de andere is gestorven, dan blijft de container desondanks leven. Maar dat is een kwestie van Best Practices, waar we in andere materialen over zullen praten.
Om de kenmerken en het volledige programma van de cursus uitgebreider te bestuderen, kun je de link volgen: «».
Auteur: Marcel Ibraev, gecertificeerd Kubernetes-beheerder, praktiserend ingenieur bij Southbridge, spreker en cursusontwikkelaar bij Slurm.
Bron: habr.com
