

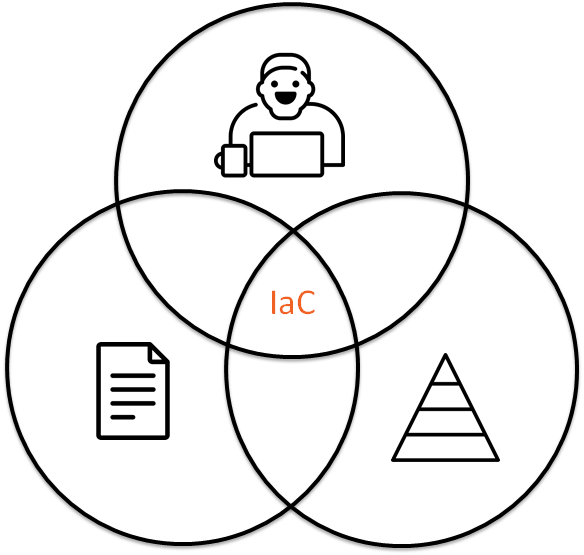
Aanpak IaC (Infrastructure as Code) bestaat niet alleen uit de code die in de repository is opgeslagen, maar ook uit de mensen en processen die deze code omringen. Is het mogelijk om benaderingen uit softwareontwikkeling te hergebruiken voor het beheer en de beschrijving van infrastructuur? Het is nuttig om dit idee in gedachten te houden terwijl u het artikel leest.
Dit is de transcriptie van mijn en een werkende opdracht krijgen. .
Dia's en video's
- Dry run 2019-04-24
Infrastructuur als bash-geschiedenis
Stel, je komt op een nieuw project en men zegt je: «we hebben Infrastructure as Code». In werkelijkheid blijkt dat Infrastructuur als bash-geschiedenis of bijvoorbeeld Documentatie als bash-geschiedenis. Dit is een heel reële situatie, bijvoorbeeld, zo'n geval beschreef Denis Lysenko in zijn voordracht , hij vertelde hoe ze uit bash-geschiedenis een gestructureerde infrastructuur voor het project hebben ontvangen.
Met enige moeite kan men zeggen dat Infrastructuur als bash-geschiedenis het als code is:
- reproduceerbaarheid: je kunt bash-geschiedenis nemen, de commando's daaruit uitvoeren, mogelijk krijg je trouwens een werkende configuratie als resultaat.
- versiebeheer: je weet wie er binnenkwam en wat ze deden, maar nogmaals, het is niet zeker dat dit je naar een werkende configuratie leidt.
- geschiedenis: de geschiedenis van wie wat deed. Maar je kunt er niet mee werken als je de server verliest.
Wat moeten we nu doen?
Infrastructure as Code
Zelfs zo'n vreemd geval als Infrastructuur als bash-geschiedenis kan naar het Infrastructure as Codegetrokken worden, maar wanneer we iets complexers willen doen dan de oude vertrouwde LAMP-server, komen we tot de conclusie dat deze code op een bepaalde manier moet worden aangepast, gewijzigd, verder ontwikkeld. Verder willen we de parallellen tussen Infrastructure as Code en softwareontwikkeling bekijken.
D.R.Y.
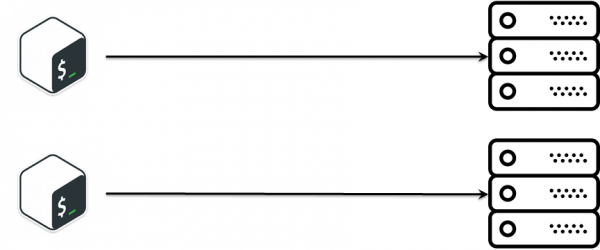
Bij een project voor de ontwikkeling van opslagarrays was er een subtaak : we brengen een nieuwe release uit - deze moet worden uitgerold voor verdere tests. De taak is uiterst eenvoudig:
- ga hierheen via ssh en voer de opdracht uit.
- kopieer het bestand daarheen.
- corrigeer hier de configuratie.
- start daar de service.
- …
- WINST!
Voor de beschreven logica is bash meer dan voldoende, vooral in de vroege stadia van het project, wanneer het net begint. Het is , maar na verloop van tijd ontstaan er verzoeken om iets soortgelijks uit te breiden, maar net iets anders. Het eerste wat in me opkomt: copy-paste. En daar hebben we al twee heel vergelijkbare scripts die bijna hetzelfde doen. Na verloop van tijd is het aantal scripts toegenomen, en we stuiten op een zekere bedrijfslogica voor de uitrol van de installatie, die gesynchroniseerd moet worden tussen verschillende scripts; dat is best complex.
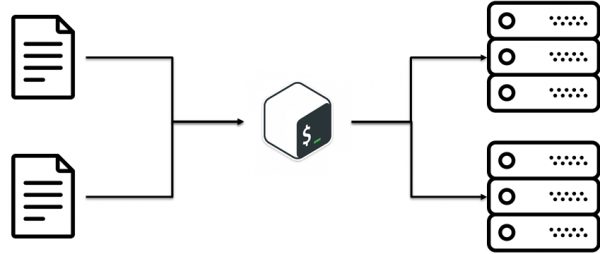
Het blijkt dat er een praktijk is genaamd D.R.Y. (Do not Repeat Yourself). Het idee is om bestaande code te hergebruiken. Het klinkt eenvoudig, maar we kwamen daar niet meteen achter. In ons geval was het een banale gedachte: scheid de configuraties van de scripts. Dat wil zeggen, de bedrijfslogica voor het uitrollen van de installatie apart, de configuraties apart.
S.O.L.I.D. voor CFM
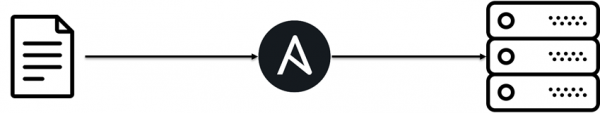
Na verloop van tijd groeide het project en de opkomst van Ansible. De belangrijkste reden voor de opkomst ervan was de aanwezige expertise in het team en dat bash niet bedoeld is voor complexe logica. Ansible bevatte ook complexe logica. Om ervoor te zorgen dat complexe logica niet in chaos verandert, bestaan er in softwareontwikkeling principes voor het organiseren van code. S.O.L.I.D. Ook bijvoorbeeld Grigory Petrov raakte in zijn presentatie "Waarom een IT'er een persoonlijk merk nodig heeft" het onderwerp aan dat mensen zodanig zijn opgebouwd dat het voor hen gemakkelijker is om met sociale entiteiten om te gaan, in softwareontwikkeling zijn dit objecten. Als je deze twee ideeën samenvoegt en verder ontwikkelt, kan je merken dat ook in de beschrijving van infrastructuur S.O.L.I.D. het in de toekomst gemakkelijker zal zijn om deze logica te ondersteunen en te wijzigen.
Het Enkelvoudige Verantwoordelijkheidsprincipe
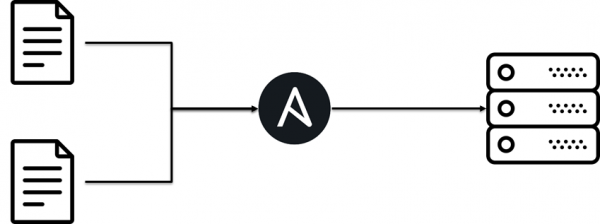
Elke klasse voert slechts één taak uit.
Mix geen code en maak geen monolitische goddelijke spaghettimonsters. Infrastructuur moet bestaan uit eenvoudige bouwstenen. Blijkt dat als je een Ansible playbook in kleine stukjes opdeelt, lees Ansible rollen, dat ze gemakkelijker te onderhouden zijn.
Het Open Gesloten Principe
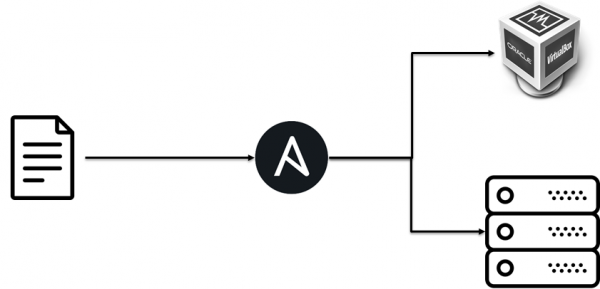
Het principe van openheid/geslotenheid.
- Open voor uitbreiding: betekent dat het gedrag van een entiteit kan worden uitgebreid door nieuwe typen entiteiten te creëren.
- Gesloten voor wijziging: als gevolg van het uitbreiden van het gedrag van een entiteit mogen er geen wijzigingen worden aangebracht in de code die deze entiteiten gebruikt.
Aanvankelijk draaiden we een testinfrastructuur op virtuele machines, maar omdat de zakelijke logica van de implementatie gescheiden was, hebben we zonder problemen een uitrol op bare metal toegevoegd.
Het Liskov-substitutieprincipe
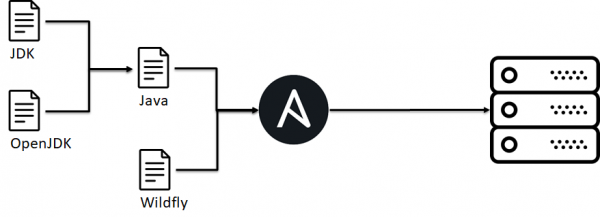
Het Liskov-substitutieprincipe. Objecten in een programma moeten vervangbaar zijn door instanties van hun subtypen zonder de correctheid van het programma in gevaar te brengen.
Als je breder kijkt, is het geen specifieke eigenschap van een bepaald project dat je daar kunt toepassen. S.O.L.I.D., het gaat in het algemeen om CFM, bijvoorbeeld in een ander project moet je een kant-en-klaar Java-toepassing implementeren bovenop verschillende Java, applicatieservers, databases, besturingssystemen, enz. Op dit voorbeeld zal ik de verdere principes bekijken. S.O.L.I.D.
In ons geval is er binnen het infrastructuurteam een afspraak dat als we de rol imbjava of oraclejava hebben geïnstalleerd, er een uitvoerbaar binair bestand java aanwezig moet zijn. Dit is nodig omdat de bovenliggende rollen van dit gedrag afhankelijk zijn en ze de aanwezigheid van java verwachten. Tegelijkertijd stelt dit ons in staat om de ene implementatie/versie van java door de andere te vervangen zonder de logica van de applicatie-implementatie te veranderen.
Het probleem hier zit in het feit dat je zoiets niet kunt implementeren in Ansible, waardoor er binnen het team bepaalde afspraken ontstaan.
Het Interface-segregatieprincipe
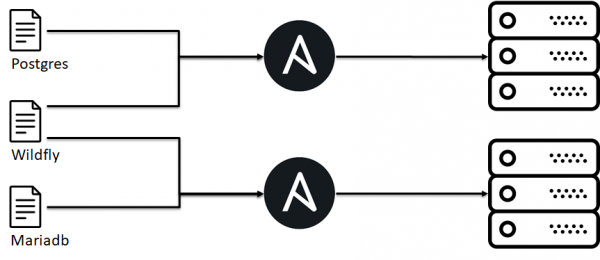
Het principe van interface-segregatie. "Veel interfaces, speciaal ontworpen voor klanten, zijn beter dan één interface voor algemeen gebruik."
Aanvankelijk probeerden we alle variabiliteit van de applicatie-implementatie in één Ansible-playbook onder te brengen, maar dit was moeilijk te onderhouden. De aanpak waarbij we een gespecificeerd interface naar buiten hebben (de klant verwacht poort 443), stelt ons in staat om de infrastructuur voor een specifieke implementatie uit afzonderlijke bouwstenen samen te stellen.
Het principe van afhankelijkheidsinversie
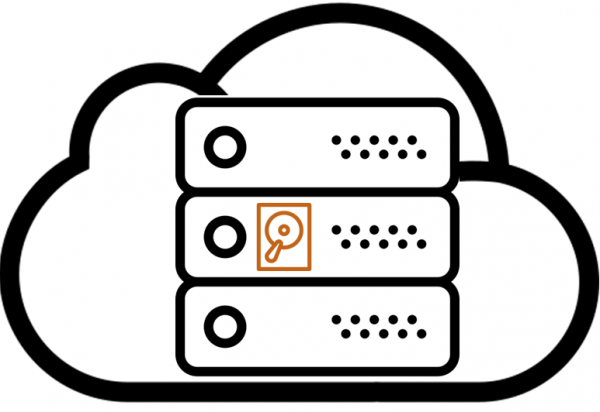
Het principe van afhankelijkheidsinversie. Modules op een hoger niveau mogen niet afhankelijk zijn van modules op een lager niveau. Beide soorten modules moeten afhankelijk zijn van abstracties. Abstracties mogen niet afhankelijk zijn van details. Details moeten afhankelijk zijn van abstracties.
Het voorbeeld hier zal gebaseerd zijn op een antipatroon.
- Een van onze klanten had een privécloud.
- Binnen de cloud vroegen we virtuele machines aan.
- Maar vanwege de kenmerken van de cloud was de uitrol van de applicatie gebonden aan de hypervisor waarop de VM terechtkwam.
Dus, de hoog-niveau logica van de applicatieontplooiing, afhankelijkheden, stroomden naar de onderliggende niveaus van de hypervisor, en dit betekende problemen bij het hergebruiken van deze logica. Dat hoef je niet te doen.
Interacties
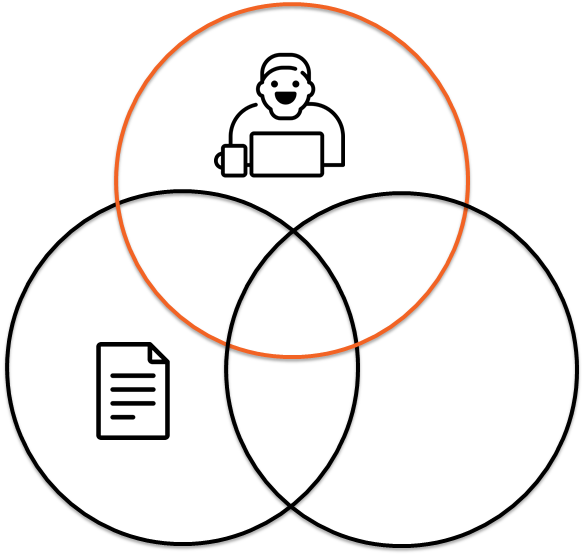
Infrastructuur als code gaat niet alleen over code, maar ook over de relaties tussen de code en de mens, over de interacties tussen infrastructuurontwikkelaars.
Busfactor
Stel dat je iemand op je project hebt, laten we zeggen Vasja. Vasja weet alles over jouw infrastructuur; wat gebeurt er als Vasja plotseling verdwijnt? Dit is een heel reële situatie, want hij kan door een bus overreden worden. Soms gebeurt dat. Als dergelijke kennis over de code, de structuur, hoe het werkt, gebruikersnamen en wachtwoorden niet binnen het team is verdeeld, dan kun je met een aantal vervelende situaties geconfronteerd worden. Om deze risico's te minimaliseren en de kennis binnen het team te verspreiden, kunnen verschillende benaderingen worden gebruikt.
Pair Devopsing
Dit is niet zoals , dat admins bier dronken, wachtwoorden wijzigden, en een analoog aan pair programming. Dat wil zeggen, twee ingenieurs zitten achter één computer, één toetsenbord en beginnen samen jouw infrastructuur in te stellen: de server configureren, een Ansible-rol schrijven, enzovoort. Het klinkt mooi, maar bij ons werkte het niet. Maar private gevallen van deze praktijk werkten. Een nieuwe medewerker, zijn mentor neemt samen met hem een echte taak op zich en werkt samen — kennisoverdracht.
Een ander privé geval is de incident call. Tijdens een probleem verzamelt zich een groep van kaderleden en betrokkenen, er wordt één leider aangewezen die zijn scherm deelt en zijn gedachtegang verhaalt. Andere deelnemers volgen de gedachtegang van de leider, kijken naar tricks in de console, controleren wat hij niet in de log heeft gemist, en leren nieuwe dingen over het systeem. Deze aanpak werkte meer dan niet.
Code Review
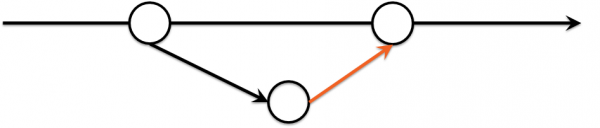
Subjectief gezien vond ik de verspreiding van kennis over de infrastructuur en hoe deze is opgebouwd effectiever via code reviews:
- De infrastructuur is in code beschreven in de repository.
- Wijzigingen vinden plaats in een aparte tak.
- Bij de merge-aanvraag kan je de delta van de veranderingen in de infrastructuur zien.
Het opvallende hier was dat de reviewers om de beurt, volgens een schema, werden geselecteerd, dus met een zekere waarschijnlijkheid zou je in een nieuw deel van de infrastructuur kunnen duiken.
Code Stijl
Naarmate de tijd vorderde, begonnen er discussies te ontstaan tijdens reviews, omdat reviewers hun eigen stijl hadden en de rotatie van reviewers hen in aanraking bracht met verschillende stijlen: 2 spaties of 4, camelCase of snake_case. Het implementeren hiervan lukte niet meteen.
- Het eerste idee was om aan te bevelen een linter te gebruiken, want tenslotte zijn het allemaal ingenieurs, allemaal slim. Maar verschillende editors, besturingssystemen, niet handig.
- Dit evolueerde naar een bot die bij elk problematisch commit naar Slack schreef en de uitvoer van de linter toevoegde. Maar in de meeste gevallen waren er belangrijkere zaken en bleef de code ongecorrigeerd.
Green Build Master
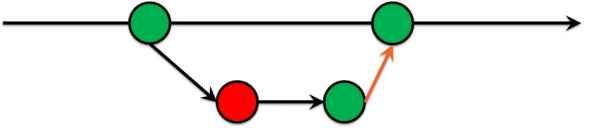
De tijd ging voorbij, en we kwamen tot de conclusie dat commits die niet door bepaalde tests komen, niet in de master mogen worden toegelaten. Voilà! We hebben de Green Build Master uitgevonden, die al geruime tijd in softwareontwikkeling wordt toegepast:
- De ontwikkeling vindt plaats in een aparte tak.
- In deze tak worden tests uitgevoerd.
- Als de tests niet slagen, komt de code niet in de master.
Het nemen van deze beslissing was behoorlijk pijnlijk, omdat het veel discussie veroorzaakte, maar het was het waard, omdat de merge-aanvragen voor reviews zonder stilistische meningsverschillen binnenkwamen en na verloop van tijd het aantal probleemgevallen afnam.
IaC Testing
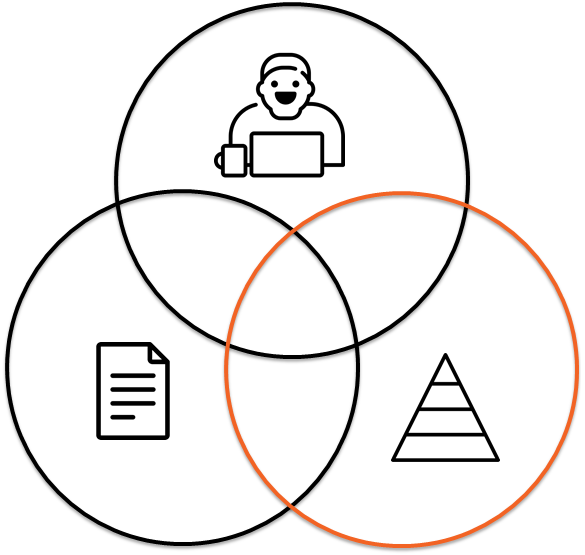
Naast stijlcontroles kunnen ook andere zaken worden gebruikt, bijvoorbeeld controleren of uw infrastructuur daadwerkelijk kan worden uitgerold. Of controleren of de wijzigingen in de infrastructuur niet leiden tot verlies van geld. Waarom zou dit nodig zijn? De vraag is complex en filosofisch, het antwoord kan beter met een verhaal worden gegeven: er was eens een auto-scaler op Powershell die geen randvoorwaarden controleerde => er werden meer VM's gemaakt dan nodig was => de klant gaf meer uit dan gepland. Niet leuk, maar deze fout had heel goed in een vroeg stadium kunnen worden opgemerkt.
Men kan zich afvragen, waarom een complexe infrastructuur nog ingewikkelder maken? Tests voor infrastructuur, net als voor code, zijn niet bedoeld om het te vereenvoudigen, maar om te begrijpen hoe uw infrastructuur zou moeten werken.
IaC Testing Pyramid
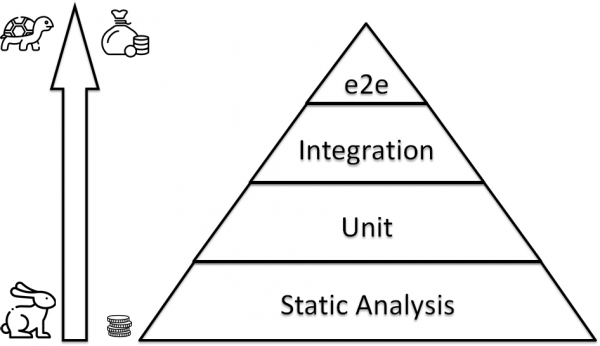
IaC Testing: Static Analysis
Als je meteen de volledige infrastructuur uitrolt en controleert of deze werkt, kan het zijn dat dit een hoop tijd en inspanning vergt. Daarom moet er iets zijn dat snel werkt, veel voorkomt, en dat vele primitieve aspecten dekt.
Bash is tricky
Laten we een eenvoudig voorbeeld bekijken. Alle bestanden in de huidige directory selecteren en naar een andere locatie kopiëren. Het eerste dat in me opkomt:
for i in * ; do
    cp $i /some/path/$i.bak
done
Maar wat als er een spatie in de bestandsnaam zit? Nou ja, we zijn slim, we weten hoe we aanhalingstekens moeten gebruiken:
for i in * ; do cp "$i" "/some/path/$i.bak" ; doneGoed gedaan? Nee! Wat als er niets in de directory staat, dat wil zeggen, globbing werkt niet.
find . -type f -exec mv -v {} dst/{}.bak ;En nu, goed gedaan? Nee… We zijn vergeten dat er n.
touch x
mv x "$(printf "foonbar")"
find . -type f -print0 | xargs -0 mv -t /path/to/target-dir
Statische analysetools
Het probleem van de vorige stap kon worden opgemerkt toen we de aanhalingstekens vergaten, hiervoor bestaan er veel middelen. , er zijn er veel en waarschijnlijk kun je een linter voor jouw stack vinden voor je IDE.
Taal
Hulpmiddel
bash
Ruby
python
ansible
IaC Testing: Unit Tests
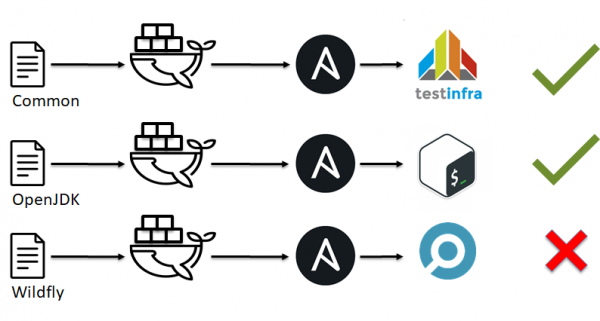
Zoals we uit het vorige voorbeeld hebben gezien, zijn linters niet almachtig en kunnen ze niet alle probleemgebieden aanwijzen. Verderop, in navolging van testen in softwareontwikkeling, kunnen we het hebben over unittests. Hier komen meteen in gedachten: , , , . Maar wat doen we met ansible, chef, saltstack en soortgelijke?
Aan het begin spraken we over S.O.L.I.D. en dat onze infrastructuur uit kleine bouwstenen moet bestaan. Het is tijd voor hen.
- De infrastructuur wordt opgedeeld in kleine bouwstenen, zoals Ansible-rollen.
- Er wordt een bepaalde omgeving opgezet, of dit nu docker of een VM is.
- We passen onze Ansible-rol toe op deze testomgeving.
- We controleren of alles is uitgevoerd zoals we verwachtten (we voeren de tests uit).
- We besluiten of het goed of niet goed is.
IaC Testing: Unit Testing tools
De vraag is, wat zijn tests voor CFM? Je kunt simpelweg een script uitvoeren, maar je kunt ook gebruik maken van kant-en-klare oplossingen hiervoor:
CFM
Hulpmiddel
Ansible
Chef
Chef
saltstack
Voorbeeld voor testinfra, we controleren of de gebruikers test1, test2 bestaan en lid zijn van de groep sshusers:
def test_default_users(host):
    users = ['test1', 'test2']
    for login in users:
        assert host.user(login).exists
        assert 'sshusers' in host.user(login).groups
Wat te kiezen? Een moeilijke en niet eenduidige vraag, hier is een voorbeeld van veranderingen in projecten op GitHub in 2018-2019:
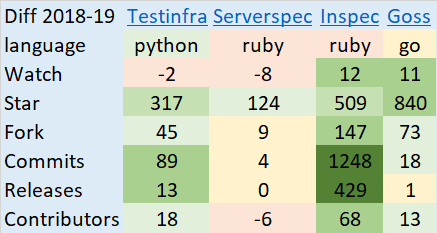
IaC Testing frameworks
De vraag is hoe dit allemaal samen te brengen en uit te voeren? Je kunt met voldoende ingenieurs. Of je kunt kant-en-klare oplossingen nemen, maar die zijn er niet veel:
CFM
Hulpmiddel
Ansible
Chef
Terraform
Voorbeeld van veranderingen in projecten op GitHub in 2018-2019:
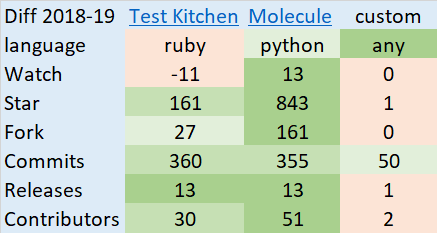
Molecule vs. Testkitchen
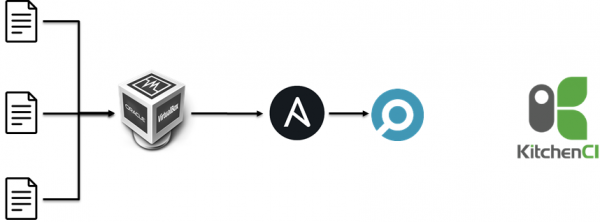
In het begin hebben we :
- Een VM parallel creëren.
- Toepassen van Ansible-rollen.
- Inspec uitvoeren.
Voor 25-35 rollen duurde het 40-70 minuten, wat lang was.
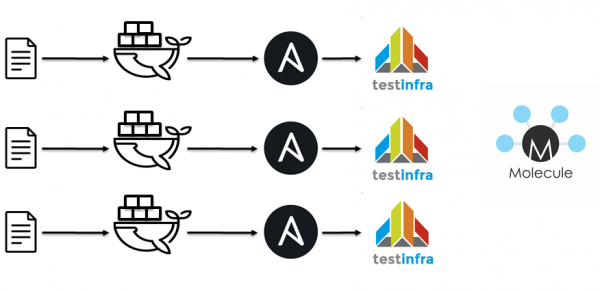
De volgende stap was de overstap naar Jenkins / Docker / Ansible / Molecule. Ideologisch is het allemaal hetzelfde.
- Playbooks linten.
- Rollen linten.
- Container starten.
- Toepassen van Ansible-rollen.
- Testinfra uitvoeren.
- Controleer idempotentie.
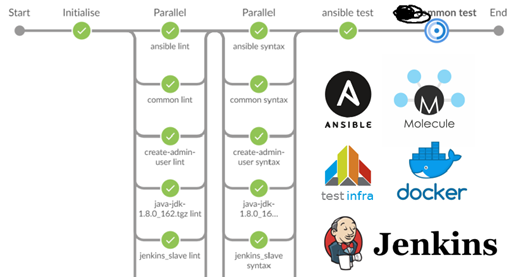
Linten voor 40 rollen en tests voor een tiental duurden ongeveer 15 minuten.
Wat te kiezen hangt af van veel factoren, zoals de gebruikte stack, expertise in het team, enz. Iedereen beslist zelf hoe ze de kwestie van unit testing aanpakken.
IaC Testing: Integratietests.
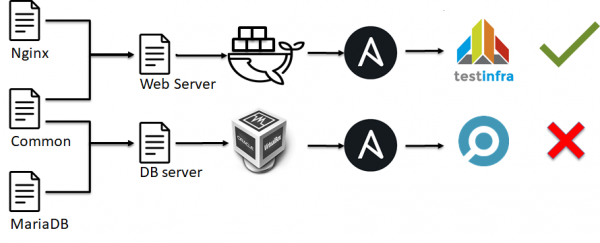
In de volgende laag van de piramide voor infrastructuurtesten verschijnen integratietests. Ze lijken op unit tests:
- Infrastructuur wordt opgesplitst in kleine blokjes, bijvoorbeeld Ansible-rollen.
- Er wordt een bepaalde omgeving opgezet, of dit nu docker of een VM is.
- Deze testomgeving wordt toegepast op. veel Ansible-rollen.
- We controleren of alles is uitgevoerd zoals we verwachten (we voeren de tests uit).
- We besluiten of het goed of niet goed is.
Grofweg gezegd, controleren we niet de functionaliteit van een enkel element van het systeem zoals bij unit tests, maar controleren we hoe de server als geheel is geconfigureerd.
IaC Testing: End-to-End Tests.
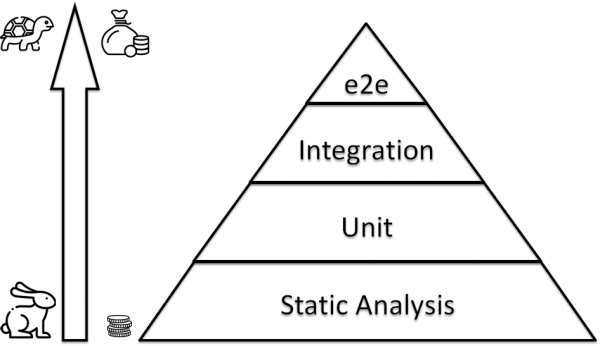
Bovenaan de piramide worden we begroet door end-to-end tests. Dat wil zeggen, we controleren niet de functionaliteit van een enkele server, een enkel script, of een enkele bouwsteen van onze infrastructuur. We controleren of een aantal servers, verenigd als één geheel, onze infrastructuur werkt zoals we verwachten. Helaas heb ik geen kant-en-klare oplossingen gezien, waarschijnlijk omdat infrastructuren vaak uniek zijn en moeilijk te standaardiseren en te kaderen voor testen. Als resultaat maken velen hun eigen oplossingen. Er is vraag, maar geen aanbod. Daarom zal ik vertellen wat er is, om anderen op verstandige gedachten te brengen of om me te wijzen op het feit dat alles al lang voor ons is uitgevonden.
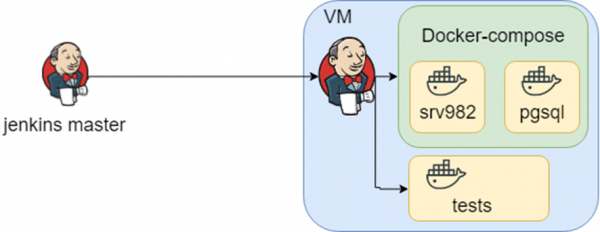
Project met een rijke geschiedenis. Het wordt gebruikt in grote organisaties en waarschijnlijk heeft elk van jullie er indirect mee te maken gehad. De applicatie ondersteunt veel databases, integraties, enzovoort. Kennis over hoe de infrastructuur eruit kan zien, is een heleboel docker-compose bestanden, en kennis over welke tests in welke omgeving moeten worden uitgevoerd — dat is Jenkins.
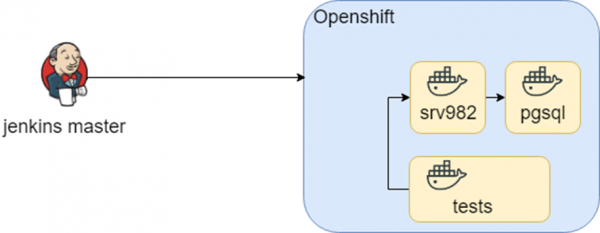
Dit schema heeft relatief lang gewerkt totdat we het op Openshift probeerden te zetten. De containers bleven hetzelfde, maar de uitvoeringsomgeving is veranderd (hallo D.R.Y. weer).
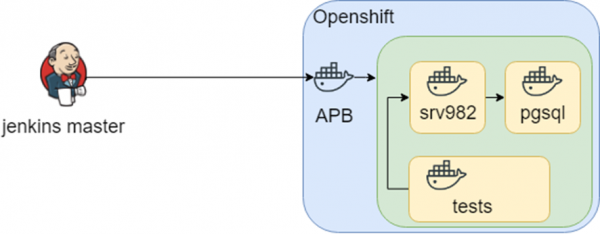
De gedachtegang van het onderzoek ging verder, en in OpenShift werd er zo'n ding gevonden genaamd APB (Ansible Playbook Bundle), waarmee je de kennis over het implementeren van infrastructuur in een container kunt inpakken. Dat wil zeggen, er is een reproduceerbaar, testbaar kennis punt over hoe de infrastructuur te implementeren.
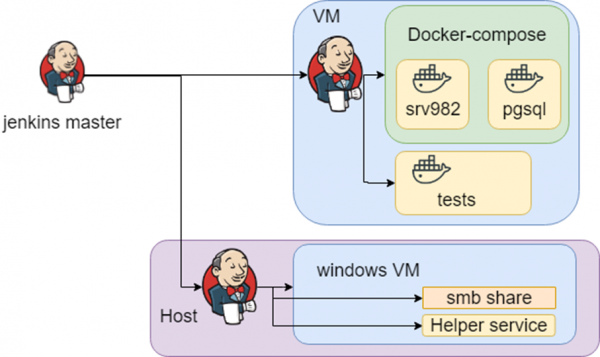
Dit klonk allemaal goed, totdat we tegen een heterogene infrastructuur aanliepen: we hebben Windows nodig voor tests. Uiteindelijk bevindt de kennis over wat, waar en hoe te implementeren en te testen zich in Jenkins.
Conclusie
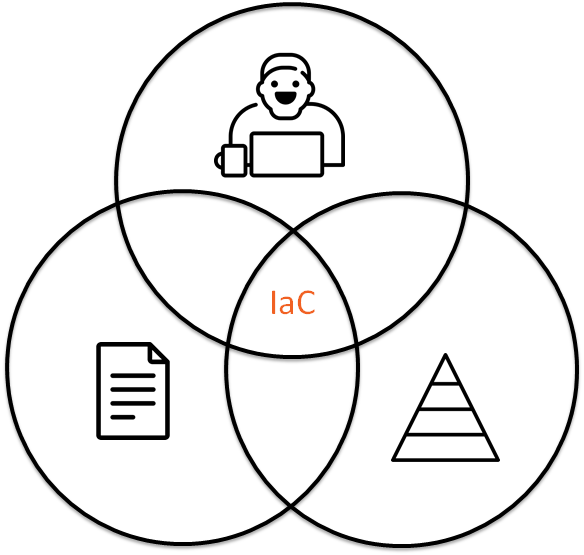
Infrastructure as Code is
- Code in de repository.
- Interacties tussen mensen.
- Testen van infrastructuur.
links
- Dry run 2019-04-24
- &
Bron: habr.com
