

Hallo, habr.
Als iemand het systeem gebruikt en tegen prestatieproblemen aanloopt (IO, gebruikte schijfruimte), dan zou de kans dat er naar ClickHouse als vervanging is gekeken,naar één moeten neigen. Deze verklaring impliceert dat er al een externe implementatie als metriek demon wordt gebruikt, bijvoorbeeld of .
ClickHouse lost de beschreven problemen goed op. Bijvoorbeeld, na het migreren van 2TiB gegevens uit whisper, pasten ze in 300GiB. Ik zal niet in detail treden over de vergelijking, er zijn genoeg artikelen over dit onderwerp. Bovendien was er tot voor kort niet alles perfect met onze ClickHouse opslag.
Problemen met gebruikte ruimte
Op het eerste gezicht zou alles goed moeten werken. Volg , we maken een configuratie voor het opslag-schema (verder retention), daarna maken we een tabel volgens de aanbeveling van de gekozen backend voor graphite-web: + of , afhankelijk van welke stack wordt gebruikt. En... er wordt een tijdbom geactiveerd.
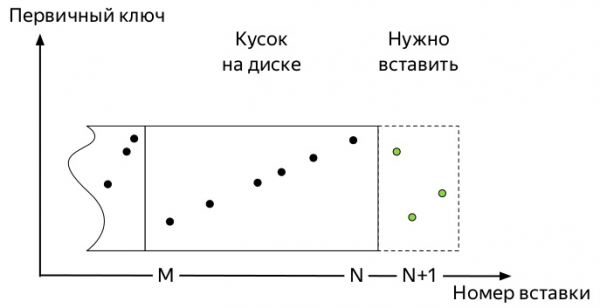
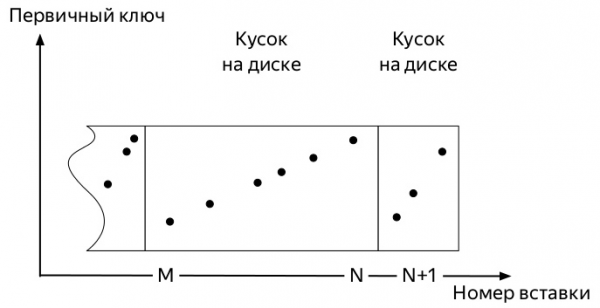
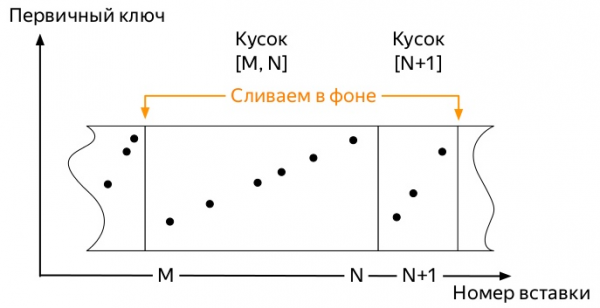
Om te begrijpen welke, moet je weten hoe inserts werken en de verdere levenscyclus van gegevens in de tabellen van de *MergeTree ClickHouse (diagrammen zijn afkomstig van Alexey Zatelepin):
- Er wordt een
blokgegevens ingevoegd. In ons geval kwamen de metrics binnen.

- Elk zulk blok wordt gesorteerd volgens de sleutel
ORDER BY, opgegeven bij het aanmaken van de tabel. - Na sortering,
een stuk(part) gegevens wordt naar de schijf geschreven.
- De server houdt op de achtergrond in de gaten dat er niet te veel van zulke stukken zijn, en start achtergrond
samenvoegingen(merge, daarna mergen).
- De server stopt met het automatisch starten van merges zodra er geen actieve gegevens meer binnenkomen in
de partitie(partition), maar je kunt het proces handmatig starten met het commandoOPTIMIZE. - Als er in de partitie nog maar één stuk over is, dan kan je de merge niet met een gewoon commando starten, je moet
OPTIMIZE ... FINAL
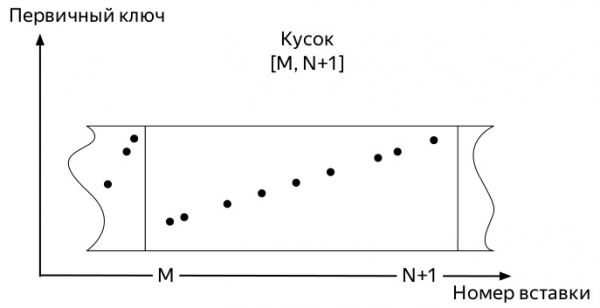
Dus, de eerste metrics komen binnen. En ze nemen enige ruimte in beslag. De daaropvolgende gebeurtenissen kunnen enigszins variëren afhankelijk van verschillende factoren:
- De partitioneringssleutel kan ofwel heel klein zijn (dag), of heel groot (meerdere maanden).
- De retention-configuratie kan verschillende significante aggregatiedrempels binnen de actieve partitie (waar de metrics worden geregistreerd) bevatten, of dat kan ook niet.
- Als er veel data is, zullen de oudste stukken, die door achtergrondmarges enorm kunnen zijn (bij het kiezen van een suboptimale partitie-sleutel), niet samensmelten met de nieuwe kleine stukken.
En het eindigt altijd op dezelfde manier. De ruimte die door metrics in ClickHouse wordt ingenomen, groeit alleen als:
- we geen toepassing maken
OPTIMIZE ... FINALhandmatig of - geen data in alle partities continu invoeren, zodat vroeg of laat een achtergrondmerge kan plaatsvinden.
De tweede aanpak lijkt het eenvoudigst te realiseren en is daarom foutief; deze werd als eerste getest.
Ik heb een vrij eenvoudige Python-script geschreven dat fictieve metrics voor elke dag van de afgelopen 4 jaar verzond en elk uur werd uitgevoerd door cron.
Aangezien al het werk van ClickHouse DBMS is gebaseerd op het feit dat dit systeem vroeg of laat al het achtergrondwerk zal uitvoeren, maar niet bekend is wanneer, kreeg ik het niet voor elkaar om te wachten tot oude enorme stukken gebruikbaar werden voor een merge met nieuwe kleine. Het werd duidelijk dat ik een manier moest vinden om gedwongen optimalisaties te automatiseren.
Informatie in de systeemtabellen van ClickHouse
Laten we naar de structuur van de tabel . Dit is uitputtende informatie over elk stuk van alle tabellen op de ClickHouse-server. Het bevat onder andere de volgende kolommen:
- database naam (
database); - tabel naam (
table); - naam en ID van de partitie (
partition&partition_id); - wanneer het stuk is aangemaakt (
modification_time); - minimum en maximum datum in het stuk (de partitiëring is per dag) (
min_date&max_date);
Er is ook een tabel , met de volgende interessante velden:
- database naam (
Tables.database); - tabel naam (
Tables.table); - de leeftijd van de metric, wanneer de volgende aggregatie moet worden toegepast (
age);
Dus:
- We hebben een tabel met stukken en een tabel met aggregatieregels.
- We combineren hun snijpunt en krijgen alle tabellen *GraphiteMergeTree.
- We zoeken naar alle partities waar:
- meer dan één stuk
- of het tijd is om de volgende aggregatieregel toe te passen, en
modification_timeouder is dan dit moment.
Implementatie
Deze query
SELECT
    concat(p.database, '.', p.table) AS table,
    p.partition_id AS partition_id,
    p.partition AS partition,
    -- De "oudste" regel die kan worden toegepast voor
    -- de partition, maar niet in de toekomst, zie (*)
    max(g.age) AS age,
    -- Aantal stukken in de partition
    countDistinct(p.name) AS parts,
    -- De oudste metriek in de partition wordt beschouwd als 00:00:00 van de volgende dag
    toDateTime(max(p.max_date + 1)) AS max_time,
    -- Wanneer de partition geoptimaliseerd moet worden
    max_time + age AS rollup_time,
    -- Wanneer het oudste stuk in de partition is bijgewerkt
    min(p.modification_time) AS modified_at
FROM system.parts AS p
INNER JOIN
(
    -- Alle regels voor alle tabellen *GraphiteMergeTree
    SELECT
        Tables.database AS database,
        Tables.table AS table,
        age
    FROM system.graphite_retentions
    ARRAY JOIN Tables
    GROUP BY
        database,
        table,
        age
) AS g ON
    (p.table = g.table)
    AND (p.database = g.database)
WHERE
    -- Alleen actieve stukken
    p.active
    -- (*) En alleen rijen waar aggregatieregels al van toepassing moeten zijn
    AND ((toDateTime(p.max_date + 1) + g.age) < now())
GROUP BY
    table,
    partition
HAVING
    -- Alleen partitions die jonger zijn dan het optimalisatiepunt
    (modified_at  1)
ORDER BY
    table ASC,
    partition ASC,
    age ASC
geeft elk van de partitions van de tabellen *GraphiteMergeTree terug, waarvan het samenvoegen zou moeten leiden tot het vrijmaken van schijfruimte. Alleen de laatste stap blijft: ze allemaal doorlopen met de query OPTIMIZE ... FINAL. In de uiteindelijke implementatie is er ook rekening mee gehouden dat partitions met actieve schrijftoegang niet aangeraakt hoeven te worden.
Dit is precies wat het project doet . Voormalige collega's van Yandex.Market hebben het in productie getest, het resultaat is hieronder zichtbaar.
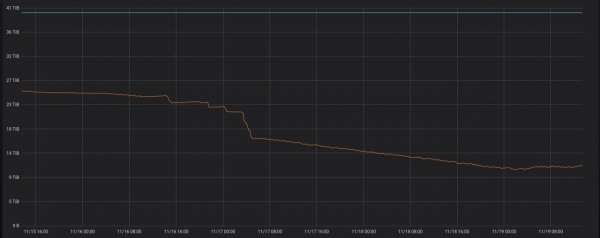
Als je het programma op een server met ClickHouse uitvoert, begint het gewoon te draaien in daemon-modus. Elke hour wordt er een query uitgevoerd om te controleren of er nieuwe partitions zijn ouder dan drie dagen die geoptimaliseerd kunnen worden.
In de nabije toekomst is het plan om in ieder geval deb-pakketten te verstrekken, en waar mogelijk ook rpm.
Ter afsluiting
In de afgelopen 9 maanden heb ik binnen mijn bedrijf veel tijd doorgebracht aan de kruising van ClickHouse en graphite-web. Het was een goede ervaring, het resultaat hiervan was de mogelijke snelle overgang van whisper naar ClickHouse als opslag voor metrics. Ik hoop dat dit artikel een soort begin is van een serie over welke verbeteringen we hebben aangebracht in verschillende onderdelen van deze stack, en wat in de toekomst zal worden gedaan.
Voor de ontwikkeling van de aanvraag zijn er verschillende liters bier en admin-dagen besteed samen met , waarvoor ik mijn dank wil uitspreken. Ook voor het beoordelen van dit artikel.
Bron: habr.com
