

In dit bericht willen we een interessante manier delen om om te gaan met de configuratie van een gedistribueerd systeem.
De configuratie wordt direct in de Scala-taal op een type-veilige manier weergegeven. Een voorbeeldimplementatie wordt in detail beschreven. Verschillende aspecten van het voorstel worden besproken, inclusief de invloed op het algemene ontwikkelingsproces.
()
Inleiding
Het bouwen van robuuste gedistribueerde systemen vereist het gebruik van correcte en coherente configuratie op alle knooppunten. Een typische oplossing is het gebruik van een tekstuele implementatiebeschrijving (terraform, ansible of iets dergelijks) en automatisch gegenereerde configuratiebestanden (vaak speciaal voor elk knooppunt/rol). We willen ook dezelfde protocollen van dezelfde versies op elk communicerend knooppunt gebruiken (anders krijgen we incompatibiliteitsproblemen). In de JVM-wereld betekent dit dat de messagingbibliotheek op alle communicerende knooppunten minstens dezelfde versie moet hebben.
Wat betreft het testen van het systeem? Natuurlijk moeten we eenheidstests voor alle componenten hebben voordat we naar integratietests gaan. Om testresultaten op runtime te extrapoleren, moeten we ervoor zorgen dat de versies van alle bibliotheken identiek zijn in zowel runtime- als testomgevingen.
Bij het uitvoeren van integratietests is het vaak veel gemakkelijker om hetzelfde classpath op alle knooppunten te hebben. We moeten gewoon zorgen dat hetzelfde classpath bij de implementatie wordt gebruikt. (Het is mogelijk om verschillende classpaths op verschillende knooppunten te gebruiken, maar het is moeilijker om deze configuratie correct weer te geven en te implementeren.) Om het simpel te houden, zullen we alleen identieke classpaths op alle knooppunten overwegen.
Configuratie heeft de neiging te evolueren samen met de software. We gebruiken meestal versies om verschillende
fasen van software-evolutie te identificeren. Het lijkt redelijk om configuratie onder versiebeheer te dekken en verschillende configuraties met enkele labels te identificeren. Als er maar één configuratie in productie is, kunnen we een enkele versie als identificator gebruiken. Soms hebben we meerdere productie-omgevingen. En voor elke omgeving hebben we misschien een aparte tak van configuratie nodig. Dus configuraties kunnen worden gelabeld met tak- en versienummers om verschillende configuraties uniek te identificeren. Elke taklabel en versie komt overeen met een enkele combinatie van gedistribueerde knooppunten, poorten, externe bronnen en classpath bibliotheekversies op elk knooppunt. Hier behandelen we alleen de enkele tak en identificeren configuraties met een drievoudige decimale versie (1.2.3), op dezelfde manier als andere artefacten.
In moderne omgevingen worden configuratiebestanden niet meer handmatig aangepast. Typisch genereren we
configbestanden tijdens de implementatie en Dus zou men zich kunnen afvragen waarom we nog steeds het tekstformaat voor configuratiebestanden gebruiken? Een levensvatbare optie is om de configuratie binnen een compilatie-eenheid te plaatsen en te profiteren van compilatietijdconfiguratievalidatie.
In dit bericht zullen we het idee onderzoeken om de configuratie in het gecompileerde artefact te houden.
Compilabele configuratie
In dit gedeelte bespreken we een voorbeeld van statische configuratie. Twee eenvoudige services — echo-service en de client van de echo-service worden geconfigureerd en geïmplementeerd. Vervolgens worden twee verschillende gedistribueerde systemen met beide services geïnstantieerd. Eén is voor een enkele knooppuntconfiguratie en de andere voor een configuratie met twee knooppunten.
Een typisch gedistribueerd systeem bestaat uit een paar knooppunten. De knooppunten kunnen worden geïdentificeerd met behulp van een soort:
sealed trait NodeId
case object Backend extends NodeId
case object Frontend extends NodeId
of gewoon
case class NodeId(hostName: String)of zelfs
object Singleton
type NodeId = Singleton.type
Deze knooppunten vervullen verschillende rollen, draaien enkele services en moeten in staat zijn om met de andere knooppunten te communiceren via TCP/HTTP-verbindingen.
Voor een TCP-verbinding is in ieder geval een poortnummer vereist. We willen er ook voor zorgen dat client en server hetzelfde protocol gebruiken. Om een verbinding tussen knooppunten te modelleren, laten we de volgende klasse verklaren:
case class TcpEndPoint[Protocol](node: NodeId, port: Port[Protocol])waar Poort is gewoon een Int binnen het toegestane bereik:
type PortNumber = Refined[Int, Closed[_0, W.`65535`.T]]Verfijnde types
Zie bibliotheek. In het kort, het stelt in staat om compileertijdbeperkingen toe te voegen aan andere types. In dit geval Int mag slechts 16-bits waarden hebben die een poortnummer kunnen vertegenwoordigen. Het is niet vereist om deze bibliotheek voor deze configuratiemethode te gebruiken. Het lijkt gewoon heel goed te passen.
Voor HTTP (REST) hebben we mogelijk ook een pad van de service nodig:
type UrlPathPrefix = Refined[String, MatchesRegex[W.`"[a-zA-Z_0-9\/]*"`.T]]
case class PortWithPrefix[Protocol](portNumber: PortNumber, pathPrefix: UrlPathPrefix)
Phantom type
Om het protocol tijdens compilatie te identificeren, gebruiken we de Scala-functie om typeargumenten te declareren Protocol dat niet in de klasse wordt gebruikt. Het is een zogenaamde phantom type. Tijdens de uitvoering hebben we zelden een instantie van de protocolidentificator nodig, daarom slaan we deze niet op. Tijdens de compilatie biedt dit phantom type extra typeveiligheid. We kunnen geen poort doorgeven met een onjuist protocol.
Een van de meest gebruikte protocollen is REST API met Json-serialisatie:
sealed trait JsonHttpRestProtocol[RequestMessage, ResponseMessage]waar RequestMessage is het basistype van berichten die de client naar de server kan sturen en ResponseMessage is het reactiebericht van de server. Natuurlijk kunnen we andere protocolbeschrijvingen maken die het communicatieprotocol met de gewenste precisie specificeren.
Voor de doeleinden van deze post gebruiken we een eenvoudigere versie van het protocol:
sealed trait SimpleHttpGetRest[RequestMessage, ResponseMessage]In dit protocol wordt het aanvraagbericht aan de url toegevoegd en het reactiebericht wordt als platte string teruggegeven.
Een serviceconfiguratie kan worden beschreven door de servicenaam, een verzameling poorten en enkele afhankelijkheden. Er zijn een paar mogelijke manieren om al deze elementen in Scala weer te geven (bijvoorbeeld, HList, algebraïsche datatypes). Voor de doeleinden van deze post gebruiken we het Cake Pattern en vertegenwoordigen we combineerbare stukken (modules) als traits. (Cake Pattern is geen vereiste voor deze compilarbare configuratiemethode. Het is slechts een mogelijke implementatie van het idee.)
Afhankelijkheden kunnen worden weergegeven met behulp van het Cake Pattern als eindpunten van andere knooppunten:
  type EchoProtocol[A] = SimpleHttpGetRest[A, A]

  trait EchoConfig[A] extends ServiceConfig {
    def portNumber: PortNumber = 8081
    def echoPort: PortWithPrefix[EchoProtocol[A]] = PortWithPrefix[EchoProtocol[A]](portNumber, "echo")
    def echoService: HttpSimpleGetEndPoint[NodeId, EchoProtocol[A]] = providedSimpleService(echoPort)
  }
De Echo-service heeft alleen een geconfigureerde poort nodig. En we verklaren dat deze poort het echo-protocol ondersteunt. Merk op dat we op dit moment geen specifieke poort hoeven op te geven, omdat traits abstracte methodedeclaraties toestaan. Als we abstracte methoden gebruiken, zal de compiler een implementatie vereisen in een configuratie-instantie. Hier hebben we de implementatie gegeven (8081) en deze zal worden gebruikt als de standaardwaarde als we deze in een specifieke configuratie overslaan.
We kunnen een afhankelijkheid in de configuratie van de echo-serviceclient declareren:
  trait EchoClientConfig[A] {
    def testMessage: String = "test"
    def pollInterval: FiniteDuration
    def echoServiceDependency: HttpSimpleGetEndPoint[_, EchoProtocol[A]]
  }
Afhankelijkheid heeft hetzelfde type als de echoService. In het bijzonder vereist het hetzelfde protocol. Daarom kunnen we er zeker van zijn dat als we deze twee afhankelijkheden verbinden, ze correct zullen werken.
Servicesimplementatie
Een service heeft een functie nodig om te starten en zich netjes af te sluiten. (De mogelijkheid om een service af te sluiten is cruciaal voor tests.) Nogmaals, er zijn een paar opties om zo'n functie voor een bepaalde configuratie op te geven (bijvoorbeeld, we zouden typeklassen kunnen gebruiken). Voor deze post gebruiken we opnieuw het Cake Pattern. We kunnen een service vertegenwoordigen met cats.Resource dat al het bracketen en het vrijgeven van middelen biedt. Om een middel te verwerven, moeten we een configuratie en een runtime-context bieden. Dus de startfunctie van de service zou er als volgt uit kunnen zien:
  type ResourceReader[F[_], Config, A] = Reader[Config, Resource[F, A]]

  trait ServiceImpl[F[_]] {
    type Config
    def resource(
      implicit
      resolver: AddressResolver[F],
      timer: Timer[F],
      contextShift: ContextShift[F],
      ec: ExecutionContext,
      applicative: Applicative[F]
    ): ResourceReader[F, Config, Unit]
  }
waar
Config— type configuratie dat vereist is door deze servicestarterAddressResolver— een runtime-object dat het vermogen heeft om echte adressen van andere knooppunten te verkrijgen ( blijf lezen voor details).
de andere types komen van cats:
F[_]— effecttype (in de eenvoudigste gevalF[A]kan gewoon zijn() => A. In deze post gebruiken wecats.IO.)Reader[A,B]— is meer of minder een synoniem voor een functieA => Bcats.Resource— heeft manieren om te verwerven en vrij te gevenTimer— stelt in staat om te slapen / tijd te metenContextShift— analoog vanExecutionContextApplicative— wrapper van functies in effect (bijna een monade) (we zouden het uiteindelijk met iets anders kunnen vervangen)
Met deze interface kunnen we een paar services implementeren. Bijvoorbeeld, een service die niets doet:
  trait ZeroServiceImpl[F[_]] extends ServiceImpl[F] {
    type Config  Resource.pure[F, Unit](())
  }
(Zie voor andere servicesimplementaties — ,
en .)
Een knooppunt is een enkel object dat een paar services uitvoert (het starten van een keten van middelen wordt mogelijk gemaakt door het Cake Pattern):
object SingleNodeImpl extends ZeroServiceImpl[IO]
  with EchoServiceService
  with EchoClientService
  with FiniteDurationLifecycleServiceImpl
{
  type Config = EchoConfig[String] with EchoClientConfig[String] with FiniteDurationLifecycleConfig
}
Merk op dat we in het knooppunt het exacte type configuratie specificeren dat nodig is door dit knooppunt. De compiler laat ons het object (Cake) niet bouwen met een onvoldoende type, omdat elke service trait een beperking op de Config type. Ook kunnen we de node niet starten zonder een complete configuratie te verstrekken.
Resolutie van node-adressen
Om een verbinding tot stand te brengen, hebben we een echt hostadres voor elke node nodig. Dit kan later bekender zijn dan andere delen van de configuratie. Daarom hebben we een manier nodig om een mapping te verstrekken tussen node-id en het werkelijke adres. Deze mapping is een functie:
case class NodeAddress[NodeId](host: Uri.Host)
trait AddressResolver[F[_]] {
  def resolve[NodeId](nodeId: NodeId): F[NodeAddress[NodeId]]
}
Er zijn een paar mogelijke manieren om zo'n functie te implementeren.
- Als we de werkelijke adressen vóór de uitrol kennen, tijdens de instantiatie van de node-hosts, dan kunnen we Scala-code genereren met de werkelijke adressen en de build daarna uitvoeren (die compileertijdcontroles uitvoert en vervolgens de integratietestsuite uitvoert). In dit geval is onze mappingfunctie statisch bekend en kan worden vereenvoudigd tot iets als een
Map[NodeId, NodeAddress]. - Soms verkrijgen we de werkelijke adressen pas later, wanneer de node daadwerkelijk wordt gestart, of hebben we geen adressen van nodes die nog niet zijn gestart. In dit geval kunnen we een ontdekkingsservice hebben die vóór alle andere nodes wordt gestart en elke node kan zijn adres in die service adverteren en zich abonneren op afhankelijkheden.
- Als we kunnen wijzigen
/etc/hosts, kunnen we vooraf gedefinieerde hostnamen gebruiken (zoalsmy-project-main-nodeenecho-backend) en deze naam gewoon koppelen aan het ip-adres tijdens de uitrol.
In dit bericht behandelen we deze gevallen niet uitgebreider. In feite hebben al onze voorbeeldnodes hetzelfde IP-adres — 127.0.0.1.
In dit bericht zullen we twee indelingen voor gedistribueerde systemen overwegen:
- Indeling met één node, waar alle services op één enkele node zijn geplaatst.
- Indeling met twee nodes, waar de service en de client op verschillende nodes zijn.
De configuratie voor een indeling is als volgt:
Configuratie voor enkele node
object SingleNodeConfig extends EchoConfig[String]
  met EchoClientConfig[String] met FiniteDurationLifecycleConfig
{
  case object Singleton \/\/ identifier van de enkele node
  \/\/ configuratie van de server
  type NodeId = Singleton.type
  def nodeId = Singleton

  \/** Type veilige servicepoort specificatie. *\/
  override def portNumber: PortNumber = 8088

  \/\/ configuratie van de client

  \/** We zullen de service gebruiken die door dezelfde host wordt aangeboden. *\/
  def echoServiceDependency = echoService

  override def testMessage: UrlPathElement = "hallo"

  def pollInterval: FiniteDuration = 1.second

  \/\/ lifecycle controller configuratie
  def lifetime: FiniteDuration = 10500.milliseconds \/\/ extra 0.5 seconden zodat er 10 aanvragen zijn, niet 9.
}
Hier creëren we een enkele configuratie die zowel server- als clientconfiguratie uitbreidt. Ook configureren we een levenscycluscontroller die normaal gesproken de client en server beëindigt nadat levensduur de tijdsperiode verstrijkt.
Dezelfde set van service-implementaties en configuraties kan worden gebruikt om een indeling van een systeem met twee afzonderlijke nodes te creëren. We hoeven alleen maar met de juiste services te creëren:
Configuratie van twee nodes
  object NodeServerConfig extends EchoConfig[String] with SigTermLifecycleConfig
  {
    type NodeId = NodeIdImpl

    def nodeId = NodeServer

    override def portNumber: PortNumber = 8080
  }

  object NodeClientConfig extends EchoClientConfig[String] with FiniteDurationLifecycleConfig
  {
    \/\/ NB! specificatie van afhankelijkheid
    def echoServiceDependency = NodeServerConfig.echoService

    def pollInterval: FiniteDuration = 1.second

    def lifetime: FiniteDuration = 10500.milliseconds \/\/ extra 0.5 seconden zodat er 10 aanvragen zijn, niet 9.

    def testMessage: String = "dolly"
  }
Zie hoe we de afhankelijkheid specificeren. We vermelden de door de andere node aangeboden service als een afhankelijkheid van de huidige node. Het type afhankelijkheid wordt gecontroleerd omdat het een fantoomtype bevat dat het protocol beschrijft. En in runtime hebben we de juiste node-id. Dit is een van de belangrijke aspecten van de voorgestelde configuratieaanpak. Het biedt ons de mogelijkheid om de poort slechts één keer in te stellen en ervoor te zorgen dat we de juiste poort aanroepen.
Implementatie van twee nodes
Voor deze configuratie gebruiken we exact dezelfde service-implementaties. Geen enkele wijziging. Echter, we creëren twee verschillende node-implementaties die een verschillende set van services bevatten:
  object TwoJvmNodeServerImpl extends ZeroServiceImpl[IO] met EchoServiceService met SigIntLifecycleServiceImpl {
    type Config = EchoConfig[String] met SigTermLifecycleConfig
  }

  object TwoJvmNodeClientImpl extends ZeroServiceImpl[IO] met EchoClientService met FiniteDurationLifecycleServiceImpl {
    type Config = EchoClientConfig[String] met FiniteDurationLifecycleConfig
  }
De eerste node implementeert de server en heeft alleen serverconfiguratie nodig. De tweede node implementeert de client en heeft een ander deel van de configuratie nodig. Beide nodes vereisen een levensduur specificatie. Voor de doeleinden van dit bericht zal de servicenode een onbegrensde levensduur hebben die beëindigd kan worden met SIGTERM, terwijl de echo-client beëindigd zal worden na de geconfigureerde eindige duur. Zie de voor details.
Algemeen ontwikkelingsproces
Laten we bekijken hoe deze aanpak de manier waarop we met configuratie werken verandert.
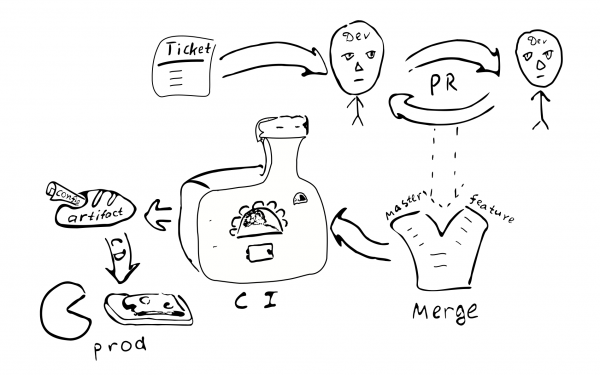
De configuratie als code wordt gecompileerd en produceert een artefact. Het lijkt redelijk om het configuratieartefact van andere code-artefacten te scheiden. Vaak kunnen we een veelheid aan configuraties op dezelfde codebasis hebben. En natuurlijk kunnen we meerdere versies van verschillende configuratietakken hebben. In een configuratie kunnen we specifieke versies van bibliotheken selecteren en dit blijft constant wanneer we deze configuratie implementeren.
Een verandering in configuratie wordt een wijziging in de code. Dus het moet worden gedekt door hetzelfde kwaliteitsborgingsproces:
Ticket -> PR -> review -> merge -> continue integratie -> continue implementatie
Er zijn de volgende gevolgen van deze aanpak:
- De configuratie is coherent voor de instantie van een bepaald systeem. Het lijkt erop dat er geen verkeerde verbinding tussen knooppunten mogelijk is.
- Het is niet gemakkelijk om de configuratie slechts in één knooppunt te wijzigen. Het lijkt onredelijk om in te loggen en enkele tekstbestanden te wijzigen. Daardoor wordt configuratiedrift minder waarschijnlijk.
- Kleine configuratiewijzigingen zijn niet eenvoudig door te voeren.
- De meeste configuratiewijzigingen volgen hetzelfde ontwikkelingsproces en worden onderworpen aan een bepaalde beoordeling.
Hebben we een aparte repository nodig voor productieconfiguratie? De productieconfiguratie kan gevoelige informatie bevatten die we uit handen van velen willen houden. Het kan daarom de moeite waard zijn om een aparte repository met beperkte toegang te behouden die de productieconfiguratie bevat. We kunnen de configuratie splitsen in twee delen: één dat de meeste open parameters van productie bevat en één dat het geheime onderdeel van de configuratie bevat. Dit zou toegang geven aan de meeste ontwikkelaars tot de overgrote meerderheid van de parameters, terwijl de toegang tot echt gevoelige zaken wordt beperkt. Dit is gemakkelijk te realiseren met tussenliggende eigenschappen met standaardparameterwaarden.
Variaties
Laten we de voor- en nadelen van de voorgestelde benadering bekijken in vergelijking met andere configuratiebeheertechnieken.
Als eerste zullen we een aantal alternatieven opsommen voor de verschillende aspecten van de voorgestelde manier van omgaan met configuratie:
- Tekstbestand op de doellocatie.
- Gecentraliseerde sleutel-waardeopslag (zoals
etcd/zookeeper). - Subprocescomponenten die opnieuw geconfigureerd/herstart kunnen worden zonder het proces opnieuw te starten.
- Configuratie buiten artefact en versiebeheer.
Een tekstbestand biedt enige flexibiliteit voor ad-hoc oplossingen. Een systeembeheerder kan inloggen op het doelknopunt, een wijziging aanbrengen en eenvoudig de service opnieuw starten. Dit is misschien niet zo goed voor grotere systemen. Er blijven geen sporen achter van de wijziging. De wijziging wordt niet door een andere persoon beoordeeld. Het kan moeilijk zijn om te achterhalen wat de wijziging heeft veroorzaakt. Het is niet getest. Vanuit het perspectief van een gedistribueerd systeem kan een beheerder simpelweg vergeten de configuratie in een van de andere knooppunten bij te werken.
(Trouwens, als er uiteindelijk behoefte aan tekstconfiguratiebestanden komt, hoeven we alleen maar een parser + validator toe te voegen die hetzelfde Config type kan produceren, en dat is voldoende om tekstconfiguraties te gaan gebruiken. Dit toont ook aan dat de complexiteit van compile-time configuratie iets kleiner is dan de complexiteit van tekstgebaseerde configuraties, omdat we in de tekstgebaseerde versie enige extra code nodig hebben.)
Gecentraliseerde sleutel-waardeopslag is een goed mechanisme voor het verspreiden van applicatiemetaparameters. Hier moeten we nadenken over wat we beschouwen als configuratiewaarden en wat alleen gegevens zijn. Gegeven een functie C => A => B noemen we meestal zelden veranderende waarden C «configuratie», terwijl vaak veranderde gegevens A — gewoon invoergegevens zijn. Configuratie moet eerder aan de functie worden geleverd dan de gegevens. A. Gegeven dit idee kunnen we zeggen dat de verwachte frequentie van wijzigingen kan worden gebruikt om configuratiegegevens van alleen gegevens te onderscheiden. Ook komen gegevens typisch uit één bron (gebruiker) en configuratie komt uit een andere bron (beheerder). Het omgaan met parameters die kunnen worden gewijzigd na de initialisatie van het proces leidt tot een toenemende complexiteit van de applicatie. Voor zulke parameters moeten we hun aflevermechanisme, parseren en validatie, en het omgaan met onjuiste waarden afhandelen. Daarom is het beter om het aantal parameters dat tijdens runtime kan veranderen te verminderen (of deze zelfs helemaal te elimineren) om de programmastructuur te vereenvoudigen.
Vanuit het perspectief van deze post moeten we een onderscheid maken tussen statische en dynamische parameters. Als de logica van de service zelden wijziging van bepaalde parameters tijdens runtime vereist, dan kunnen we ze dynamische parameters noemen. Anders zijn ze statisch en kunnen ze worden geconfigureerd met behulp van de voorgestelde benadering. Voor dynamische herconfiguratie kunnen andere benaderingen nodig zijn. Bijvoorbeeld, delen van het systeem kunnen opnieuw worden opgestart met de nieuwe configuratieparameters op een manier die lijkt op het opnieuw opstarten van aparte processen van een gedistribueerd systeem.
(Mijn bescheiden mening is om runtime-herconfiguratie te vermijden omdat dit de complexiteit van het systeem verhoogt.
Het kan eenvoudiger zijn om gewoon te vertrouwen op de ondersteuning van het besturingssysteem voor het opnieuw opstarten van processen. Hoewel, het is misschien niet altijd mogelijk.)
Een belangrijk aspect van het gebruik van statische configuratie dat mensen soms laat overwegen om dynamische configuratie te gebruiken (zonder andere redenen) is de downtime van de service tijdens de configuratie-update. Inderdaad, als we wijzigingen aan de statische configuratie moeten aanbrengen, moeten we het systeem opnieuw opstarten zodat nieuwe waarden effectief worden. De vereisten voor downtime variëren tussen verschillende systemen, dus het hoeft misschien niet zo kritisch te zijn. Als het kritisch is, moeten we vooruit plannen voor systeem-herstarts. Bijvoorbeeld, we kunnen implementeren . In dit scenario, wanneer we het systeem opnieuw moeten opstarten, starten we een nieuwe instantie van het systeem parallel, schakelen dan de ELB naar deze, terwijl we het oude systeem laten doorgaan met het afhandelen van bestaande verbindingen.
Wat betreft het houden van configuratie binnen een versieartifact of buiten? Het houden van configuratie binnen een artifact betekent in de meeste gevallen dat deze configuratie hetzelfde kwaliteitsborgingsproces heeft doorlopen als andere artifacts. Men kan er dus zeker van zijn dat de configuratie van goede kwaliteit en betrouwbaar is. Aan de andere kant betekent configuratie in een apart bestand dat er geen sporen zijn van wie en waarom wijzigingen zijn aangebracht in dat bestand. Is dit belangrijk? Wij geloven dat het voor de meeste productie-systemen beter is om een stabiele en hoogwaardige configuratie te hebben.
Version van het artifact maakt het mogelijk om te achterhalen wanneer het is aangemaakt, welke waarden het bevat, welke functies zijn in-/uitgeschakeld, wie verantwoordelijk was voor het aanbrengen van elke wijziging in de configuratie. Het kan enige moeite kosten om configuratie binnen een artifact te houden en het is een ontwerpkeuze om te maken.
Voor- en nadelen
Hier willen we enkele voordelen benadrukken en enkele nadelen van de voorgestelde benadering bespreken.
Voordelen
Kenmerken van de compileerbare configuratie van een compleet gedistribueerd systeem:
- Statische controle van configuratie. Dit biedt een hoog niveau van vertrouwen dat de configuratie correct is gezien de typebeperkingen.
- Rijke taal voor configuratie. Typisch zijn andere configuratiebenaderingen beperkt tot hooguit variabele substitutie.
Met Scala kan men een breed scala aan taalkenmerken gebruiken om de configuratie te verbeteren. Bijvoorbeeld, we kunnen traits gebruiken om standaardwaarden te bieden, objecten om verschillende scopes in te stellen, we kunnen verwijzen naarvals die slechts één keer in de buitenste scope zijn gedefinieerd (DRY). Het is mogelijk om letterlijke reeksen te gebruiken, of instanties van bepaalde klassen (Seq,Map, enz.). - DSL. Scala heeft decente ondersteuning voor DSL-schrijvers. Men kan deze functies gebruiken om een configuratietaal op te stellen die handiger en gebruiksvriendelijker is voor eindgebruikers, zodat de uiteindelijke configuratie op zijn minst leesbaar is voor domeingebruikers.
- Integriteit en coherentie over nodes. Een van de voordelen van het hebben van configuratie voor het hele gedistribueerde systeem op één plek is dat alle waarden strikt één keer zijn gedefinieerd en vervolgens in alle plaatsen waar we ze nodig hebben worden hergebruikt. Ook zorgt typeveilige poortverklaringen ervoor dat in alle mogelijke correcte configuraties de nodes van het systeem dezelfde taal spreken. Er zijn expliciete afhankelijkheden tussen de nodes, waardoor het moeilijk is om te vergeten enkele services te bieden.
- Hoge kwaliteit van wijzigingen. De algehele benadering van het doorgeven van configuratiewijzigingen via het normale PR-proces stelt hoge normen voor kwaliteit ook in de configuratie.
- Gelijktijdige configuratiewijzigingen. Wanneer we wijzigingen in de configuratie aanbrengen, zorgt automatische implementatie ervoor dat alle knooppunten worden geüpdatet.
- Vereenvoudiging van de applicatie. De applicatie hoeft de configuratie niet te parseren en valideren en hoeft geen onjuiste configuratiewaarden af te handelen. Dit vereenvoudigt de algehele applicatie. (Enkele complexiteit neemt toe in de configuratie zelf, maar dit is een weloverwogen afweging ten gunste van veiligheid.) Het is vrij eenvoudig om terug te keren naar de gewone configuratie — voeg gewoon de ontbrekende onderdelen toe. Het is makkelijker om te beginnen met gecompileerde configuratie en de implementatie van extra onderdelen uit te stellen tot een later tijdstip.
- Geverste configuratie. Aangezien configuratiewijzigingen het zelfde ontwikkelingsproces volgen, krijgen we als resultaat een artefact met een unieke versie. Dit stelt ons in staat om de configuratie terug te schakelen indien nodig. We kunnen zelfs een configuratie implementeren die een jaar geleden is gebruikt en die zal exact hetzelfde functioneren. Stabiele configuratie verbetert de voorspelbaarheid en betrouwbaarheid van het gedistribueerde systeem. De configuratie is vastgelegd tijdens de compilatie en kan niet gemakkelijk worden gemanipuleerd op een productiesysteem.
- Modulariteit. Het voorgestelde framework is modulair en modules kunnen op verschillende manieren worden gecombineerd om
verschillende configuraties (opstellingen/layouts) te ondersteunen. In het bijzonder is het mogelijk om een kleine opstelling met één knooppunt en een grootschalige multi-knooppunt setting te hebben. Het is redelijk om meerdere productie-opstellingen te hebben. - Testen. Voor testdoeleinden kan men een mockservice implementeren en deze op een type-veilige manier als afhankelijkheid gebruiken. Enkele verschillende testopstellingen met verschillende onderdelen vervangen door mocks kunnen gelijktijdig worden onderhouden.
- Integratietesten. Soms is het in gedistribueerde systemen moeilijk om integratietests uit te voeren. Met behulp van de beschreven aanpak voor type-veilige configuratie van het volledige gedistribueerde systeem, kunnen we alle gedistribueerde delen op een enkele server op een controleerbare manier uitvoeren. Het is eenvoudig om de situatie na te bootsen
wanneer een van de services niet beschikbaar wordt.
Nadelen
De gecompileerde configuratie-aanpak verschilt van de «normale» configuratie en is mogelijk niet geschikt voor alle behoeften. Hier zijn enkele van de nadelen van de gecompileerde configuratie:
- Statische configuratie. Het is misschien niet geschikt voor alle applicaties. In sommige gevallen is er een behoefte aan snel het configuratieprobleem in de productie op te lossen, waarbij alle veiligheidsmaatregelen worden omzeild. Deze aanpak maakt dat moeilijker. De compilatie en herimplementatie zijn vereist na elke wijziging in de configuratie. Dit is zowel een voordeel als een last.
- Configuratiegeneratie. Wanneer configuratie wordt gegenereerd door een automatiseringshulpmiddel, vereist deze aanpak een daaropvolgende compilatie (die op zijn beurt kan mislukken). Het kan extra inspanning vergen om deze extra stap in het buildsysteem te integreren.
- Hulpmiddelen. Er zijn vandaag de dag veel tools die afhankelijk zijn van tekstgebaseerde configuraties. Sommige hiervan
zijn niet toepasbaar wanneer de configuratie is gecompileerd. - Een verschuiving in denkwijze is nodig. Ontwikkelaars en DevOps zijn bekend met tekstconfiguratiebestanden. Het idee van het compileren van configuratie kan vreemd voor hen zijn.
- Voordat compilabele configuratie wordt geïntroduceerd, is een hoogwaardig softwareontwikkelingsproces vereist.
Er zijn enkele beperkingen van het geïmplementeerde voorbeeld:
- Als we extra configuratie bieden die niet door de knooppuntimplementatie wordt vereist, zal de compiler ons niet helpen om de ontbrekende implementatie te detecteren. Dit kan worden aangepakt door gebruik te maken van
HListof ADT's (case classes) voor knooppuntconfiguratie in plaats van traits en het Cake-patroon. - We moeten wat boilerplate in het configuratiebestand opnemen: (
package,import,objectverklaringen;
override def's voor parameters die standaardwaarden hebben). Dit kan gedeeltelijk worden aangepakt met behulp van een DSL. - In deze post behandelen we de dynamische herconfiguratie van clusters van soortgelijke knooppunten.
Conclusie
In deze post hebben we de idee besproken om configuratie direct in de source code op een type-veilige manier weer te geven. Deze aanpak kan in veel toepassingen worden gebruikt als vervanging voor xml- en andere op tekst gebaseerde configuraties. Hoewel ons voorbeeld in Scala is geïmplementeerd, kan het ook worden vertaald naar andere compileerbare talen (zoals Kotlin, C#, Swift, enz.). Men kan deze aanpak in een nieuw project proberen en, mocht het niet goed passen, overstappen op de ouderwetse manier.
Natuurlijk vereist compileerbare configuratie een hoogwaardig ontwikkelingsproces. In ruil daarvoor belooft het om een even hoogwaardig robuuste configuratie te bieden.
Deze aanpak kan op verschillende manieren worden uitgebreid:
- Men kan macro's gebruiken om configuratievalidatie uit te voeren en te falen bij compileertijd in geval van schendingen van bedrijfslogica.
- Een DSL kan worden geïmplementeerd om configuratie op een gebruiksvriendelijke manier voor de domeingebruiker weer te geven.
- Dynamisch resourcebeheer met automatische configuratie-aanpassingen. Bijvoorbeeld, wanneer we het aantal cluster-nodes aanpassen, willen we misschien (1) dat de nodes licht gewijzigde configuratie ontvangen; (2) dat de clusterbeheerder nieuwe node-informatie ontvangt.
Bedankt
Ik wil Andrey Saksonov, Pavel Popov, Anton Nehaev bedanken voor hun inspirerende feedback op het concept van deze post die me hielp het duidelijker te maken.
Bron: habr.com
