

Opmerking vertaler.: dit leerzame verhaal van Omio — de Europese reisaggregator — leidt de lezers van basisprincipes naar fascinerende praktische details in de configuratie van Kubernetes. Het kennismaken met dergelijke gevallen helpt niet alleen om de horizon te verbreden, maar ook om niet-triviale problemen te voorkomen.
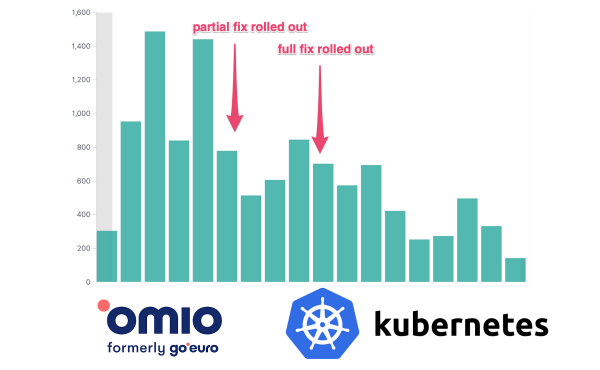
Heb je ooit ervaren dat een applicatie 'vastliep', niet meer reageerde op statusverzoeken (health checks) en dat je de oorzaak van dit gedrag niet kon begrijpen? Een van de mogelijke uitleggen heeft te maken met de limiet van CPU-bronnen. Daarover gaat dit artikel.
TL;DR:
We adviseren ten zeerste om CPU-limieten in Kubernetes (of CFS-quota in Kubelet uit te schakelen) af te schaffen als je een Linux-kernel met een CFS-quota-bug gebruikt. In de kernel is er een ernstige en bug die leidt tot overmatige throttling en vertragingen..
Bij Omio wordt alle infrastructuur beheerd door Kubernetes.Al onze stateful en stateless workloads draaien exclusief op Kubernetes (we gebruiken Google Kubernetes Engine). De afgelopen zes maanden hebben we willekeurige haperingen waargenomen. Applicaties bevriezen of reageren niet meer op health checks, verliezen verbinding met het netwerk, enzovoort. Dit gedrag heeft ons lange tijd in verwarring gebracht, en uiteindelijk hebben we besloten het probleem grondig aan te pakken.
Korte samenvatting van het artikel:
- Enkele woorden over containers en Kubernetes;
- Hoe CPU-aanvragen en limieten zijn geïmplementeerd;
- Hoe CPU-limiet werkt in omgevingen met meerdere cores;
- Hoe throttling van CPU te monitoren;
- Oplossing van het probleem en nuances.
Enkele woorden over containers en Kubernetes
Kubernetes is in essentie de moderne standaard in de wereld van infrastructuur. De belangrijkste taak is containerorkestratie.
Containers
In het verleden moesten we artefacten zoals Java JAR's/WAR's, Python Eieren of uitvoerbare bestanden creëren voor later gebruik op servers. Om ze echter te laten functioneren, was er extra werk vereist: het installeren van de runtime-omgeving (Java/Python), het plaatsen van benodigde bestanden op de juiste locaties, het zorgen voor compatibiliteit met een specifieke versie van het besturingssysteem, enzovoort. Met andere woorden, er moest veel aandacht worden besteed aan configuratiebeheer (wat vaak de oorzaak was van conflicten tussen ontwikkelaars en systeembeheerders).
Containers hebben alles veranderd. Nu is de artefact een container image. Dit kan worden gezien als een soort uitgebreide uitvoerbare bestand, dat niet alleen het programma bevat, maar ook een volledige uitvoeringsomgeving (Java/Python/…), evenals de benodigde bestanden/pakketten, voorgeïnstalleerd en klaar voor gebruik. Containers kunnen op verschillende servers worden ingezet en uitgevoerd zonder enige extra handelingen.
Bovendien werken containers in hun eigen sandbox-omgeving. Ze hebben hun eigen virtuele netwerkaart, een eigen bestandssysteem met beperkte toegang, hun eigen proces hiërarchie, hun eigen beperkingen op CPU en geheugengebruik, enzovoort. Dit alles is gerealiseerd door een speciale subsystem van de Linux-kernel – namespaces.
Kubernetes
Zoals eerder vermeld is Kubernetes een containerorchestrator. Het werkt als volgt: je geeft een pool van machines op en zegt dan: "Hé, Kubernetes, draai tien exemplaren van mijn container met 2 processors en 3 GB geheugen per stuk, en houd ze draaiende!" Kubernetes zorgt voor de rest. Het vindt beschikbare capaciteit, start de containers en herstart ze indien nodig, en voert updates uit bij versiewijzigingen, enzovoort. In essentie stelt Kubernetes je in staat om te abstraheren van de hardwarecomponent en maakt het diverse systemen geschikt voor het implementeren en draaien van applicaties.
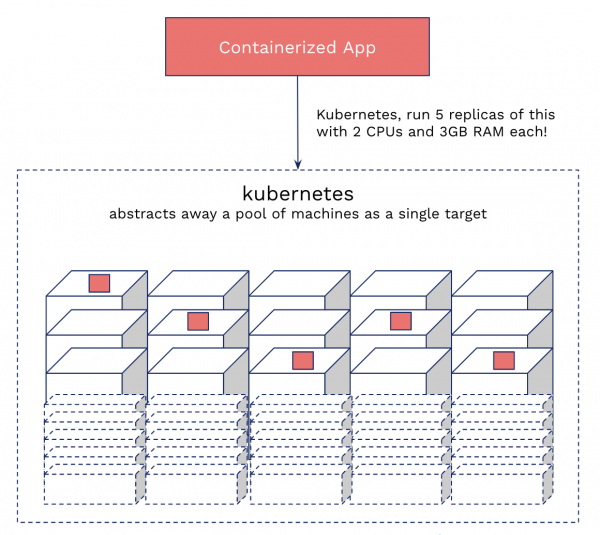
Kubernetes vanuit het perspectief van de gewone burger
Wat zijn requests en limits in Kubernetes?
Oké, we hebben de containers en Kubernetes begrepen. We weten ook dat meerdere containers op één machine kunnen staan.
Je kunt een analogie trekken met een gemeenschappelijke woning. Een ruime ruimte (machines/nodes) wordt gehuurd door meerdere huurders (containers). Kubernetes fungeert als makelaar. De vraag is: hoe voorkom je conflicten tussen huurders? Wat als één van hen bijvoorbeeld besluit de badkamer voor een halve dag te bezetten?
Precies hier komen requests en limits in beeld. CPU Request is uitsluitend voor planning. Het is iets als een "verlanglijst" van de container, en wordt gebruikt om de meest geschikte node te selecteren. Tegelijkertijd kan de CPU Beperking vergeleken worden met een huurovereenkomst — zodra we een node voor de container hebben gekozen, kan deze geen overschrijdingen hebben van de vastgestelde grenzen. En hier komt het probleem…
Hoe zijn requests en limits geïmplementeerd in Kubernetes
Kubernetes gebruikt een ingebouwd throttling-mechanisme (klokpauzes) om CPU-limits te implementeren. Als de applicatie de limiet overschrijdt, wordt throttling ingeschakeld (d.w.z. het krijgt minder CPU-cycli). Requests en limits voor geheugen zijn anders georganiseerd en dus gemakkelijker te detecteren. Het is voldoende om de laatste herstartstatus van de pod te controleren: is deze niet "OOMKilled"? Met CPU-throttling is het niet zo eenvoudig, omdat K8s alleen metingen van gebruik beschikbaar stelt, niet van cgroups.
CPU Request
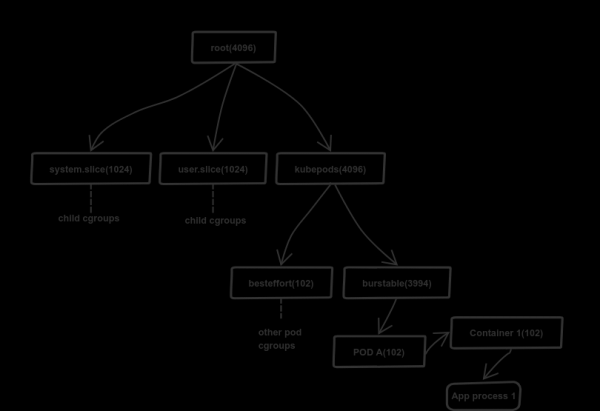
Hoe wordt een CPU request geïmplementeerd
Laten we voor de eenvoud het proces bekijken aan de hand van een machine met een 4-core CPU.
K8s gebruikt een mechanismen van controlegroepen (cgroups) voor het beheren van de toewijzing van middelen (geheugen en CPU). Voor dit doel is er een hiërarchisch model beschikbaar: een kind erft de limits van de oudergroep. Details van de toewijzing worden opgeslagen in het virtuele bestandssysteem (/sys/fs/cgroup). In het geval van de processor is dit /sys/fs/cgroup/cpu,cpuacct/*.
K8s gebruikt het bestand cpu.share voor de verdeling van CPU-middelen. In ons geval ontvangt de hoofdcontrolegroep 4096 aandelen CPU-middelen - 100% van de beschikbare CPU-kracht (1 core = 1024; dit is een vaste waarde). De hoofdgroep verdeelt middelen proportioneel op basis van de aandelen van de kinderen, die zijn vastgelegd in cpu.share, en zij op hun beurt doen hetzelfde met hun kinderen, enz. In een typische Kubernetes-knooppunt heeft de hoofdcontrolegroep drie kinderen: system.slice, user.slice en kubepods. De eerste twee subgroepen worden gebruikt voor het verdelen van middelen tussen kritieke systeemlasten en gebruikersprogramma's buiten K8s. De laatste - kubepods - wordt door Kubernetes aangemaakt voor het verdelen van middelen tussen pods.
In het bovenstaande diagram is te zien dat de eerste en tweede subgroepen elk ontvangen 1024 aandelen, terwijl de kubepod-subgroep 4096 aandelen toegewezen krijgt. Hoe is dit mogelijk: immers, de hoofdgroep heeft slechts toegang tot 4096 aandelen, en de som van de aandelen van zijn kinderen overstijgt dit aantal aanzienlijk (6144)? Het punt is dat de waarde logisch zinvol is, daarom gebruikt de Linux-scheduler (CFS) het voor de proportionele toewijzing van CPU-middelen. In ons geval ontvangen de eerste twee groepen elk 680 echte aandelen (16,6% van 4096), terwijl de kubepod de resterende 2736 aandelen krijgt. In het geval van inactiviteit zullen de eerste twee groepen de toegewezen middelen niet gebruiken.
Gelukkig biedt de planner een mechanisme om het verlies van ongebruikte CPU-bronnen te voorkomen. Het geeft 'inactieve' capaciteit door aan een globale pool, waaruit deze wordt toegewezen aan groepen die extra verwerkingskracht nodig hebben (de overdracht gebeurt in batches om verlies door afronding te voorkomen). Een soortgelijke methode wordt toegepast op alle nakomelingen van nakomelingen.
Dit mechanisme zorgt voor een eerlijke verdeling van de verwerkingscapaciteit en houdt ervoor zorg dat geen enkel proces 'bronnen steelt' van anderen.
CPU Limiet
Hoewel de configuraties van limieten en verzoeken in K8s vergelijkbaar lijken, is hun implementatie drastisch anders: dit is het meest misleidende en het minst gedocumenteerde gedeelte.
K8s gebruikt om limieten te implementeren. De instellingen worden gedefinieerd in bestanden cfs_period_us en cfs_quota_us in de cgroup-map (dezelfde map bevat het bestand cpu.share).
In tegenstelling tot cpu.share, is de quota gebaseerd op een tijdsperiode, niet op de beschikbare verwerkingscapaciteit. cfs_period_us stelt de duur van de periode (epoch) in — dit is altijd 100000 μs (100 ms). In K8s is het mogelijk om deze waarde te wijzigen, maar deze optie is momenteel alleen beschikbaar in de alfa-versie. De planner gebruikt de epoch om de gebruikte quota opnieuw in te stellen. Het tweede bestand, cfs_quota_us, stelt de beschikbare tijd (quota) in elke epoch in. Houd er rekening mee dat dit ook in microseconden wordt aangegeven. De quota kan de duur van de epoch overschrijden; met andere woorden, deze kan groter zijn dan 100 ms.
Laten we twee scenario's bekijken op 16-core machines (de meest voorkomende computerconfiguratie bij ons bij Omio):
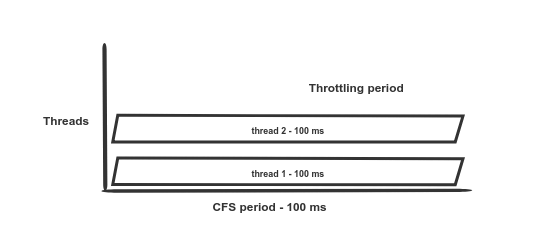
Scenario 1: 2 threads en een limiet van 200 ms. Geen throttling.
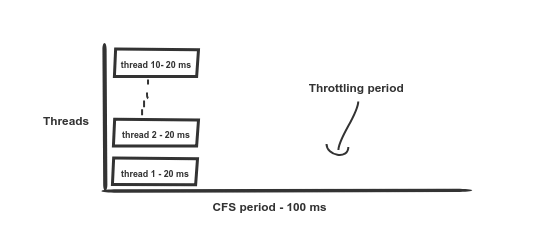
Scenario 2: 10 threads en een limiet van 200 ms. Throttling begint na 20 ms, toegang tot de CPU-bronnen herstart na nog eens 80 ms.
Stel dat je de CPU-limiet instelt op 2 cores; Kubernetes zal deze waarde omzetten naar 200 ms. Dit betekent dat de container maximaal 200 ms verwerkingstijd kan gebruiken zonder throttling.
En hier begint het interessante. Zoals hierboven vermeld, is de beschikbare quota 200 ms. Als je gelijktijdig hebt tien threads op een 12-core machine (zie de illustratie van scenario 2), terwijl alle andere pods inactief zijn, zal de quota al na 20 ms zijn uitgeput (aangezien 10 * 20 ms = 200 ms), en zullen alle threads van deze pod 'throttle' worden. (throttle) voor de volgende 80 ms. De situatie wordt verergerd door de eerder genoemde , waardoor er overmatige throttling optreedt en de container niet eens haar toegewezen quotum kan halen.
Hoe beoordeel je throttling in pods?
Voer simpelweg de pod binnen en voer uit cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— het totale aantal planningsperioden; -
nr_throttled— het aantal throttled-perioden in totaalnr_periods; -
throttled_time— de totale throttled-tijd in nanoseconden.
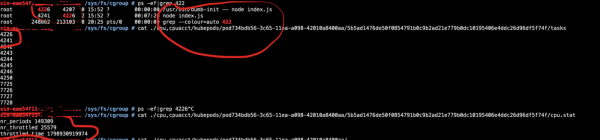
Wat gebeurt er daadwerkelijk?
Uiteindelijk ervaren we hoge throttling in alle applicaties. Soms is het anderhalve keer sterker dan berekend!
Dit leidt tot verschillende fouten — falen van readiness checks, vastlopen van containers, onderbrekingen van netwerkverbindingen, time-outs binnen servicecalls. Uiteindelijk resulteert dit in verhoogde latentie en een toename van het aantal fouten.
Oplossing en gevolgen
Het is eenvoudig. We hebben de CPU-limieten opgeheven en zijn begonnen met het updaten van de OS-kernel in de clusters naar de meest recente versie, waarin de bug was verholpen. Het aantal fouten (HTTP 5xx) in onze services daalde onmiddellijk aanzienlijk:
HTTP 5xx-fouten
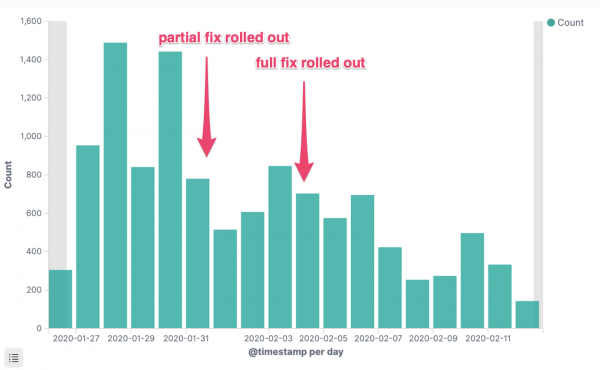
HTTP 5xx-fouten van één kritiek belangrijke service
P95 Reactietijd
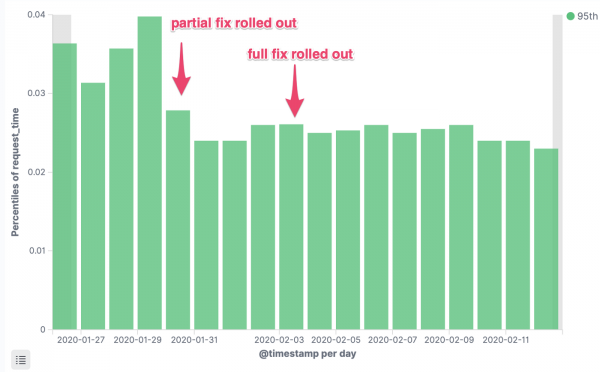
Vertraging van aanvragen voor een kritieke service, 95e percentiel
Operationele kosten
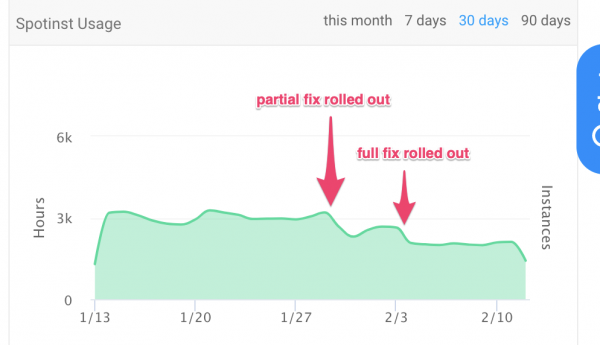
Aantal verbruikte instance-uren
Wat is de catch?
Zoals aan het begin van het artikel werd vermeld:
Je kunt het vergelijken met een gedeeld appartement… Kubernetes fungeert als de makelaar. Maar hoe houd je huurders uit elkaar?
Dat is de catch. Eén slordige container kan alle beschikbare CPU-bronnen op de machine opslokken. Als je een goed functionerende applicatiestack hebt (zoals correct geconfigureerde JVM's, Go, Node VM), dan is dat geen probleem: je kunt lange tijd onder zulke omstandigheden werken. Maar als de applicaties slecht of helemaal niet geoptimaliseerd zijn (FROM java:latest), kan de situatie uit de hand lopen. Bij Omio hebben we geautomatiseerde basis Dockerfiles met redelijke standaardinstellingen voor de belangrijkste taalstacks, dus dat probleem heeft zich niet voorgedaan.
We raden aan om de metrics in de gaten te houden. (gebruik, verzadiging en fouten), API-vertragingen en foutfrequentie. Zorg ervoor dat de resultaten aan de verwachtingen voldoen.
Links
Dit is ons verhaal. De volgende materialen hebben ons enorm geholpen om te begrijpen wat er aan de hand is:
- ;
- ;
- ;
- ;
- — zoek naar 'cpu throttling'.
Kubernetes foutmeldingen:
- ;
- ;
- .
Heb je soortgelijke problemen ervaren in je praktijk of heb je ervaring met throttling in gecontaineriseerde productieomgevingen? Deel je verhaal in de reacties!
P.S. van de vertaler
Lees ook op onze blog:
- «»;
- «»;
- «».
Bron: habr.com
