

Dit zijn precies de klachten die ik van onze ontwikkelaars heb gehoord. Het meest interessante is dat het waar bleek te zijn, wat leidde tot een langdurig onderzoek. Het gaat over SQL-servers die wij op VMware draaien.
Eigenlijk is het heel eenvoudig om ervoor te zorgen dat de production server hopeloos achterblijft bij de laptop. Voer (niet op tempdb en niet op een database met ingeschakelde Delayed Durability) de volgende code uit:
set nocount on
create table _t (v varchar(100))
declare @n int=300000
while @n>0 begin
  insert into _t select 'Wat een langzame!'
  delete from _t
  set @n=@n-1
  end
GO
drop table _t
Op mijn desktop draait het in 5 seconden, terwijl het op de production server 28 seconden duurt. Omdat SQL moet wachten op de fysieke voltooiing van de opname in de transaction log, terwijl we hier erg korte transacties uitvoeren. Grof gezegd, we hebben een grote krachtige vrachtwagen de stadsverkeer ingeduwd en zien hoe bezorgers op scooters er vlot voorbijsnellen — throughput doet er hier niet toe, alleen latency. En geen enkele netwerkschijf, hoe duur ook, kan het opnemen tegen de latency van een lokale SSD.
(In de reacties bleek dat ik loog — ik had in beide gevallen delayed durability ingeschakeld. Zonder delayed durability krijg je:
Desktop — 39 seconden, 15K tr/sec, 0.065ms /io roundtrip
PROD — 360 seconden, 1600 tr/sec, 0.6ms
Ik had moeten opmerken dat het wel erg snel was)
Echter, in dit geval hebben we te maken met triviale nullen van de Riemann-functie met een triviaal voorbeeld. In het voorbeeld dat de ontwikkelaars me gaven, was het anders. Ik heb bevestigd dat ze gelijk hadden en begon al hun specifieke bedrijfslogica uit het voorbeeld te verwijderen. Op een gegeven moment realiseerde ik me dat ik hun code volledig kon weggooien en mijn eigen kon schrijven — die hetzelfde probleem demonstreert — op productie draait het 3-4 keer langzamer:
create function dbo.isPrime (@n bigint)
returns int
as
  begin
  if @n = 1 return 0
  if @n = 2 return 1
  if @n = 3 return 1
  if @n % 2 = 0 return 0
  declare @sq int
  set @sq = sqrt(@n)+1 -- controleer oneven nummers tot sqrt
  declare @dv int = 1
  while @dv < @sq
    begin
	set @dv=@dv+2
	if @n % @dv = 0 return 0
	end
  return 1
  end
GO
declare @dt datetime set @dt=getdate()
select dbo.isPrime(1000000000000037)
select datediff(ms,@dt,getdate()) as ms
GO
Als alles goed gaat, duurt de controle op de priemgetal 6-7-8 seconden. Zo was het in verschillende gevallen. servers. Maar in sommige gevallen duurde het 25-40 seconden. Wat interessant is, er waren geen servers waar het 14 seconden duurde — de code werkte ofwel erg snel of helemaal traag, wat betekent dat het probleem, laten we zeggen, zwart-wit was.
Wat heb ik gedaan? Ik ging de VMware-statistieken in. Alles leek in orde — er waren voldoende bronnen, Ready time = 0, alles was voldoende, zowel op snelle als op langzame servers was de CPU=100 op één vCPU. Ik deed een test voor het berekenen van Pi — de test toonde vergelijkbare resultaten op alle servers. Het begon steeds meer naar zwarte magie te ruiken.
Toen ik op de DEV-farm aankwam, begon ik met de servers te experimenteren. Het bleek dat vMotion van host naar host een server kan 'genezen', maar ook een 'snelle' server in een 'langzame' kan veranderen. Het lijkt erop dat sommige hosts een probleem hebben... maar... nee. Een bepaalde virtuele machine stopte op host A maar werkte snel op host B. En een andere virtuele machine werkte daarentegen snel op A en stopte op B! Op de host waren vaak zowel 'snelle' als 'langzame' machines actief!
Vanaf dat moment rook het duidelijk naar zwavel in de lucht. Het probleem kon niet worden toegeschreven aan de virtuele machine (windows-patches, bijvoorbeeld) — want die werd 'snel' tijdens vMotion. Maar het probleem kon ook niet aan de host worden toegeschreven — want daarop konden zowel 'snelle' als 'langzame' machines draaien. Het had ook niets met de belasting te maken — ik kreeg een 'langzame' machine op een host waar verder niets anders draaide.
Uit wanhoop opende ik Process Explorer van Sysinternals en keek naar de SQL-stack. Op de langzame machines viel me onmiddellijk de volgende regel op:
ntoskrnl.exe!KeSynchronizeExecution+0x5bf6
ntoskrnl.exe!KeWaitForMultipleObjects+0x109d
ntoskrnl.exe!KeWaitForMultipleObjects+0xb3f
ntoskrnl.exe!KeWaitForSingleObject+0x377
ntoskrnl.exe!KeQuerySystemTimePrecise+0x881 < — !!!
ntoskrnl.exe!ObDereferenceObjectDeferDelete+0x28a
ntoskrnl.exe!KeSynchronizeExecution+0x2de2
sqllang.dll!CDiagThreadSafe::PxlvlReplace+0x1a20
… overgeslagen
sqldk.dll!SystemThread::MakeMiniSOSThread+0xa54
KERNEL32.DLL!BaseThreadInitThunk+0x14
ntdll.dll!RtlUserThreadStart+0x21
Dit was al iets. Er was een programma geschreven:
    class Program
    {
        [DllImport("kernel32.dll")]
        static extern void GetSystemTimePreciseAsFileTime(out FILE_TIME lpSystemTimeAsFileTime);

        [StructLayout(LayoutKind.Sequential)]
        struct FILE_TIME
        {
            public int ftTimeLow;
            public int ftTimeHigh;
        }

        static void Main(string[] args)
        {
            for (int i = 0; i < 16; i++)
            {
                int counter = 0;

                var stopwatch = Stopwatch.StartNew();

                while (stopwatch.ElapsedMilliseconds  0)
                {
                    Console.WriteLine("{0}", counter);
                }
            }
        }
    }
Dit programma toonde een nog opvallendere vertraging — op 'snelle' machines laat het 16-18 miljoen cycli per seconde zien, terwijl het op langzame machines anderhalf miljoen of zelfs 700 duizend is. Dit betekent dat het verschil 10-20 keer is (!!!). Dit was al een kleine overwinning: in ieder geval was er geen gevaar om vast te komen zitten tussen Microsoft en VMware support, zodat ze elkaar de schuld gaven.
Daarna stopte de vooruitgang — vakantie, belangrijke zaken, een virale hysterium en een plotselinge toename van de belasting. Ik heb vaak het magische probleem aan collega's genoemd, maar soms leek het wel alsof ze me niet altijd geloofden — de verklaring dat VMware de code met 10-20 keer vertraagt was te monsterachtig.
Ik heb zelf geprobeerd uit te vissen wat de vertraging veroorzaakte. Soms leek het alsof ik de oplossing vond — het in- en uitschakelen van Hot plugs, het wijzigen van het geheugenvolume of het aantal processors maakte de machine vaak 'snel'. Maar niet voor altijd. Wat wel waar bleek te zijn, is dat het genoeg is om naar buiten te gaan en op het wiel te kloppen — dat wil zeggen, de elk virtuele instellingen te wijzigen.
Uiteindelijk vonden mijn Amerikaanse collega's plotseling de root cause.
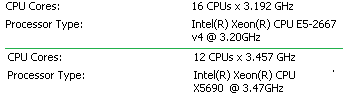
De hosts verschilden in frequentie!
- Over het algemeen is dat niet erg. Maar: bij het verhuizen van de 'thuis'-host naar een host met een 'andere' frequentie moet VMware het resultaat van GetTimePrecise corrigeren.
- Over het algemeen is dit niet erg, tenzij er een applicatie is die miljoenen keren per seconde de exacte tijd vraagt, zoals SQL Server.
- Maar dat is ook niet erg, omdat SQL Server dit lang niet altijd doet (zie Conclusie).
Maar er zijn gevallen waarin deze hobbels echt pijn doen. En ja, door op het wiel te kloppen (iets in de VM-instellingen te veranderen) dwong ik VMware om de configuratie 'opnieuw te berekenen', en de frequentie van de huidige host werd de 'thuis'-frequentie van de machine.
Oplossing
Wanneer je de virtualisatie van de TSC uitschakelt, retourneert het lezen van de TSC vanuit de virtuele machine de TSC-waarde van de fysieke machine, en het schrijven van de TSC vanuit de virtuele machine heeft geen effect. Het migreren van de virtuele machine naar een andere host, deze hervatten vanuit de gesuspendeerde staat of terugkeren naar een momentopname veroorzaakt dat de TSC discontinu sprongen. Sommige gastbesturingssystemen starten niet op, of vertonen andere problemen met tijdregistratie, wanneer de TSC-virtualisatie is uitgeschakeld. In het verleden is deze functie soms aanbevolen om de prestaties van applicaties die de TSC vaak lezen te verbeteren., maar de prestaties van de virtuele TSC zijn in de huidige producten aanzienlijk verbeterd. De functie wordt ook aanbevolen voor gebruik bij het uitvoeren van metingen die een precieze bron van real-time in de virtuele machine vereisen.
Kortom, er moet een parameter worden toegevoegd.
monitor_control.virtual_rdtsc = FALSE
Conclusie
Je vraagt je misschien af: waarom zou je GetTimePrecise zo vaak aanroepen in SQL?
Ik heb geen toegang tot de SQL server-bronbestanden, maar de logica zegt het volgende. SQL is eigenlijk bijna een besturingssysteem met coöperatieve gelijktijdigheid, waar elke thread af en toe 'moet wijken'. En waar gebeurt dat het beste? Op plaatsen waar er natuurlijke wachttijd is — zoals bij lock of I/O. Maar wat als we computationele lussen draaien? Dan is de duidelijkste en bijna enige plek — in de interpreter (het is niet helemaal een interpreter), na het uitvoeren van de volgende instructie.
Over het algemeen wordt SQL server niet gebruikt voor puur rekenwerk en dat is geen probleem. Maar lussen die werken met tijdelijke tabellen (die meteen worden gecached) maken de code tot een reeks zeer snel uitgevoerde instructies.
Overigens, als je de functie verbergt in NATIVELY COMPILED, stopt het met het aanvragen van tijd en wordt de snelheid ervan tien keer hoger. Maar hoe zit het met coöperatieve multitasking? Juist voor native compiled code moest SQL PREEMPTIVE MULTITASKING implementeren.
Bron: habr.com
