

We discuss the people of the future who decode organic big data. Over the last two decades, the amount of biological data that can be analyzed has increased dramatically thanks to the decoding of the human genome. Before this, we could not have imagined that the information literally contained in our blood could determine our ancestry, check how the body will respond to certain medications, and even alter our biological inheritance.
This and other articles are released first on our website. Happy reading.
The attributes of an average bioinformatician are similar to those of a programmer — red eyes, a hunched posture, and coffee cup stains on the desk. However, at this desk, work is not done on abstract algorithms and commands but on the very code of nature, which can tell us a lot about ourselves and the world around us.
Specialists in this field deal with enormous volumes of data (for example, the sequencing results of a single person's genome take up about 100 gigabytes). Therefore, processing such a large amount of information requires Data Science approaches and tools. It is logical that a successful bioinformatician must be knowledgeable not only in biology and chemistry but also in data analysis methods, statistics, and mathematics — which makes this profession quite rare and in demand. Such specialists are especially needed in the fields of innovative medicine and drug development. Technology giants like IBM and Intel dedicated to the study of bioinformatics.
What is needed to become a bioinformatician?
- Biology and chemistry (university level);
- Mathematical statistics, linear algebra, probability theory;
- Programming languages (Python and R, often also using C++);
- For structural bioinformatics: understanding of mathematical analysis and differential equations theory.
One can enter the field of bioinformatics with either a biological background or knowledge of programming and mathematics. For the former, working with ready-made bioinformatics programs is suitable, while for the latter, a more algorithmic profile of the specialty will be appropriate.
What do bioinformaticians do?
Moderne bio-informatica is onderverdeeld in twee belangrijke takken: structurele bio-informatica en sequentie bio-informatica. In het eerste geval zien we een persoon die voor de computer zit en programma's uitvoert die helpen bij het bestuderen van biologische objecten (zoals DNA of eiwitten) in 3D-visualisaties. Ze bouwen computer modellen die voorspellen hoe een geneesmiddelenmolecule zal interageren met een eiwit, hoe de ruimtelijke structuur van het eiwit in de cel eruitziet, welke eigenschappen de moleculen verklaren hoe ze interageren met cellulaire structuren, enzovoort.
Methoden van structurele bio-informatica worden actief gebruikt in zowel de academische wetenschap als de industrie: het is moeilijk voor te stellen dat een farmaceutisch bedrijf zonder dergelijke specialisten kan. In de afgelopen jaren hebben computertechnieken het proces van het zoeken naar potentiële geneesmiddelen drastisch vereenvoudigd, waardoor de farmaceutische ontwikkeling een veel snellere en goedkopere aangelegenheid is geworden.
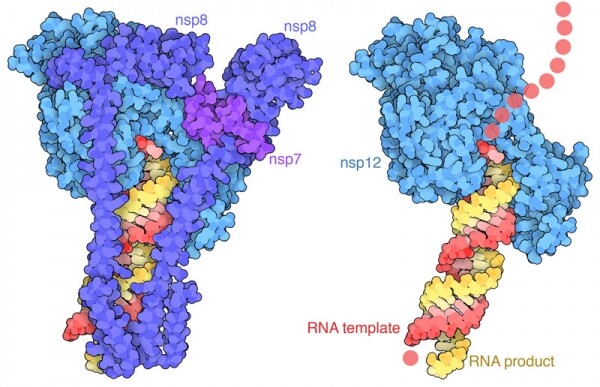
RNA-afhankelijke RNA-polymerase SARS-CoV-2 (links), evenals de verbinding met het RNA-duplex.
Wat is een genoom?
Een genoom is alle informatie over de structuur van de erfelijkheid van een organisme. Bijna alle levende wezens dragen hun genoom in de vorm van DNA, maar er zijn organismen die hun erfelijke informatie in de vorm van RNA doorgeven. Het genoom wordt van ouders op kinderen overgedragen en gedurende dit overdrachtsproces kunnen fouten optreden — mutaties.
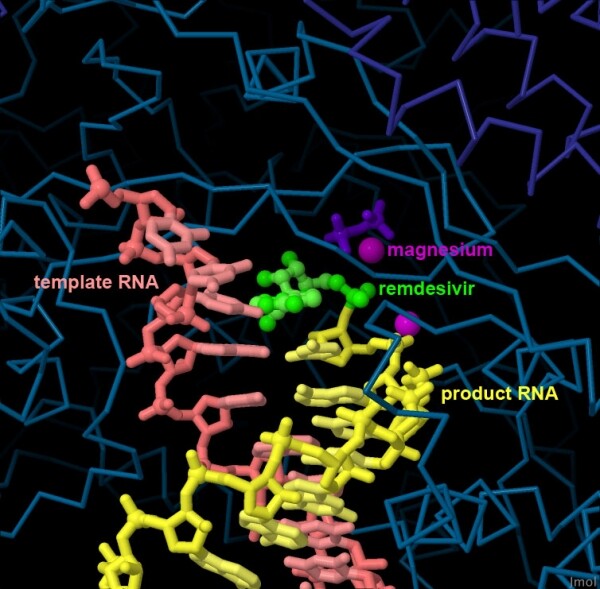
De interactie van het medicijn remdesivir met het RNA-afhankelijke RNA-polymerase van het SARS-CoV-2 virus.
Sequentiebio-informatica werkt met een hoger niveau van organisatie van levende materie — beginnend bij afzonderlijke nucleotiden, DNA en genen, en eindigend met volledigegenomen en hun vergelijkingen met elkaar.
Stel je voor dat iemand voor zich een reeks letters van het alfabet ziet (maar niet een gewoon alfabet, eerder een genetisch of aminozuuralfabet) en naar patronen zoekt, deze verklaart en bevestigt met behulp van statistiek en computermethoden. De bio-informatica van sequenties verklaart welke mutatie verbonden is met bepaalde ziekten of waarom schadelijke stoffen zich in het bloed van een patiënt ophopen. Naast medische gegevens bestuderen bio-informatica van sequenties de patronen van verspreiding van organismen over de aarde, populatieverschillen tussen groepen dieren, alsook de rollen en functies van specifieke genen. Dankzij deze wetenschap kunnen we de effectiviteit van medicijnen testen en de biologische mechanismen bestuderen die hun werking verklaren.
Bijvoorbeeld, door bio-informatica analyse zijn mutaties ontdekt en beschreven die leiden tot de ontwikkeling van taaislijmziekte — een monogene aandoening veroorzaakt door een defect in het gen van een van de chloridekanalen. Ook weten we nu veel beter wie de naaste biologische verwant van de mens is en hoe onze voorouders zich over de planeet hebben verspreid. Bovendien kan elke persoon die zijn genoom laat analyseren, ontdekken waar zijn of haar afkomst ligt en tot welke etnische groep hij of zij behoort. Tal van buitenlandse (, ) en Russische (, ) diensten bieden deze service aan voor een relatief lage prijs (ongeveer 20.000 roebel).
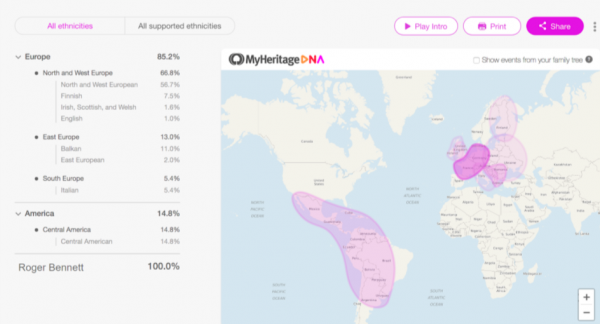
De resultaten van de DNA-testanalyse over afkomst en populatiebehoor van MyHeritage.
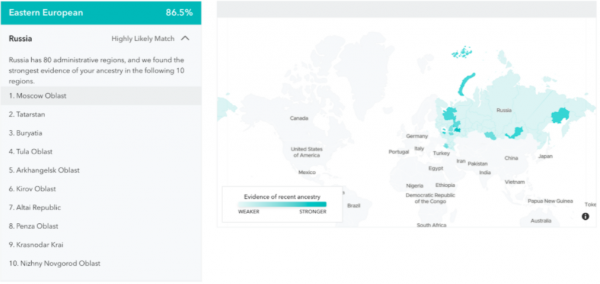
De resultaten van de DNA-testanalyse over populatiebehoor van 23andMe.
Hoe lees je een genoom?
Tegenwoordig is genoomsequencing een routineprocedure die voor iedereen die dat wenst ongeveer duizend roebel kost (inclusief in Rusland). Om je genoom te lezen, moet je simpelweg bloed uit een ader in een speciaal laboratorium laten nemen: na twee weken ontvang je het resultaat met een gedetailleerde beschrijving van je genetische kenmerken. Naast je eigen genoom kun je ook de genomen van de darmmicrobiota analyseren: je leert over de kenmerken van de bacteriën die je spijsverteringssysteem bewonen, en je krijgt advies van een professionele diëtist.
Het genoom kan op verschillende manieren worden gelezen, waarbij de zogenaamde 'next-generation sequencing' momenteel een van de belangrijkste methoden is. Om deze procedure uit te voeren, moeten eerst biologische monsters worden verkregen. In elke cel van het organisme is het genoom identiek, daarom worden meestal bloedmonsters genomen (dit is het gemakkelijkst). Vervolgens worden de cellen afgebroken en wordt het DNA gescheiden van de rest. Daarna wordt het verkregen DNA in veel kleine stukjes gehakt en worden speciale adapters - kunstmatig gesynthetiseerde bekende nucleotidenvolgordes - aan elk van deze stukjes 'genaaid'. Daarna worden de DNA-ketens gescheiden en worden de enkele ketens met behulp van adapters aan een speciale plaat bevestigd waarop de sequencing plaatsvindt. Tijdens de sequencing worden complementaire fluorescent gelabelde nucleotiden aan de DNA-volgorde toegevoegd. Elke gelabelde nucleotide zendt, wanneer hij zich bindt, een bundel licht van een bepaalde golflengte uit, wat door de computer wordt geregistreerd. Zo leest de computer korte volgordes van het oorspronkelijke DNA, die vervolgens met behulp van speciale algoritmen worden samengevoegd tot het oorspronkelijke genoom.
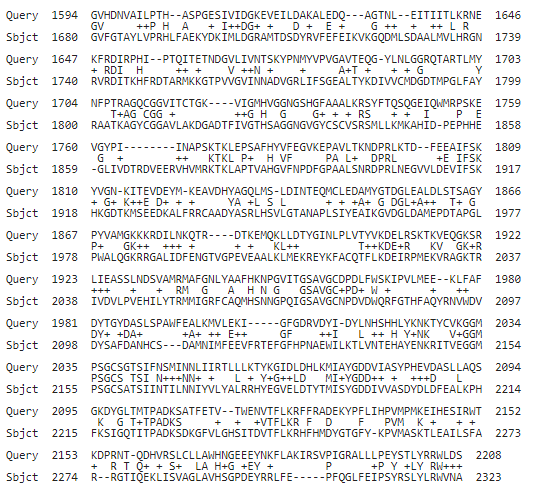
Voorbeeld van gegevens waarmee bioinformatici werken: uitlijning van aminozuurvolgordes.
Waar werken bioinformatici en wat verdienen ze?
De carrière van een bioinformaticus wordt traditioneel verdeeld in twee hoofdgebieden: industrie en wetenschap. Een academische carrière voor een bioinformaticus begint meestal met een promotieplaats aan een van de grote instituten. Eerst ontvangen bioinformatici een basissalaris, dat afhankelijk is van hun instituut, het aantal subsidies waaraan zij deelnemen en hun aantal affiliaties - plaatsen waar zij officieel zijn aangesteld. Na verloop van tijd groeit het aantal subsidies en affiliaties, en na een paar jaar in de academische wereld verdient een bioinformaticus zonder problemen een gemiddeld salaris (70-80 duizend roebel), maar veel hangt af van de inzet en hard werken. De meest ervaren bioinformatici leiden uiteindelijk hun eigen laboratoria binnen hun specialisatie.
Waar kun je bioinformatica studeren?
- MSU - Faculteit van Bioengineering en Bioinformatica
- HSE - Data-analyse in Biologie en Geneeskunde (masterprogramma)
- MFTI — кафедra bio-informatica
- Instituut voor bio-informatica (NKO)
In tegenstelling tot de academie, zal in de industrie niemand zijn tijd besteden aan het opleiden van een werknemer in de benodigde vaardigheden, waardoor de toegang daar meestal moeilijker is. Het carrièrepad van een bio-informaticus in de industrie varieert sterk afhankelijk van zijn specialisatie en werkplek. Gemiddeld schommelt het salaris in dit gebied duizend roebel, afhankelijk van ervaring en specialisatie.
Bekende bio-informatici
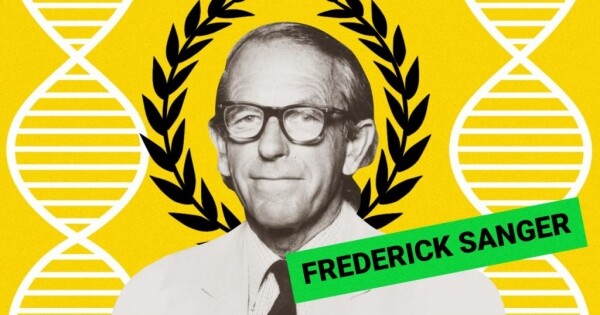
De geschiedenis van de bio-informatica kan worden herleid tot Frederik Sanger, een Engelse wetenschapper die in 1980 de Nobelprijs voor de Scheikunde ontving voor de ontdekking van een methode om DNA-sequenties te lezen. Sindsdien worden de methoden voor het lezen van sequenties elk jaar verbeterd, maar de methode van 'Sanger-sequencing' diende als basis voor alle verdere onderzoeken op dit gebied.
Trouwens, veel programma's die specifiek door Russische wetenschappers zijn ontwikkeld, worden tegenwoordig wereldwijd veel gebruikt — bijvoorbeeld de genoomassembler , — St. Petersburg genome assembler, ontwikkeld aan het Instituut in Sint-Petersburg, helpt wetenschappers over de hele wereld korte DNA-sequenties samen te voegen tot grote sequenties om de oorspronkelijke genomen van organismen te reconstrueren.
Ontdekkingen en prestaties in de bio-informatica
Tegenwoordig doen bio-informatici talloze waardevolle ontdekkingen. Het zou onmogelijk zijn geweest om medicijnen tegen het coronavirus te ontwikkelen zonder het ontcijferen van zijn genoom en de complexe bio-informatica-analyse van de processen die zich tijdens de ziekte voordoen. Internationale wetenschappers konden met behulp van vergelijkende genomicamethodes en machine learning begrijpen wat coronavirussen gemeen hebben met andere pathogenen.
Het bleek dat een van zulke kenmerken — het versterkte signalen van nucleaire localisatie (NLS) van pathogene virussen dat plaatsvindt tijdens de evolutie. Dit onderzoek kan helpen bij het bestuderen van virusstammen die potentieel gevaarlijk voor de mens kunnen zijn in de toekomst, en wellicht het voortijdig ontwikkelen van medicijnen stimuleren.
Bovendien hebben bio-informatici een sleutelrol gespeeld in de ontwikkeling van nieuwe methoden voor genbewerking, met name het CRISPR/Cas9-systeem (een technologie die is gebaseerd op het immuunsysteem ). Dankzij bio-informatica-analyse van de datastructuren van eiwitten en hun evolutionaire ontwikkeling is de nauwkeurigheid en effectiviteit van dit systeem in de afgelopen jaren sterk toegenomen, wat het mogelijk maakte om genoom van veel organismen (inclusief mensen) gericht te bewerken.
Ontvang een gewilde beroepskwalificatie vanaf nul of verbeter je vaardigheden en salaris door online cursussen bij SkillFactory te volgen:
Meer cursussen
Bron: habr.com
