

Op welke principes is een ideale Data Warehouse gebaseerd?
Focus op bedrijfwaarde en analytics zonder boilerplate code. Beheer van DWH als codebasis: versionering, review, automatisch testen en CI. Modulariteit, schaalbaarheid, open source en gemeenschap. Gebruiksvriendelijke documentatie en visualisatie van afhankelijkheden (Data Lineage).
Meer hierover en de rol van DBT in het Big Data & Analytics ecosysteem — welkom onder de kat.
Hallo allemaal
Hier is Artemiy Kozyr. Ik werk al meer dan 5 jaar met data warehouses, houd me bezig met het opzetten van ETL/ELT, evenals data-analyse en visualisatie. Momenteel werk ik bij , geef les bij OTUS in de cursus , en vandaag wil ik een artikel met jullie delen dat ik heb geschreven ter voorbereiding op de start van een nieuwe set voor de cursus.
Korte samenvatting
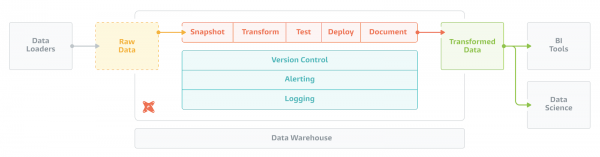
Het DBT-framework gaat helemaal over de letter T in de afkorting ELT (Extract — Transform — Load).
Met de opkomst van krachtige en schaalbare analytische databases zoals BigQuery, Redshift, Snowflake, is er geen enkele reden meer om transformaties buiten de Data Warehouse te doen.
DBT laadt geen gegevens vanuit bronnen, maar biedt enorme mogelijkheden voor het werken met de gegevens die al in het Warehouse zijn geladen (in Internal of External Storage).
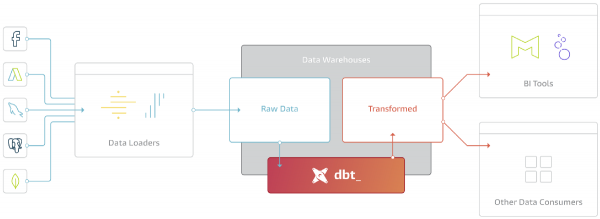
De belangrijkste taak van DBT is om de code te nemen, deze te compileren naar SQL en de commando's in de juiste volgorde in het Warehouse uit te voeren.
Structuur van het DBT-project
Het project bestaat uit slechts twee soorten directories en bestanden:
- Model (.sql) — een eenheid van transformatie, uitgedrukt als een SELECT-query
- Configuratiebestand (.yml) — parameters, instellingen, tests, documentatie
Op basisniveau werkt het als volgt:
- De gebruiker bereidt de code voor modellen voor in elke gewenste IDE.
- Met behulp van de CLI wordt het starten van de modellen aangeroepen, DBT compileert de code van de modellen naar SQL.
- De gecompileerde SQL-code wordt in het Warehouse uitgevoerd in de opgegeven volgorde (grafiek).
Zo kan een start vanuit de CLI eruitzien:
Alles is SELECT
Dit is de killer-feature van het Data Build Tool-framework. Met andere woorden, DBT abstraheert alle code die verband houdt met de materialisatie van uw queries in het Warehouse (variaties van commando's zoals CREATE, INSERT, UPDATE, DELETE ALTER, GRANT, …).
Elk model impliceert het schrijven van één SELECT-query die de resulterende dataset bepaalt.
De logica van de transformaties kan meerdere niveaus hebben en gegevens uit verschillende andere modellen consolideren. Een voorbeeld van een model dat een bestelfront (f_orders) opbouwt:
{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

met orders als (

 select * from {{ ref('stg_orders') }}

),

order_payments als (

 select * from {{ ref('order_payments') }}

),

eindresultaat als (

 select
 orders.order_id,
 orders.customer_id,
 orders.order_date,
 orders.status,
 {% for payment_method in payment_methods -%}
 order_payments.{{payment_method}}_amount,
 {% endfor -%}
 order_payments.total_amount as amount
 from orders
 left join order_payments using (order_id)
)

select * from eindresultaat
Wat kunnen we hier interessant zien?
Ten eerste: CTE's (Common Table Expressions) zijn gebruikt — voor de organisatie en begrip van de code die veel transformaties en businesslogica bevat.
Ten tweede: De modelcode is een mix van SQL en (templating language).
In het voorbeeld wordt een lus gebruikt voor om de som voor elke betalingsmethode, genoemd in de expressie, te vormen set. Ook wordt de functie ref gebruikt — de mogelijkheid om in de code naar andere modellen te verwijzen:
- Tijdens de compilatie ref zal het worden omgezet in een doeltabel of weergave in de Data Warehouse
- ref maakt het mogelijk om een afhankelijkheidsgrafiek van modellen op te bouwen.
Precies biedt in DBT bijna onbeperkte mogelijkheden. De meest gebruikte zijn:
- If / else statements — vertakkingsoperators.
- For loops — lussen.
- Variables — variabelen.
- Macro — het maken van macro's.
Materialisatie: Table, View, Incremental.
De Materialisatiestrategie is een benadering waarbij de resulterende dataset van het model in het Data Warehouse wordt opgeslagen.
In de basis betekent dit:
- Table — een fysieke tabel in het Data Warehouse.
- View — een weergave, een virtuele tabel in het Data Warehouse.
Er zijn ook complexere materialisatiestrategieën:
- Incremental — incrementeel laden (van grote feitentabellen); nieuwe rijen worden toegevoegd, gewijzigde worden bijgewerkt, verwijderde worden verwijderd.
- Ephemeral — het model wordt niet direct gematerialiseerd, maar doet mee als CTE in andere modellen.
- Elke andere strategie die je zelf kunt toevoegen.
Naast de materialisatiestrategieën ontstaan er mogelijkheden voor optimalisatie voor specifieke Data Warehouses, bijvoorbeeld:
- Snowflake: Transiente tabellen, samenvoeggedrag, tabelclustering, kopiëren van bevoegdheden, veilige weergaves.
- Redshift: Distkey, Sortkey (interleaved, compound), Late Binding Views.
- BigQuery: Tabelpartionering & clustering, samenvoeggedrag, KMS-encryptie, Labels & Tags.
- Spark: Bestandsindelingen (parquet, csv, json, orc, delta), partition_by, clustered_by, buckets, incremental_strategy
Op dit moment worden de volgende Opslagplaatsen ondersteund:
- Postgres
- Redshift
- BigQuery
- Snowflake
- Presto (deeltijd)
- Spark (deeltijd)
- Microsoft SQL Server (community adapter)
Laten we ons model verbeteren:
- Maak de inhoud incrementeel (Incremental)
- Voeg segmentatie- en sorteertoetsen toe voor Redshift
-- Modelconfiguratie:
-- Incrementele vulwijze, unieke sleutel voor het bijwerken van records (unique_key)
-- Segmentatiesleutel (dist), sorteersleutel (sort)
{{
  config(
      materialized='incremental',
      unique_key='order_id',
      dist="customer_id",
      sort="order_date"
   )
}}

{% set payment_methods = ['credit_card', 'coupon', 'bank_transfer', 'gift_card'] %}

with orders as (

   select * from {{ ref('stg_orders') }}
   where 1=1
   {% if is_incremental() -%}
       -- Deze filter wordt alleen toegepast voor incrementele uitvoeringen
       and order_date >= (select max(order_date) from {{ this }})
   {%- endif %}

),

order_payments as (

   select * from {{ ref('order_payments') }}

),

final as (

   select
       orders.order_id,
       orders.customer_id,
       orders.order_date,
       orders.status,
       {% for payment_method in payment_methods -%}
       order_payments.{{payment_method}}_amount,
       {% endfor -%}
       order_payments.total_amount as amount
   from orders
       left join order_payments using (order_id)

)

select * from final
Afhankelijkheidsgrafiek van modellen
Dat is ook de afhankelijkheidsboom. Ook DAG (Directed Acyclic Graph — Gericht Acyclisch Grafiek).
DBT bouwt een grafiek op basis van de configuratie van alle modellen in het project, meer specifiek de ref()-verwijzingen in de modellen naar andere modellen. Het hebben van een grafiek stelt ons in staat om het volgende te doen:
- Modellen in de juiste volgorde uitvoeren
- Paralleliseren van het vormen van datavitrines
- Het uitvoeren van een willekeurige subgrafiek
Voorbeeld visualisatie van de grafiek:
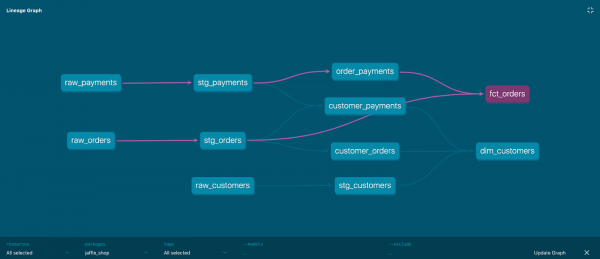
Elke knoop in de grafiek is een model, de randen van de grafiek worden bepaald door de ref-uitdrukking.
Datakwaliteit en Documentatie
Naast het vormen van de modellen, stelt DBT ons in staat om een aantal aannames (asserties) over de resulterende dataset te testen, zoals:
- Not Null
- Uniek
- Referentieel integriteit — bijvoorbeeld dat customer_id in de tabel orders overeenkomt met id in de tabel customers
- Overeenstemming met een lijst van toegestane waarden
Het is mogelijk om eigen tests (custom data tests) toe te voegen, zoals bijvoorbeeld % afwijking van omzet met statussen van een dag, week, maand geleden. Elke aanname, geformuleerd in de vorm van een SQL-query, kan een test worden.
Op deze manier kunnen ongewenste afwijkingen en fouten in de gegevens in de datavitrines worden opgevangen.
Wat documentatie betreft, biedt DBT mechanismen voor het toevoegen, versiebeheer en verspreiden van metadata en opmerkingen op model- en zelfs attribuutniveau.
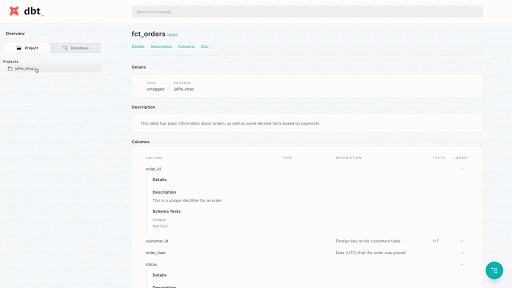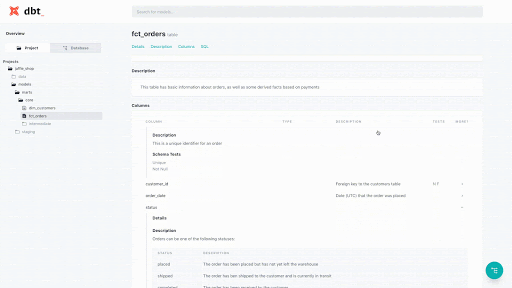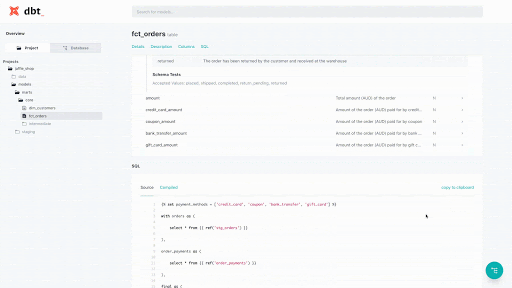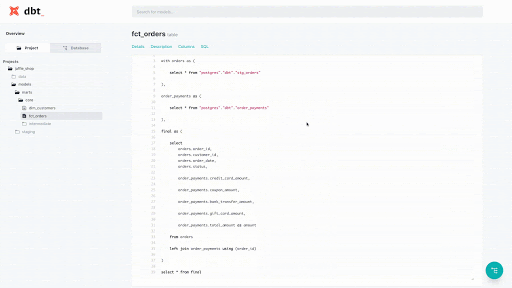
Zo ziet het toevoegen van tests en documentatie in het configuratiebestand eruit:
 - name: fct_orders
   description: Deze tabel bevat basisinformatie over bestellingen, evenals enkele afgeleide feiten op basis van betalingen
   columns:
     - name: order_id
       tests:
         - unique # controle op unieke waarden
         - not_null # controle op niet-nul
       description: Dit is een unieke identificatie voor een bestelling
     - name: customer_id
       description: Buitenlandse sleutel naar de klanten tabel
       tests:
         - not_null
         - relationships: # controle op referentiële integriteit
             to: ref('dim_customers')
             field: customer_id
     - name: order_date
       description: Datum (UTC) waarop de bestelling is geplaatst
     - name: status
       description: '{{ doc("orders_status") }}'
       tests:
         - accepted_values: # controle op toegestane waarden
             values: ['placed', 'shipped', 'completed', 'return_pending', 'returned']
Hier is hoe deze documentatie eruitziet op de gegenereerde website:
Macro's en Modules
Het doel van DBT is niet zozeer om een set SQL-scripts te zijn, maar om gebruikers krachtige en multifunctionele tools te bieden om hun eigen transformaties te creëren en deze modules te verspreiden.
Macro's zijn verzamelingen van constructies en expressies die als functies binnen modellen kunnen worden aangeroepen. Macro's maken het mogelijk om SQL te hergebruiken tussen modellen en projecten volgens het engineeringprincipe DRY (Don’t Repeat Yourself).
Voorbeeld van een macro:
{% macro rename_category(column_name) %}
case
 when {{ column_name }} ilike  '%osx%' then 'osx'
 when {{ column_name }} ilike  '%android%' then 'android'
 when {{ column_name }} ilike  '%ios%' then 'ios'
 else 'other'
end as renamed_product
{% endmacro %}
En het gebruik ervan:
{% set column_name = 'product' %}
select
 product,
 {{ rename_category(column_name) }} -- aanroep van de macro
from my_table
DBT wordt geleverd met een pakketbeheerder (packages) die gebruikers in staat stelt om afzonderlijke modules en macro's te publiceren en te hergebruiken.
Dit betekent de mogelijkheid om bibliotheken zoals te laden en te gebruiken:
- : werken met Datum/Tijd, Surrogate Keys, Schema tests, Pivot/Unpivot en meer
- Kant-en-klare sjablonen voor etalages zoals en
- Bibliotheken voor specifieke Data Warehouses, zoals
- — Module voor het loggen van DBT-activiteiten
Voor een complete lijst van pakketten kun je kijken op .
Nog meer mogelijkheden
Hier beschrijf ik enkele andere interessante kenmerken en implementaties die ik en het team gebruiken voor het opzetten van een Data Warehouse in .
Scheiding van uitvoeringsomgevingen DEV — TEST — PROD
Zelfs binnen één DWH-cluster (binnen verschillende schemas). Bijvoorbeeld met behulp van de volgende uitdrukking:
with source as (

   select * from {{ source('salesforce', 'users') }}
   where 1=1
   {%- if target.name in ['dev', 'test', 'ci'] -%}
       where timestamp >= dateadd(day, -3, current_date)
   {%- endif -%}

)
Deze code zegt letterlijk: voor de omgevingen dev, test, ci neem alleen gegevens van de laatste 3 dagen en niet meer. Dit betekent dat de uitvoering in deze omgevingen veel sneller zal zijn en minder middelen zal vereisen. Bij uitvoering op de omgeving prod zal de filtervoorwaarde worden genegeerd.
Materialisatie met alternatieve kolomcodering
Redshift is een kolom-gebaseerd databasesysteem dat compressie-algoritmen voor elke afzonderlijke kolom kan instellen. Het kiezen van de optimale algoritmen kan de benodigde schijfruimte met 20-50% verminderen.
Macro voert de ANALYZE COMPRESSION-opdracht uit, maakt een nieuwe tabel aan met de aanbevolen kolomcodering-algoritmen, de opgegeven segmentatie-sleutels (dist_key) en sorteersleutels (sort_key), verplaatst de gegevens erin, en verwijdert indien nodig de oude kopie.
Macro-handtekening:
{{ compress_table(schema, table,
                 drop_backup=False,
                 comprows=none|Integer,
                 sort_style=none|compound|interleaved,
                 sort_keys=none|List,
                 dist_style=none|all|even,
                 dist_key=none|String) }}
Logging van modeluitvoeringen
Voor elke modeluitvoering kunnen hooks worden ingesteld die worden uitgevoerd vóór de start of direct na het beëindigen van het maken van het model:
   pre-hook: "{{ logging.log_model_start_event() }}"
   post-hook: "{{ logging.log_model_end_event() }}"
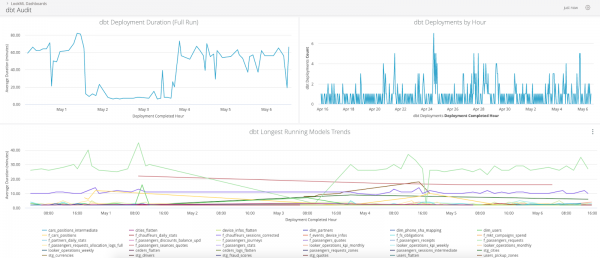
De logging-module stelt je in staat om alle benodigde metadata in een aparte tabel vast te leggen, waarmee later audits kunnen worden uitgevoerd en probleemgebieden (bottlenecks) kunnen worden geanalyseerd.
Zo ziet het dashboard eruit met de logginggegevens in Looker:
Automatisering van het onderhoud van het Data Warehouse
Als je extensies van de functionaliteit van het gebruikte Data Warehouse gebruikt, zoals UDF (User Defined Functions), dan is versiebeheer van deze functies, toegangbeheer, en geautomatiseerde uitrol van nieuwe versies erg handig om in DBT te realiseren.
We gebruiken UDF in Python voor het berekenen van hashwaarden, domeinen van e-mailadressen en voor het decoderen van bitmaskers (bitmask).
Voorbeeld van een macro die UDF creëert in elke uitvoeromgeving (dev, test, prod):
{% macro create_udf() -%}

 {% set sql %}
 CREATE OR REPLACE FUNCTION {{ target.schema }}.f_sha256(mes "varchar")
 RETURNS varchar
 LANGUAGE plpythonu
 STABLE
 AS $$
 import hashlib
 return hashlib.sha256(mes).hexdigest()
 $$
 ;
 {% endset %}

 {% set table = run_query(sql) %}

{%- endmacro %}
Bij Wheely gebruiken we Amazon Redshift, dat is gebaseerd op PostgreSQL. Voor Redshift is het belangrijk om regelmatig statistieken van tabellen te verzamelen en schijfruimte vrij te maken – respectievelijk met de commando's ANALYZE en VACUUM.
Daarom worden elke nacht de commando's uit de macro redshift_maintenance uitgevoerd:
{% macro redshift_maintenance() %}

 {% set vacuumable_tables=run_query(vacuumable_tables_sql) %}

 {% for row in vacuumable_tables %}
 {% set message_prefix=loop.index ~ " van " ~ loop.length %}

 {%- set relation_to_vacuum = adapter.get_relation(
 database=row['table_database'],
 schema=row['table_schema'],
 identifier=row['table_name']
 ) -%}
 {% do run_query("commit") %}

 {% if relation_to_vacuum %}
 {% set start=modules.datetime.datetime.now() %}
 {{ dbt_utils.log_info(message_prefix ~ " Het vacuümproces van " ~ relation_to_vacuum) }}
 {% do run_query("VACUUM " ~ relation_to_vacuum ~ " BOOST") %}
 {{ dbt_utils.log_info(message_prefix ~ " Analyseren " ~ relation_to_vacuum) }}
 {% do run_query("ANALYZE " ~ relation_to_vacuum) %}
 {% set end=modules.datetime.datetime.now() %}
 {% set total_seconds = (end - start).total_seconds() | round(2)  %}
 {{ dbt_utils.log_info(message_prefix ~ " Voltooid " ~ relation_to_vacuum ~ " in " ~ total_seconds ~ "s") }}
 {% else %}
 {{ dbt_utils.log_info(message_prefix ~ ' Overgeslagen relatie "' ~ row.values() | join ('"."') ~ '" omdat deze niet bestaat') }}
 {% endif %}

 {% endfor %}

{% endmacro %}
DBT Cloud
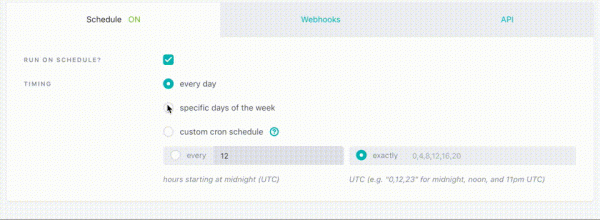
Er is een mogelijkheid om DBT als een service (Managed Service) te gebruiken. Inclusief:
- Web IDE voor het ontwikkelen van projecten en modellen
- Configuratie van jobs en tijdsplanning
- Eenvoudige en handige toegang tot logs
- Websites met documentatie van uw project
- Integratie van CI (Continuous Integration)
Conclusie
Het bereiden en gebruiken van DWH is net zo plezierig en voordelig als het drinken van smoothies. DBT bestaat uit Jinja, gebruikersuitbreidingen (modules), een compiler, een motor (executor) en een pakketbeheerder. Door deze elementen samen te voegen, krijgt u een volledig werkende omgeving voor uw Data Warehouse. Vandaag de dag is er waarschijnlijk geen betere manier om transformaties binnen DWH te beheren.
De overtuigingen die de DBT-ontwikkelaars volgden, worden als volgt geformuleerd:
- Code, en niet GUI, is de beste abstractie voor het uitdrukken van complexe analytische logica.
- Werken met data zou de beste praktijken van softwareontwikkeling (Software Engineering) moeten volgen.
- De belangrijkste infrastructuur voor dataverwerking moet door de gebruikersgemeenschap worden gecontroleerd als open source software.
- Niet alleen analytische tools, maar ook code zal steeds vaker eigendom worden van de Open Source-gemeenschap.
Deze kernoverzeugingen hebben een product voortgebracht dat vandaag de dag door meer dan 850 bedrijven wordt gebruikt en vormen de basis voor veel interessante uitbreidingen die in de toekomst zullen worden ontwikkeld.
Voor geïnteresseerden is er een opname van de open les die ik enkele maanden geleden tijdens een open les bij OTUS heb gegeven — .
Naast DBT en Data Warehouses geven mijn collega's en ik trainingen over verschillende andere actuele en moderne onderwerpen in de Data Engineer-cursus op het OTUS-platform:
- Architecturale concepten van Big Data-applicaties.
- Praktische ervaring met Spark en Spark Streaming.
- Onderzoek naar manieren en tools voor het laden van gegevensbronnen.
- Het opbouwen van analytische datalakes in DWH.
- NoSQL-concepten: HBase, Cassandra, ElasticSearch.
- Principes van monitoring en orkestratie organisatie.
- Eindproject: alle vaardigheden samenbrengen met mentorschap.
Links:
- — Officiële documentatie.
- — Overzichtsartikel van een van de auteurs van DBT.
- — YouTube, Opname van de open les bij OTUS.
- — Volgende open les op 15 mei 2020.
- — OTUS.
- — Een blik op de toekomst van dataverwerking en analytics.
- — De evolutie van analytics en de invloed van Open Source.
- — Principes van CI-opbouw met DBT.
- — Praktijk, Stapsgewijze instructies voor zelfstudie.
- — Github, code van het leerproject
Bron: habr.com
