

De beroepen Data Scientist en Data Engineer worden vaak door elkaar gehaald. Elke onderneming heeft zijn eigen specifieke manier van werken met gegevens, verschillende analysem targets en verschillende opvattingen over wie welke taak moet uitvoeren, daarom stelt iedereen zijn eigen eisen.
We onderzoeken het verschil tussen deze specialisten, welke zakelijke taken zij oplossen, over welke vaardigheden zij beschikken en hoeveel zij verdienen. Het materiaal is omvangrijk, daarom hebben we het in twee publicaties verdeeld.
In het eerste artikel vertelt Elena Gerasimova, de leidinggevende van de faculteit «» aan Netology, over het verschil tussen Data Scientist en Data Engineer en met welke tools zij werken.
Hoe de rollen van ingenieurs en scientists verschillen
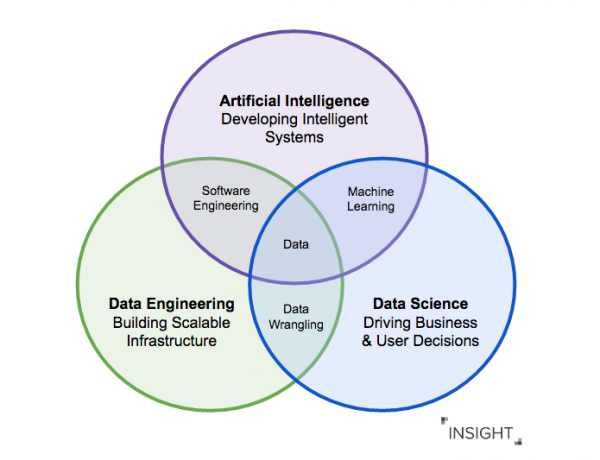
Een data engineer is een specialist die aan de ene kant de infrastructuur van gegevensverwerking ontwikkelt, test en ondersteunt: databases, opslag en systemen voor massale verwerking. Aan de andere kant is hij degene die gegevens schoonmaakt en 'ordent' voor gebruik door analisten en data scientists, dat wil zeggen hij creëert verwerkingspipelines.
Data Scientists creëren en trainen voorspellende (en andere) modellen met behulp van machine learning-algoritmen en neurale netwerken, waarbij zij bedrijven helpen verborgen patronen te ontdekken, de ontwikkeling van gebeurtenissen te voorspellen en belangrijke bedrijfsprocessen te optimaliseren.
Het belangrijkste verschil tussen een Data Scientist en een Data Engineer is dat zij meestal verschillende doelen hebben. Beiden werken eraan om gegevens toegankelijk en van hoge kwaliteit te maken. Maar de Data Scientist zoekt antwoorden op zijn vragen en test hypotheses in het gegevens ecosysteem (bijvoorbeeld op basis van Hadoop), terwijl de Data Engineer een pipeline creëert voor het onderhoud van het machine learning-algoritme dat door de data scientist is geschreven, binnen een Spark-cluster in hetzelfde ecosysteem.
Een data engineer voegt waarde toe aan het bedrijf door in een team te werken. Zijn taak is om een belangrijke schakel te zijn tussen verschillende deelnemers: van ontwikkelaars tot bedrijfsgebruikers van rapportages - en de productiviteit van analisten te verhogen, van marketing en product tot BI.
De Data Scientist daarentegen, speelt een actieve rol in de strategie van het bedrijf en het extraheren van inzichten, besluitvorming, de implementatie van automatiseringsalgoritmen, modellering en het genereren van waarde uit gegevens.
Het werken met gegevens is onderhevig aan het GIGO-principe (garbage in — garbage out): als analisten en data scientists werken met onvoorbereide en potentieel onjuiste gegevens, zullen de resultaten, zelfs met de meest geavanceerde analysalgoritmen, onjuist zijn.
Data-ingenieurs lossen dit probleem op door pipelines op te bouwen voor het verwerken, schoonmaken en transformeren van gegevens, zodat de data scientist met hoogwaardige gegevens kan werken.
Er zijn veel tools op de markt voor gegevensverwerking die elke fase dekken: van het ontstaan van gegevens tot het weergeven op een dashboard voor de raad van bestuur. Het is belangrijk dat de beslissing om deze tools te gebruiken door de ingenieur wordt genomen, niet omdat het trendy is, maar omdat het echt zal helpen in het werk van de andere procesdeelnemers.
Voorbeeld: als een bedrijf BI en ETL moet verbinden — de gegevensinvoer en het bijwerken van rapporten, dan is dit het typische legacy-fundament waarmee een Data Engineer te maken zal krijgen (het is goed als er naast hem ook een architect in het team zit).
Verantwoordelijkheden van de Data Engineer
- Het ontwikkelen, bouwen en onderhouden van de infrastructuur voor gegevensverwerking.
- Foutafhandeling en het creëren van betrouwbare data-verwerkingspijplijnen.
- Het omzetten van ongestructureerde gegevens uit verschillende dynamische bronnen naar een formaat dat nodig is voor analisten.
- Het geven van aanbevelingen voor het verbeteren van de consistentie en kwaliteit van gegevens.
- Het waarborgen en ondersteunen van de gegevensarchitectuur die door data scientists en data-analisten wordt gebruikt.
- Het efficiënt en effectief verwerken en opslaan van gegevens in een gedistribueerd cluster van tientallen of honderden servers.
- Het beoordelen van de technische compromissen van tools voor het creëren van eenvoudige maar betrouwbare architecturen die storingen kunnen overleven.
- Het bewaken en ondersteunen van gegevensstromen en aanverwante systemen (instellen van monitoring en meldingen).
Er is nog een andere specialisatie binnen het pad van de Data Engineer — ML engineer. Kort gezegd, deze ingenieurs zijn gespecialiseerd in het klaarstomen van machine learning-modellen voor industrieel gebruik. Vaak is het model dat van een data scientist komt, een onderdeel van een onderzoek en kan het in een productieomgeving niet werken.
Verantwoordelijkheden van de Data Scientist
- Het extraheren van kenmerken uit gegevens voor het toepassen van machine learning-algoritmen.
- Het gebruik van verschillende machine learning-tools voor het voorspellen en classificeren van patronen in gegevens.
- Verbetering van de prestaties en nauwkeurigheid van machine learning-algoritmen door het fijn afstemmen en optimaliseren van de algoritmen.
- Het formuleren van 'sterke' hypotheses in overeenstemming met de bedrijfsstrategie die moeten worden getest.
Zowel Data Engineers als Data Scientists dragen substantieel bij aan de ontwikkeling van een datacultuur waarmee het bedrijf extra winst kan genereren of kosten kan verlagen.
Met welke talen en tools werken engineers en scientists?
Tegenwoordig zijn de verwachtingen van data-analyse-specialisten veranderd. Vroeger verzamelden engineers grote SQL-query's, schreven ze handmatig MapReduce en verwerkten ze gegevens met tools zoals Informatica ETL, Pentaho ETL, Talend.
In 2020 kan een specialist niet zonder kennis van Python en moderne rekentools (bijvoorbeeld Airflow), en een begrip van het werken met cloudplatforms (het gebruik ervan voor besparingen op 'hardware', met inachtneming van veiligheidsprincipes).
SAP, Oracle, MySQL, Redis zijn traditionele tools voor data engineers in grote bedrijven. Ze zijn goed, maar de licentiekosten zijn zo hoog dat het alleen zinvol is om ermee te leren werken in industriële projecten. Er is echter een gratis alternatief in de vorm van Postgres - het is gratis en geschikt voor opleiding.
Historisch gezien is er vaak vraag naar Java en Scala, hoewel deze talen naarmate de technologieën en benaderingen zich ontwikkelen, op de achtergrond komen te staan.
Desondanks zijn hardcore Big Data-tools zoals Hadoop, Spark en de rest van de 'zoo' geen vereiste meer voor data engineers, maar eerder een soort tools voor het oplossen van problemen die niet met traditionele ETL kunnen worden opgelost.
In opkomst zijn services voor het gebruik van tools zonder kennis van de taal waarin ze zijn geschreven (bijvoorbeeld Hadoop zonder Java-kennis), evenals het aanbieden van kant-en-klare services voor het verwerken van streaminggegevens (zoals spraakherkenning of beeldherkenning in video's).
Industrieel populaire oplossingen van SAS en SPSS, terwijl Tableau, RapidMiner, Stata en Julia ook veel worden gebruikt door data scientists voor lokale taken.
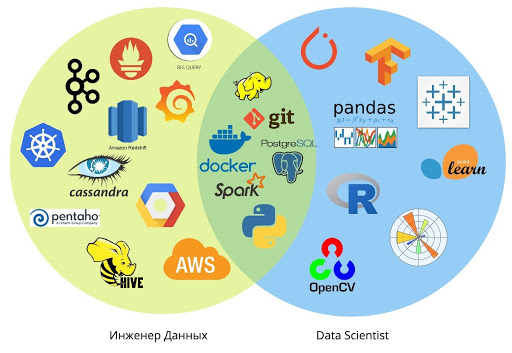
De mogelijkheid om zelf pipelines te bouwen is pas enkele jaren geleden ontstaan voor analisten en data scientists: bijvoorbeeld, het is nu mogelijk om met relatief eenvoudige scripts gegevens naar een opslag op basis van PostgreSQL te sturen.
Gewoonlijk ligt het gebruik van pipelines en geïntegreerde datastructuren in handen van data-ingenieurs. Maar vandaag de dag is de trend naar T-vormige specialisten sterker dan ooit — met brede competenties in aanverwante gebieden, aangezien de tools voortdurend vereenvoudigen.
Waarom Data Engineer en Data Scientist samen moeten werken
Door nauw samen te werken met ingenieurs kunnen Data Scientists zich concentreren op het onderzoeksaspect, waarbij ze werkende machine learning-algoritmes creëren.
En ingenieurs kunnen zich richten op schaalbaarheid, hergebruik van gegevens en ervoor zorgen dat de in- en uitvoerpipelines in elk apart project voldoen aan de globale architectuur.
Deze verdeling van verantwoordelijkheden zorgt voor consistentie in de acties tussen groepen specialisten die aan verschillende machine learning-projecten werken.
Samenwerking helpt bij het effectief creëren van nieuwe producten. Snelheid en kwaliteit worden bereikt door een balans tussen het creëren van een service voor iedereen (de wereldwijde opslag of integratie van dashboards) en de implementatie van elke specifieke behoefte of project (gespecialiseerde pipeline, aansluiting van externe bronnen).
Nauwe samenwerking met data scientists en analisten helpt ingenieurs analytische en onderzoeksvaardigheden te ontwikkelen voor het schrijven van hogere kwaliteitcode. De uitwisseling van kennis tussen de gebruikers van opslagplaatsen en datameren verbetert, wat projecten flexibeler maakt en zorgt voor duurzamere resultaten op lange termijn.
In bedrijven die streven naar de ontwikkeling van een datacultuur en het opbouwen van bedrijfsprocessen op basis daarvan, vullen Data Scientists en Data Engineers elkaar aan en creëren ze een volledig systeem voor gegevensanalyse.
In het volgende artikel zullen we bespreken welke opleiding Data Engineers en Data Scientists moeten hebben, welke vaardigheden ze moeten ontwikkelen en hoe de markt eruit ziet.
Van de redactie van Netology
Als je overweegt om een carrière als Data Engineer of Data Scientist na te streven, nodigen we je uit om onze cursusprogramma's te bekijken:
- Baan "».
- Baan "».
Bron: habr.com
