

Hallo, Habr!
Gegevens zijn de meest waardevolle activa van een bedrijf. Elke digitaal gerichte onderneming bevestigt dit wel. Dit is moeilijk te betwisten: zonder overleg over de benaderingen voor het beheer, de opslag en de verwerking van gegevens, komt er tegenwoordig geen enkele grote IT-conferentie voorbij.
Gegevens komen van buitenaf, maar worden ook binnen het bedrijf gevormd. Als we het hebben over gegevens van een telecombedrijf, dan is dit een goudmijn aan informatie over de klant, zijn interesses, gewoonten en locatie. Bij een goede profilering en segmentatie zijn reclameaanbiedingen het effectiefst. Echter, in de praktijk is niet alles zo rooskleurig. De gegevens die bedrijven opslaan, kunnen hopeloos verouderd, overbodig, repetitief zijn, of niemand weet behalve een selecte groep gebruikers dat ze bestaan. ¯_(ツ)_/¯
Kortom, gegevens moeten effectief worden beheerd - alleen dan worden ze een actief dat de onderneming echte voordelen en winst oplevert. Helaas zijn er bij het oplossen van gegevensbeheer veel complicaties te overwinnen. Deze zijn voornamelijk te wijten aan historisch erfgoed in de vorm van 'dierentuinen' van systemen en het ontbreken van uniforme processen en benaderingen voor het beheer. Maar wat betekent het om 'gegevens te beheren'?
Dat is precies wat we onder de loep nemen, evenals hoe opensource-technologie ons daarbij kan helpen.
Het concept van strategisch gegevensbeheer, Data Governance (DG), is al goed bekend op de Russische markt, en de doelen die bedrijven bereiken door de implementatie ervan zijn duidelijk en expliciet geformuleerd. Ons bedrijf is daarop geen uitzondering en heeft de taak gesteld om het concept van gegevensbeheer te implementeren.
Dus, waar zijn we begonnen? Ten eerste hebben we de belangrijkste doelen voor onszelf geformuleerd:
- Zorg voor de toegankelijkheid van onze gegevens.
- Zorg voor transparantie in de levenscyclus van gegevens.
- Bied de bedrijfsgebruikers consistente en coherente gegevens.
- Bied de bedrijfsgebruikers betrouwbare gegevens.
Tegenwoordig zijn er op de softwaremarkt een dozijn tools van de klasse DataGovernance beschikbaar.
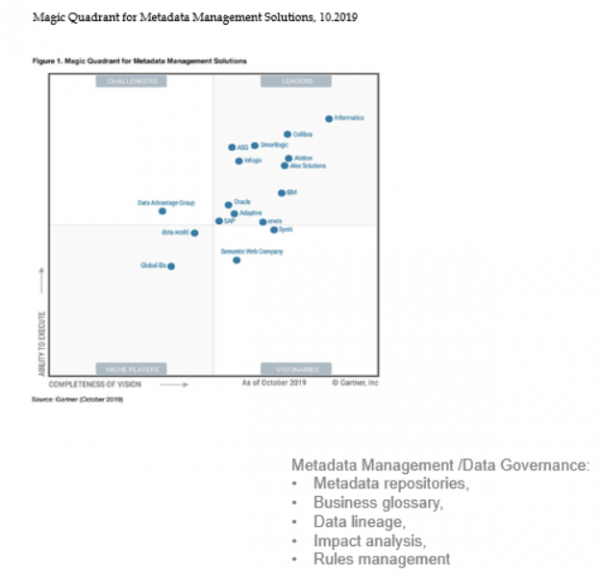
Maar na een grondige analyse en studie van de oplossingen hebben we een aantal kritische kanttekeningen gemaakt:
- De meeste producenten bieden een uitgebreid scala aan oplossingen aan, wat voor ons overbodig is en al bestaande functionaliteit dupliceert. Bovendien is de integratie in het huidige IT-landschap kostbaar qua middelen.
- De functionaliteit en interface zijn bedoeld voor technici en niet voor eindgebruikers in het bedrijfsleven.
- Lage acceptatiegraad van producten en gebrek aan succesvolle implementaties op de Russische markt.
- Hoge kosten van software en verdere ondersteuning.
De bovengenoemde criteria en aanbevelingen met betrekking tot het vervangen van software voor Russische bedrijven hebben ons overtuigt om onze eigen ontwikkeling aan te gaan met een opensource-stack. We hebben Django gekozen als platform – een gratis en open framework geschreven in Python. Op deze manier hebben we essentiële modules gedefinieerd die zullen bijdragen aan de eerder genoemde doelen:
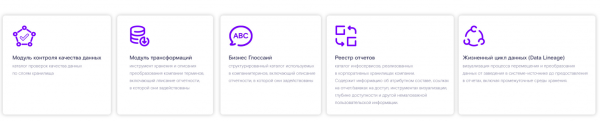
- Register van rapporten.
- Zakelijk glossarium.
- Module voor het beschrijven van technische transformaties.
- Module voor het beschrijven van de levenscyclus van gegevens van de bron tot het BI-instrument.
- Module voor kwaliteitscontrole van gegevens.
Register van rapporten
Uit interne onderzoeken bij grote bedrijven is gebleken dat medewerkers die met gegevens werken, 40-80% van hun tijd besteden aan het zoeken naar deze gegevens. Daarom hebben we ons ten doel gesteld om informatie over bestaande rapporten openbaar te maken, die voorheen alleen beschikbaar waren voor opdrachtgevers. Hierdoor verkorten we de tijd voor het opstellen van nieuwe rapportages en bevorderen we de democratisering van gegevens.
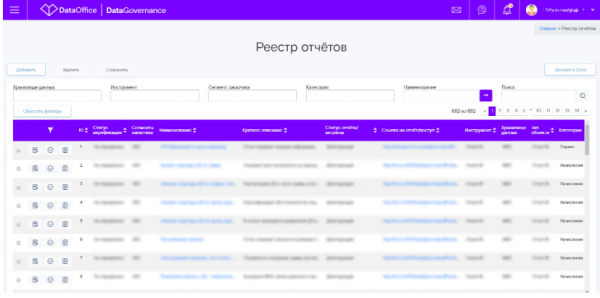
Het register van rapporten is een centraal punt voor rapportage voor interne gebruikers uit verschillende regio's, afdelingen en eenheden. Hierin is informatie geconsolideerd over de infoservices die zijn gecreëerd in verschillende bedrijfsopslagsystemen van de onderneming, waarvan er veel zijn bij Rostelecom.
Maar het register is niet zomaar een droge lijst van ontwikkelde rapporten. Voor elk rapport bieden we de informatie die de gebruiker nodig heeft voor een zelfstandige kennismaking:
- korte beschrijving van het rapport;
- diepte van gegevensbeschikbaarheid;
- klantsegment;
- visualisatietool;
- naam van de bedrijfsopslag;
- functionele zakelijke eisen;
- link naar het rapport;
- link naar de aanvraag voor toegang;
- status van implementatie.
De rapporten bieden inzichten in het gebruiksniveau, en de rapporten komen bovenaan de lijst op basis van de loganalyses van het aantal unieke gebruikers. En dat is nog niet alles. Naast de algemene kenmerken hebben we een gedetailleerde beschrijving van de attributen van de rapporten met voorbeelden van waarden en rekenmethoden opgenomen. Deze detaillering geeft de gebruiker onmiddellijk antwoord op de vraag of het rapport nuttig voor hem is.
De ontwikkeling van deze module was een belangrijke stap in de democratisering van gegevens en heeft de tijd die nodig is om de vereiste informatie te vinden, aanzienlijk verkort. Naast het verkorten van de zoektijd, is ook het aantal verzoeken aan het ondersteuningsteam voor consultaties afgenomen. We moeten ook een ander nuttig resultaat opmerken dat we hebben behaald door een gezamenlijk register van rapporten te ontwikkelen – het voorkomen van de ontwikkeling van dubbele rapporten voor verschillende operationele eenheden.
Bedrijfswoordenlijst
Iedereen weet dat zelfs binnen hetzelfde bedrijf de bedrijfsterminologie verschillende betekenissen kan hebben. Ja, ze gebruiken dezelfde termen, maar ze begrijpen er heel verschillende dingen onder. Deze uitdaging moet worden opgelost met de bedrijfswoordenlijst.
Voor ons is de bedrijfswoordenlijst niet alleen een naslagwerk met beschrijvingen van termen en rekenmethodologieën. Het is een volwaardige ontwikkelomgeving voor het afstemmen en goedkeuren van terminologie, evenals het opbouwen van verbanden tussen termen en andere informatie-activa van het bedrijf. Voordat een term in de bedrijfswoordenlijst belandt, moet deze alle goedkeuringsfases doorlopen met zakelijke opdrachtgevers en het datakwaliteitscentrum. Pas daarna wordt hij beschikbaar voor gebruik.
Zoals ik hierboven al heb geschreven, is de uniciteit van dit instrument dat het mogelijk maakt om verbindingen te leggen van een zakelijke term naar specifieke gebruikersrapporten waarin deze wordt gebruikt, en ook naar de fysieke objecten van databases.
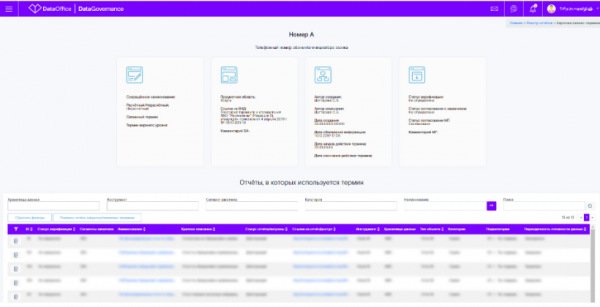
Dit is mogelijk gemaakt door het gebruik van de identificatietermen van de woordenlijst in de gedetailleerde beschrijving van de rapporten uit het register en in de beschrijving van de fysieke objecten van databases.
Momenteel zijn er meer dan 4000 termen gedefinieerd en goedgekeurd in het Glossarium. Het gebruik ervan vereenvoudigt en versnelt de verwerking van binnenkomende verzoeken tot wijzigingen in de informatiesystemen van het bedrijf. Als de vereiste indicator al is geïmplementeerd in een rapport, ziet de gebruiker direct een set kant-en-klare rapporten waarin deze indicator wordt gebruikt, en kan hij beslissen of hij de bestaande functionaliteit effectief opnieuw wil gebruiken of dat er minimale aanpassingen nodig zijn, zonder nieuwe verzoeken voor de ontwikkeling van een nieuw rapport in te dienen.
Module voor de beschrijving van technische transformaties en DataLineage
U vraagt zich misschien af wat dit voor modules zijn? Het is niet genoeg om alleen het Rapportregister en het Glossarium te implementeren, we moeten ook alle zakelijke termen verankeren in het fysieke datamodel. Op deze manier konden we het proces van de levenscyclus van gegevens voltooien, van bronsystemen tot BI-visualisatie via alle lagen van de dataopslag. Met andere woorden: we hebben DataLineage opgebouwd.
We hebben een interface ontwikkeld, gebaseerd op het eerder gebruikte format voor het beschrijven van regels en logica voor datatransformatie. Via de interface wordt dezelfde informatie ingevoerd als voorheen, maar het verplicht bepalen van de identificator van de term uit het zakelijke glossarium is nu een vereiste. Zo bouwen we de verbinding op tussen de zakelijke en fysieke lagen.
Wie heeft dit nodig? Wat was er mis met het oude format waarmee we enkele jaren hebben gewerkt? Hoeveel is de werklast voor het opstellen van vereisten toegenomen? We werden met dergelijke vragen geconfronteerd tijdens de implementatie van de tool. De antwoorden zijn vrij eenvoudig - dit is nodig voor ons allemaal, het data-office van ons bedrijf en onze gebruikers.
Inderdaad, medewerkers moesten zich aanpassen; dit leidde in het begin tot een lichte toename van de tijd die nodig was voor het voorbereiden van documentatie, maar we hebben dit probleem kunnen oplossen. Praktijk, identificatie en optimalisatie van problematische gebieden hebben hun werk gedaan. We hebben het belangrijkste bereikt: de kwaliteit van de ontwikkelde vereisten is verhoogd. Verplichte invulvelden, gestandaardiseerde naslagwerken, invoermaskers en ingebouwde controles hebben de kwaliteit van de beschrijvingen van transformaties aanzienlijk verbeterd. We zijn afgestapt van de praktijk om scripts in de vorm van ontwikkelingsvereisten over te dragen en hebben kennis gedeeld die voorheen alleen beschikbaar was voor het ontwikkelingsteam. De opgestelde metadata-database verkort de tijd voor regressieanalyse aanzienlijk en biedt de mogelijkheid voor een snelle beoordeling van de impact van veranderingen op elk niveau van het IT-landschap (rapportages, aggregaten, bronnen).
Wat hebben gewone gebruikers van rapporten hier mee te maken, wat hebben zij eraan? Dankzij de mogelijkheid om DataLineage te construeren, krijgen onze gebruikers, zelfs degenen die ver van SQL en andere programmeertalen afstaan, snel informatie over de bronnen en objecten waarop een bepaald rapport is gebaseerd.
Module voor kwaliteitscontrole van gegevens
Alles wat we hierboven hebben besproken over het waarborgen van de transparantie van gegevens, is niet relevant zonder begrip dat de gegevens die we aan gebruikers verstrekken, correct zijn. Een van de belangrijke modules van ons Data Governance-concept is de module voor kwaliteitscontrole van gegevens.
In de huidige fase is dit een catalogus van controles op steekproefsgewijze entiteiten. Het dichtstbijzijnde doel voor productontwikkeling is het uitbreiden van de lijst met controles en integratie met het register van rapporten.
Wat zal dit opleveren en voor wie? Voor de eindgebruiker van het register zal informatie over geplande en werkelijke datums van rapportgereedheid beschikbaar zijn, evenals de resultaten van uitgevoerde controles met dynamiek en informatie over de in het rapport geladen bronnen.
Voor ons is de geïntegreerde kwaliteitsmodule in de werkprocessen:
- Snelle vorming van klantverwachtingen.
- Beslissingen nemen over verder gebruik van de gegevens.
- Het verkrijgen van een voorlopige set van probleemgebieden in de vroege fasen van het werk voor de ontwikkeling van reguliere kwaliteitscontroles.
Zeker, dit zijn de eerste stappen in het opbouwen van een volledig databeheerproces. Maar we zijn ervan overtuigd dat we, door ons gericht met dit werk bezig te houden en actief Data Governance-tools in de workflow te integreren, onze klanten informatie, een hoog niveau van vertrouwen in de data, transparantie in de verkrijging ervan kunnen bieden en de snelheid van nieuwe functionaliteit kunnen verhogen.
Team DataOffice
Bron: habr.com
