

DataHub met open source: een platform voor het zoeken en ontdekken van metadata van LinkedIn
Snelle toegang tot de benodigde gegevens is essentieel voor elk bedrijf dat afhankelijk is van grote hoeveelheden gegevens om beslissingen te nemen. Dit beïnvloedt niet alleen de productiviteit van gegevensgebruikers (waaronder analisten, machine learning-ontwikkelaars, gegevensanalisten en gegevensingenieurs), maar heeft ook directe gevolgen voor de eindproducten die afhankelijk zijn van een kwalitatieve machine learning (ML) pipeline. Bovendien roept de trend in het implementeren of creëren van machine learning-platforms vanzelf de vraag op: wat is uw interne methode voor het ontdekken van functies, modellen, metrics, datasets, enz.
In dit artikel bespreken we hoe we onze datasets onder een open licentie hebben gepubliceerd op ons platform voor het zoeken en ontdekken van metadata, te beginnen met de eerste dagen van het project . LinkedIn ondersteunt een eigen versie van DataHub naast de open source-versie. We beginnen met uitleggen waarom we twee aparte ontwikkelomgevingen nodig hebben, waarna we de vroegste benaderingen van het gebruik van WhereHows met open source zullen bespreken en een vergelijking zullen maken tussen onze interne (productie) versie van DataHub en de versie op . We zullen ook details delen over onze nieuwe geautomatiseerde oplossing voor het verzenden en ontvangen van updates met open source, om beide repositories te synchroniseren. Tot slot geven we instructies over hoe u kunt beginnen met het gebruiken van DataHub met open source en bespreken we kort de architectuur.
WhereHows is nu DataHub!
Het metadata-team van LinkedIn heeft eerder de (opvolger van WhereHows), het platform voor het zoeken en ontdekken van metadata van LinkedIn geïntroduceerd en de plannen gedeeld om het open te stellen. Kort na deze aankondiging hebben we de alpha-versie van DataHub uitgebracht en deze gedeeld met de community. Sindsdien hebben we voortdurend bijgedragen aan de repository en samengewerkt met geïnteresseerde gebruikers om de meest gevraagde functies toe te voegen en problemen op te lossen. Nu zijn we blij om de officiële release aan te kondigen .
Open source benaderingen
WhereHows, het originele LinkedIn-portaal voor dataverkenning en herkomst, begon als een intern project; het metadata-team opende het. . Sindsdien heeft het team altijd twee verschillende codebases onderhouden - één voor open source en de andere voor intern gebruik door LinkedIn, omdat niet alle productfunctionaliteiten die zijn ontwikkeld voor LinkedIn-toepassingen, algemeen toepasbaar waren voor een breder publiek. Bovendien heeft WhereHows enkele interne afhankelijkheden (infrastructuur, bibliotheken, enz.) waarvan de broncode niet openbaar is. In de daaropvolgende jaren heeft WhereHows vele iteraties en ontwikkelingscycli doorgemaakt, wat de synchronisatie van de twee codebases een grote uitdaging maakte. Het metadata-team heeft jarenlang geprobeerd verschillende benaderingen te gebruiken om de interne ontwikkeling en de open source ontwikkeling te synchroniseren.
Eerste poging: 'Eerst open source'
Oorspronkelijk volgden we het model van 'eerst open source ontwikkeling', waarbij de hoofdontwikkeling plaatsvond in de open source repository en aanpassingen werden aangebracht voor interne implementatie. Het probleem met deze benadering is dat de code altijd eerst op GitHub wordt geplaatst voordat deze intern volledig wordt gecontroleerd. Totdat wijzigingen uit de open source repository zijn doorgevoerd en een nieuwe interne implementatie is voltooid, zullen we geen productieverstoringen ontdekken. In het geval van een slechte implementatie was het ook zeer moeilijk om de schuldige te identificeren, omdat wijzigingen in batches werden aangebracht.
Bovendien heeft dit model de productiviteit van het team verminderd bij het ontwikkelen van nieuwe functies die snelle iteraties vereisten, omdat het alle wijzigingen vereiste om eerst in de open source repository te worden geplaatst en vervolgens naar de interne repository te worden overgebracht. Om de verwerkingstijd te verkorten, kon een noodzakelijke correctie of wijziging zoals eerder in de interne repository worden gemaakt, maar dit werd een enorm probleem toen het aankwam op het samenvoegen van deze wijzigingen terug naar de open source repository, omdat de twee repositories niet meer synchroon waren.
Dit model is veel gemakkelijker te implementeren voor algemene platforms, bibliotheken of infrastructuurprojecten dan voor volledig functionele gebruikerswebapplicaties. Bovendien is dit model perfect voor projecten die vanaf dag één met open source beginnen, maar WhereHows werd volledig ontwikkeld als een interne webapplicatie. Het was echt moeilijk om volledig afstand te doen van alle interne afhankelijkheden, dus we moesten de interne fork behouden, maar het behouden van de interne fork en voornamelijk open source ontwikkelen werkte niet echt goed.
Tweede poging: 'Eerst intern'
** In de tweede poging zijn we overgestapt op het 'eerst intern'-ontwikkelingsmodel, waarbij de belangrijkste ontwikkeling binnen het bedrijf plaatsvindt en wijzigingen regelmatig aan de open source code worden toegevoegd. Hoewel dit model het beste past bij ons gebruiksgeval, zijn er enkele problemen. Direct alle verschillen naar de open source repository verzenden en dan later proberen om samenvoegconflicten op te lossen is een optie, maar dit kost veel tijd. Ontwikkelaars proberen dit in de meeste gevallen niet bij elke code-review te doen. Het resultaat is dat dit veel minder vaak, in batches, wordt gedaan, wat het latere oplossen van samenvoegconflicten bemoeilijkt.
De derde keer was het gelukt!
De twee hierboven genoemde mislukte pogingen hebben ertoe geleid dat de WhereHows GitHub-repository lange tijd verouderd bleef. Het team bleef functies en de architectuur van het product verbeteren, waardoor de interne versie van WhereHows voor LinkedIn steeds geavanceerder werd dan de open source versie. Het had zelfs een nieuwe naam — DataHub. Op basis van de eerdere mislukte pogingen besloot het team een schaalbare, langetermijnoplossing te ontwikkelen.
Voor elk nieuw open source-project adviseert het open source-ontwikkelingsteam van LinkedIn en ondersteunt het een ontwikkelingsmodel waarin de projectmodules volledig met open source worden ontwikkeld. Versieondersteunde artifacten worden gedeployed in een openbare repository en daarna teruggestuurd naar het interne artifact van LinkedIn met behulp van Het volgen van dit ontwikkelingsmodel is niet alleen gunstig voor diegenen die open source gebruiken, maar leidt ook tot de creatie van een meer modulaire, uitbreidbare en aansluitbare architectuur.
Echter, om deze staat te bereiken voor een volwassen interne applicatie zoals DataHub, is een aanzienlijke hoeveelheid tijd nodig. Dit sluit ook de mogelijkheid uit voor een volledig werkende open source implementatie voordat alle interne afhankelijkheden volledig zijn geabstraheerd. Daarom hebben we tools ontwikkeld die ons helpen om sneller en met veel minder pijn bij te dragen aan open source. Deze oplossing is voordelig voor zowel het metadata-team (de ontwikkelaar van DataHub) als de open source community. In de volgende secties zal deze nieuwe aanpak worden besproken.
Automatisering van open source publicatie
De laatste aanpak van de metadata-groep voor DataHub met open source is het ontwikkelen van een tool die automatisch de interne codebase en de open source repository synchroniseert. Hoogwaardige functies van deze toolkit zijn onder andere:
- Synchronisatie van LinkedIn code met / uit open source, vergelijkbaar met .
- Genereren van licentietitels, vergelijkbaar met .
- Automatisch creëren van commit logs met open source uit interne commit logs.
- Voorkomen dat interne wijzigingen de open source build verstoren door .
In de volgende subsections worden de bovengenoemde functies met interessante problemen in detail besproken.
Synchronisatie van de broncode
In tegenstelling tot de open source versie van DataHub, die een enkele GitHub repository is, is de DataHub versie voor LinkedIn een combinatie van meerdere repositories (binnen het bedrijf genaamd ). De interface van DataHub, de bibliotheek van metadata-modellen, de serverdienst voor metadataopslag en de streamingjobs bevinden zich in verschillende repositories binnen LinkedIn. Echter, om het voor gebruikers makkelijker te maken met open source, hebben we een enkele repository voor de open source versie van DataHub.
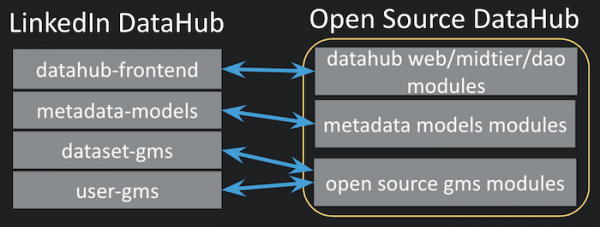
Figuur 1: Synchronisatie tussen repositories LinkedIn DataHub en de enkele repository DataHub met open source
Om automatische workflows voor build, verzending en extractie te ondersteunen, creëert ons nieuwe hulpmiddel automatisch een bestandsniveau mapping die overeenkomt met elk origineel bestand. Voor de tooling is echter een initiële configuratie vereist, en gebruikers moeten een high-level mapping van de modules aanleveren, zoals hieronder weergegeven.
{
  "datahub-dao": [
    "${datahub-frontend}/datahub-dao"
  ],
  "gms/impl": [
    "${dataset-gms}/impl",
    "${user-gms}/impl"
  ],
  "metadata-dao": [
    "${metadata-models}/metadata-dao"
  ],
  "metadata-builders": [
    "${metadata-models}/metadata-builders"
  ]
}
De module-niveau mapping is een eenvoudige JSON waarvan de sleutels de doelmodules in de open-source repository zijn, en de waarden een lijst van originele modules in de LinkedIn repositories. Elke doelmodule in de open-source repository kan gevoed worden door een onbeperkt aantal originele modules. Voor het aanduiden van interne repository-namen in originele modules wordt in Bash-stijl gebruikt. Met behulp van de module-niveau mapping maken de tools een bestandsniveau mapping door alle bestanden in de bijbehorende mappen te scannen.
{
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Foo.java":
"metadata-builders/src/main/java/com/linkedin/Foo.java",
  "${metadata-models}/metadata-builders/src/main/java/com/linkedin/Bar.java":
"metadata-builders/src/main/java/com/linkedin/Bar.java",
  "${metadata-models}/metadata-builders/build.gradle": null,
}
De bestandsniveau mapping wordt automatisch aangemaakt door de tools; deze kan echter ook handmatig door een gebruiker worden bijgewerkt. Deze mapping is 1:1 tussen het originele bestand van LinkedIn en een bestand in de open-source repository. Er zijn verschillende regels verbonden aan deze automatische creatie van bestandsmapping:
- In het geval van meerdere originele modules voor een doelmodule kunnen er conflicten optreden in de open-source repository, zoals wanneer dezelfde , bestaat in meer dan één originele module. Als een conflictoplossingsstrategie gebruiken onze tools standaard de optie 'laatste wint'.
- "null" betekent dat het originele bestand geen deel uitmaakt van de open-source repository.
- Na elke verzending naar of extractie uit de open source-code wordt deze mapping automatisch bijgewerkt en wordt er een momentopname gemaakt. Dit is noodzakelijk om toevoegingen en verwijderingen van de broncode na de laatste actie te identificeren.
Commitlogboeken aanmaken
Commitlogboeken voor commits met open source-code worden ook automatisch aangemaakt door de commitlogboeken van interne repositories te combineren. Hieronder staat een voorbeeld van een commit-logboek om de structuur van het commit-logboek weer te geven, dat door onze tool is aangemaakt. De commit geeft duidelijk aan welke versies van de oorspronkelijke repositories in deze commit zijn verpakt en biedt een samenvatting van het commitlogboek. Controleer dit aan een echt voorbeeld van een commit-logboek, gemaakt door onze tools.
metadata-models 29.0.0 -> 30.0.0
    Aspectmodel foo toegevoegd
    Probleem bar opgelost

dataset-gms 2.3.0 -> 2.3.4
    Rest.li API toegevoegd om foo-aspect te bedienen

MP_VERSION=dataset-gms:2.3.4
MP_VERSION=metadata-models:30.0.0
Afhankelijkheidstest
LinkedIn heeft , die helpt garanderen dat wijzigingen in de interne multi-productstructuur de bouw van afhankelijke multi-producten niet verstoren. De open source DataHub-repository is geen multi-product en kan geen directe afhankelijkheid zijn van een of ander multi-product, maar met behulp van een multi-productwrapper, die de open source DataHub-code extraheert, kunnen we dit systeem voor afhankelijkheidstests nog steeds gebruiken. Dus elke wijziging (die mogelijk later openbaar wordt) in een van de multi-producten die de open source DataHub-repository voedt, activeert een bouwgebeurtenis in de wrapper van het multi-product. Daarom wordt elke wijziging die voorkomt dat de wrapper van het multi-product wordt gebouwd, niet toegestaan tijdens de tests voordat de broncode van het multi-product wordt gecommit en wordt teruggestuurd.
Dit is een nuttig mechanisme dat helpt om elke interne commit te voorkomen die de bouw van de open source-code verstoort, en ontdekt het tijdens het aanmaken van de commit. Zonder dit zou het vrij moeilijk zijn om te bepalen welke interne commit heeft geleid tot de mislukking van de bouw van de open source-repository, omdat we batchgewijze interne wijzigingen in de open source DataHub-repository plaatsen.
Verschillen tussen de open-source DataHub en onze productieversie
Tot nu toe hebben we onze oplossing voor het synchroniseren van twee versies van de DataHub-repositories besproken, maar we hebben nog niet de redenen benoemd waarom we überhaupt twee verschillende ontwikkelstromen nodig hebben. In dit gedeelte zullen we de verschillen tussen de openbare versie van DataHub en de productieversie op de servers van LinkedIn opnoemen, en de redenen voor deze verschillen uitleggen.
Een van de bronnen van discrepantie komt voort uit het feit dat onze productieversie afhankelijkheden heeft van code die nog niet open-source is, zoals LinkedIn's Offspring (de interne afhankelijkheidsinvoegstructuur van LinkedIn). Offspring wordt veel gebruikt in de interne codebase, omdat het de voorkeur heeft bij het beheer van dynamische configuratie. Maar dit is niet open-source; daarom moesten we open-source alternatieven vinden voor de open-source DataHub.
Er zijn ook andere redenen. Terwijl we metadata-modeluitbreidingen maken voor de behoeften van LinkedIn, zijn deze uitbreidingen vaak zeer specifiek voor LinkedIn en kunnen ze niet direct op andere omgevingen worden toegepast. Bijvoorbeeld, we hebben zeer specifieke labels voor de identificaties van deelnemers en andere soorten metadata-overeenkomsten. Dus hebben we deze uitbreidingen momenteel uitgesloten van het open-source metadata-model van DataHub. Naarmate we contact hebben met de gemeenschap en hun behoeften begrijpen, zullen we werken aan gezamenlijke open-source versies van deze uitbreidingen waar nodig.
Gebruiksgemak en een eenvoudigere aanpassing voor de open-source gemeenschap hebben ook enkele verschillen tussen de twee versies van DataHub geïnspireerd. Verschillen in streaming-infrastructuur zijn een goed voorbeeld hiervan. Hoewel onze interne versie gebruikmaakt van beheerde streaming-infrastructuur, hebben we besloten ingebouwde (autonome) streaming te gebruiken voor de open-source versie, omdat dit voorkomt dat er een extra infrastructuurafhankelijkheid moet worden gecreëerd.
Een ander voorbeeld van het verschil is de aanwezigheid van één GMS (Generiek Metadatastore) in de open-source implementatie, in plaats van meerdere GMS. GMA (Generieke Metadata-architectuur) is de naam voor de interne architectuur van DataHub, terwijl GMS de metadataopslag is in de context van GMA. GMA is een zeer flexibele architectuur die u in staat stelt om elke gegevensstructuur (zoals datasets, gebruikers, enz.) in zijn eigen metadataopslag te plaatsen of meerdere gegevensstructuren in één metadataopslag op te slaan, zolang het register dat de mapping van de gegevensstructuur in GMS bijwerkt. Voor het gebruiksgemak hebben we één instantie van GMS gekozen die alle verschillende gegevensstructuren in de open-source DataHub opslaat.
Een volledige lijst van de verschillen tussen de twee implementaties vindt u in de onderstaande tabel.
Productkenmerken
LinkedIn DataHub
Open Source DataHub
Ondersteunde gegevensstructuren
1) Datasets 2) Gebruikers 3) Statistieken 4) ML Kenmerken 5) Grafieken 6) Dashboards
1) Datasets 2) Gebruikers
Ondersteunde metadata-bronnen voor datasets
1) 2) Couchbase 3) 4) 5) HDFS 6) Hive 7) Kafka 8) MongoDB 9) MySQL 10) Oracle 11) 12) Presto 12) 13) Teradata 13) Vector 14)
Hive Kafka RDBMS
Pub-sub
Confluent Kafka
Streamverwerking
Beheerd
Ingebedde (standalone)
Dependency Injection & Dynamische Configuratie
LinkedIn Offspring
Build Tooling
Ligradle (LinkedIn’s interne Gradle wrapper)
CI/CD
CRT (LinkedIn’s interne CI/CD)
en
Metadata-opslagen
Gedistribueerde meerdere GMS: 1) Dataset GMS 2) Gebruiker GMS 3) Statistiek GMS 4) Functie GMS 5) Grafiek/Dashboard GMS
Enkele GMS voor: 1) Datasets 2) Gebruikers
Microservices in Docker-containers
vereenvoudigen de implementatie en distributie van applicaties met behulp van Elk onderdeel van de dienst in DataHub met open source, inclusief infrastructuurcomponenten zoals Kafka, , en , heeft zijn eigen Docker-image. Voor de orkestratie van Docker-containers hebben we gebruikt .
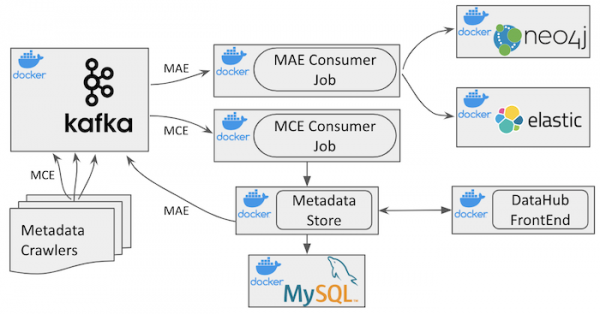
Figuur 2: Architectuur DataHub *met open source*
U kunt de high-level architectuur van DataHub zien op de afbeelding hierboven. Naast infrastructuurcomponenten heeft het vier verschillende Docker-containers:
datahub-gms: metadataopslagdienst
datahub-frontend: applicatie , die de gebruikersinterface van DataHub bedient.
datahub-mce-consumer: applicatie , die de stroom van metadatawijzigingsevents (MCE) gebruikt en de metadataopslag bijwerkt.
datahub-mae-consumer: applicatie , die de stroom van metadata-audit evenementen (MAE) gebruikt en een zoekindexdatabase en graf creëert.
Documentatie van de open source repository en bevat gedetailleerdere informatie over de functies van verschillende diensten.
CI/CD in DataHub met open source
De open source repository van DataHub maakt gebruik van voor continue integratie en voor continue implementatie. Beide hebben een goede integratie met GitHub en zijn eenvoudig in te stellen. Voor het grootste deel van de open source infrastructuur, ontwikkeld door de gemeenschap of particuliere bedrijven (bijvoorbeeld, ), zijn Docker-afbeeldingen gemaakt en deze worden geïmplementeerd in Docker Hub voor gebruiksgemak door de gemeenschap. Elke Docker-afbeelding die in Docker Hub wordt gevonden, kan eenvoudig worden gebruikt met de eenvoudige opdracht .
Bij elke commit in de open source repository van DataHub worden alle Docker-afbeeldingen automatisch aangemaakt en in Docker Hub geïmplementeerd met de tag "latest". Als er in Docker Hub een bepaalde , worden alle tags in de open source repository ook uitgegeven met de bijbehorende tagnamen in Docker Hub.
Gebruik van DataHub
is zeer eenvoudig en bestaat uit drie eenvoudige stappen:
- Clone de open source repository en start alle Docker-containers met docker-compose met behulp van het meegeleverde script voor een snelle start.
- Download de voorbeeldgegevens die in de repository worden gepresenteerd met behulp van de meegeleverde commandoregeltool.
- Bekijk DataHub in uw browser.
Een actief gemonitord is ook ingesteld voor snelle vragen. Gebruikers kunnen ook issues direct in de GitHub repository aanmaken. Het belangrijkste is dat we alle feedback en suggesties verwelkomen en waarderen!
Toekomstplannen
Momenteel is elke infrastructuur of microservice voor DataHub met open source gebouwd als een Docker-container, en het gehele systeem wordt georkestreerd met behulp van . Gezien de populariteit en brede verspreiding , willen we ook graag in de nabije toekomst een op Kubernetes gebaseerde oplossing aanbieden.
We zijn ook van plan om een kant-en-klare oplossing voor de implementatie van DataHub in een openbare cloudservice, zoals , of . Gezien de recente aankondiging over de migratie van LinkedIn naar Azure, zal dit aansluiten bij de interne prioriteiten van de metadata-groep.
En tot slot, maar zeker niet minder belangrijk: bedankt aan alle eerste gebruikers van DataHub in de open-source gemeenschap die de bètaversies van DataHub hebben gewaardeerd en ons hebben geholpen problemen te identificeren en de documentatie te verbeteren.
Bron: habr.com
