

Bij de complexe verwerking van grote datasets (verschillende : imports, conversies en synchronisaties met een externe bron) ontstaat vaak de noodzaak om tijdelijk iets te 'onthouden', en snel te verwerken iets omvangrijks.
Een typische taak van deze aard klinkt meestal ongeveer zo: "Hier heeft de boekhouding recent ontvangen betalingen uit het klantensysteem geëxporteerd, we moeten deze snel naar de website uploaden en aan rekeningen koppelen" Om hiermee om te gaan in PostgreSQL (en niet alleen daar), kunnen we gebruikmaken van verschillende optimalisatiemogelijkheden die het mogelijk maken om alles sneller en met minder middelen te verwerken.
1. Waar te uploaden?
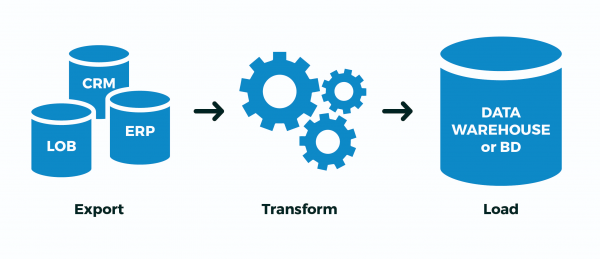
Laten we eerst vaststellen waar we de gegevens kunnen uploaden die we willen 'verwerken'.
1.1. Tijdelijke tabellen (TEMPORARY TABLE)
In principe zijn tijdelijke tabellen in PostgreSQL net zo'n tabel als elke andere. Daarom zijn bijgeloof zoals
"het wordt alleen in het geheugen opgeslagen, en dat kan op raken"
niet correct. Maar er zijn ook enkele belangrijke verschillen.Een eigen 'naamruimte' voor elke databaseverbinding
Als twee verbindingen tegelijkertijd proberen uit te voeren
CREATE TABLE x , dan krijgt iemand zeker eenuniquenessfout van databaseobjecten. Maar als beide proberen uit te voeren,
, dan kunnen beiden dit normaal doen, en krijgt elke verbinding CREATE Tijdelijk TABEL xzijn eigen instantie van de tabel. En er is niets gemeen tussen hen. "Zelfvernietiging" bij disconnect
Bij het sluiten van de verbinding worden alle tijdelijke tabellen automatisch verwijderd, dus heeft het geen zin om
DROP TABLE x handmatig uit te voeren, behalve… Als je werkt via
pgbouncer in transaction mode , dan denkt de database dat deze verbinding nog steeds actief is, en dan bestaat deze tijdelijke tabel daar nog steeds.Dus de poging om deze opnieuw te maken, al vanuit een andere pgbouncer-verbinding, zal resulteren in een fout. Maar dit kan worden omzeild door gebruik te maken van
Een poging om het opnieuw te creëren vanuit een andere verbinding naar pgbouncer zal leiden tot een fout. Maar dit kan worden omzeild door gebruik te maken van CREËER TUSSENTIJDELIJKE TABEL ALS HET NOG NIET BESTAAT x.
Het is beter om dit niet te doen, omdat je dan plotseling gegevens kunt ontdekken die van de 'vorige eigenaar' zijn. In plaats daarvan is het veel beter om de handleiding te lezen en te zien dat er bij het aanmaken van een tabel de mogelijkheid is om Bij commit DROP — dat wil zeggen dat de tabel automatisch zal worden verwijderd bij het afronden van de transactie.
Niet-replicatie
Vanwege de toewijzing aan een specifiek verband worden tijdelijke tabellen niet gerepliceerd. Maar dit elimineert de noodzaak voor dubbele gegevensopslag in heap + WAL, waardoor INSERT/UPDATE/DELETE daarin aanzienlijk sneller zijn.
Maar omdat een tijdelijke tabel toch 'bijna een gewone' tabel is, kan deze ook niet op de replica worden aangemaakt. Tenminste, voorlopig niet, hoewel de bijbehorende patch al lang in omloop is.
1.2. Niet-logbare tabellen (UNLOGGED TABLE)
Maar wat te doen als je bijvoorbeeld een zwaar ETL-proces hebt dat niet binnen één transactie kan worden uitgevoerd en dat je toch , dan denkt de database dat deze verbinding nog steeds actief is, en dan bestaat deze tijdelijke tabel daar nog steeds.?..
Of de gegevensstroom is zo groot dat de bandbreedte van één verbinding niet voldoende is met de database (lees: één proces op de CPU)?..
Of sommige operaties verlopen asynchroon via verschillende verbindingen?..
Hier is er maar één optie — tijdelijk een niet-tijdelijke tabel aanmaken. Een woordgrap, hè. Dat wil zeggen:
- je hebt 'jouw' tabellen met maximaal willekeurige namen aangemaakt, zodat er geen overlap is met anderen.
- Extract: je hebt gegevens uit een externe bron in die tabellen geladen.
- Transform: geconfigureerd en de sleutelverbindingvelden ingevuld.
- Load: je hebt de voltooide gegevens in de doelstellingen getransfereerd.
- je hebt 'jouw' tabellen verwijderd.
En nu — de lepel teer. In wezen vindt alle opslag in PostgreSQL twee keer plaats — , daarna in de lichaam van de tabellen/indexen. Dit is allemaal gedaan voor de ondersteuning van ACID en een correcte zichtbaarheid van gegevens tussen COMMITgebonden en ROLLBACKgebonden transacties.
Maar dat hebben we niet nodig! Ons hele proces is ofwel volledig succesvol verlopen, of niet.. Het maakt niet uit hoeveel tussentijdse transacties erin zitten — we zijn niet geïnteresseerd in 'het proces voortzetten vanaf het midden', vooral niet als onduidelijk is waar het was.
Om dit te doen hebben de ontwikkelaars van PostgreSQL al in versie 9.1 zoiets geïmplementeerd als :
Met deze aanwijzing wordt de tabel aangemaakt als niet-logbaar. Gegevens die in niet-logbare tabellen worden opgeslagen, verlopen niet via het oplopend logboek (zie Hoofdstuk 29), waardoor deze tabellen werken veel sneller dan gewone. Echter, ze zijn niet beschermd tegen uitval; bij uitval of een onverwachte serverstop wordt de niet-geloggde tabel automatisch afgebroken. Bovendien wordt de inhoud van de niet-geloggde tabel niet gerepliceerd naar de secundaire servers. Alle indexen die voor de niet-geloggde tabel worden gemaakt, worden automatisch niet-geloggde.
Kortom, zal het veel sneller zijn, maar als de DB-server 'crasht' - zal dat vervelend zijn. Maar hoe vaak gebeurt dat, en kan uw ETL-proces dit correct afhandelen vanaf het 'midden' na het 'herleven' van de DB?..
Als dat niet het geval is, en de bovenstaande case lijkt op de uwe - gebruik dan UNLOGGED, maar schakel deze attribuut nooit in voor echte tabellen, waarvan u de gegevens belangrijk zijn.
1.3. ON COMMIT { DELETE ROWS | DROP }
Deze constructie stelt u in staat om bij het aanmaken van een tabel automatisch gedrag op te geven bij het beëindigen van de transactie.
Over Bij commit DROP heb ik hierboven al geschreven, het genereert DROP TABLE, maar met Bij commit Rijen verwijderen is de situatie interessanter - hier wordt gegenereerd TRUNCATE TABLE.
Aangezien de hele infrastructuur voor het opslaan van de meta-beschrijving van de tijdelijke tabel precies hetzelfde is als die van de gewone, leidt voortdurend aanmaken-verwijderen van tijdelijke tabellen tot sterke 'uitbreiding' van de systeemtabellen pg_class, pg_attribute, pg_attrdef, pg_depend,…
Stel je nu voor dat je een worker hebt met een directe verbinding met de DB, die elke seconde een nieuwe transactie opent, een tijdelijke tabel aanmaakt, vult, verwerkt en verwijdert… Er zal teveel rommel in de systeemtabellen ophopen, wat onnodige vertragingen bij elke operatie met zich meebrengt.
In het algemeen, zo moet je het niet doen! In dit geval is het veel efficiënter om CREATE TEMPORARY TABLE x ... ON COMMIT DELETE ROWS buiten de transactiecyclus te plaatsen - dan zal de tabel aan het begin van elke nieuwe transactie al bestaan (we besparen aanroep CREATE), maar zal leeg zijn, dankzij TRUNCATE (die aanroep hebben we ook bespaard) bij het beëindigen van de vorige transactie.
1.4. LIKE… INCLUDING …
Ik heb aan het begin genoemd dat een van de typische use cases voor tijdelijke tabellen allerlei soorten importen zijn - en de ontwikkelaar kopieert vermoeid de lijst met velden van de doeltabel naar de declaratie van zijn tijdelijke…
Maar luiheid is de motor van vooruitgang! Daarom kun je een nieuwe tabel 'naar voorbeeld' maken veel eenvoudiger:
CREATE TEMPORARY TABLE import_table(
  LIKE target_table
);
Omdat je in deze tabel behoorlijk veel gegevens kunt genereren, zal het zoeken daarin allesbehalve snel zijn. Maar er is een traditioneel oplossing hiervoor - indexen! En ja, de tijdelijke tabel kan ook indexen hebben.
Omdat de benodigde indexen vaak overeenkomen met de indexen van de doeltabel, kun je eenvoudig schrijven LIKE target_table INCLUSIEF INDEXEN.
Als je ook nog eens DEFAULT-waarden nodig hebt (bijvoorbeeld om de waarden van de primaire sleutel in te vullen), kun je gebruikmaken van LIKE target_table INCLUSIEF STANDAARDINSTELLINGEN. Of gewoon - LIKE target_table INCLUSIEF ALLES zal de defaults, indexen, constraints,… kopiëren
Maar hier moet je wel begrijpen dat als je de importtabel meteen met indexen hebt gemaakt, de gegevens langer zullen laden, dan als je eerst alles laadt en vervolgens de indexen aanbrengt - kijk als voorbeeld hoe dit werkt bij .
Kortom, !
2. Hoe te schrijven?
Ik zeg gewoon - gebruik -stream in plaats van "batch" INSERT, . Je kunt zelfs direct vanuit een vooraf gevormd bestand werken.
3. Hoe te verwerken?
Dus, laten we zeggen dat onze invoer er ongeveer zo uitziet:
- je hebt een tabel met klantgegevens in je database met 1M records
- iedere dag stuurt de klant je een nieuwe volledige 'afbeelding'
- uit ervaring weet je dat er niet meer dan 10K records per keer veranderen
Een klassiek voorbeeld van een dergelijke situatie is - er zijn veel adressen, maar in elke wekelijkse export van wijzigingen (hernoemingen van plaatsen, samenvoegen van straten, verschijnen van nieuwe huizen) is er heel weinig, zelfs op nationaal niveau.
3.1. Algoritme voor volledige synchronisatie
Om het eenvoudig te houden, laten we aannemen dat je de gegevens zelfs niet hoeft te herstructureren - einfach de tabel in de juiste vorm brengen, namelijk:
- te verwijderen alles wat er al niet meer is
- bijwerken alles wat er al was en vernieuwd moet worden
- invoegen alles wat er nog niet was
Waarom zou je de operaties in deze volgorde uitvoeren? Omdat de grootte van de tabel zo minimaal toeneemt ().
DELETE FROM dst
Nee, je kunt natuurlijk volstaan met slechts twee operaties:
- te verwijderen (
HEAD) alles - invoegen alles uit de nieuwe afbeelding
Maar hierdoor zal de grootte van de tabel dankzij MVCC precies verdubbelen ! Het krijgen van +1M records in de tabel door 10K te updaten - dat is een behoorlijke overbodigheid…TRUNCATE dst
Een meer ervaren ontwikkelaar weet dat je de hele tabel relatief goedkoop kunt opschonen:
opschonen
- ) de hele tabel (
TRUNCATEEen effectieve methode, - invoegen alles uit de nieuwe afbeelding
soms heel goed toepasbaar , maar er is een probleem… Het importeren van 1 miljoen records zal heel lang duren, dus we kunnen ons niet veroorloven om de tabel gedurende deze tijd leeg te laten (zoals het zal gebeuren zonder het in één transactie te wikkelen).
Dat betekent:
- we beginnen met een langdurige transactie
TRUNCATElegt een AccessExclusive-lock op- we zijn lang bezig met invoegen, en ondertussen kunnen anderen zelfs niet
SELECT
Dit gaat niet goed…
ALTER TABLE… RENAME… / DROP TABLE …
Een optie is om alles in een nieuwe tabel te plaatsen en deze vervolgens gewoon te hernoemen naar de oude. Een paar vervelende details:
- dat gaat ook AccessExclusive, zij het veel sneller
- al de query-plannen/statistieken van deze tabel worden gereset,
- alle externe sleutels (FK) naar de tabel zijn defect Er was een WIP-patch van Simon Riggs, die voorstelde om een
ALTER -operatie te maken voor het vervangen van de tabelstructuur op bestandniveau, zonder de statistieken en FK aan te raken, maar hij kwam niet tot een quorum.DELETE, UPDATE, INSERT
Dus, we gaan voor de niet-blokkerende optie uit de drie bewerkingen. Bijna drie… Hoe doen we dit het meest efficiënt?
-- alles doen binnen een transactie, zodat niemand "tussentijdse" toestanden ziet BEGIN;-- creëren van een tijdelijke tabel met de te importeren gegevens CREATE TEMPORARY TABLE tmp( LIKE dst INCLUDING INDEXES -- naar het voorbeeld, inclusief indexen ) ON COMMIT DROP; -- buiten de transactie hebben we deze niet meer nodig-- snel de nieuwe structuur importeren via COPY COPY tmp FROM STDIN; -- ... -- .-- ontbrekende records verwijderen DELETE FROM dst D USING dst X LEFT JOIN tmp Y USING(pk1, pk2) -- primaire sleutels WHERE (D.pk1, D.pk2) = (X.pk1, X.pk2) AND Y IS NOT DISTINCT FROM NULL; -- "anti-join"-- de overblijvende records bijwerken UPDATE dst D SET (f1, f2, f3) = (T.f1, T.f2, T.f3) FROM tmp T WHERE (D.pk1, D.pk2) = (T.pk1, T.pk2) AND (D.f1, D.f2, D.f3) IS DISTINCT FROM (T.f1, T.f2, T.f3); -- geen reden om overlappende records bij te werken-- ontbrekende records invoegen INSERT INTO dst SELECT T.* FROM tmp T LEFT JOIN dst D USING(pk1, pk2) WHERE D IS NOT DISTINCT FROM NULL;COMMIT;
3.2. Nazorg van de import
In dezelfde KADRa moeten alle gewijzigde records bovendien door nazorg worden gecorrigeerd — genormaliseerd, sleutelwoorden geëxtraheerd en naar de juiste structuren gebracht. Maar hoe weten we —
wat precies is gewijzigd , zonder de synchronisatiecode te compliceren, idealiter zelfs niets aan te raken?Als er op het moment van synchronisatie alleen uw proces schrijf toegang heeft, kan een trigger worden gebruikt die al onze wijzigingen verzamelt:
Als het schrijfrecht op het moment van synchroniseren alleen aan jouw proces behoort, kun je gebruikmaken van een trigger die alle wijzigingen voor ons verzamelt:
-- doel tabellen
CREATE TABLE kladr(...);
CREATE TABLE kladr_house(...);

-- tabellen met geschiedenis van wijzigingen
CREATE TABLE kladr$log(
  ro kladr, -- hier liggen de volledige beelden van oude/nieuwe records
  rn kladr
);

CREATE TABLE kladr_house$log(
  ro kladr_house,
  rn kladr_house
);

-- algemene functie voor het loggen van wijzigingen
CREATE OR REPLACE FUNCTION diff$log() RETURNS trigger AS $$
DECLARE
  dst varchar = TG_TABLE_NAME || '$log';
  stmt text = '';
BEGIN
  -- controleer de noodzaak van logging bij het bijwerken van een record
  IF TG_OP = 'UPDATE' THEN
    IF NEW IS NOT DISTINCT FROM OLD THEN
      RETURN NEW;
    END IF;
  END IF;
  -- maak een logrecord aan
  stmt = 'INSERT INTO ' || dst::text || '(ro,rn)VALUES(';
  CASE TG_OP
    WHEN 'INSERT' THEN
      EXECUTE stmt || 'NULL,$1)' USING NEW;
    WHEN 'UPDATE' THEN
      EXECUTE stmt || '$1,$2)' USING OLD, NEW;
    WHEN 'DELETE' THEN
      EXECUTE stmt || '$1,NULL)' USING OLD;
  END CASE;
  RETURN NEW;
END;
$$ LANGUAGE plpgsql;
Nu kunnen we vóór het starten van de synchronisatie triggers aanbrengen (of inschakelen via ALTER TABLE ... ENABLE TRIGGER ...):
CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();

CREATE TRIGGER log
  AFTER INSERT OR UPDATE OR DELETE
  ON kladr_house
    FOR EACH ROW
      EXECUTE PROCEDURE diff$log();
En dan kunnen we eenvoudig alle benodigde wijzigingen uit de log-tabellen ophalen en deze door aanvullende verwerkers laten lopen.
3.3. Importeren van gerelateerde sets
Boven hebben we gevallen besproken waarin de datastructuren van de bron en de ontvanger overeenkomen. Maar wat te doen als de export uit een extern systeem een formaat heeft dat verschilt van de opslagstructuur in onze database?
Laten we als voorbeeld het opslaan van klanten en hun facturen nemen, een klassiek geval van 'veel-tot-een':
CREATE TABLE client(
  client_id
    serial
      PRIMARY KEY
, inn
    varchar
      UNIQUE
, name
    varchar
);

CREATE TABLE invoice(
  invoice_id
    serial
      PRIMARY KEY
, client_id
    integer
      REFERENCES client(client_id)
, number
    varchar
, dt
    date
, sum
    numeric(32,2)
);
Maar de export uit de externe bron komt bij ons binnen als 'alles-in-een':
CREATE TEMPORARY TABLE invoice_import(
  client_inn
    varchar
, client_name
    varchar
, invoice_number
    varchar
, invoice_dt
    date
, invoice_sum
    numeric(32,2)
);
Het is duidelijk dat de gegevens van klanten in deze opzet kunnen dupliceren, en de hoofdrecord is de 'factuur':
0123456789;Vasily;A-01;2020-03-16;1000.00
9876543210;Petya;A-02;2020-03-16;666.00
0123456789;Vasily;B-03;2020-03-16;9999.00
Voor het model voegen we eenvoudig onze testgegevens in, maar onthoud — COPY efficiënter!
INSERT INTO invoice_import
VALUES
  ('0123456789', 'Vasily', 'A-01', '2020-03-16', 1000.00)
, ('9876543210', 'Petya', 'A-02', '2020-03-16', 666.00)
, ('0123456789', 'Vasily', 'B-03', '2020-03-16', 9999.00);
Laten we eerst de 'sneden' выделим waarop onze 'feiten' verwijzen. In ons geval verwijzen de facturen naar de klanten:
MAAK EEN TIJDELIJKE TABEL client_import AAN
SELECT DISTINCT ON(client_inn)
-- je kunt gewoon SELECT DISTINCT gebruiken als de gegevens per definitie niet tegenstrijdig zijn
  client_inn inn
, client_name "name"
VAN
  invoice_import;
Om rekeningen correct te koppelen aan klant-ID's, moeten we deze identificaties eerst weten of genereren. We voegen velden voor hen toe:
ALTER TABLE invoice_import ADD COLUMN client_id integer;
ALTER TABLE client_import ADD COLUMN client_id integer;
We maken gebruik van de hierboven beschreven methode voor het synchroniseren van tabellen met een kleine aanpassing — we zullen niets bijwerken of verwijderen in de doeltabel, want de import van klanten is 'append-only':
-- we vullen de importtabel met ID's van reeds bestaande records
UPDATE
  client_import T
SET
  client_id = D.client_id
VAN
  client D
WAAR
  T.inn = D.inn; -- unieke sleutel

-- we voegen ontbrekende records in en vullen hun ID's in
WITH ins AS (
  INSERT INTO client(
    inn
  , name
  )
  SELECT
    inn
  , name
  VAN
    client_import
  WAAR
    client_id IS NULL -- als ID niet is ingevuld
  RETURNING *
)
UPDATE
  client_import T
SET
  client_id = D.client_id
VAN
  ins D
WAAR
  T.inn = D.inn; -- unieke sleutel

-- we vullen ID's van klanten in bij de rekeningrecords
UPDATE
  invoice_import T
SET
  client_id = D.client_id
VAN
  client_import D
WAAR
  T.client_inn = D.inn; -- toepasselijke sleutel
Eigenlijk is dat alles — in invoice_import nu is het veld voor de koppeling ingevuld client_id, dat we zullen gebruiken om de rekening in te voegen.
Bron: habr.com
