

Ontleding van het verslag van 2015 van Alexey Lesovsky 'Diepgaande verkenning van de interne statistieken van PostgreSQL'
Disclaimer van de auteur van het verslag: Ik merk op dat dit verslag dateert uit november 2015 - er zijn meer dan 4 jaar verstreken en er is veel tijd voorbijgegaan. De in het verslag besproken versie 9.4 wordt al niet meer ondersteund. In de afgelopen 4 jaar zijn er 5 nieuwe releases verschenen waarin veel innovaties, verbeteringen en wijzigingen met betrekking tot statistieken zijn geïntroduceerd en een deel van het materiaal is verouderd en niet meer actueel. Tijdens de review heb ik geprobeerd deze plekken te markeren om je, lezer, niet in verwarring te brengen. Ik heb deze plekken echter niet herschreven, er zijn er veel en het zou uiteindelijk een heel ander verslag opleveren.
De database PostgreSQL is een enorm mechanisme, dat bestaat uit vele subsystemen, waarvan de gecoördineerde werking direct invloed heeft op de prestaties van de database. In het proces van exploitatie wordt statistiek en informatie over de werking van componenten verzameld, wat het mogelijk maakt om de effectiviteit van PostgreSQL te beoordelen en maatregelen te nemen om de prestaties te verbeteren. Deze informatie is echter overvloedig en wordt in een vrij vereenvoudigde vorm gepresenteerd. Het verwerken en interpreteren van deze informatie is soms een niet-triviale taak, en de 'dierenentuin' van tools en utilities kan zelfs een geavanceerde DBA in verwarring brengen.
Goedendag! Mijn naam is Alexey. Zoals Ilya zei, ga ik praten over de statistieken van PostgreSQL.
Activiteitstatistieken van PostgreSQL. PostgreSQL heeft twee soorten statistieken. Activiteitstatistieken, waarover we het zullen hebben. En statistieken van de planner over de verdeling van gegevens. Ik ga specifiek in op de activiteitstatistieken van PostgreSQL, die ons in staat stellen de prestaties te beoordelen en deze op een of andere manier te verbeteren.
Ik zal uitleggen hoe je statistieken effectief kunt gebruiken om een verscheidenheid aan problemen op te lossen die je tegenkomt of kunt tegenkomen.
Wat zal er niet in het verslag staan? In het verslag zal ik de statistiek van de planner niet behandelen, omdat dit een apart onderwerp is voor een apart verslag over hoe gegevens in de database worden opgeslagen en hoe de queryplanner een beeld krijgt van de kwalitatieve en kwantitatieve kenmerken van deze gegevens.
En er zullen geen overzichten van tools zijn, ik zal geen producten met elkaar vergelijken. Er zal geen reclame zijn. Laten we dat achterwege laten.
Ik wil je laten zien dat het gebruik van statistieken nuttig is. Het is nodig. Het is niet eng om het te gebruiken. We hebben alleen een gewone SQL en basiskennis van SQL nodig.
En laten we bespreken welke statistieken we moeten kiezen om problemen op te lossen.
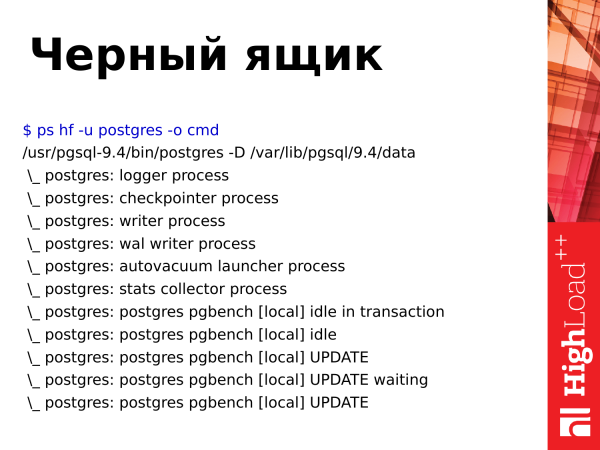
Als we naar PostgreSQL kijken en de opdracht voor het bekijken van processen in het besturingssysteem uitvoeren, zullen we een "zwartdoos" zien. We zullen een aantal processen zien die iets doen, en aan de hand van hun namen kunnen we ongeveer begrijpen wat ze doen en waar ze mee bezig zijn. Maar in wezen is dit een zwartdoos, we kunnen er niet in kijken.
We kunnen de belasting van de processor bekijken in top, we kunnen de geheugengebruik met systeemutiliteitsprogramma's bekijken, maar we kunnen niet naar binnen in PostgreSQL kijken. Hiervoor hebben we andere tools nodig.
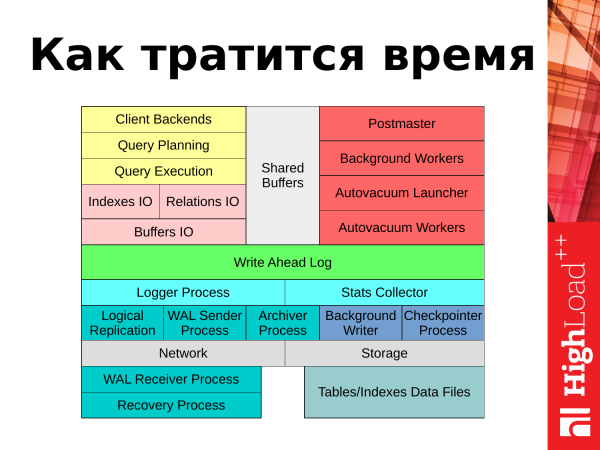
En voortgaand zal ik uitleggen waar de tijd naartoe gaat. Als we PostgreSQL in de vorm van een schema voorstellen, kunnen we antwoorden waar de tijd naartoe gaat. Dit zijn twee dingen: het verwerken van klantaanvragen van applicaties en achtergrondtaken die PostgreSQL uitvoert voor het onderhoud van zijn werking.
Als we beginnen met het linkerbovenhoek van het schema, kunnen we volgen hoe klantaanvragen worden verwerkt. Een aanvraag komt van de applicatie en voor verdere verwerking wordt er een klant sessie geopend. De aanvraag wordt doorgestuurd naar de planner. De planner maakt een aanvraagplan. Dit wordt vervolgens voor uitvoering verzonden. Er vindt een blok IO van gegevens plaats die verband houden met tabellen en indexen. De noodzakelijke gegevens worden van de schijven naar het geheugen gelezen in een speciaal gebied genaamd "shared buffers". De resultaten van de aanvraag, als het updates of deletes zijn, worden vastgelegd in het transactie log in WAL. Sommige statistische informatie komt in de log of in de statistiekverzamelaar terecht. En het resultaat van de aanvraag wordt teruggegeven aan de klant. Daarna kan de klant alles opnieuw doen met een nieuwe aanvraag.
Wat betreft de achtergrondtaken en achtergrondprocessen? We hebben verschillende processen die de werking waarborgen en de database in een normale werkmodus houden. Deze processen zullen ook in de presentatie worden behandeld: dit zijn autovacuum, checkpointer, processen die met replicatie te maken hebben, background writer. Ieder van hen zal ik gedurende de presentatie behandelen.
Wat zijn de problemen met betrekking tot statistieken?
- Er is veel informatie. PostgreSQL 9.4 biedt 109 statieken voor het bekijken van gegevens. Als er echter veel tabellen, schema's, databases in de database zijn opgeslagen, moet je al deze statistieken vermenigvuldigen met het betreffende aantal tabellen en databases. Dat betekent dat de informatie nog verder toeneemt. En het is heel gemakkelijk om erin te verdrinken.
- Een volgend probleem is dat de statistieken in de vorm van tellers worden gepresenteerd. Zodra we deze statistieken bekijken, zien we constant toenemende tellers. En als er al veel tijd is verstreken sinds de statistieken zijn gereset, zien we miljardenwaarden. En die zeggen ons niets.
- Er is geen geschiedenis. Als er een storing is opgetreden, bijvoorbeeld 15-30 minuten geleden, kun je de statistieken niet gebruiken om te zien wat er die 15-30 minuten is gebeurd. Dat is een probleem.
- Het ontbreken van een ingebouwde tool in PostgreSQL is een probleem. De ontwikkelaars van de kern bieden geen enkele tool aan. Ze hebben niets dergelijks. Ze geven gewoon de statistieken in de database. Maak er gebruik van, stel je vragen, doe wat je wilt.
- Aangezien er geen ingebouwde tool in PostgreSQL is, leidt dit tot een ander probleem. Veel externe tools. Elk bedrijf met enige technische vaardigheden probeert zijn eigen programma te schrijven. En uiteindelijk zijn er in de community veel tools die gebruikt kunnen worden voor statistiek. Sommige tools hebben bepaalde mogelijkheden, andere tools hebben weer andere mogelijkheden of nieuwe functies. Dit leidt ertoe dat je twee, drie of vier tools moet gebruiken die elkaar overlappen en verschillende functionaliteiten bezitten. Dat is zeer onplezierig.
Wat kunnen we hieruit concluderen? Het is belangrijk om statistieken rechtstreeks op te halen, zodat je niet afhankelijk bent van software, of om deze programma's zelf te verbeteren: voeg enkele functies toe om je voordeel te behalen.
Basiskennis van SQL is nodig. Om bepaalde gegevens uit de statistieken te halen, moet je SQL-query's samenstellen, dat wil zeggen dat je moet weten hoe je select en join opbouwt.
Statistieken bieden ons verschillende dingen. Deze kunnen worden onderverdeeld in categorieën.
- De eerste categorie betreft gebeurtenissen die plaatsvinden in de database. Dit zijn gebeurtenissen zoals een verzoek, een oproep naar een tabel, autovacuüm, commits; al deze gebeurtenissen worden geregistreerd. De bijbehorende tellers worden geüpdatet. We kunnen deze gebeurtenissen volgen.
- De tweede categorie zijn de eigenschappen van objecten zoals tabellen en databases. Ze hebben specifieke eigenschappen, zoals de grootte van de tabellen. We kunnen de groei van tabellen en indices volgen en veranderingen in de dynamiek bekijken.
- De derde categorie betreft de tijd die aan een gebeurtenis wordt besteed. Een verzoek is bijvoorbeeld een gebeurtenis met zijn eigen specifieke tijdsduur. We kunnen zien wanneer het is gestart en wanneer het is beëindigd. Ook de tijd die nodig is voor het lezen van een blok van de schijf of het schrijven daarvan, wordt bijgehouden.
De bronnen van de statistieken worden als volgt gepresenteerd:
- In het gedeelde geheugen (shared buffers) is er een segment voor het plaatsen van statistische gegevens, waar ook die tellers zich bevinden die voortdurend worden geüpdated bij het optreden van bepaalde gebeurtenissen of wanneer er specifieke momenten in de werking van de database optreden.
- Al deze tellers zijn niet toegankelijk voor de gebruiker en zelfs niet voor de administrator. Dit zijn low-level zaken. Om toegang te krijgen tot deze gegevens biedt PostgreSQL een interface in de vorm van SQL-functies. We kunnen select-queries uitvoeren met behulp van deze functies en bepaalde statistieken (of een set statistieken) verkrijgen.
- Het gebruik van deze functies is echter niet altijd handig, daarom dienen ze als basis voor weergaven (VIEWs). Dit zijn virtuele tabellen die statistieken over een specifieke subsysteem of een bepaalde set gebeurtenissen in de database bieden.
- Deze ingebouwde weergaven (VIEWs) zijn de belangrijkste interface voor de gebruiker om met statistieken te werken. Ze zijn standaard beschikbaar zonder enige extra configuratie; je kunt ze meteen gebruiken om informatie in te zien en daaruit te halen. Daarnaast zijn er de contrib-modules. De contrib-modules zijn officieel. Je kunt het postgresql-contrib-pakket installeren (bijvoorbeeld postgresql94-contrib), de benodigde module laden in de configuratie, parameters voor deze module opgeven, PostgreSQL herstarten en de module gebruiken. (Opmerking. Afhankelijk van de distributie is het contrib-pakket in de laatste versies een onderdeel van het hoofdpackage.).
- Er zijn ook niet-officiële contrib. Deze worden niet meegeleverd met de standaard PostgreSQL-installatie. Ze moeten ofwel worden gecompileerd of als bibliotheek worden geïnstalleerd. De varianten kunnen heel divers zijn, afhankelijk van wat de ontwikkelaar van deze niet-officiële contrib heeft bedacht.
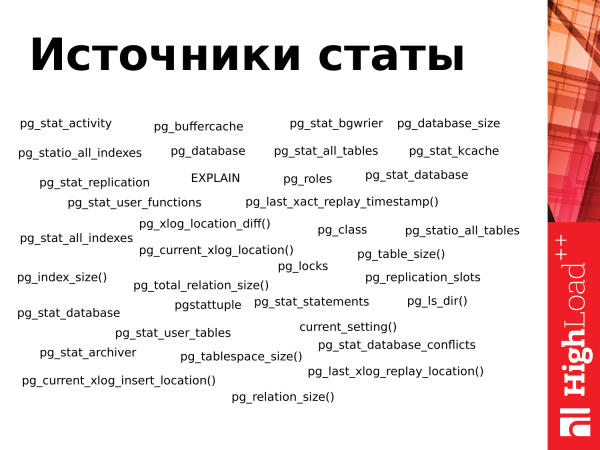
Op deze slide zijn alle views en een deel van de functies weergegeven die beschikbaar zijn in PostgreSQL 9.4. Zoals we zien, zijn er er heel veel. En het is vrij gemakkelijk om in de war te raken als je dit voor de eerste keer ziet.
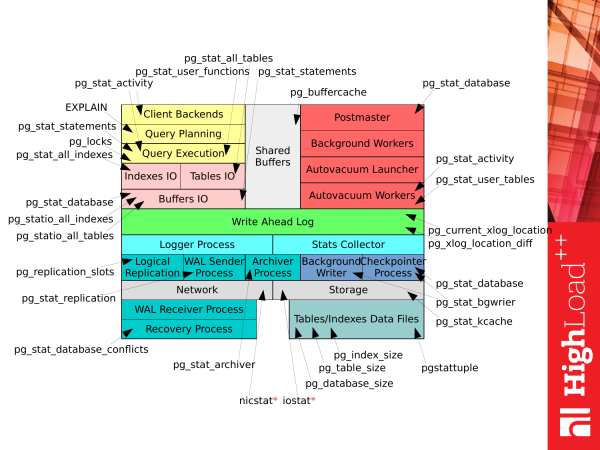
Maar als we de vorige afbeelding bekijken Hoe de tijd in PostgreSQL wordt besteed en dit vergelijken met deze lijst, krijgen we deze afbeelding. Elke view of functie kunnen we gebruiken voor verschillende doeleinden om relevante statistieken te verkrijgen wanneer PostgreSQL draait. En we kunnen al wat informatie krijgen over de werking van de subsysteem.
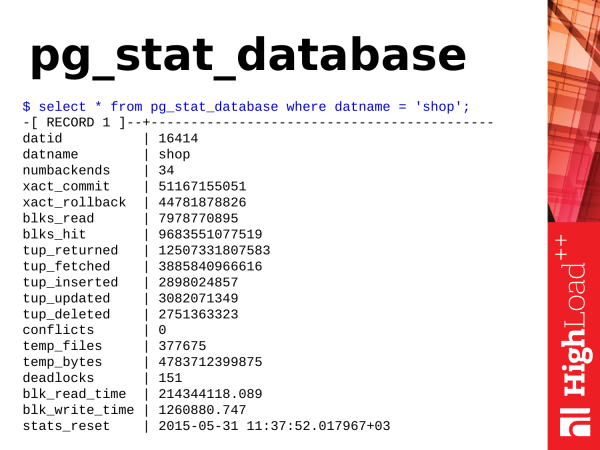
Het eerste dat we zullen bekijken, is pg_stat_database. Zoals we zien, is dit een view. Hierin staat veel informatie. Zeer diverse informatie. En het biedt zeer nuttige kennis over wat er in de database gebeurt.
Wat kunnen we hieruit nuttigs halen? Laten we beginnen met de eenvoudigste dingen.
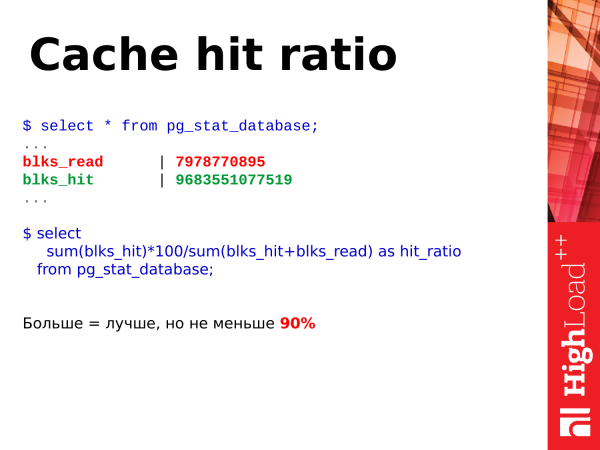
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
Het eerste dat we kunnen bekijken, is het percentage cache-hits. Het percentage cache-hits is een nuttige metriek. Het stelt ons in staat om te beoordelen welk volume data uit de shared buffers-cache wordt gehaald en welke hoeveelheid van de schijf wordt gelezen.
Het is logisch dat hoe hoger ons cache-hitpercentage, hoe beter. We evalueren deze metriek als percentage. En bijvoorbeeld, als ons percentage van deze cache-hits boven de 90% ligt, is dat goed. Als het onder de 90% zakt, betekent dit dat we onvoldoende geheugen hebben om de 'hot' data in het geheugen vast te houden. En om deze gegevens te gebruiken, moet PostgreSQL de schijf benaderen, wat langzamer is dan wanneer de gegevens uit het geheugen worden gelezen. En dan moeten we al nadenken over het vergroten van het geheugen: ofwel de shared buffers verhogen, ofwel het fysieke geheugen (RAM) uitbreiden.
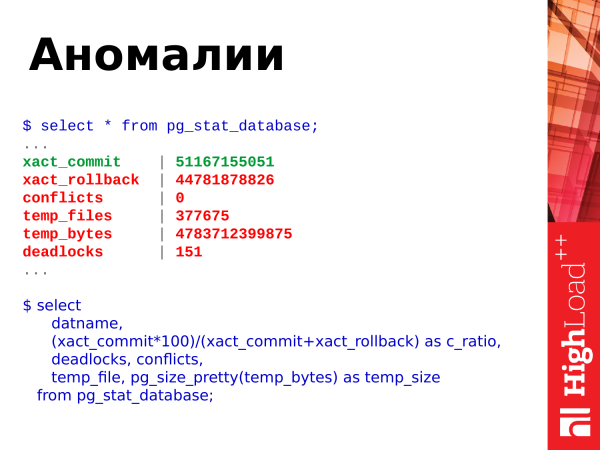
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
Wat kunnen we nog meer uit deze view halen? We kunnen anomalieën in de database bekijken. Wat wordt hier weergegeven? Hier zijn commits, rollbacks, de creatie van tijdelijke bestanden, hun volume, deadlocks en conflicten.
We kunnen gebruikmaken van deze query. Deze SQL is vrij eenvoudig. En we kunnen deze gegevens bekijken bij ons.
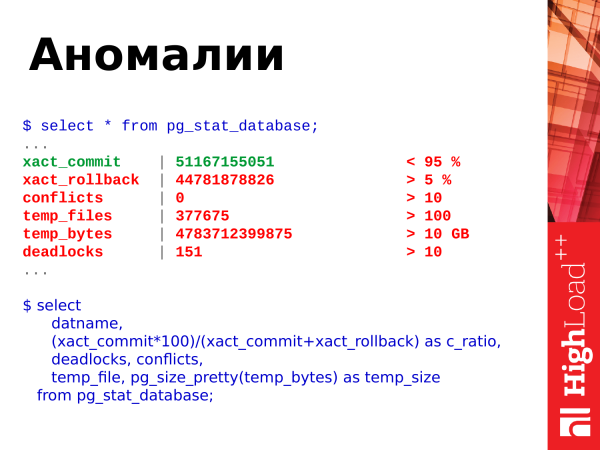
En hier zijn meteen de drempelwaarden. We kijken naar de verhouding tussen commits en rollbacks. Commits zijn de succesvolle bevestigingen van een transactie. Rollbacks zijn terugdraaien, dat wil zeggen dat de transactie een bepaalde taak heeft uitgevoerd, de database heeft belast, iets heeft berekend, en vervolgens ging het mis, en worden de resultaten van de transactie verworpen. Dat wil zeggen. het aantal rollbacks, dat voortdurend toeneemt, is slecht. En dat moet op de een of andere manier worden vermeden, en de code moet worden gecorrigeerd om dit te voorkomen.
Conflicten zijn gerelateerd aan replicatie. En die moeten ook worden vermeden. Als je verzoeken hebt die op de replica worden uitgevoerd en er conflicten optreden, dan moet je deze conflicten analyseren en bekijken wat er gebeurt. Details zijn te vinden in de logs. En los conflicten op, zodat de aanvragen van de toepassing zonder fouten werken.
Deadlocks zijn ook een slechte situatie. Wanneer aanvragen strijden om bronnen, heeft één aanvraag toegang gekregen tot één bron en een blokkering opgelegd, een andere aanvraag heeft toegang gekregen tot een andere bron en heeft ook een blokkering opgelegd, en toen zijn beide aanvragen naar elkaars bronnen gegaan en zijn geblokkeerd terwijl ze wachtten tot de buur de blokkering opheft. Dit is ook een problematische situatie. Ze moeten worden opgelost op het niveau van herschrijven van applicaties en serialisering van de toegang tot bronnen. En als je ziet dat je deadlocks voortdurend toenemen, moet je de details in de logs bekijken, de opkomende situaties analyseren en kijken wat het probleem is.
Tijdelijke bestanden zijn ook slecht. Wanneer de gebruikersaanvraag niet genoeg geheugen heeft om operationele, tijdelijke gegevens op te slaan, creëert deze een bestand op de schijf. En alle operaties die het in de tijdelijke buffer in het geheugen zou kunnen uitvoeren, begint het al op de schijf uit te voeren. Dit is langzaam. Dit verhoogt de uitvoeringstijd van de aanvraag. En de klant die de aanvraag naar PostgreSQL heeft gestuurd, krijgt iets later een antwoord. Als al deze operaties in het geheugen zouden worden uitgevoerd, zou Postgres veel sneller antwoorden en zou de klant minder lang hoeven te wachten.
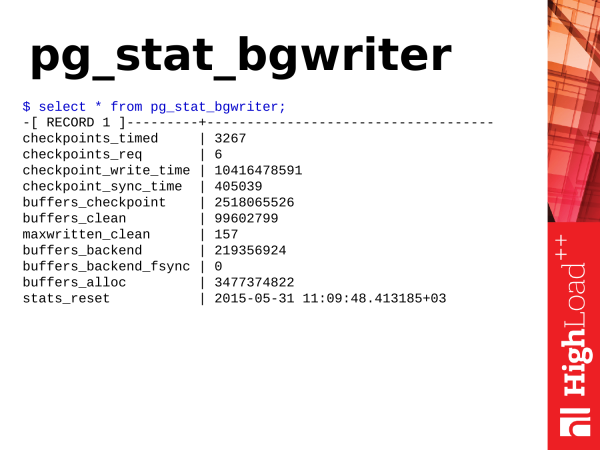
Pg_stat_bgwriter is een weergave die het werk van twee achtergrondsubsystemen van PostgreSQL beschrijft: dit zijn checkpointer en background writer.
Laten we beginnen met de controlepunten, de zogenaamde checkpoints. Wat zijn controlepunten? Een controlepunt is een positie in het transactie-log die aangeeft dat alle gegevenswijzigingen die in het log zijn vastgelegd, succesvol zijn gesynchroniseerd met de gegevens op de schijf. Het proces kan afhankelijk van de werklast en instellingen langdurig zijn en bestaat grotendeels uit de synchronisatie van vuile pagina's in de shared buffers met de datagegevens op de schijf. Waarom is dit nodig? Als PostgreSQL voortdurend naar de schijf zou moeten gaan om gegevens op te halen en gegevens bij elke toegang zou moeten schrijven, zou dat traag zijn. Daarom heeft PostgreSQL een geheugensegment waarvan de grootte afhankelijk is van de parameters in de configuratie. Postgres plaatst in dit geheugen operationele gegevens voor verdere verwerking of levering op verzoek. In het geval van verzoeken om gegevens te wijzigen, vindt de wijziging plaats. En we krijgen twee versies van gegevens. De ene is in geheugen, de andere op schijf. En af en toe moeten deze gegevens worden gesynchroniseerd. We moeten de gewijzigde gegevens in het geheugen naar de schijf synchroniseren. Hiervoor zijn checkpoints nodig.
Het checkpoint doorloopt de shared buffers, markeert de vuile pagina's die nodig zijn voor het checkpoint. Vervolgens start het een tweede doorloop door de shared buffers. En de pagina's die voor het checkpoint zijn gemarkeerd, worden nu gesynchroniseerd. Op deze manier vindt de synchronisatie van gegevens plaats met de schijf.
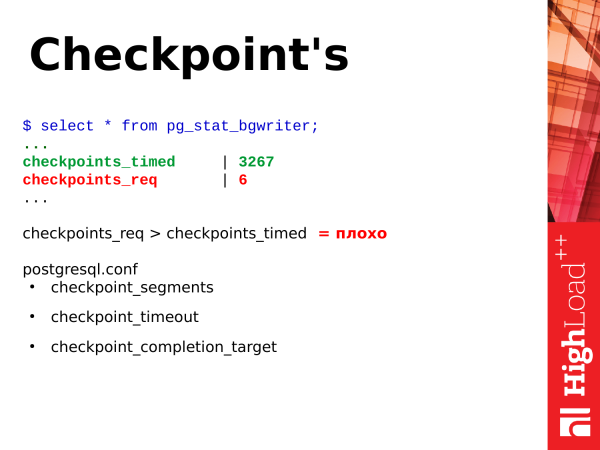
Er zijn twee typen controlepunten. Een checkpoint wordt uitgevoerd op basis van een timeout. Dit is een nuttige en goede checkpoint - checkpoint_timed. En er zijn checkpoints op verzoek - checkpoint_required. Zo'n controlepunt vindt plaats wanneer we zeer veel gegevens schrijven. We hebben een groot aantal transactie-logboeken geschreven. En PostgreSQL is van mening dat het dit zo snel mogelijk moet synchroniseren, een checkpoint moet maken en verder moet gaan.
En als je de statistieken hebt bekeken pg_stat_bgwriter en hebt gezien dat je checkpoint_req veel hoger is dan checkpoint_timed, dan is dat slecht. Waarom is het slecht? Dit betekent dat PostgreSQL zich in een constante stress-situatie bevindt wanneer het gegevens op de schijf moet schrijven. Checkpoint op basis van tijd is minder stressvol en wordt uitgevoerd volgens een intern schema en is als het ware over de tijd verspreid. PostgreSQL heeft de mogelijkheid om pauzes in de werking te maken en de schijfsubsystemen niet onder druk te zetten. Dit is voordelig voor PostgreSQL. En verzoeken die tijdens een checkpoint worden uitgevoerd, zullen geen stress ervaren omdat het schijfsubsystemen druk bezig is.
En er zijn drie parameters voor het aanpassen van checkpoint:
checkpoint_segments.checkpoint_timeout.checkpoint_completion_target.
Deze parameters stellen je in staat om de werking van checkpoints te regelen. Maar ik zal niet bij deze blijven hangen. Hun invloed is al een apart onderwerp.
Let op: De versie 9.4 die in het rapport wordt besproken, is inmiddels verouderd. In de moderne versies van PostgreSQL is de parameter checkpoint_segments vervangen door de parameters min_wal_size en max_wal_size.
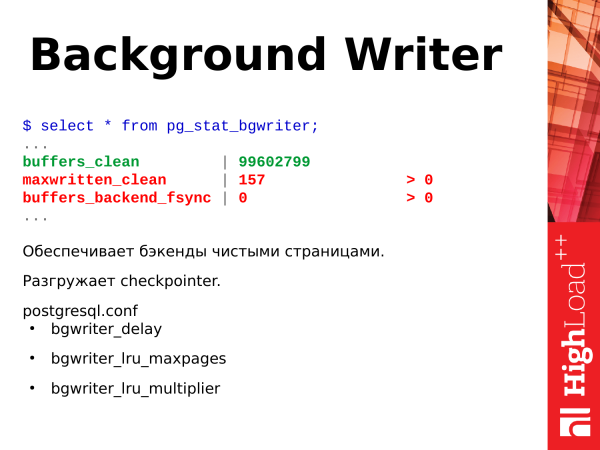
Het volgende subsysteem is de achtergrondschrijver — background writer. Wat doet hij? Hij werkt continu in een oneindige lus. Hij scant pagina's in de shared buffers en de vuile pagina's die hij vindt, schrijft hij naar schijf. Op deze manier helpt hij de checkpointer om minder werk te doen tijdens het uitvoeren van checkpoints.
Waar is hij verder nog voor nodig? Hij zorgt voor de behoefte aan schone pagina's in shared buffers als deze plotseling (in grote aantallen en tegelijk) nodig zijn voor het plaatsen van gegevens. Stel je voor dat er een situatie is waarin er schone pagina's nodig zijn voor de uitvoering van een query, en ze zijn al in shared buffers. De PostgreSQL backend neemt ze gewoon en gebruikt ze, hij hoeft zelf niets schoon te maken. Maar als er geen dergelijke pagina's zijn, stopt de backend met werken en begint hij pagina's te zoeken om naar schijf te schrijven en voor zijn eigen behoeften te nemen - wat een negatieve invloed heeft op de tijd die nodig is voor de uitvoerende query op dat moment. Als je ziet dat je parameter maxwritten_clean hoog is, betekent dit dat de achtergrondschrijver zijn werk niet goed doet en dat de parameters moeten worden verhoogd bgwriter_lru_maxpages, zodat hij in één cyclus meer werk kan doen en meer pagina's kan schoonmaken.
En een andere zeer nuttige indicator is buffers_backend_fsync. Backends voeren geen fsync uit omdat dit traag is. Ze geven fsync door aan de checkpointer in de IO-stack. De checkpointer heeft zijn eigen wachtrij, hij behandelt fsync periodiek en synchroniseert pagina's in het geheugen met bestanden op schijf. Als de wachtrij van de checkpointer groot en vol is, is de backend gedwongen om zelf fsync uit te voeren en dit vertraagt de werking van de backend, d.w.z. de klant krijgt later een antwoord dan hij zou kunnen. Als je ziet dat deze waarde groter is dan nul, dan is dat al een probleem en moet je aandacht besteden aan de instellingen van de achtergrondschrijver en ook de prestaties van het schijfsysteem beoordelen.
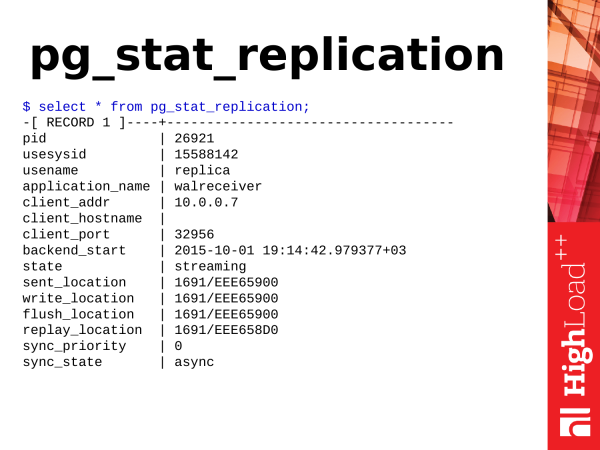
Let op: _De volgende tekst beschrijft de statistische weergaven met betrekking tot replicatie. De meeste namen van weergaven en functies zijn hernoemd in Postgres 10. Het doel van de hernoemingen was om xlog en een werkende opdracht krijgen. wal en locatie en een werkende opdracht krijgen. lsn in de namen van functies/weergaven enz. Een specifiek voorbeeld, de functie pg_xlog_location_diff() werd hernoemd naar pg_wal_lsn_diff()._
Ook hier hebben we veel te bespreken. Maar we hebben slechts de punten nodig die betrekking hebben op locatie.
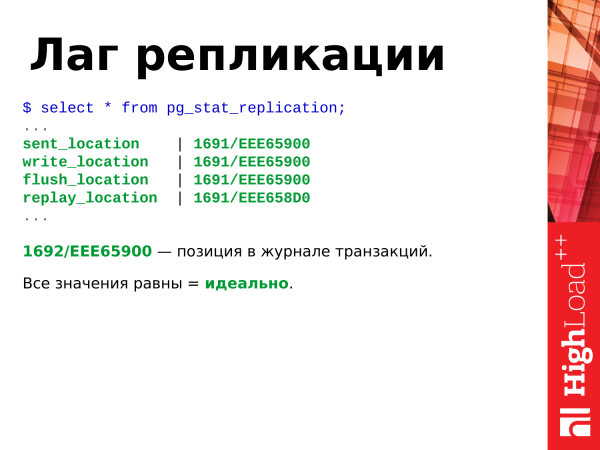
Als we zien dat alle waarden gelijk zijn, is dat de ideale situatie en loopt de replica niet achter op de master.
Deze hexadecimale positie is de positie in het transactie-log. Deze neemt constant toe als er activiteit in de database is: inserts, deletes, enz.
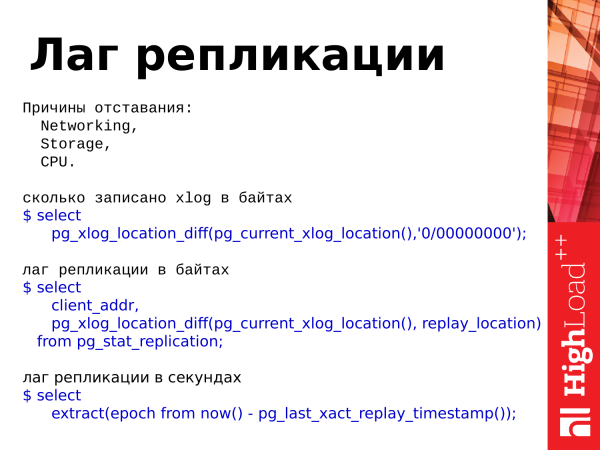
hoeveel xlog in bytes is geschreven
$ select
pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000');
replicatielatentie in bytes
$ select
client_addr,
pg_xlog_location_diff(pg_current_xlog_location(), replay_location)
from pg_stat_replication;
replicatielatentie in seconden
$ select
extract(epoch from now() - pg_last_xact_replay_timestamp());
Als deze dingen verschillen, betekent dat er een of andere latentie is. Latentie is de achterstand van de replica op de master, dat wil zeggen, de gegevens verschillen tussen de servers.
Er zijn drie redenen voor achterstand:
- Het is het opslagsysteem dat niet in staat is om de synchronisatie van bestanden te schrijven.
- Het kan netwerkmissers zijn, of netwerkbelasting, waarbij de gegevens niet op tijd bij de replica aankomen en hij ze niet kan reproduceren.
- En de processor. De processor is een heel zeldzaam geval. En ik heb dit twee of drie keer gezien, maar het kan ook gebeuren.
Hier zijn drie queries die ons in staat stellen om de statistieken te gebruiken. We kunnen beoordelen hoeveel er in ons transactie-log is geschreven. Er is een functie pg_xlog_location_diff en we kunnen de replicatielatentie in bytes en seconden schatten. Hiervoor gebruiken we ook de waarde uit deze weergave (VIEWs).
Opmerking: _In plaats van pg_xlog_locationdiff() kunnen we de aftrekkingsoperator gebruiken en de ene locatie van de andere aftrekken. Dat is handig.
Met de latentie die in seconden is, is er één punt. Als er op de master geen activiteit is, de transactie daar ongeveer 15 minuten geleden was en er geen activiteit is, en als we naar deze latentie op de replica kijken, zien we een latentie van 15 minuten. Dit is belangrijk om te onthouden. En dit kan verwarrend zijn als je naar deze latentie kijkt.
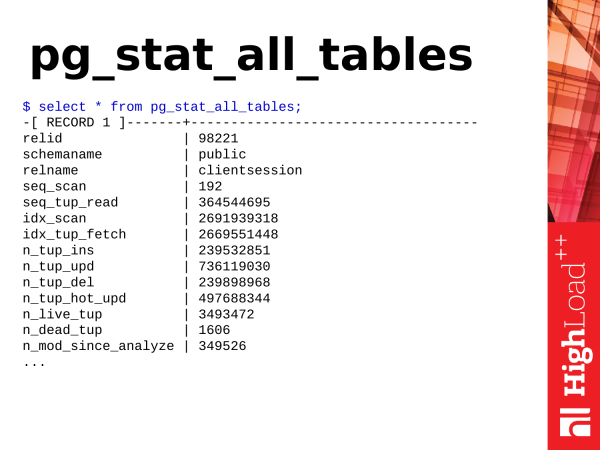
Pg_stat_all_tables is another useful view. It shows statistics for tables. When we have tables in the database with some activity or actions taking place, we can obtain this information from this view.
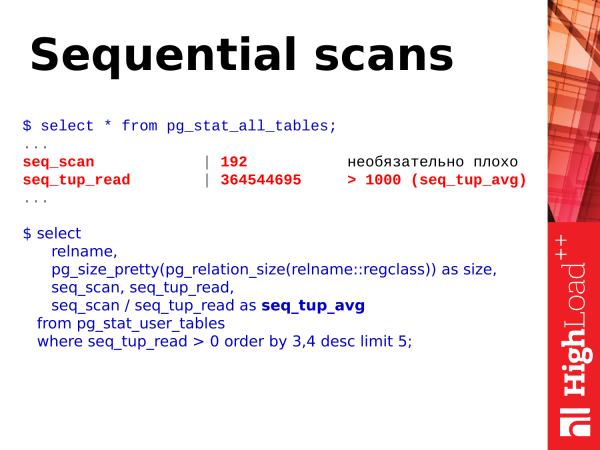
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3,4 desc limit 5;
The first thing we can look at is sequential scans on the table. The number following these scans is not necessarily bad and does not indicate that action needs to be taken.
However, there is a second metric – seq_tup_read. This is the number of rows returned as a result of a sequential scan. If the average number exceeds 1,000, 10,000, 50,000, or 100,000, it indicates that you might need to build an index somewhere to allow index-based access, or possibly optimize the queries that use such sequential scans to avoid this issue.
A simple example – suppose a query with a large OFFSET and LIMIT is used. For instance, scanning 100,000 rows in a table and then taking 50,000 required rows while discarding previously scanned rows. This is also a bad case, and such queries need optimization. Here’s a simple SQL query that can demonstrate this and allow you to evaluate the obtained figures.
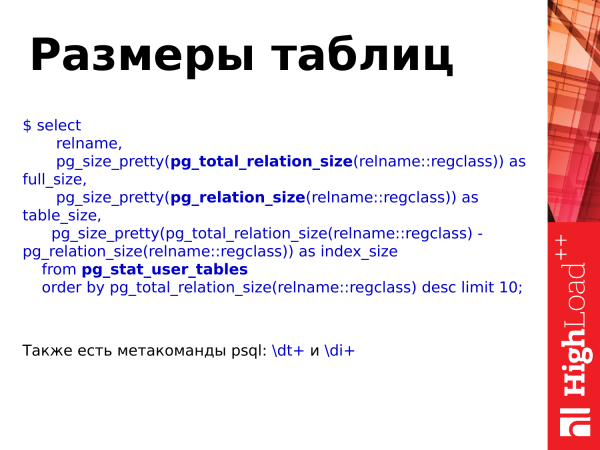
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
Table sizes can also be obtained using this table and additional functions. pg_total_relation_size(), pg_relation_size().
In general, there are meta-commands dt en di, which can be used in PSQL to view the sizes of tables and indices.
However, using functions helps us view table sizes, considering indices or not, and allows us to make assessments based on database growth, i.e., how it is expanding, at what intensity, and draw conclusions about size optimization.
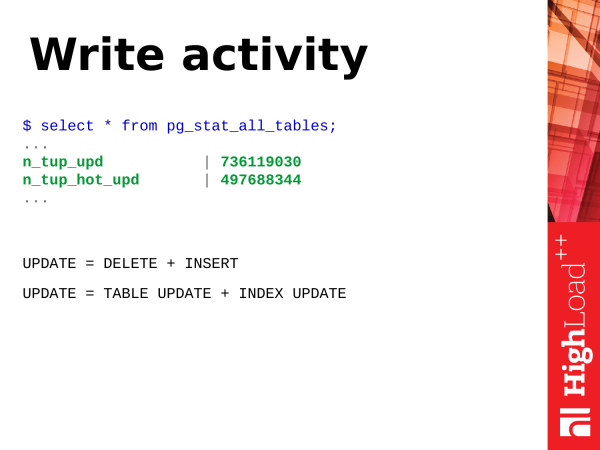
Write activity. What is a write operation? Let's examine the operation. UPDATE – de bewerking voor het bijwerken van rijen in een tabel. In wezen is update een combinatie van twee operaties (en mogelijk nog meer). Dit omvat het invoegen van een nieuwe versie van de rij en het markeren van de oude versie van de rij als verouderd. Later komt de autovacuüm en deze verouderde versies van rijen worden dan opgeruimd, waarbij deze ruimte als beschikbaar voor hergebruik wordt gemarkeerd.
Bovendien is update niet alleen het bijwerken van de tabel. Het omvat ook het bijwerken van de indexen. Als je veel indexen op de tabel hebt, moeten bij een update alle indexen die de velden bevatten die in de aanvraag worden bijgewerkt, ook worden bijgewerkt. In deze indexen zullen ook verouderde versies van rijen aanwezig zijn die moeten worden opgeruimd.
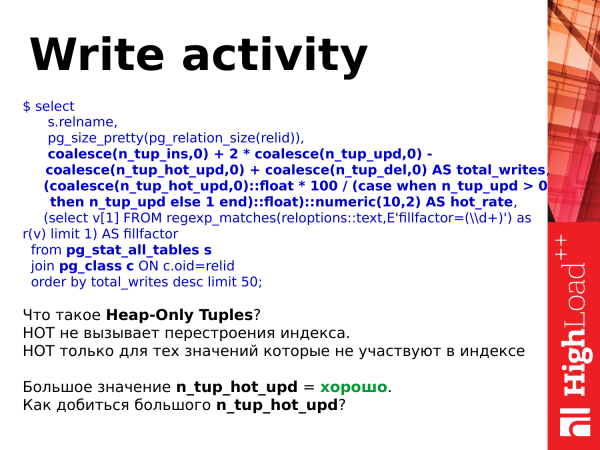
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
En door zijn ontwerp zijn UPDATE zware operaties. Maar ze kunnen worden verlicht. Er zijn hot updates. Deze zijn geïntroduceerd in PostgreSQL versie 8.3. En wat zijn ze? Dit is een lichte update die geen herstructurering van indexen veroorzaakt. Dat wil zeggen, we hebben een record bijgewerkt, maar alleen het record op de pagina (die bij de tabel hoort) is bijgewerkt, terwijl de indexen nog steeds naar hetzelfde record op de pagina verwijzen. Het werkingsprincipe is interessant; wanneer het vacuüm komt, worden deze ketens opnieuw opgebouwd hot en alles blijft werken zonder indexupdates, met een lagere belasting van de middelen.
En wanneer je n_tup_hot_upd hoog is, is dat heel goed. Dit betekent dat lichte updates de overhand hebben en dat het minder resources kost, waardoor alles goed gaat.
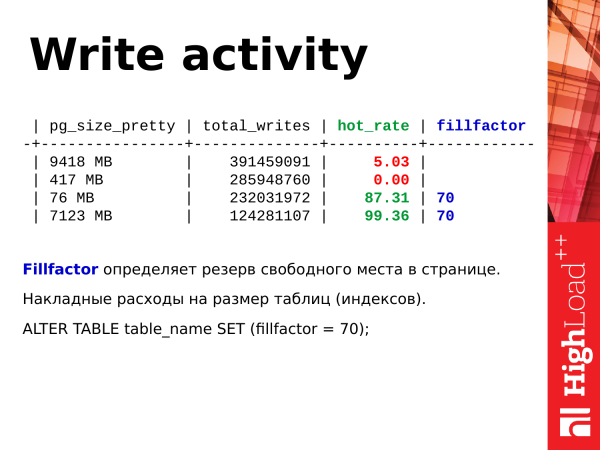
ALTER TABLE table_name SET (fillfactor = 70);Hoe de hoeveelheid hot updates te verhogen? We kunnen gebruikmaken van fillfactor. Dit bepaalt de grootte van de gereserveerde lege ruimte bij het vullen van een pagina in de tabel met behulp van INSERT’s. Wanneer er inserts in de tabel komen, vullen ze de pagina volledig op, waardoor er geen lege ruimte achterblijft. Dan wordt er een nieuwe pagina toegewezen. De gegevens worden opnieuw ingevuld. Dit is het standaardgedrag, met fillfactor = 100%.
We kunnen de fillfactor op 70 % instellen. Dit betekent dat er bij invoegen een nieuwe pagina wordt toegewezen, maar dat slechts 70 % van de pagina is ingevuld. En 30 % blijft als reserve. Wanneer we een update moeten doen, zal deze naar alle waarschijnlijkheid op dezelfde pagina plaatsvinden, en de nieuwe versie van de rij komt op dezelfde pagina te staan. En er zal een hot_update worden uitgevoerd. Op deze manier wordt het schrijven op de tabellen vergemakkelijkt.
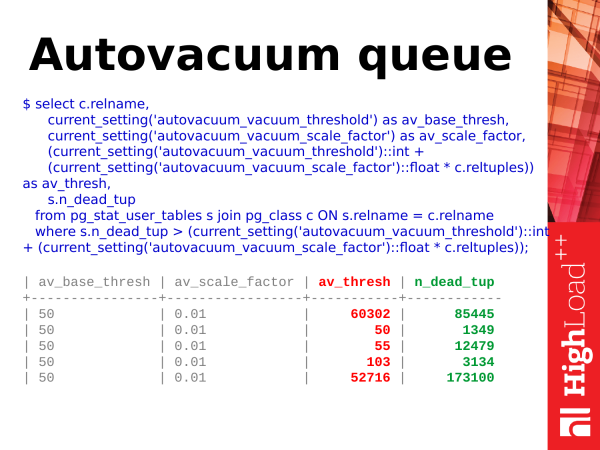
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
De wachtrij van de autovacuum. Autovacuum is een subsysteem waarover in PostgreSQL heel weinig statistieken beschikbaar zijn. We kunnen in de tabellen alleen in pg_stat_activity zien hoe lang onze vacuumprocessen momenteel duren. Maar het is heel moeilijk om te begrijpen hoeveel tabellen er in de wachtrij staan.
Opmerking: _Sinds versie Postgres 10 is de situatie met het volgen van autovacuum aanzienlijk verbeterd — er is een weergave pg_stat_progressvacuum, die het monitoren van autovacuum aanzienlijk vereenvoudigt.
We kunnen een vereenvoudigde query gebruiken. En we kunnen bekijken wanneer er een vacuum moet worden uitgevoerd. Maar hoe en wanneer moet het vacuum worden gestart? Dit zijn de verouderde versies van de rijen waar ik eerder over sprak. Een update heeft plaatsgevonden, en een nieuwe versie van de rij is ingevoegd. Er is een verouderde versie van de rij ontstaan. In de tabel pg_stat_user_tables is er een parameter n_dead_tup. Deze geeft het aantal "dode" rijen aan. Zodra het aantal dode rijen groter is dan een bepaalde drempel, komt de autovacuum naar de tabel.
En hoe wordt deze drempel berekend? Dit is een heel specifiek percentage van het totale aantal rijen in de tabel. Er is een parameter autovacuum_vacuum_scale_factor. Dit bepaalt het percentage verhouding. Laten we zeggen, 10 % + daar een aanvullende basisdrempel van 50 rijen. En wat gebeurt er? Wanneer we meer dode rijen hebben dan "10 % + 50" van alle rijen in de tabel, plaatsen we de tabel in autovacuum.
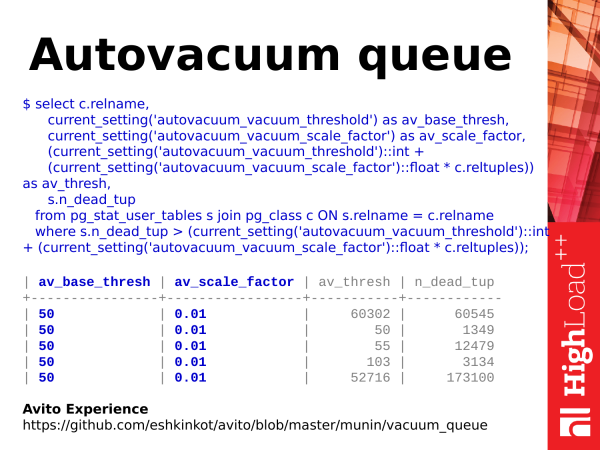
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
Maar hier is één punt. De basisdrempels van de parameters av_base_thresh en av_scale_factor kunnen individueel worden toegewezen. En, dus, de drempel zal niet globaal zijn, maar individueel voor de tabel. Daarom is het nodig om trucs en slimheid te gebruiken om dit te berekenen. En als je geïnteresseerd bent, kun je de ervaring van onze collega's van Avito bekijken (de link op de dia is ongeldig en is in de tekst bijgewerkt).
Ze schreven voor , die rekening houdt met deze zaken. Het is een document van twee pagina's. Maar het berekent correct en stelt behoorlijk efficiënt in staat om te beoordelen waar we veel vacuüm nodig hebben voor tabellen en waar weinig.
Wat kunnen we hiermee doen? Als we een grote wachtrij hebben en de autovacuüm niet genoeg is, kunnen we het aantal vacuümwerkers verhogen, of we kunnen gewoon de vacuüm agressiever maken, zodat deze eerder wordt geactiveerd en de tabel in kleine stukken verwerkt. En daardoor zal de wachtrij afnemen. — Het belangrijkste hier is om de belasting op de schijven in de gaten te houden, aangezien vacuüm niet gratis is, hoewel dankzij de introductie van SSD/NVMe-apparaten het probleem minder opvalt.
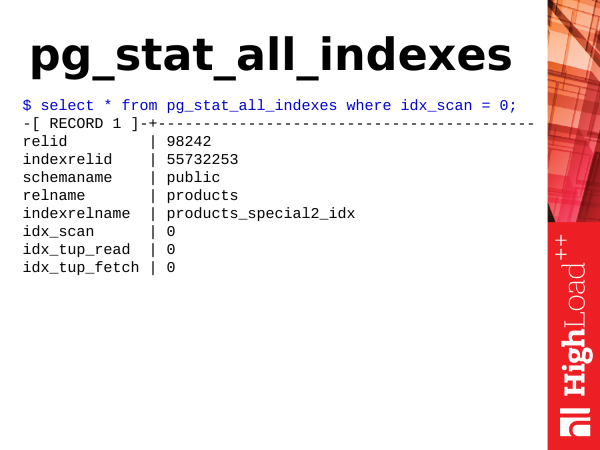
Pg_stat_all_indexes – dit is de statistiek van de indexen. Het is klein. En we kunnen het gebruiken om informatie over het gebruik van indexen te verkrijgen. En bijvoorbeeld kunnen we bepalen welke indexen overbodig zijn.
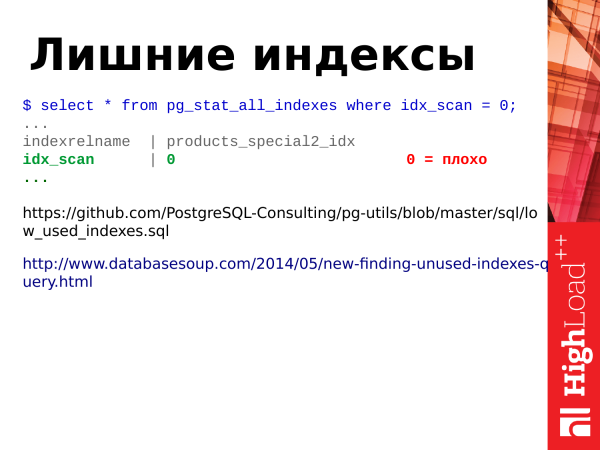
Zoals ik al zei, update – dit is niet alleen het bijwerken van tabellen, maar ook het bijwerken van indexen. Dus, als we veel indexen op de tabel hebben, moet bij het bijwerken van rijen in de tabel ook de index van geïndexeerde velden worden bijgewerkt, en als we ongebruikte indexen hebben, waarvoor geen indexscans zijn, blijven ze als ballast hangen. En we moeten ons ervan ontdoen. Om dit te doen, hebben we het veld idx_scan. We kijken gewoon naar het aantal indexscans. Als indexen nul scans hebben over een relatief lange periode van statistische opslag (minimaal 2-3 weken), is de kans groot dat dit slechte indexen zijn, en moeten we ons ervan ontdoen.
Opmerking: Bij het zoeken naar ongebruikte indexen in geval van clusters voor streaming replicatie, moet je alle knooppunten van de cluster controleren, omdat de statistiek niet globaal is, en als een index niet op de master wordt gebruikt, kan deze op de replicas worden gebruikt (als daar belasting is).
Twee links:
Dit zijn meer geavanceerde voorbeelden van queries voor het zoeken naar ongebruikte indexen.
De tweede link is een vrij interessante aanvraag. Daarin is een zeer niet-triviale logica ingebouwd. Ik raad het aan voor een nadere kennismaking.
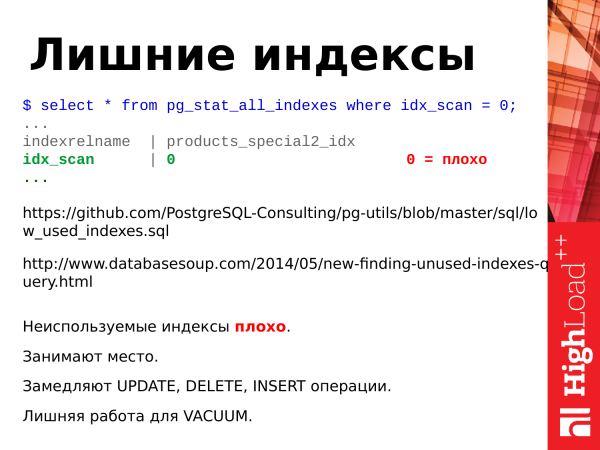
Wat moeten we nog meer samenvatten over indexen?
Ongebruikte indexen zijn slecht.
Ze nemen ruimte in.
Ze vertragen de update-operaties.
Het is extra werk voor de vacuum.
Als we de ongebruikte indexen verwijderen, verbeteren we alleen de database.
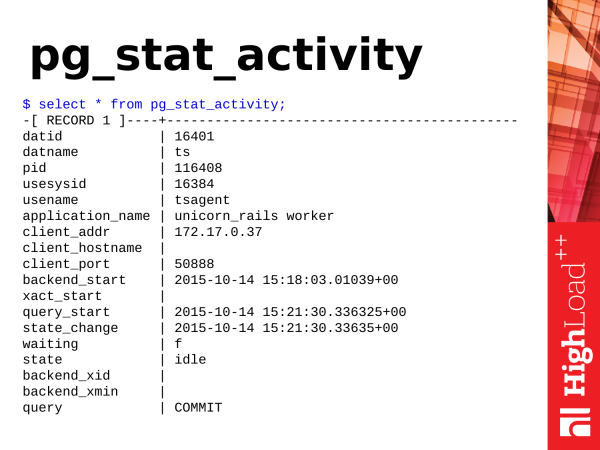
De volgende weergave is pg_stat_activity. Dit is een analoog van de tool ps, maar dan voor PostgreSQL. Als psje de processen in het besturingssysteem bekijkt, dan pg_stat_activity toont het de activiteit binnen PostgreSQL.
Wat kunnen we daar nuttigs uit halen?
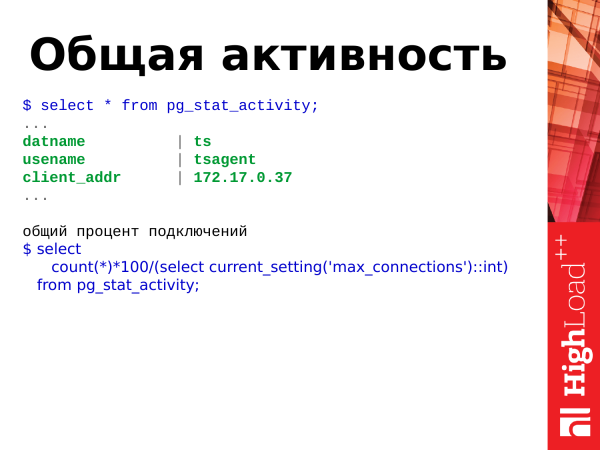
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
We kunnen de totale activiteit bekijken, wat er in de database gebeurt. We kunnen een nieuwe deployment doen. Alles is daar in de lucht gevlogen, nieuwe verbindingen worden niet geaccepteeerd, fouten verschijnen in de applicatie.
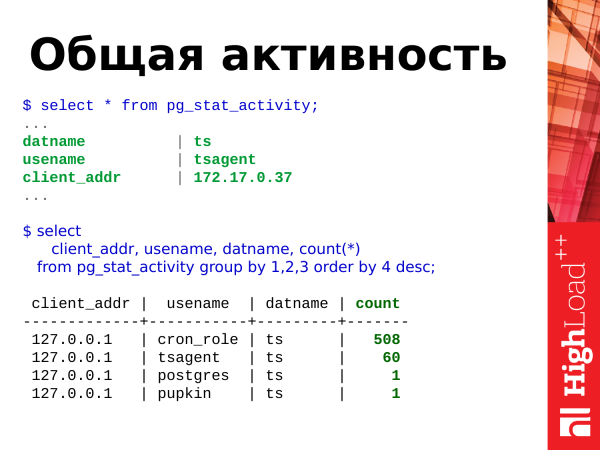
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
We kunnen zo'n query uitvoeren en het totale percentage verbindingen ten opzichte van de maximale verbindingen bekijken en zien wie de meeste verbindingen gebruikt. In dit geval zien we dat de gebruiker cron_role 508 verbindingen heeft geopend. En er is iets met hem aan de hand. We moeten daar achteraan gaan en kijken. Het is heel goed mogelijk dat dit een abnormaal aantal verbindingen is.
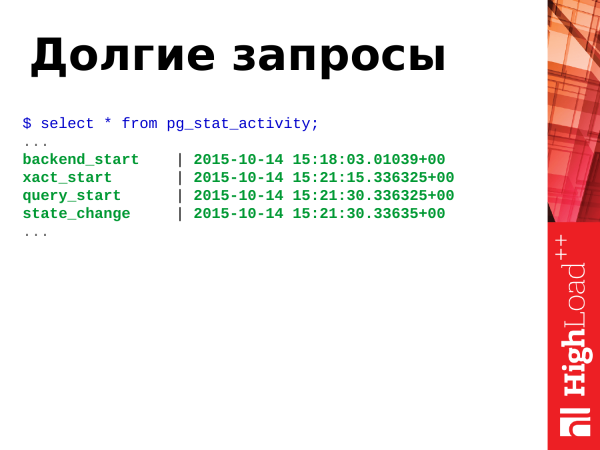
Als we OLTP-belasting hebben, moeten de queries snel, heel snel worden uitgevoerd en er mogen geen lange queries zijn. Maar als er lange queries optreden, is dat op de korte termijn niet zo'n probleem, maar op de lange termijn schaden lange queries de database; ze vergroten het bloat-effect van tabellen wanneer er fragmentatie van tabellen optreedt. We moeten zowel van bloat als van lange queries af.
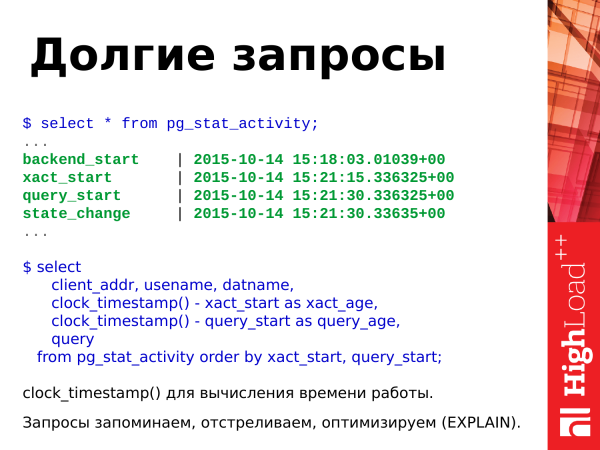
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Let op: met deze query kunnen we lange queries en transacties identificeren. We gebruiken de functie clock_timestamp() om de tijdsduur te bepalen. De lange queries die we hebben gevonden, kunnen we onthouden, uitvoeren explain, de plannen bekijken en op de een of andere manier optimaliseren. We beëindigen de huidige lange queries en gaan verder.
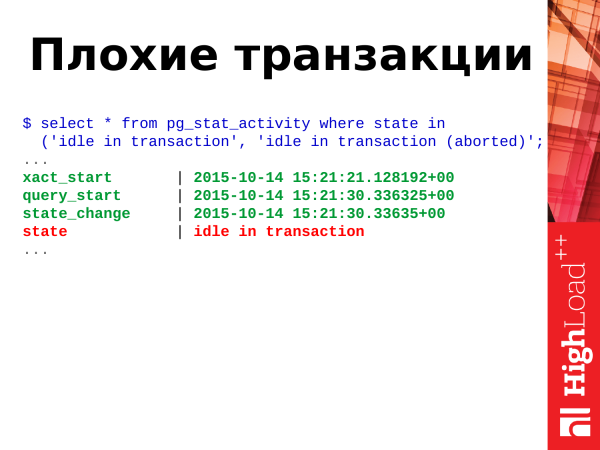
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Slechte transacties zijn transacties in de toestand idle in transaction en idle in transaction (aborted).
Wat betekent dit? Transacties hebben verschillende staten. En een van deze staten kan op elk moment worden aangenomen. Voor de bepaling van de staten is er een veld state in deze weergave. En we gebruiken het om de status te bepalen.
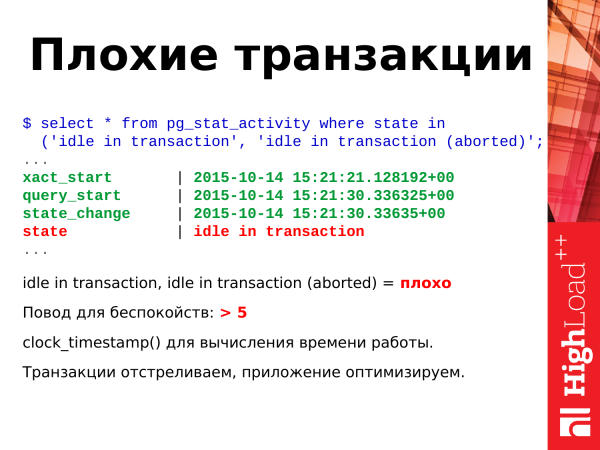
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
En, zoals ik hierboven al zei, zijn deze twee staten idle in transaction en idle in transaction (aborted) - dat is slecht. Wat is dat? Dit is wanneer de applicatie een transactie heeft geopend, bepaalde acties heeft uitgevoerd en verder is gegaan met zijn dingen. De transactie blijft open. Deze hangt, er gebeurt niets, het neemt verbinding in beslag, blokkeert gewijzigde rijen en vergroot potentieel nog de bloat van andere tabellen, vanwege de architectuur van de transactionele engine van Postgres. En dergelijke transacties moeten ook worden beëindigd, omdat ze schadelijk zijn, ongeacht de omstandigheid.
Als je ziet dat er meer dan 5-10-20 van zijn in je database, moet je je al zorgen gaan maken en iets gaan doen.
Hier gebruiken we ook voor de rekentijd clock_timestamp(). We beëindigen transacties, we optimaliseren de applicatie.
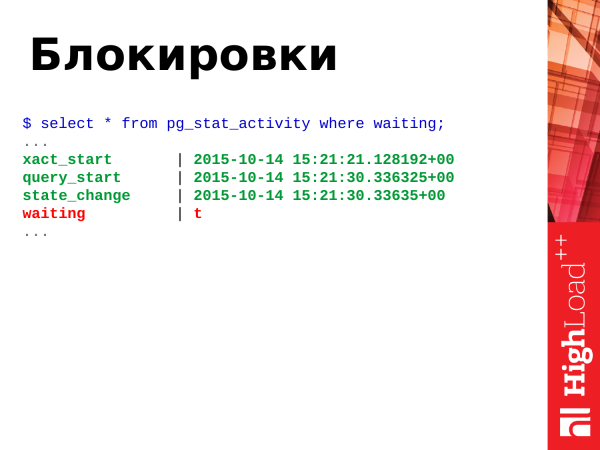
Zoals ik hierboven al zei, blokkades zijn wanneer twee of meer transacties strijden om één of een groep van middelen. Hiervoor hebben we een veld waiting met een booleaanse waarde true of false.
True - dat betekent dat het proces in afwachting is, er moet iets gedaan worden. Wanneer een proces in afwachting is, betekent dit dat de klant die dit proces heeft geïnitieerd ook wacht. De klant in de browser zit te wachten.
Let op: _Vanaf versie Postgres 9.6 is het veld waiting verwijderd en zijn er in plaats daarvan twee meer informatieve velden toegevoegd wait_event_type en wait_event._
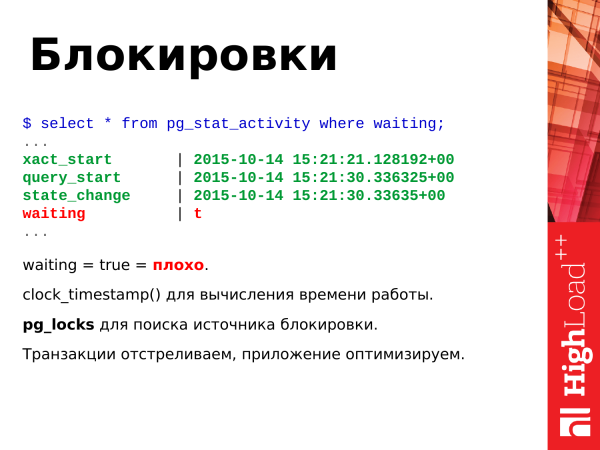
Wat te doen? Als je true ziet voor een lange tijd, dan betekent dat dat je van dergelijke verzoeken af moet komen. We beëindigen gewoon zulke transacties. We schrijven naar de ontwikkelaars dat ze iets moeten optimaliseren zodat er geen race om middelen is. En vervolgens optimaliseren de ontwikkelaars de applicatie zodat dit niet gebeurt.
En het laatste, maar potentiëel niet fatale geval - is het ontstaan van deadlocks. Twee transacties hebben twee bronnen bijgewerkt, en vervolgens proberen ze opnieuw toegang te krijgen, maar dan tot de tegenovergestelde bronnen. PostgreSQL beëindigt in dit geval zelf de transactie zodat de andere verder kan gaan met werken. Dit is een vastgelopen situatie en deze lost zichzelf niet op. Daarom is PostgreSQL gedwongen om uiterste maatregelen te nemen.
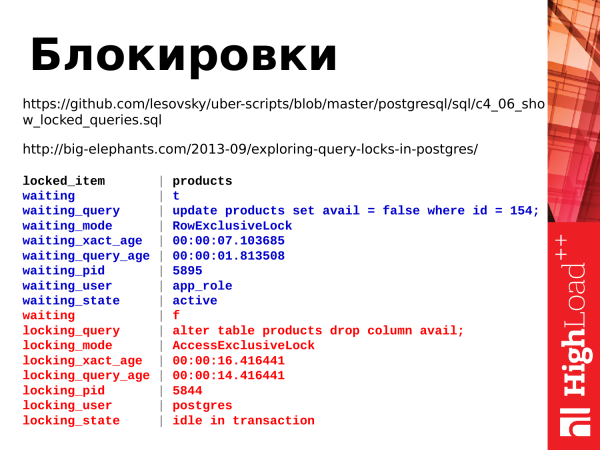
En hier zijn twee verzoeken die blokkades kunnen volgen. We gebruiken de weergave pg_locks, dat het mogelijk maakt om zware blokkeringen te volgen.
En de eerste link is de tekst van de aanvraag zelf. Deze is vrij lang.
En de tweede link is een artikel over locks. Het is nuttig om te lezen, en het is erg interessant.
Dus, wat zien we? We zien twee aanvragen. De transactie met ALTER TABLE is een blokkeringstransactie. Deze is gestart, maar niet voltooid en de applicatie die deze transactie heeft gestart is ergens anders mee bezig. En de tweede aanvraag is update. Deze wacht totdat alter table is voltooid om zijn werk voort te zetten.
Zo kunnen we achterhalen wie wie heeft geblokkeerd en kunnen we verder met deze kwestie omgaan.
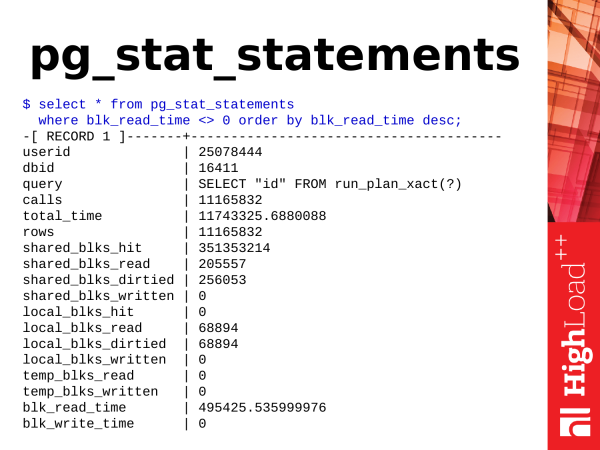
De volgende module is pg_stat_statements. Zoals ik al zei, dit is een module. Om deze te gebruiken, moet je de bibliotheek in de configuratie laden, PostgreSQL opnieuw opstarten, de module installeren (met één opdracht) en dan hebben we een nieuwe weergave.
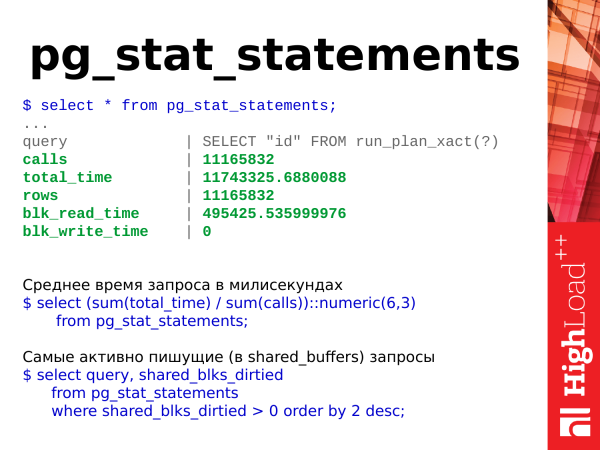
Gemiddelde querytijd in milliseconden
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

De meest actieve schrijfverzoeken (in shared_buffers)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
Wat kunnen we daaruit halen? Als we het over eenvoudige zaken hebben, kunnen we de gemiddelde uitvoeringstijd van de aanvraag nemen. Als de tijd toeneemt, betekent dit dat PostgreSQL langzaam reageert en dat we iets moeten ondernemen.
We kunnen de meest actieve schrijftransacties in de database bekijken, die gegevens in shared buffers veranderen. Kijken wie er gegevens bijwerkt of verwijdert.
En we kunnen gewoon verschillende statistieken over deze aanvragen bekijken.
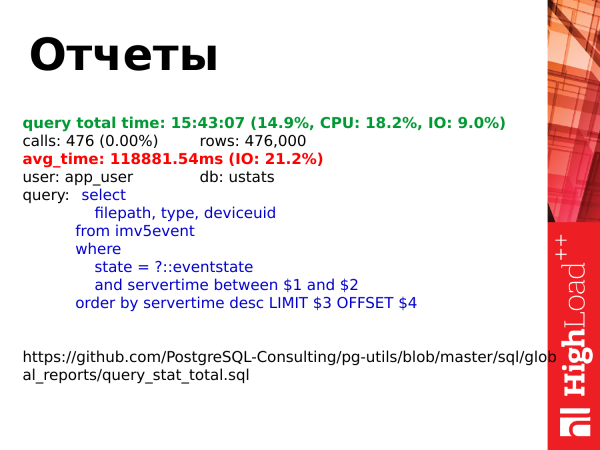
Wij pg_stat_statements gebruiken om rapporten te genereren. We resetten de statistieken eenmaal per dag. We verzamelen deze. Voor de volgende reset van de statistieken maken we een rapport. Hier is de link naar het rapport. Je kunt het bekijken.
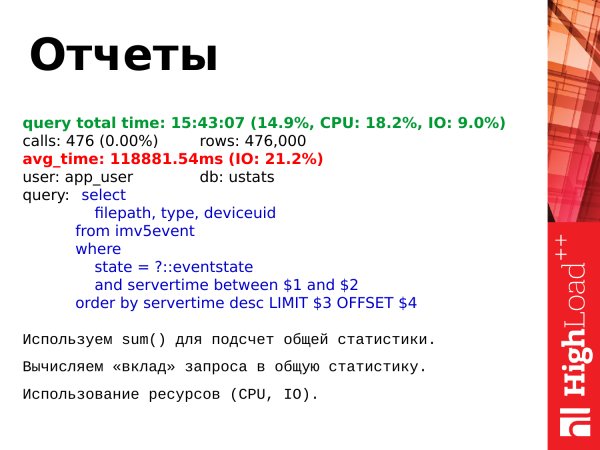
Wat doen we? We tellen de totale statistieken van alle aanvragen. Vervolgens berekenen we voor elke aanvraag zijn individuele bijdrage aan deze totale statistieken.
En wat kunnen we bekijken? We kunnen de totale uitvoeringstijd van alle aanvragen van een specifiek type in vergelijking met alle andere aanvragen bekijken. We kunnen het gebruik van CPU- en I/O-resources in relatie tot het hele plaatje bekijken. En vervolgens deze aanvragen optimaliseren. We bouwen top aanvragen op basis van dit rapport en krijgen zo stof tot nadenken over wat we kunnen optimaliseren.
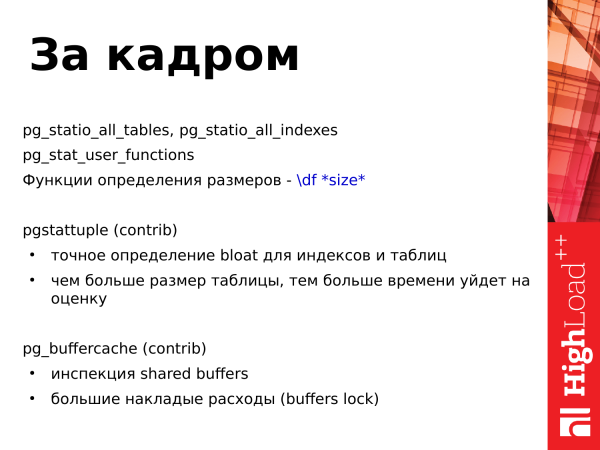
Wat hebben we achter de schermen achtergelaten? Er zijn nog enkele presentaties over die ik niet heb besproken omdat de tijd beperkt is.
Er is pgstattuple – dit is ook een extra module uit het standaard instellingpakket. Het maakt evaluatie mogelijk. bloat tabellen, de zogenaamde fragmentatie van tabellen. En als de fragmentatie groot is, moet je deze verwijderen, gebruik verschillende tools. En de functie pgstattuple werkt langzaam. En hoe meer tabellen er zijn, hoe langer het zal duren.
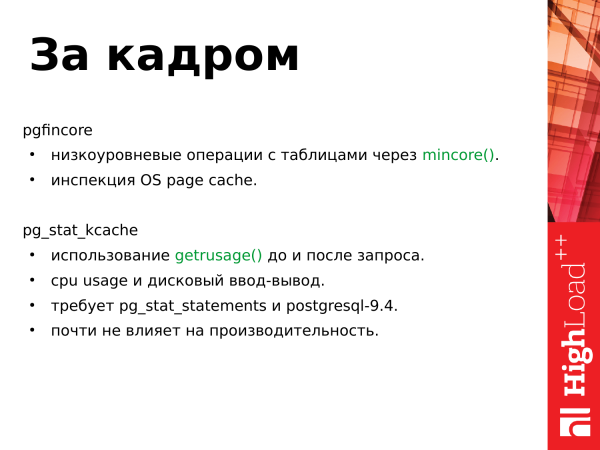
De volgende contrib is pg_buffercache. Hiermee kun je shared buffers inspecteren: hoe intensief en voor welke tabellen de bufferpagina's worden gebruikt. En het laat je gewoon in de shared buffers kijken en beoordelen wat daar gebeurt.
De volgende module is pgfincore. Hiermee kun je low-level operaties met tabellen uitvoeren via de systeemaanroep mincore(), dat wil zeggen, het laat je een tabel in de shared buffers laden of deze eruit halen. En het maakt het ook mogelijk om de paginacache van het besturingssysteem te inspecteren, dat wil zeggen, in welke mate onze tabel in de page cache, in shared buffers zit en het laat gewoon de belasting van de tabel beoordelen.
De volgende module is pg_stat_kcache. Het gebruikt ook de systeemaanroep getrusage(). En voert deze uit voor en na het uitvoeren van de aanvraag. En in de verkregen statistieken kan je beoordelen hoeveel onze aanvraag heeft gekost voor het uitvoeren van schijfinvoer- en uitvoeroperaties, dat wil zeggen operaties met het bestandssysteem en kijkt naar CPU-gebruik. Echter, de module is jong (ahem) en voor zijn werking vereist hij PostgreSQL 9.4 en pg_stat_statements, waarover ik eerder sprak.
De vaardigheid om statistieken te gebruiken is nuttig. Je hebt geen externe programma's nodig. Je kunt zelf kijken, bekijken, iets doen, uitvoeren.
Statistieken gebruiken is niet moeilijk, het is gewone SQL. Je hebt een aanvraag samengesteld, deze verzonden, bekeken.
Statistieken helpen om vragen te beantwoorden. Als je vragen hebt, ga je naar de statistieken – kijk, trek conclusies, analyseer de resultaten.
En experimenteer. Er zijn veel aanvragen, veel gegevens. Je kunt altijd een bestaande aanvraag optimaliseren. Je kunt je eigen versie van de aanvraag maken, die beter bij je past dan het origineel en hem gebruiken.
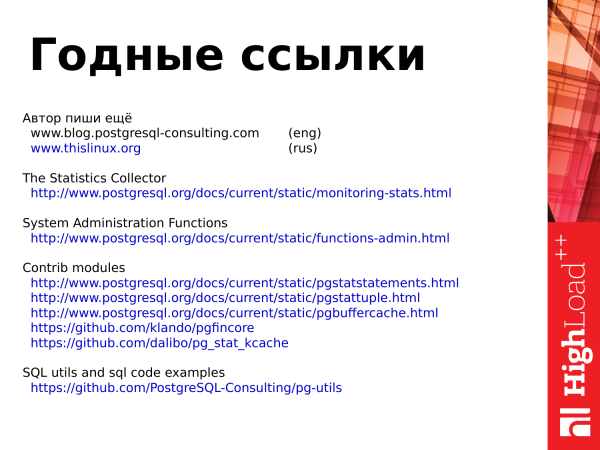
Links
Goede links die in het artikel werden genoemd, waarover in de rapportage werd gesproken.
De auteur schrijft verder
(eng)
De Statistiekverzamelaar
Systeembeheersfuncties
Contrib-modules
SQL-tools en sql-codevoorbeelden
Iedereen bedankt voor uw aandacht!
Bron: habr.com
