

In de aanloop naar de lancering van een nieuwe stroom voor de cursus hebben we een vertaling van interessant materiaal voorbereid.
Overzicht
We zullen een vrij populair patroon bespreken waarmee applicaties meerdere databases gebruiken, waarbij elke database voor zijn eigen doeleinden wordt ingezet, bijvoorbeeld voor het opslaan van de canonieke datavorm (MySQL, enz.), het bieden van uitgebreide zoekmogelijkheden (ElasticSearch, enz.), caching (Memcached, enz.) en andere. Meestal functioneert bij het gebruik van meerdere databases één als de primaire database, terwijl de andere als secundaire databases werken. Het enige probleem is hoe je deze databases kunt synchroniseren.
We hebben verschillende patronen bekeken die geprobeerd hebben het probleem van het synchroniseren van meerdere databases op te lossen, zoals double write, gedistribueerde transacties, enz. Echter, deze benaderingen hebben aanzienlijke beperkingen qua bruikbaarheid in de praktijk, betrouwbaarheid en onderhoud. Naast de synchronisatie van gegevens hebben sommige applicaties ook behoefte aan het verrijken van gegevens door externe services aan te roepen.
Om deze problemen op te lossen, is Delta ontwikkeld. Delta is uiteindelijk een consistente, op evenementen gestuurde platform voor het synchroniseren en verrijken van gegevens.
Bestaande oplossingen
Double write
Om twee databases te synchroniseren, kan double write worden gebruikt, dat een record in de ene database schrijft en vervolgens onmiddellijk daarna een record in de andere database schrijft. De eerste schrijven kan worden herhaald, en de tweede kan worden afgebroken als de eerste mislukt na een aantal pogingen. Echter, twee databases kunnen uit sync raken als de schrijven naar de tweede database mislukt. Dit probleem wordt doorgaans opgelost door een herstelprocedure te creëren die periodiek gegevens van de eerste database naar de tweede kan terugzetten, of dit alleen kan doen als er ongelijkheden in de gegevens worden gevonden.
Problemen:
Het uitvoeren van het herstelproces is een specifieke taak die niet herbruikbaar is. Bovendien blijven de gegevens tussen de opslagplaatsen desynchroniseerd totdat het herstelproces is voltooid. De situatie wordt gecompliceerd als er meer dan twee gegevensopslagplaatsen worden gebruikt. Ten slotte kan het herstelproces de belasting op de oorspronkelijke gegevensbron verhogen.
Wijzigingslogboek
Wanneer er wijzigingen in het tabelset plaatsvinden (bijvoorbeeld het invoegen, bijwerken of verwijderen van een record), worden de wijzigingsrecords toegevoegd aan het logboek als onderdeel van dezelfde transactie. Een andere thread of proces vraagt voortdurend naar gebeurtenissen uit het logboek en schrijft deze naar een of meerdere gegevensopslagplaatsen, waarbij het, indien nodig, gebeurtenissen uit het logboek verwijdert nadat de registratie door alle opslagplaatsen is bevestigd.
Problemen:
Dit patroon moet worden geïmplementeerd als een bibliotheek en idealiter zonder de code van de toepassing die deze gebruikt te wijzigen. In een polyglot-omgeving moet zo'n bibliotheek bestaan in elke benodigde taal, maar het waarborgen van consistente functionaliteit en gedrag tussen talen is zeer uitdagend.
Een ander probleem is het verkrijgen van schemawijzigingen in systemen die geen transactionele schemawijzigingen ondersteunen [1][2], zoals MySQL. Daarom zal het sjabloon voor het uitvoeren van wijzigingen (bijvoorbeeld schemawijzigingen) en het transactioneel opnemen ervan in het wijzigingslogboek niet altijd werken.
Distributed Transactions
Distributed transactions kunnen worden gebruikt om een transactie te splitsen tussen meerdere heterogene gegevensopslagplaatsen, zodat de operatie ofwel in alle gebruikte opslagplaatsen wordt vastgelegd, ofwel in geen van hen wordt vastgelegd.
Problemen:
Gedistribueerde transacties zijn een groot probleem voor heterogene dataopslag. Van nature kunnen ze alleen vertrouwen op de kleinste gemene deler van de betrokken systemen. Bijvoorbeeld, XA-transacties blokkeren de uitvoering als er in het toepassingsproces een storing optreedt tijdens de voorbereidingsfase. Bovendien biedt XA geen detectie van deadlocks en ondersteunt het geen optimistische schema's voor parallelle verwerking. Daarnaast ondersteunen sommige systemen zoals ElasticSearch geen XA of enige andere heterogene transactiemodel. Zo blijft het waarborgen van de atomiciteit van schrijven in verschillende dataopslagtechnologieën een aanzienlijke uitdaging voor toepassingen [3].
Delta
Delta is ontwikkeld om de beperkingen van bestaande oplossingen voor datasynchronisatie te verhelpen; het maakt ook real-time data-enriching mogelijk. Ons doel was om al deze complexe zaken te abstraheren van applicatieontwikkelaars, zodat ze zich volledig kunnen concentreren op de implementatie van zakelijke functionaliteit. Vervolgens zullen we ‘Movie Search’ beschrijven, de feitelijke use case van Delta bij Netflix.
Netflix past op grote schaal microservice-architectuur toe en elke microservice bedient doorgaans één type data. Basisinformatie over films is ondergebracht in een microservice die Movie Service wordt genoemd, terwijl gerelateerde gegevens zoals informatie over producenten, acteurs, leveranciers, enzovoort, door verschillende andere microservices worden beheerd (namelijk Deal Service, Talent Service en Vendor Service).
Businessgebruikers in Netflix Studios hebben vaak behoefte aan het zoeken naar films op verschillende criteria, daarom is het voor hen van groot belang om te kunnen zoeken door alle gegevens die met films zijn gerelateerd.
Voor de komst van Delta moest het team dat films zocht gegevens uit verschillende microservices verkrijgen voordat ze de filmgegevens konden indexeren. Bovendien moest het team een systeem ontwikkelen dat periodiek de zoekindex bijwerkte door wijzigingen op te vragen bij andere microservices, zelfs als er helemaal geen wijzigingen waren. Dit systeem groeide al snel complex en werd moeilijk te onderhouden.
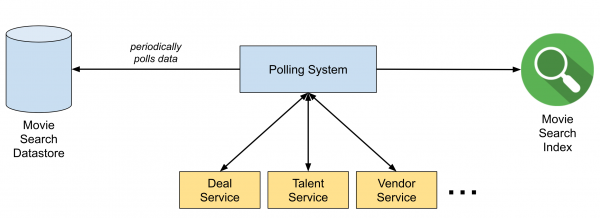
Figuur 1. Het polling systeem vóór Delta
Na de start van het gebruik van Delta is het systeem vereenvoudigd tot een op gebeurtenissen gebaseerd systeem, zoals weergegeven in de volgende afbeelding. CDC (Change-Data-Capture) gebeurtenissen worden via de Delta-Connector naar de Keystone Kafka topics gestuurd. De Delta-applicatie, gebouwd met behulp van het Delta Stream Processing Framework (gebaseerd op Flink), ontvangt CDC-evenementen uit de topic, verrijkt ze door andere microservices aan te roepen en stuurt uiteindelijk de verrijkte gegevens naar de zoekindex in Elasticsearch. Het hele proces verloopt bijna in real-time, dat wil zeggen, zodra wijzigingen worden vastgelegd in de dataopslag, worden de zoekindexen bijgewerkt.
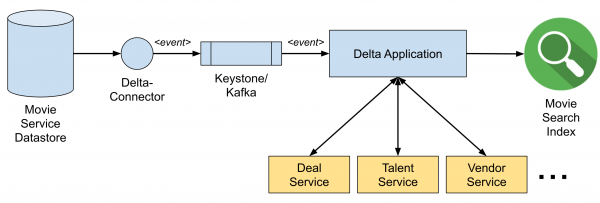
Afbeelding 2. Datapijplijn bij het gebruik van Delta
In de volgende secties zullen we het Delta-Connector beschrijven, dat verbinding maakt met de opslag en CDC-evenementen publiceert op het transportniveau, dat de infrastructuur voor dataoverdracht in real-time is, die CDC-evenementen naar Kafka topics leidt. En aan het einde zullen we het structuur van de Delta-streamverwerking bespreken, die ontwikkelaars kunnen gebruiken voor de verwerkingslogica en gegevensverrijking.
CDC (Change-Data-Capture)
We hebben een CDC-service ontwikkeld met de naam Delta-Connector, die gecommitteerde wijzigingen uit de dataopslag in real-time kan vastleggen en ze naar een stream kan schrijven. Wijzigingen in real-time worden uit het transactielogboek en de opslagdump gehaald. Dumps worden gebruikt omdat transactielogboeken meestal niet de volledige geschiedenis van wijzigingen opslaan. Wijzigingen worden meestal als Delta-evenementen geserialiseerd, zodat de ontvanger zich geen zorgen hoeft te maken over de oorsprong van de wijziging.
Delta-Connector ondersteunt verschillende extra functies, zoals:
- De mogelijkheid om naar aangepaste uitvoerdata te schrijven buiten Kafka.
- De mogelijkheid om handmatige dumps op elk moment te activeren voor alle tabellen, een bepaalde tabel of voor specifieke primaire sleutels.
- Dumps kunnen in chunks worden opgehaald, zodat het niet nodig is om opnieuw te beginnen in geval van een storing.
- Er is geen noodzaak om tabellen te vergrendelen, wat erg belangrijk is om ervoor te zorgen dat de schrijfverkeer naar de database nooit door onze service wordt geblokkeerd.
- Hoge beschikbaarheid dankzij reserve-instanties in AWS Availability Zones.
Momenteel ondersteunen we MySQL en Postgres, ook bij het implementeren in AWS RDS en Aurora. We ondersteunen ook Cassandra (multi-master). Meer details over de Delta-Connector kunt u vinden in deze .
Kafka en de transportlaag
De transportlaag van Delta-evenementen is gebouwd op de berichtenservice van het platform .
Historisch gezien is de publicatie van berichten in Netflix geoptimaliseerd voor verhoogde beschikbaarheid, in plaats van duurzaamheid (zie ). De compromis was een potentieel dataconflict in verschillende randscenario's. Bijvoorbeeld, unclean leader election is verantwoordelijk voor het feit dat de ontvanger eventueel gebeurtenissen dupliceert of verliest.
Met Delta wilden we sterkere garanties voor duurzaamheid verkrijgen om de levering van CDC-gebeurtenissen naar afgeleide opslagplaatsen te waarborgen. Hiervoor hebben we een speciaal ontworpen Kafka-cluster voorgesteld als een first-class object. U kunt enkele brokerinstellingen in de onderstaande tabel bekijken:
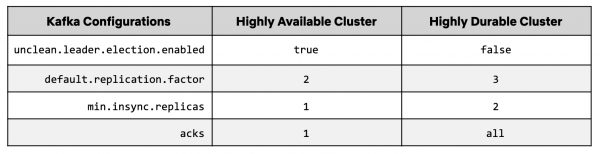
In Keystone Kafka-clusters, unclean leader election is meestal ingeschakeld om de beschikbaarheid van de uitgever te waarborgen. Dit kan leiden tot verlies van berichten als een niet-synchroniseerde replica als leider wordt gekozen. Voor een nieuwe hoogbetrouwbare Kafka-cluster is de parameter unclean leader election uitgeschakeld om verlies van berichten te voorkomen.
Daarnaast hebben we de replication factor verhoogd van 2 naar 3 en minimum insync replicas verhoogd van 1 naar 2. Uitgevers die naar deze cluster schrijven, vereisen acks van alle andere, waardoor wordt gegarandeerd dat 2 van de 3 replica's de meest actuele berichten van de uitgever hebben.
Wanneer een broker-instantie stopt, vervangt een nieuwe instantie de oude. De nieuwe broker moet echter de niet-gesynchroniseerde replica's inhalen, wat enkele uren kan duren. Om de hersteltijd van dit scenario te verkorten, zijn we begonnen met het gebruik van blokgegevensopslag (Amazon Elastic Block Store) in plaats van lokale schijven van de brokers. Wanneer een nieuwe instantie de beëindigde broker-instantie vervangt, sluit deze zich aan bij de EBS-volume die bij de beëindigde instantie hoorde en begint nieuwe berichten in te halen. Dit proces verkort de tijd om achterstanden weg te werken van enkele uren naar enkele minuten, omdat de nieuwe instantie niet langer vanaf een lege staat hoeft te repliceren. Over het algemeen verminderen afzonderlijke levenscycli van opslag en broker aanzienlijk de impact van de verandering van broker.
Om de garanties voor gegevenslevering verder te vergroten, hebben we gebruik gemaakt van om eventuele verlies van berichten in extreme omstandigheden (bijvoorbeeld tijdsynchronisatieproblemen bij de sectieleider) te detecteren.
Stream Processing Framework
Het verwerkingsniveau in Delta is gebaseerd op het Netflix SPaaS-platform, dat de integratie van Apache Flink met het Netflix-ecosysteem mogelijk maakt. Het platform biedt een gebruikersinterface die de implementatie van Flink-taken en de orkestratie van Flink-clusters bovenop ons containerbeheersysteem Titus beheert. De interface beheert ook de configuraties van taken en stelt gebruikers in staat om configuraties dynamisch aan te passen zonder dat ze de Flink-taken opnieuw moeten compileren.
Delta biedt een framework voor gegevensstreaming (stream processing framework) op basis van Flink en SPaaS, dat gebruik maakt van annotatie-gebaseerde DSL (Domain Specific Language) om technische details te abstraheren. Bijvoorbeeld, om de stap te definiëren waarmee gebeurtenissen worden verrijkt door externe diensten aan te roepen, moeten gebruikers de volgende DSL schrijven, en het framework genereert op basis daarvan een model dat door Flink zal worden uitgevoerd.
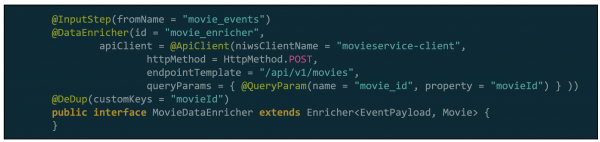
Figuur 3. Voorbeeld van verrijking op DSL in Delta
Het framework voor verwerking verkort niet alleen de leercurve, maar biedt ook algemene functionaliteiten voor stream processing, zoals deduplicatie, schematisering, evenals flexibiliteit en fouttolerantie om veelvoorkomende problemen in de werking op te lossen.
Delta Stream Processing Framework bestaat uit twee belangrijke modules: de DSL & API-module en de Runtime-module. De DSL & API-module biedt een DSL en UDF (User-Defined Function) API, zodat gebruikers hun eigen verwerkingslogica kunnen schrijven (bijvoorbeeld filtering of transformaties). De Runtime-module biedt een implementatie van de DSL-parser, die een interne weergave van verwerkingsstappen in DAG-modellen opbouwt. De Execution-component interpreteert de DAG-modellen om de daadwerkelijke Flink-operators te initialiseren en uiteindelijk de Flink-toepassing te starten. De architectuur van het framework is geïllustreerd in de volgende afbeelding.
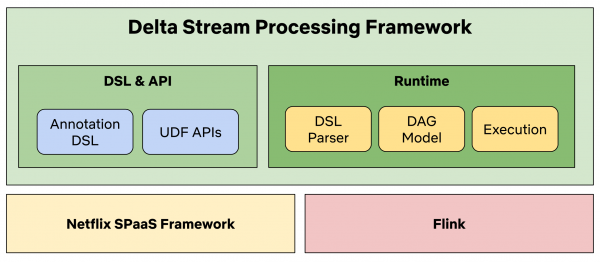
Afbeelding 4. Architectuur van het Delta Stream Processing Framework
Deze aanpak heeft verschillende voordelen:
- Gebruikers kunnen zich concentreren op hun bedrijfslogica zonder zich te hoeven verdiepen in de specifics van Flink of de SPaaS-structuur.
- Optimalisatie kan op een gebruiksvriendelijke manier plaatsvinden, en fouten kunnen worden hersteld zonder dat wijzigingen in de gebruikerscode (UDF) nodig zijn.
- Het gebruik van Delta-applicaties is vereenvoudigd voor gebruikers, aangezien het platform out-of-the-box flexibiliteit en veerkracht biedt, evenals gedetailleerde metrics die kunnen worden gebruikt voor meldingen.
Gebruik in productie
Delta is al meer dan een jaar in productie en speelt een sleutelrol in veel toepassingen van Netflix Studio. Het heeft teams geholpen bij het realiseren van gebruiksmogelijkheden zoals zoekindexering, gegevensopslag en evenementgestuurde workflows. Hieronder volgt een overzicht van de high-level architectuur van het Delta-platform.
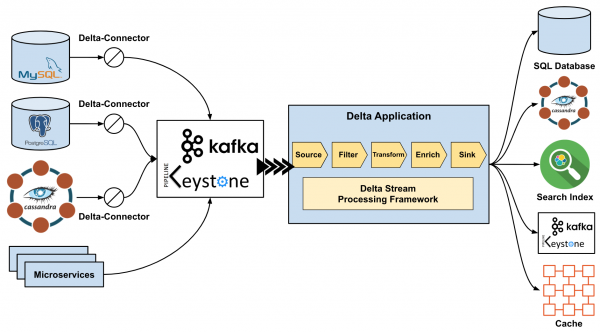
Afbeelding 5. High-level architectuur van Delta.
Waardering
We willen de volgende mensen bedanken die hebben bijgedragen aan de ontwikkeling en evolutie van Delta bij Netflix: Allen Wang, Charles Zhao, Jaebin Yoon, Josh Snyder, Kasturi Chatterjee, Mark Cho, Olof Johansson, Piyush Goyal, Prashanth Ramdas, Raghuram Onti Srinivasan, Sandeep Gupta, Steven Wu, Tharanga Gamaethige, Yun Wang en Zhenzhong Xu.
Bronnen
- Martin Kleppmann, Alastair R. Beresford, Boerge Svingen: Online event processing. Commun. ACM 62(5): 43–49 (2019). DOI:
: "Data Build Tool voor Amazon Redshift Data Warehouse."
Bron: habr.com
