

Hallo allemaal! In het kader van mijn afstudeerproject heb ik onderzoek gedaan naar de mogelijkheden van een inheemse cloudplatform zoals . Het platform biedt verschillende diensten aan voor het oplossen van praktische vraagstukken. Soms is het echter nodig om op basis van deze diensten een eigen cloudapplicatie in te richten met een vrij uitgebreide infrastructuur. In dit artikel wil ik mijn ervaring delen met het implementeren van zo'n applicatie.
Wat wil je bereiken?
— een krachtig hulpmiddel voor het oplossen van analytische vraagstukken of het monitoren van bepaalde systemen. In de basisconfiguratie is dit een virtuele machine met een Grafana-webserver, en ook een database (ClickHouse, InfluxDB, etc.) met een dataset waarop de analyses zullen worden gebaseerd.
Na het opstarten van de virtuele machine met de webserver kan je de host ervan openen en een mooie UI verkrijgen, de databases als bronnen voor verdere werkzaamheden opgeven, dashboards en grafieken creëren.
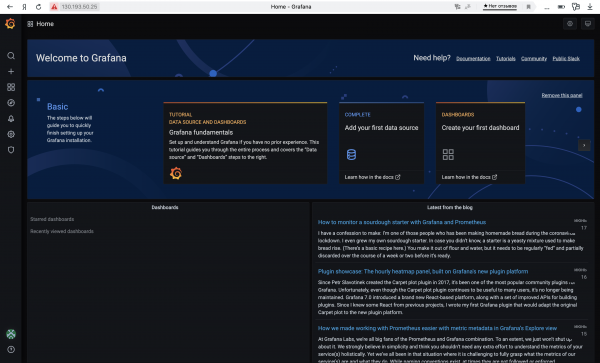
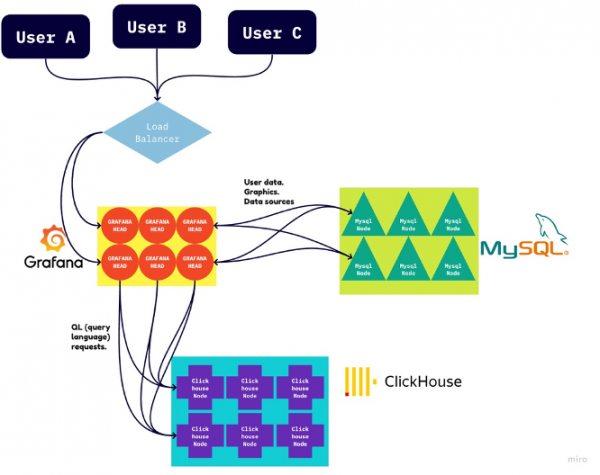
De basisversie heeft één aanzienlijk nadeel — deze is volledig niet-fouttolerant. Dat wil zeggen, de werking van de applicatie hangt af van de levensvatbaarheid van één virtuele machine. Als deze faalt of als 10 personen tegelijkertijd de UI openen, zullen er problemen optreden.
Deze problemen zijn eenvoudig op te lossen: je hoeft alleen maar... veel identieke virtuele machines met een webserver op te zetten en ze onder een L3-loadbalancer te plaatsen. Maar het is hier niet zo eenvoudig. Grafana slaat gebruikersinstellingen (paden naar databases, dashboards, grafieken, enz.) rechtstreeks op de schijf van zijn virtuele machine op. Dus als je bepaalde instellingen in de UI wijzigt, zullen deze wijzigingen slechts op die virtuele machine verschijnen waar de loadbalancer ons naartoe heeft gestuurd. Dit leidt tot inconsistente instellingen van onze applicatie, waardoor er problemen ontstaan bij het opstarten en gebruiken.
Hier komt een andere database, zoals MySQL of een soortgelijke, van pas. We zeggen tegen Grafana dat het de gebruikersinstellingen precies in deze 'reserve'-database moet opslaan. Daarna hoeft het slechts eenmaal op elke machine het pad naar deze DB aan te geven, en kunnen alle andere gebruikersinstellingen op elke van de virtuele machines worden bewerkt; ze zullen zich naar de andere machines verspreiden.
Hier is het schema van de uiteindelijke infrastructuur van de applicatie:
Laten we leren om het handmatig op te zetten
MySQL en ClickHouse
Voordat je zo'n applicatie met één klik kunt implementeren, moet je leren elk component handmatig op te zetten en ze met elkaar te integreren.
Hier helpt Yandex Cloud ons, dat L3-loadbalancers, ClickHouse en MySQL als managed services aanbiedt. De gebruiker hoeft alleen de parameters op te geven en te wachten tot het platform alles operationeel maakt.
Ik heb me geregistreerd, heb een cloud en betalingsaccount aangemaakt. Daarna ben ik naar de cloud gegaan en heb ik MySQL- en ClickHouse-clusters opgezet met minimale instellingen. Ik wachtte tot ze actief werden.
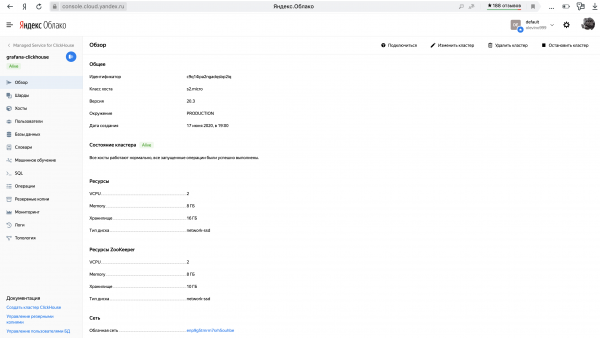
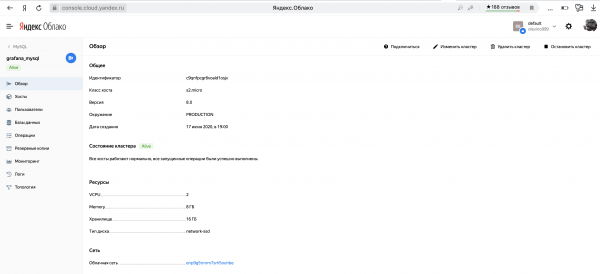
Vergeet niet om in elk cluster een database aan te maken en toegang te configureren met een gebruikersnaam en wachtwoord. Ik ga hier niet in op de details - in de interface is alles vrij duidelijk.
Een minder voor de hand liggende detail was dat deze databases meerdere hosts hebben die zorgen voor hun failover. Maar Grafana vereist precies één host voor elke database waarmee het werkt. Het langdurig lezen van de cloud leidde me naar de oplossing. Blijkbaar wordt een host van het type c-<cluster_id>.rw.mdb.yandexcloud.net gemapt naar de huidige actieve masterhost van het cluster met het bijbehorende ID. Dit is wat we aan Grafana zullen geven.
Webserver
Nu is het aan de webserver. Laten we een gewone virtuele machine met Linux opzetten en Grafana handmatig instellen.
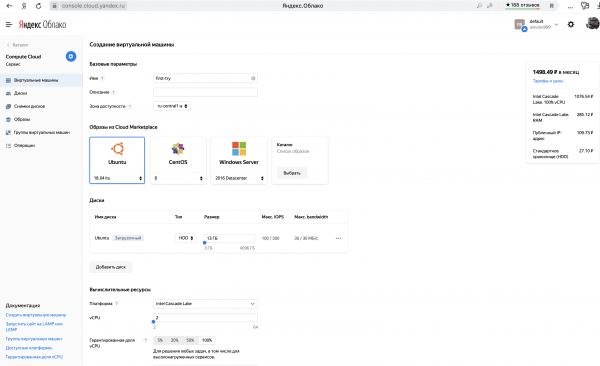
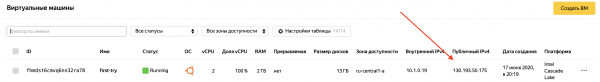
We maken verbinding via ssh en installeren de nodige pakketten.
sudo apt-get install -y apt-transport-https software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
Daarna starten we Grafana met systemctl en installeren we de plugin voor ClickHouse (ja, in de basisconfiguratie is deze niet inbegrepen).
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
Dat is het, met het eenvoudige commando
sudo service grafana-server startstarten we de webserver. Nu kun je het externe IP-adres van de virtuele machine in je browser invoeren, poort 3000 opgeven en een mooie UI van Grafana zien.
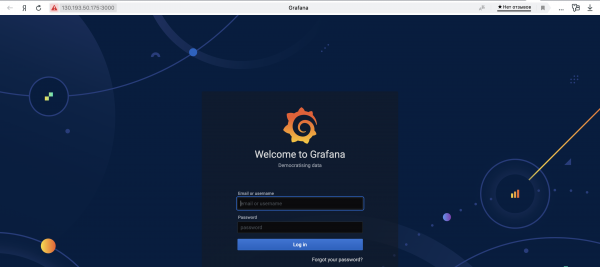
Maar haast je niet, voordat je Grafana instelt, vergeet niet om het pad naar MySQL op te geven, zodat het daar de instellingen kan opslaan.
De gehele configuratie van de webserver van Grafana bevindt zich in het bestand /etc/grafana/grafana.ini. De benodigde regel ziet er als volgt uit:
;url =We connect the host to the MySQL cluster. This file also contains the login and password for accessing Grafana in the image above, both of which are set to default values. admin.
You can use sed commands:
sudo sed -i "s#.*;url =.*#url = mysql://{MYSQL_USERNAME}:{MYSQL_PASSWORD}@{MYSQL_CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = {GRAFANA_USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = {GRAFANA_PASSWORD}#" /etc/grafana/grafana.ini
It's time to restart the web server!
sudo service grafana-server restartNow let's specify ClickHouse as the DataSource in the Grafana UI.
I managed to achieve a working configuration with the following settings:
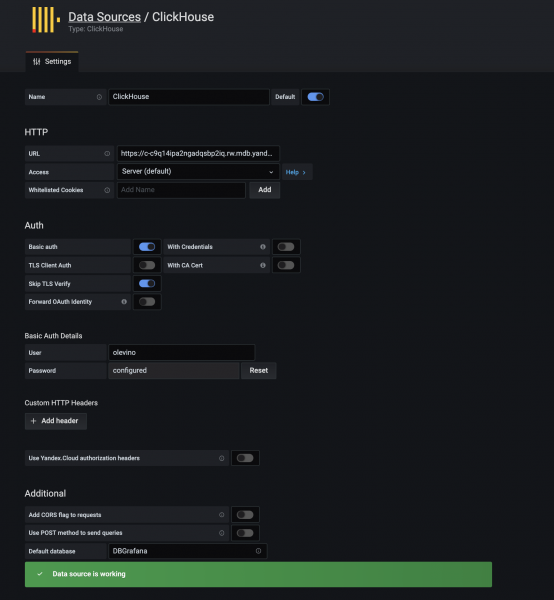
I specified the URL as https://c-.rw.mdb.yandexcloud.net:8443
That's it! We have one operational virtual machine with a web server connected to CH and MySQL. We can already upload a dataset into ClickHouse and build dashboards. However, we have not yet reached our goal and have not deployed a full infrastructure.
Packer
Yandex.Cloud allows you to create a disk image of an existing virtual machine, and based on that, you can create as many identical machines as you like. This is exactly what we will do. To conveniently collect the image, we will use a tool from HashiCorp. It takes a JSON file as input with instructions for building the image.
Our JSON file will consist of two blocks: builders and provisioners. The first block describes the parameters of the image as an entity, and the second provides instructions for filling it with the necessary content.
Builders
{
"builders": [
    {
      "type": "yandex",
      "endpoint": "{{user `endpoint`}}",
      "folder_id": "",
      "subnet_id": "{{user `subnet_id`}}",
      "zone": "{{user `zone`}}",
      "labels": {},
      "use_ipv4_nat": true,
      "use_internal_ip": false,
      "service_account_key_file": "",
      "image_name": "grafana-{{timestamp}}",
      "image_family": "grafana",
      "image_labels": {},
      "image_description": "GRAFANA",
      "source_image_family": "ubuntu-1804-lts",
      "disk_size_gb": 3,
      "disk_type": "network-hdd",
      "ssh_username": "ubuntu"
    }
  ],
...
}
In this template, you need to specify the ID of the section in the cloud where you want to create the image, as well as the path to the file with the service account keys previously set up in this section. You can find more about creating service accounts and keys in file form in the corresponding section. .
This configuration states that the disk image will be assembled based on the platform ubuntu-1804-lts, placed in the user's corresponding section in the image family GRAFANA under the name grafana-{{timestamp}}.
Provisioners
Laten we nu de spannendere onderdelen van de configuratie bekijken. Hierin wordt de volgorde van acties beschreven die op de virtuele machine moeten worden uitgevoerd voordat deze in een schijfbeeld wordt opgeslagen.
{
...,
"provisioners": [
    {
            "type": "shell",
            "pause_before": "5s",
            "scripts": [
                "prepare-ctg.sh"
            ]
        },
    {
            "type": "file",
            "source": "setup.sh",
            "destination": "\/opt\/grafana\/setup.sh"
        },
        {
            "type": "shell",
        "execute_command": "sudo {{ .Vars }} bash '{{ .Path }}'",
            "pause_before": "5s",
            "scripts": [
                "install-packages.sh",
                "grafana-setup.sh",
                "run-setup-at-reboot.sh"
        ]
        }
  ]
}
Hier zijn alle acties verdeeld over 3 fasen. In de eerste fase wordt een eenvoudig script uitgevoerd dat een hulpprogrammadirectory aanmaakt.
prepare-ctg.sh:
#!/bin/bash
sudo mkdir -p /opt/grafana
sudo chown -R ubuntu:ubuntu /opt/grafana
In de volgende fase plaatsen we in deze directory een script dat onmiddellijk na het opstarten van de virtuele machine moet worden uitgevoerd. Dit script zal de gebruikersvariabelen die moeten worden ingesteld in de Grafana-configuratie plaatsen en de webserver opnieuw opstarten.
setup.sh:
#!/bin/bash
CLUSTER_ID="<cluster_id>"
USERNAME="<username>"
PASSWORD="<password>"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@c-${CLUSTER_ID}.rw.mdb.yandexcloud.net#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
Daarna moeten er nog 3 dingen gedaan worden:
1) pakketten installeren
2) Grafana onder systemctl starten en de ClickHouse-plugin installeren
3) het script setup.sh in de opstartwachtrij plaatsen zodat het direct na de inschakeling van de virtuele machine wordt uitgevoerd.
install-packages.sh:
#!/bin/bash
sudo systemd-run --property='After=apt-daily.service apt-daily-upgrade.service' --wait /bin/true
sudo apt-get install -y apt-transport-https
sudo apt-get install -y software-properties-common wget
wget -q -O - https://packages.grafana.com/gpg.key | sudo apt-key add -
sudo add-apt-repository "deb https://packages.grafana.com/enterprise/deb stable main"
sudo apt-get update
sudo apt-get install -y grafana-enterprise
grafana-setup.sh:
#!/bin/bash
sudo systemctl start grafana-server
sudo systemctl enable grafana-server
sudo grafana-cli plugins install vertamedia-clickhouse-datasource
run-setup-at-reboot.sh:
#!/bin/bash
chmod +x /opt/grafana/setup.sh
cat > /etc/cron.d/first-boot <<EOF
PATH=/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin:/usr/games:/usr/local/games
@reboot root /bin/bash /opt/grafana/setup.sh > /var/log/yc-setup.log 2>&1
EOF
chmod +x /etc/cron.d/first-boot;
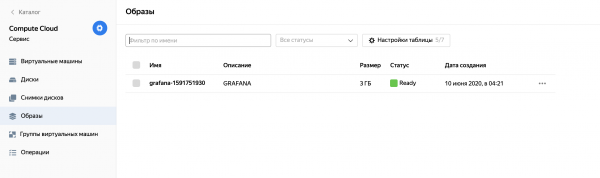
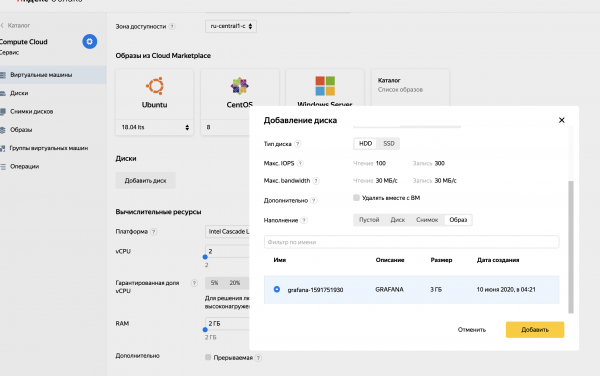
Nu resteert alleen nog het starten van Packer, waardoor we een beeld ontvangen dat in het opgegeven gedeelte is geplaatst. Bij het creëren van de virtuele machine kan deze als opstartschijf worden gekozen, waarna we een kant-en-klare Grafana-webserver kunnen krijgen.
Instance-groep en load balancer
Nadat er een schijfbeeld beschikbaar is dat het mogelijk maakt om meerdere identieke Grafana-webservers te creëren, kunnen we een instance-groep aanmaken. Op het Yandex.Cloud-platform wordt deze term gebruikt om een verzameling virtuele machines aan te duiden die identieke kenmerken hebben. Bij het creëren van een instance-groep wordt het prototype van alle machines in deze groep geconfigureerd, evenals de kenmerken van de groep zelf (bijvoorbeeld het minimale en maximale aantal actieve machines). Als het huidige aantal niet aan deze criteria voldoet, verwijdert de instance-groep automatisch de onnodige machines of creëert nieuwe op basis van het bestaande model.
In het kader van onze taak zullen we een instance-groep van webservers creëren die zullen worden gegenereerd uit het eerder gemaakte schijfbeeld.
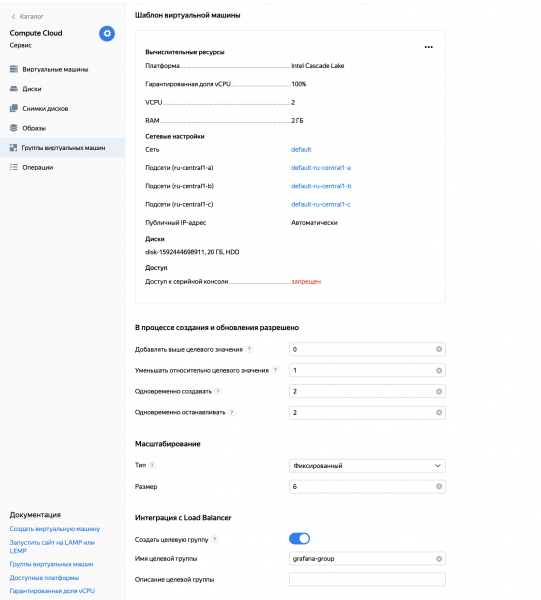
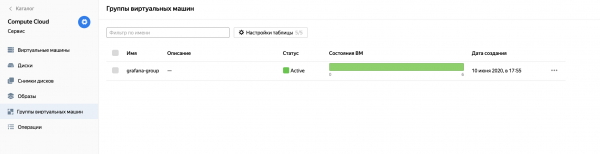
De laatste configuratie van de instance-groep is echt opmerkelijk. De doelgroep in integratie met de Load Balancer maakt het mogelijk om met een paar klikken een L3-balancer bovenop de virtuele machines van deze groep in te stellen.
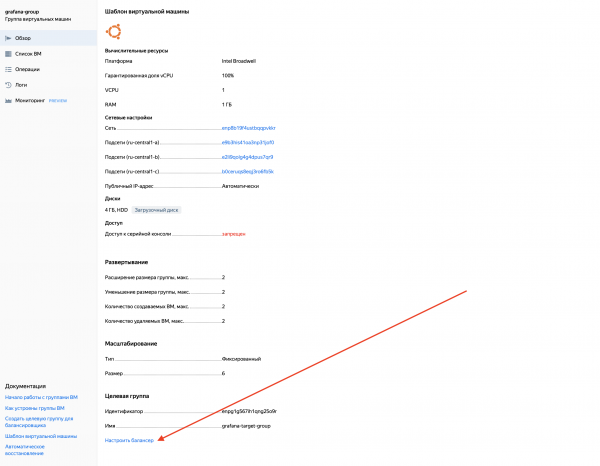
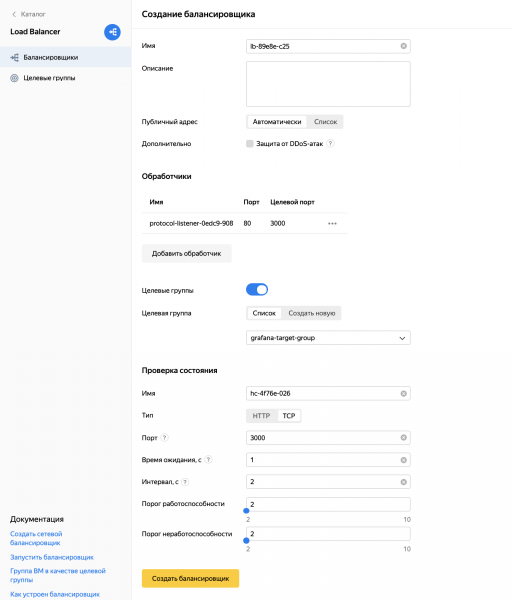
Bij het instellen van de balancer heb ik twee belangrijke punten gerealiseerd:
- Ik heb ervoor gezorgd dat de balancer gebruikersverkeer op poort 80 accepteert en dit doorstuurt naar poort 3000 van de virtuele machines, precies waar Grafana zich bevindt.
- Ik heb de levensvatbaarheid van de machines ingesteld door ze te pingen op poort 3000.
Mini-samenvatting
Uiteindelijk hebben we met eigen handen de gewenste infrastructuur van de applicatie kunnen implementeren, en nu hebben we een hoog-beschikbaar Grafana-service. We hoeven alleen het IP-adres van de balancer te weten als toegangspunt voor de applicatie en de cluster host van ClickHouse om de dataset erin te laden.
Zou je denken dat dit een overwinning is? Ja, een overwinning. Maar er is toch iets dat verontrust. Het hele proces hierboven vereist veel handmatige acties en is totaal niet schaalbaar; we willen het zo veel mogelijk automatiseren. Dit zal worden behandeld in de volgende sectie.
Integratie met Terraform
We gaan weer gebruik maken van het hulpmiddel van HashiCorp, genaamd . Dit zal helpen om met een druk op de knop de hele infrastructuur van de applicatie te implementeren, gebaseerd op enkele variabelen die door de gebruiker zijn doorgegeven. Laten we een recept schrijven dat we meervoudig kunnen uitvoeren in verschillende secties van verschillende gebruikers.
Al het werk met Terraform komt neer op het schrijven van een configuratiebestand (*.tf) en het creëren van de infrastructuur op basis daarvan.
Variabelen
Aan het begin van het bestand halen we de variabelen naar voren die bepalen waar en hoe de toekomstige infrastructuur zal worden geïmplementeerd.
variable "oauth_token" {
    type = string
    default = ""
}
variable "cloud_id" {
    type = string
    default = ""
}
variable "folder_id" {
    type = string
    default = ""
}
variable "service_account_id" {
    type = string
    default = ""
}
variable "image_id" {
    type = string
    default = ""
}
variable "username" {
    type = string
    default = ""
}
variable "password" {
    type = string
    default = ""
}
variable "dbname" {
    type = string
    default = ""
}
variable "public_key_path" {
    type = string
    default = ""
}
Het hele proces van het implementeren van de applicatie zal neerkomen op het samenstellen van een schijfimage en het instellen van deze variabelen. Laat me uitleggen waarvoor ze verantwoordelijk zijn:
oauth_token — een token voor toegang tot de cloud. Dit kan worden verkregen via .
cloud_id — de identifier van de cloud waar we de applicatie gaan implementeren
folder_id — de sectie-identificatie waar we de applicatie gaan implementeren
service_account_id — de identificatie van het service-account in het overeenkomstige gedeelte van de cloud.
image_id — de identificatie van de schijf afbeelding verkregen met Packer
username en password — gebruikersnaam en wachtwoord voor toegang tot beide databases en de Grafana webserver
dbname — naam van de database binnen de clusters CH en MySQL
public_key_path — pad naar het bestand met uw openbare ssh-sleutel, waarmee u kunt inloggen onder de naam ubuntu op virtuele machines met webservers
Providerconfiguratie
Nu moeten we de Terraform provider configureren — in ons geval Yandex:
provider "yandex" {
  token     = var.oauth_token
  cloud_id  = var.cloud_id
  folder_id = var.folder_id
  zone      = "ru-central1-a"
}
We kunnen opmerken dat we hier de eerder gedefinieerde variabelen gebruiken.
Netwerk en clusters
Laten we nu een netwerk creëren waarin de onderdelen van onze infrastructuur zullen communiceren, drie subnetten (één in elke regio) en de clusters CH en MySQL inrichten.
resource "yandex_vpc_network" "grafana_network" {}

resource "yandex_vpc_subnet" "subnet_a" {
  zone           = "ru-central1-a"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.1.0.0\/24"]
}

resource "yandex_vpc_subnet" "subnet_b" {
  zone           = "ru-central1-b"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.2.0.0\/24"]
}

resource "yandex_vpc_subnet" "subnet_c" {
  zone           = "ru-central1-c"
  network_id     = yandex_vpc_network.grafana_network.id
  v4_cidr_blocks = ["10.3.0.0\/24"]
}

resource "yandex_mdb_clickhouse_cluster" "ch_cluster" {
  name        = "grafana-clickhouse"
  environment = "PRODUCTION"
  network_id  = yandex_vpc_network.grafana_network.id

  clickhouse {
    resources {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 16
    }
  }

  zookeeper {
    resources {
      resource_preset_id = "s2.micro"
      disk_type_id       = "network-ssd"
      disk_size          = 10
    }
  }

  database {
    name = var.dbname
  }

  user {
    name     = var.username
    password = var.password
    permission {
      database_name = var.dbname
    }
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    type      = "CLICKHOUSE"
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }

  host {
    type      = "ZOOKEEPER"
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}

resource "yandex_mdb_mysql_cluster" "mysql_cluster" {
  name        = "grafana_mysql"
  environment = "PRODUCTION"
  network_id  = yandex_vpc_network.grafana_network.id
  version     = "8.0"

  resources {
    resource_preset_id = "s2.micro"
    disk_type_id       = "network-ssd"
    disk_size          = 16
  }

  database {
    name = var.dbname
  }

  user {
    name     = var.username
    password = var.password
    permission {
      database_name = var.dbname
      roles         = ["ALL"]
    }
  }

  host {
    zone      = "ru-central1-a"
    subnet_id = yandex_vpc_subnet.subnet_a.id
  }
  host {
    zone      = "ru-central1-b"
    subnet_id = yandex_vpc_subnet.subnet_b.id
  }
  host {
    zone      = "ru-central1-c"
    subnet_id = yandex_vpc_subnet.subnet_c.id
  }
}
Zoals te zien is, zijn beide clusters voldoende fouttolerant opgezet door ze in drie beschikbaarheidszones te plaatsen.
Webservers
Het lijkt misschien logisch om door te gaan op dezelfde manier, maar ik stuitte op een probleem. Voordat ik dit deed, had ik eerst een MySQL-cluster opgezet en pas daarna, wetende wat de ID was, maakte ik een schijfkopie met de juiste configuratie, waarin ik de host naar het cluster gaf. Maar nu weten we de ID van het cluster niet vóór de uitvoering van Terraform, ook niet op het moment van het bouwen van de schijfkopie. Daarom moesten we het volgende .
Met behulp van de metadata-service van Amazon zullen we enkele parameters aan de virtuele machine doorgeven, die deze zal accepteren en verwerken. We moeten ervoor zorgen dat de machine, na de opstart, de metadata raadpleegt voor de MySQL-cluster host en de gebruikersnaam-wachtwoord die de gebruiker in het Terraform-bestand heeft opgegeven. We zullen de inhoud van het bestand lichtelijk aanpassen. setup.sh, dat wordt uitgevoerd wanneer de virtuele machine wordt ingeschakeld.
setup.sh:
#!/bin/bash
CLUSTER_URI="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/mysql_cluster_uri)"
USERNAME="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/username)"
PASSWORD="$(curl -H 'Metadata-Flavor:Google' http://169.254.169.254/computeMetadata/v1/instance/attributes/password)"
sudo sed -i "s#.*;url =.*#url = mysql://${USERNAME}:${PASSWORD}@${CLUSTER_URI}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_user =.*#admin_user = ${USERNAME}#" /etc/grafana/grafana.ini
sudo sed -i "s#.*;admin_password =.*#admin_password = ${PASSWORD}#" /etc/grafana/grafana.ini
sudo service grafana-server restart
Instance-groep en load balancer
Na het opnieuw samenstellen van het nieuwe schijfbeeld kunnen we eindelijk ons bestand voor Terraform aanpassen.
Laten we aangeven dat we een bestaand schijfbeeld willen gebruiken:
data "yandex_compute_image" "grafana_image" {
  image_id = var.image_id
}
Laten we nu een instance-groep aanmaken:
resource "yandex_compute_instance_group" "grafana_group" {
  name               = "grafana-group"
  folder_id          = var.folder_id
  service_account_id = var.service_account_id
  instance_template {
    platform_id = "standard-v1"
    resources {
      memory = 1
      cores  = 1
    }
    boot_disk {
      mode = "READ_WRITE"
      initialize_params {
        image_id = data.yandex_compute_image.grafana_image.id
        size     = 4
      }
    }
    network_interface {
      network_id = yandex_vpc_network.grafana_network.id
      subnet_ids = [yandex_vpc_subnet.subnet_a.id, yandex_vpc_subnet.subnet_b.id, yandex_vpc_subnet.subnet_c.id]
      nat = "true"
    }
    metadata = {
      mysql_cluster_uri = "c-${yandex_mdb_mysql_cluster.mysql_cluster.id}.rw.mdb.yandexcloud.net:3306/${var.dbname}"
      username = var.username
      password = var.password
      ssh-keys = "ubuntu:${file("${var.public_key_path}")}"
    }
    network_settings {
      type = "STANDARD"
    }
  }

  scale_policy {
    fixed_scale {
      size = 6
    }
  }

  allocation_policy {
    zones = ["ru-central1-a", "ru-central1-b", "ru-central1-c"]
  }

  deploy_policy {
    max_unavailable = 2
    max_creating    = 2
    max_expansion   = 2
    max_deleting    = 2
  }

  load_balancer {
    target_group_name = "grafana-target-group"
  }
}
Het is belangrijk om op te merken hoe we de metadata hebben doorgegeven cluster_uri, username en password. Deze zal de virtuele machine bij het opstarten ophalen en in de configuratie van Grafana plaatsen.
Het laatste stuk is aan de load balancer.
resource "yandex_lb_network_load_balancer" "grafana_balancer" {
  name = "grafana-balancer"

  listener {
    name = "grafana-listener"
    port = 80
    target_port = 3000
    external_address_spec {
      ip_version = "ipv4"
    }
  }

  attached_target_group {
    target_group_id = yandex_compute_instance_group.grafana_group.load_balancer.0.target_group_id

    healthcheck {
      name = "healthcheck"
      tcp_options {
        port = 3000
      }
    }
  }
}
Een beetje suiker
Er resteert nog een klein beetje werk. Nadat de infrastructuur is uitgerold, moeten we naar de Grafana UI gaan en handmatig de cluster CH (waarvan we het ID nog moeten verkrijgen) als Data Source toevoegen. Maar het ID van de cluster is bekend bij Terraform. Laten we hem deze klus afronden.
We will add a new provider — Grafana, and we will use the IP address of the load balancer as the host. All changes made by Terraform on the machine designated by its load balancer will propagate to MySQL, and thus to all other machines.
provider "grafana" {
  url  = "http://${[for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0}"
  auth = "${var.username}:${var.password}"
}

resource "grafana_data_source" "ch_data_source" {
  type          = "vertamedia-clickhouse-datasource"
  name          = "grafana"
  url           = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
  basic_auth_enabled = "true"
  basic_auth_username = var.username
  basic_auth_password = var.password
  is_default = "true"
  access_mode = "proxy"
}
Let's tidy up
We will extract the IP address of the load balancer and the host of the ClickHouse cluster
output "grafana_balancer_ip_address" {
  value = [for s in yandex_lb_network_load_balancer.grafana_balancer.listener: s.external_address_spec.0.address].0
}

output "clickhouse_cluster_host" {
  value = "https://c-${yandex_mdb_clickhouse_cluster.ch_cluster.id}.rw.mdb.yandexcloud.net:8443"
}
You can start running
That's it! Our configuration file is ready, and we can instruct Terraform to deploy everything we described above by setting the variables. The entire process took me about 15 minutes.
At the end, you can see a nice message:
Apply complete! Resources: 9 added, 0 changed, 0 destroyed.
Outputs:

clickhouse_cluster_host = https://c-c9q14ipa2ngadqsbp2iq.rw.mdb.yandexcloud.net:8443
grafana_balancer_ip_address = 130.193.50.25
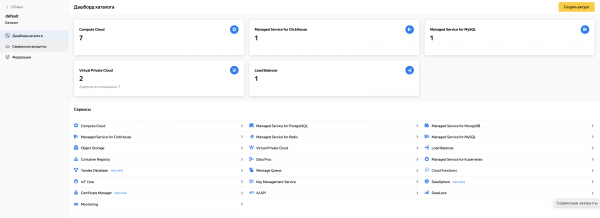
And in the cloud, you will see the elements of the deployed infrastructure:
Laten we de resultaten samenvatten
Now, using Grafana as an example, each of you knows how to deploy applications with a sprawling cloud architecture on the Yandex.Cloud platform. You can utilize helpful tools from HashiCorp, such as Packer and Terraform. I hope this article will be useful to someone 🙂
P.S. Below, I will attach a link to the repository where you can find ready-made recipes for Packer and Terraform, the snippets of which I provided in this article.
Bron: habr.com
