

Ik ga verder met mijn verhaal over hoe je Exchange en ELK kunt koppelen (begin ). Vergeet niet dat deze combinatie in staat is om zonder aarzeling een zeer grote hoeveelheid logboeken te verwerken. Dit keer zullen we bespreken hoe we Exchange kunnen laten samenwerken met de componenten Logstash en Kibana.
Logstash in de ELK-stack wordt gebruikt voor de intelligente verwerking van logboeken en hun voorbereiding voor opslag in Elastic in de vorm van documenten, waarvan je gemakkelijk verschillende visualisaties in Kibana kunt bouwen.
Installatie
Het bestaat uit twee fasen:
- Installatie en configuratie van het OpenJDK-pakket.
- Installatie en configuratie van het Logstash-pakket.
Installatie en configuratie van het OpenJDK-pakket
Het OpenJDK-pakket moet worden gedownload en uitgepakt in een specifieke directory. Vervolgens moet het pad naar deze directory worden toegevoegd aan de variabelen $env:Path en $env:JAVA_HOME van het Windows-besturingssysteem:
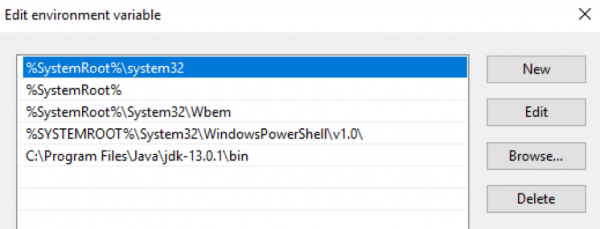
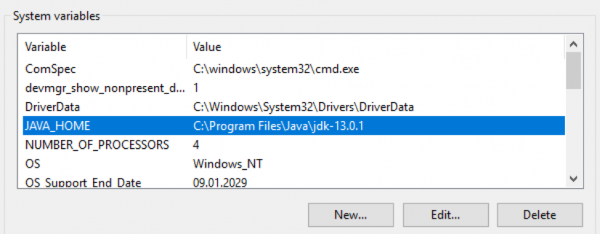
Laten we de Java-versie controleren:
PS C:> java -version
openjdk versie "13.0.1" 2019-10-15
OpenJDK Runtime Environment (build 13.0.1+9)
OpenJDK 64-Bit Server VM (build 13.0.1+9, gemengd modus, delen)
Installatie en configuratie van het Logstash-pakket
Download het archiefbestand met de distributie van Logstash. . Het archief moet worden uitgepakt in de hoofdmap van de schijf. Het is niet aan te raden om het uit te pakken in een map C:Program Files , omdat Logstash dan mogelijk niet goed opstart. Vervolgens moet er in het bestand jvm.options aanpassingen worden gedaan die verantwoordelijk zijn voor de toewijzing van geheugen voor het Java-proces. Ik raad aan om de helft van het RAM van de server in te stellen. Als er 16 GB RAM beschikbaar is, zijn de standaardinstellingen:
-Xms1g
-Xmx1g
moeten worden vervangen door:
-Xms8g
-Xmx8g
Bovendien is het zinvol om de regel -XX:+UseConcMarkSweepGCcommentaar te geven. Meer hierover . De volgende stap is het creëren van de standaardconfiguratie in het bestand logstash.conf:
input {
 stdin{}
}

filter {
}

output {
 stdout {
 codec => "rubydebug"
 }
}
Met deze configuratie leest Logstash gegevens van de console, laat het door een lege filter en geeft het weer terug aan de console. Het gebruik van deze configuratie stelt je in staat om de functionaliteit van Logstash te controleren. Laten we het in interactieve modus starten:
PS C:...bin> .logstash.bat -f .logstash.conf
...
[2019-12-19T11:15:27,769][INFO ][logstash.javapipeline ][main] Pipeline gestart {"pipeline.id"=>"main"}
De stdin-plugin wacht nu op invoer:
[2019-12-19T11:15:27,847][INFO ][logstash.agent ] Pipelines draaien {:count=>1, :running_pipelines=>[:main], :non_running_pipelines=>[]}
[2019-12-19T11:15:28,113][INFO ][logstash.agent ] Logstash API-eindpunt succesvol gestart {:port=>9600}
Logstash is succesvol gestart op poort 9600.
De laatste stap van de installatie: Logstash als Windows-service starten. Dit kan bijvoorbeeld met behulp van het pakket :
PS C:...bin> .nssm.exe install logstash
Service "logstash" succesvol geïnstalleerd!
Resilience
De veiligheid van logs tijdens verzending vanaf de oorspronkelijke server wordt gegarandeerd door het mechanisme van Persistente Wachtrijen.
Hoe het werkt
Schema van de plaatsing van wachtrijen in het verwerkingsproces van logs: input → queue → filter + output.
De input-plugin ontvangt gegevens van de logbron, schrijft ze naar de wachtrij en bevestigt de ontvangst van de gegevens aan de bron.
Berichten uit de wachtrij worden verwerkt door Logstash, ondergaan filtering en de output-plugin. Bij ontvangst van een bevestiging van de output over de verzending van de log, verwijdert Logstash de verwerkte log uit de wachtrij. Als Logstash stopt, blijven alle niet-verwerkte berichten en berichten die geen bevestiging van verzending hebben ontvangen in de wachtrij, en Logstash zal ze blijven verwerken bij de volgende opstart.
Instellingen
Wordt geregeld met sleutels in het bestand C:Logstashconfiglogstash.yml:
queue.type: (mogelijke waarden —persistedengeheugen (standaard)).path.queue: (pad naar de map met wachtrijbestanden, die standaard worden opgeslagen in C:Logstashqueue).queue.page_capacity: (maximale paginagrootte van de wachtrij, standaardwaarde — 64mb).queue.drain: (true/false — schakelt de stopzetting van de verwerking van de wachtrij in of uit voordat Logstash wordt afgesloten. Ik raad aan dit niet in te schakelen, omdat dit direct invloed heeft op de snelheid van het afsluiten van de server).queue.max_events: (maximaal aantal evenementen in de wachtrij, standaard — 0 (niet beperkt)).queue.max_bytes: (maximale grootte van de wachtrij in bytes, standaard — 1024mb (1gb)).
Als ingesteld queue.max_events en queue.max_bytes, dan worden berichten niet meer in de wachtrij geaccepteerd bij het bereiken van een waarde van een van deze instellingen. Meer informatie over Persistente Wachtrijen staat beschreven .
Voorbeeld van een gedeelte van logstash.yml dat verantwoordelijk is voor het instellen van de wachtrij:
queue.type: persisted
queue.max_bytes: 10gb
Instellingen
De configuratie van Logstash bestaat doorgaans uit drie delen, die verantwoordelijk zijn voor verschillende fasen van de verwerking van binnenkomende logs: ontvangst (input-sectie), parsing (filter-sectie) en verzending naar Elastic (output-sectie). Hieronder bekijken we elk van deze onderdelen in meer detail.
Invoer
De binnenkomende stroom van ruwe logs wordt ontvangen van de filebeat-agenten. Dit is precies de plugin die we in de input-sectie vermelden:
input {
  beats {
    port => 5044
  }
}
Na deze configuratie begint Logstash poort 5044 te beluisteren en verwerkt het logs bij ontvangst volgens de instellingen van de filter-sectie. Indien nodig kan de kanaal voor het ontvangen van logs van filebeat in SSL worden gewikkeld. Meer informatie over de instellingen van de beats-plugin is beschreven .
Filter
Alle interessante tekstprotocollen die door Exchange worden gegenereerd, zijn in csv-indeling met de in het logbestand beschreven velden. Voor het parseren van csv-gegevens biedt Logstash ons drie plugins aan: , csv en grok. De eerste is de , maar kan alleen de eenvoudigste logs parseren.
Bijvoorbeeld, de volgende vermelding zal hij splitsen in twee (vanwege het bestaan van een komma binnen een veld), waardoor het log onjuist wordt geparsed:
…,"MDB:GUID1, Mailbox:GUID2, Event:526545791, MessageClass:IPM.Note, CreationTime:2020-05-15T12:01:56.457Z, ClientType:MOMT, SubmissionAssistant:MailboxTransportSubmissionEmailAssistant",…
Hij kan worden gebruikt bij het parseren van logs, zoals IIS. In dat geval kan de filtersectie er als volgt uitzien:
filter {
  if "IIS" in [tags] {
    dissect {
      mapping => {
        "message" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      remove_field => ["message"]
      add_field => { "application" => "exchange" }
    }
  }
}
De configuratie van Logstash staat voorwaardelijke operatoren toe, IIS . Binnen de plugin koppelen we de waarden van de velden aan hun namen, verwijderen we het oorspronkelijke veld,dat de logvermelding bevatte, en kunnen we een willekeurig veld toevoegen dat bijvoorbeeld de naam van de applicatie bevat waaruit we de logs verzamelen. berichtIn het geval van trackinglogs is het beter om de csv-plugin te gebruiken, deze kan complexe velden correct verwerken:
filter { if "Tracking" in [tags] { csv { columns => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"] remove_field => ["message", "tenant-id", "schema-version"] add_field => { "application" => "exchange" } } } }
Binnen de plugin koppelen we de waarden van de velden aan hun namen, verwijderen we het oorspronkelijke veld
(en ook de velden bericht tenant-id schema-version en ), dat de logvermelding bevatte, en kunnen we een willekeurig veld toevoegen dat bijvoorbeeld de naam van de applicatie bevat waaruit we de logs verzamelen.Bij de uitvoer van de filterfase krijgen we documenten die in eerste instantie klaar zijn voor visualisatie in Kibana. Wat ons ontbreekt, is het volgende:
Aan het einde van de filterfase krijgen we documenten die in een eerste benadering klaar zijn voor visualisatie in Kibana. Wat we nog nodig hebben is het volgende:
- Cijfervelden worden herkend als tekst, waardoor bewerkingen niet mogelijk zijn. Dat wil zeggen, de velden
time-takenvan de IIS-log, evenals de veldenrecipient-countentotal-bitesvan de Tracking-log. - De standaard tijdstempel van het document bevat de verwerkingstijd van de log, niet het tijdstip waarop deze aan de server werd geschreven.
- Veld
recipient-addresszal als één string verschijnen, wat analyse met het tellen van ontvangers van e-mails bemoeilijkt.
Het is tijd om wat magie toe te voegen aan het proces van logverwerking.
Conversie van cijfervelden
De dissect-plugin heeft een optie convert_datatype, die kan worden gebruikt om een tekstveld naar een numeriek formaat te converteren. Bijvoorbeeld zo:
dissect {
  …
  convert_datatype => { "time-taken" => "int" }
  …
}
Het is belangrijk om te onthouden dat deze methode alleen geschikt is als het veld zeker een string zal bevatten. Null-waarden in de velden worden niet door deze optie verwerkt en veroorzaken een uitzondering.
Voor trackinglogs kan de soortgelijke convert-methode beter niet worden gebruikt, omdat de velden recipient-count en total-bites leeg kunnen zijn. Voor de conversie van deze velden is het beter om de plugin :
mutate {
  convert => [ "total-bytes", "integer" ]
  convert => [ "recipient-count", "integer" ]
}
Splitsen van recipient_address in afzonderlijke ontvangers
Deze taak kan ook worden opgelost met behulp van de mutate-plugin:
mutate {
  split => ["recipient_address", ";"]
}
Tijdstempel aanpassen
In het geval van trackinglogs wordt de taak zeer eenvoudig afgehandeld door de plugin , die helpt om de datum en tijd in het benodigde formaat in het veld in te vullen timestamp date-time date { match => [ "date-time", "ISO8601" ] timezone => "Europe/Moscow" remove_field => [ "date-time" ] }:
In het geval van IIS-logs moeten we de gegevens van de velden combineren
time date en met behulp van de mutate-plugin, de vereiste tijdzone instellen en deze tijdstempel plaatsen in met behulp van de date-plugin: timestamp mutate { add_field => { "data-time" => "%{date} %{time}" } remove_field => [ "date", "time" ] } date { match => [ "data-time", "YYYY-MM-dd HH:mm:ss" ] timezone => "UTC" remove_field => [ "data-time" ] }
De outputsectie wordt gebruikt om de verwerkte logs naar een logontvanger te sturen. Bij directe verzending naar Elastic wordt de plugin gebruikt,
Uitvoer
waarbij het serveradres en de sjabloonnaam van de index voor het verzenden van het gecreëerde document worden opgegeven: output { elasticsearch { hosts => ["127.0.0.1:9200", "127.0.0.2:9200"] manage_template => false index => "Exchange-%{+YYYY.MM.dd}" } }
Eindconfiguratie
De eindconfiguratie zal er als volgt uitzien:
De eindconfiguratie zal er als volgt uitzien:
input {
  beats {
    port => 5044
  }
}

filter {
  if "IIS" in [tags] {
    dissect {
      mapping => {
        "message" => "%{date} %{time} %{s-ip} %{cs-method} %{cs-uri-stem} %{cs-uri-query} %{s-port} %{cs-username} %{c-ip} %{cs(User-Agent)} %{cs(Referer)} %{sc-status} %{sc-substatus} %{sc-win32-status} %{time-taken}"
      }
      remove_field => ["message"]
      add_field => { "application" => "exchange" }
      convert_datatype => { "time-taken" => "int" }
    }
    mutate {
      add_field => { "data-time" => "%{date} %{time}" }
      remove_field => [ "date", "time" ]
    }
    date {
      match => [ "data-time", "YYYY-MM-dd HH:mm:ss" ]
      timezone => "UTC"
      remove_field => [ "data-time" ]
    }
  }
  if "Tracking" in [tags] {
    csv {
      columns => ["date-time","client-ip","client-hostname","server-ip","server-hostname","source-context","connector-id","source","event-id","internal-message-id","message-id","network-message-id","recipient-address","recipient-status","total-bytes","recipient-count","related-recipient-address","reference","message-subject","sender-address","return-path","message-info","directionality","tenant-id","original-client-ip","original-server-ip","custom-data","transport-traffic-type","log-id","schema-version"]
      remove_field => ["message", "tenant-id", "schema-version"]
      add_field => { "application" => "exchange" }
    }
    mutate {
      convert => [ "total-bytes", "integer" ]
      convert => [ "recipient-count", "integer" ]
      split => ["recipient_address", ";"]
    }
    date {
      match => [ "date-time", "ISO8601" ]
      timezone => "Europe/Moscow"
      remove_field => [ "date-time" ]
    }
  }
}

output {
  elasticsearch {
    hosts => ["127.0.0.1:9200", "127.0.0.2:9200"]
    manage_template => false
    index => "Exchange-%{+YYYY.MM.dd}"
  }
}
Nuttige links:
Bron: habr.com
