

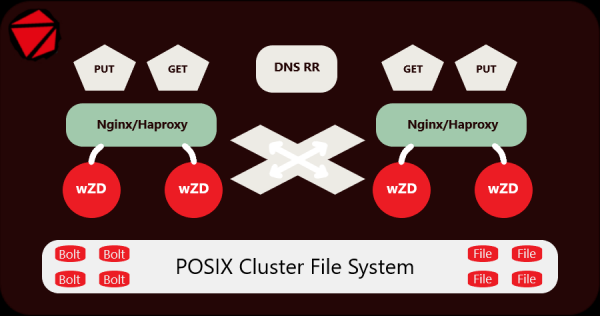
Beste gemeenschap, dit artikel zal gericht zijn op de efficiënte opslag en weergave van honderden miljoenen kleine bestanden. Op dit moment wordt een eindoplossing aangeboden voor POSIX-compatibele bestandssystemen met volledige ondersteuning voor locks, inclusief clusterlocks, en blijkbaar zelfs al zonder tijdelijke oplossingen.
Daarom heb ik voor dit doel mijn eigen gespecialiseerde server geschreven.
Tijdens de uitvoering van deze taak is het gelukt om het belangrijkste probleem op te lossen en tegelijkertijd schijfruimte en geheugen te besparen, die onverbiddelijk door ons clusterbestandssysteem werden verbruikt. Zoveel bestanden zijn eigenlijk schadelijk voor elk clusterbestandssysteem.
Het idee is als volgt:
In eenvoudige woorden, kleine bestanden worden via de server geüpload, ze worden direct in een archief opgeslagen en ook zo daaruit gelezen, terwijl grote bestanden ernaast worden geplaatst. Schema: 1 map = 1 archief, wat neerkomt op enkele miljoenen archieven met kleine bestanden, in plaats van enkele honderden miljoenen bestanden. En dit alles is volledig geïmplementeerd, zonder scripts en zonder bestanden in tar/zip-archieven te verspreiden.
Ik zal proberen dit korter uit te leggen en bied mijn excuses aan als de post te uitgebreid is.
Het begon allemaal omdat ik geen geschikte server in de wereld kon vinden die gegevens ontvangend via het HTTP-protocol direct in archieven kon opslaan, zodat er geen tekortkomingen waren die gebruikelijk zijn bij gewone archieven en objectopslag. De reden voor mijn zoektocht was een enorm gegroeide Origin-cluster van 10 servers, waar al 250.000.000 kleine bestanden waren opgeslagen, en de groeitrend verging niet.
Voor degenen die niet van het lezen van artikelen houden en kleine documentatie eenvoudiger vinden:
en .
En docker tegelijk, momenteel is er alleen een optie met nginx erbinnen voor alle zekerheid:
docker run -d --restart=always -e host=localhost -e root=\/var\/storage
-v \/var\/storage:\/var\/storage --name wzd -p 80:80 eltaline\/wzd
Vervolg:
Als er veel bestanden zijn, zijn aanzienlijke middelen nodig, en het spijtige is dat een deel daarvan nutteloos verloren gaat. Bijvoorbeeld, bij het gebruik van een clusterbestandssysteem (in dit geval MooseFS) neemt een bestand, ongeacht de feitelijke grootte, altijd minimaal 64 KB in beslag. Dit betekent dat voor bestanden van 3, 10 of 30 KB op de schijf 64 KB nodig is. Als er een kwart miljard bestanden zijn, verliezen we tussen de 2 en 10 terabyte. Eindeloos nieuwe bestanden aanmaken is niet mogelijk, want in MooseFS is er een beperking: niet meer dan 1 miljard met elke replica van elk bestand.
Naarmate het aantal bestanden toeneemt, is er veel RAM nodig voor metadata. Ook zorgen frequente grote dumps van metadata voor slijtage van SSD's.
Server wZD. We maken de schijven schoon.
De server is geschreven in Go. Allereerst moest ik het aantal bestanden verminderen. Hoe doe je dat? Door te archiveren, maar in dit geval zonder compressie, omdat mijn bestanden alleen maar gecomprimeerde afbeeldingen zijn. BoltDB kwam daarbij van pas, hoewel ik ook enkele tekortkomingen moest oplossen, wat in de documentatie is weerspiegeld.
Uiteindelijk zijn er in mijn geval in plaats van een kwart miljard bestanden nog maar 10 miljoen Bolt-archieven over. Als ik de huidige structuur van de bestandsdirectories had kunnen wijzigen, was het mogelijk om het aantal tot ongeveer 1 miljoen bestanden te verminderen.
Alle kleine bestanden worden verpakt in Bolt-archieven, die automatisch de namen krijgen van de directories waarin ze zich bevinden, terwijl alle grote bestanden naast de archieven blijven, omdat het geen zin heeft om deze te verpakken; dit is configureerbaar. Kleine bestanden worden gearchiveerd, grote bestanden blijven onveranderd. De server werkt transparant met zowel kleine als grote bestanden.
Architectuur en kenmerken van de wZD-server.
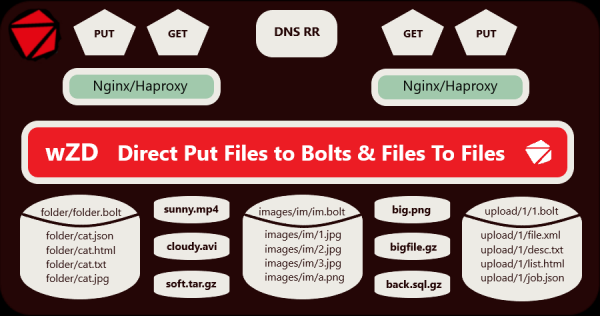
De server draait op de besturingssystemen Linux, BSD, Solaris en OSX. Ik heb het alleen getest voor de AMD64-architectuur onder Linux, maar het zou ook geschikt moeten zijn voor ARM64, PPC64, MIPS64.
Belangrijkste kenmerken:
- Multithreading;
- Multi-server functionaliteit, die redundantie en belastingbalancering waarborgt;
- Maximale transparantie voor de gebruiker of ontwikkelaar;
- Ondersteunde HTTP-methoden: GET, HEAD, PUT en DELETE;
- Beheer van gedrag bij lezen en schrijven via client-header;
- Ondersteuning voor flexibel configureerbare virtuele hosts;
- Ondersteuning voor CRC-gegevensintegriteit bij schrijven/lezen;
- Half-dynamische buffers voor minimaal geheugengebruik en optimale netwerkinstelling;
- Uitgestelde gegevenscompactie;
- Daarnaast wordt een multi-threaded archiver wZA aangeboden voor het migreren van bestanden zonder de service te stoppen.
Echte ervaring:
Ik heb de server en archiver lange tijd ontwikkeld en getest met live data, en deze werkt momenteel succesvol op een cluster met 250.000.000 kleine bestanden (afbeeldingen), verdeeld over 15.000.000 mappen op aparte SATA-schijven. Het cluster bestaat uit 10 servers die functioneren als de Origin-server, geïnstalleerd achter een CDN-netwerk. Voor het beheer worden 2 Nginx-servers + 2 wZD-servers gebruikt.
Voor degenen die deze server willen gebruiken, is het zinvol om de mapstructuur vooraf te plannen, indien van toepassing. Ik wil meteen zeggen dat de server niet bedoeld is om alles in één Bolt-archief te stoppen.
Prestatie testen:
Hoe kleiner de grootte van het gecomprimeerde bestand, hoe sneller de GET- en PUT-bewerkingen kunnen worden uitgevoerd. We vergelijken de totale schrijftijd van een HTTP-client naar normale bestanden en naar Bolt-archieven, evenals het lezen. We vergelijken de werking met bestanden van 32 KB, 256 KB, 1024 KB, 4096 KB en 32768 KB.
Bij het werken met Bolt-archieven wordt de integriteit van elk bestand gecontroleerd (CRC wordt gebruikt), zowel vóór als na de opslag vindt er een on-the-fly lezing en hercalculatie plaats, wat natuurlijk vertragingen met zich meebrengt, maar het belangrijkste is de veiligheid van de gegevens.
Ik heb prestatie tests uitgevoerd op SSD-opslag, aangezien de tests op SATA-schijven geen duidelijke verschillen tonen.
Grafieken van de testresultaten:
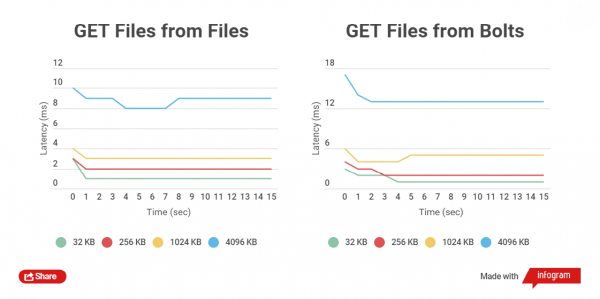
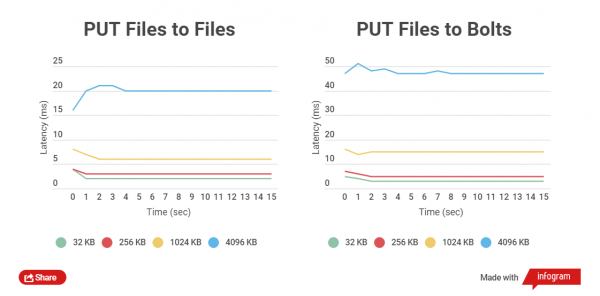
Zoals te zien is, is het tijdsverschil voor het lezen en schrijven van kleine bestanden tussen gecomprimeerde en niet-gecomprimeerde bestanden klein.
We krijgen echter een totaal ander beeld bij het testen van lezen en schrijven van bestanden van 32 MB:
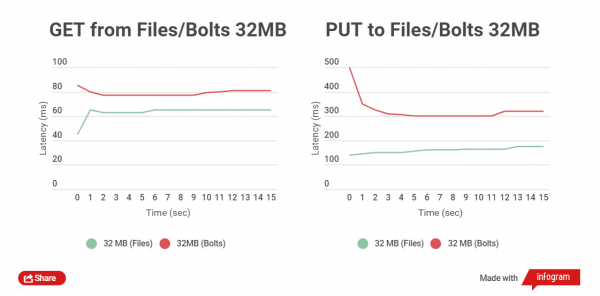
Het tijdsverschil tussen het lezen van bestanden bedraagt tussen de 5-25 ms. Met schrijven ligt het lastiger, het verschil is ongeveer 150 ms. Maar in dit geval is het ook niet nodig om grote bestanden te uploaden; dat heeft simpelweg geen zin, ze kunnen apart van de archieven bestaan.
*Technisch gezien kan deze server ook worden gebruikt voor taken die NoSQL vereisen.
Hoofdmethoden voor het werken met de wZD-server:
Uploaden van een gewoon bestand:
curl -X PUT --data-binary @test.jpg http://localhost/test/test.jpgBestand uploaden naar Bolt archief (als de serverparameter fmaxsize, die de maximale bestandsgrootte bepaalt die in het archief kan worden opgenomen, niet is overschreden; als deze is overschreden, wordt het bestand normaal geüpload naast het archief):
curl -X PUT -H "Archive: 1" --data-binary @test.jpg http://localhost/test/test.jpgBestand downloaden (als er bestanden met dezelfde namen op de schijf en in het archief staan, heeft het niet-gearchiveerde bestand standaard prioriteit bij het downloaden):
curl -o test.jpg http://localhost/test/test.jpgBestand downloaden uit Bolt archief (gedwongen):
curl -o test.jpg -H "FromArchive: 1" http://localhost/test/test.jpgOmschrijving van andere methoden is te vinden in de documentatie.
De server ondersteunt voorlopig alleen het HTTP-protocol, HTTPS werkt nog niet. Ook de POST-methode wordt niet ondersteund (of deze nodig is, is nog niet besloten).
Wie in de broncode duikt, zal daar een eterij vinden; niet iedereen houdt ervan, maar ik heb de hoofdcode niet aan de functies van het webframework gekoppeld, behalve de onderbrekingshandler, dus ik kan het later snel herschrijven naar bijna elke engine.
ToDo:
- Ontwikkeling van een eigen replicator en distributeur + geo voor gebruik in grote systemen zonder cluster FS (Alles professioneel)
- De mogelijkheid tot volledige reversibele herstel van metadata bij volledige verlies (in het geval van het gebruik van de distributeur)
- Native protocol voor de mogelijkheid tot gebruik van permanente netwerkverbindingen en drivers voor verschillende programmeertalen
- Uitgebreide mogelijkheden voor het gebruik van de NoSQL-component
- Compressie van verschillende types (gzip, zstd, snappy) voor bestanden of waarden binnen Bolt archieven en voor gewone bestanden
- Versleuteling van verschillende types voor bestanden of waarden binnen Bolt archieven en voor gewone bestanden
- Uitgestelde server video conversie, ook op GPU
Dat was alles, ik hoop dat deze server voor iemand nuttig zal zijn, BSD-3 licentie, dubbele copyright, want zonder het bedrijf waar ik werk, zou ik de server niet hebben geschreven. Ik ben de enige ontwikkelaar. Ik ben dankbaar voor gevonden bugs en feature requests.
Bron: habr.com
