

Het zoeken naar functionele afhankelijkheden in gegevens wordt toegepast in verschillende richtingen van data-analyse: databasebeheer, gegevensopschoning, reverse engineering van databases en gegevensverkenning. We hebben al eerder over deze afhankelijkheden gepubliceerd. Anastasia Birillo en Nikita Bobrov. Dit keer deelt Anastasia - afgestudeerde van het Computer Science Center van dit jaar - de ontwikkeling van dit werk binnen de onderzoeksresultaten die ze in het centrum heeft verdedigd.
Taakkeuze
Tijdens mijn studie aan het CS-centrum begon ik me grondiger te verdiepen in databases, met name in het zoeken naar functionele en differentiële afhankelijkheden. Dit onderwerp was gerelateerd aan het onderwerp van mijn scriptie aan de universiteit, dus begon ik tijdens het werken aan mijn scriptie artikelen te lezen over verschillende afhankelijkheden in databases. Ik schreef een overzicht van dit gebied - een van mijn eerste. in het Engels en diende het in voor de SEIM-2017-conferentie. Ik was erg blij toen ik hoorde dat het toch werd geaccepteerd en besloot me dieper in het onderwerp te verdiepen. Het concept is niet nieuw - het werd al in de jaren '90 toegepast, maar vindt nog steeds toepassing in veel gebieden.
In het tweede semester van mijn studie aan het centrum begon ik een onderzoeksproject gericht op het verbeteren van algoritmen voor het zoeken naar functionele afhankelijkheden. Ik werkte eraan samen met PhD-student Nikita Bobrov van de SPbGU bij JetBrains Research.
De computationele complexiteit van het zoeken naar functionele afhankelijkheden.
Het belangrijkste probleem is de computationele complexiteit. Het aantal mogelijke minimale en niet-triviale afhankelijkheden is bovengrens aan het aantal attributen van de tabel.  , waar
 De looptijd van de algoritmen hangt niet alleen af van het aantal attributen, maar ook van het aantal rijen. In de jaren '90 konden algoritmen die functionele afhankelijkheden zochten op een gewone desktop-PC datasets verwerken die tot 20 attributen en tienduizenden rijen bevatten, tot enkele uren. Moderne algoritmen, werkend op multi-core processoren, ontdekken afhankelijkheden voor datasets bestaande uit honderden attributen (tot 200) en enkele honderdduizenden rijen, ongeveer in dezelfde tijd. Dit is echter onvoldoende: deze tijd is onaanvaardbaar voor de meeste echte applicaties. Daarom hebben we benaderingen ontwikkeld om bestaande algoritmen te versnellen.
Caching-schema's voor het overlappen van partities.
In het eerste deel van het werk hebben we cacheschema's ontwikkeld voor een klasse algoritmen die gebruikmaken van de methode van partitionoverlap. Een partitie voor een attribuut stelt een set lijsten voor, waarbij elke lijst rijnummers bevat met dezelfde waarden voor het gegeven attribuut. Elke dergelijke lijst wordt een cluster genoemd. Veel moderne algoritmen gebruiken partities om te bepalen of een afhankelijkheid wordt behouden of niet, en houden zich aan de stelling: Een afhankelijkheid  wordt behouden als
 . Hier wordt de partitie aangeduid en wordt het begrip partitie-grootte gebruikt — het aantal clusters daarin. Algoritmen die gebruikmaken van partities voegen bij schending van de afhankelijkheid extra attributen toe aan de linkerzijde van de afhankelijkheid, waarna ze deze opnieuw berekenen door de operaties van partitionoverlap uit te voeren. Deze operatie wordt in artikelen specialisatie genoemd. Maar we hebben opgemerkt dat partities voor afhankelijkheden die pas na meerdere ronden van specialisatie zullen worden behouden, actief kunnen worden hergebruikt, wat de verwerkingstijd van algoritmen aanzienlijk kan verkorten, aangezien de operatie van partitionoverlap duur is.
 Daarom hebben we een heuristiek voorgesteld die is gebaseerd op de entropie van Shannon en de onzekerheid van Gini, evenals onze metriek die we Omgekeerde Entropie hebben genoemd. Deze is een kleine aanpassing van de entropie van Shannon en neemt toe naarmate de uniciteit van de dataset toeneemt. De voorgestelde heuristiek ziet er als volgt uit:
— de mate van uniciteit van de recent berekende partitie

Hier  — de mate van uniciteit van de recentelijk berekende partitie
 , met behulp van 1 bit, gelijk aan 0,
 is de mediaan van de uniciteitsgraad voor afzonderlijke attributen. Alle drie de eerder genoemde maatstaven voor uniciteit zijn als metrics getest. Ook is te merken dat er twee modificatoren in de heuristiek aanwezig zijn. De eerste geeft aan hoe dicht de huidige partitie bij de primaire sleutel ligt en maakt het mogelijk om in grotere mate de partities te cachen die verder weg zijn van de potentiële sleutel. De tweede modificator maakt het mogelijk om de bezetting van de cache te volgen en stimuleert zo de toevoeging van meer partities aan de cache wanneer er vrije ruimte is. Het succesvolle oplossen van deze taak heeft het PYRO-algoritme met 10-40% versneld, afhankelijk van de dataset. Het is vermeldenswaard dat het PYRO-algoritme het meest succesvol is op dit gebied.
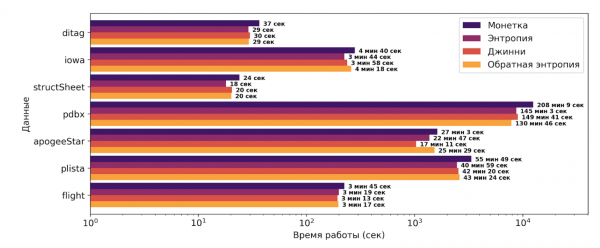
In de onderstaande afbeelding zijn de resultaten te zien van de toepassing van de voorgestelde heuristiek in vergelijking met de baseline benadering van caching, die is gebaseerd op het opgooien van een munt. De X-as is logarithmisch.
Alternatieve manier van opslag van partities
Vervolgens hebben we een alternatieve manier van opslag van partities voorgesteld. Partities vormen een set clusters, waarin de nummers van tuples met gelijke waarden voor bepaalde attributen worden opgeslagen. Deze clusters kunnen lange reeksen van tuple-nummers bevatten, bijvoorbeeld als de gegevens in de tabel zijn geordend. Daarom hebben we een compressieschema voorgesteld voor de opslag van partities, namelijk intervalopslag van waarden in de partitieclusters:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Eerste~interval}, underbrace{7, 8}_{Tweede~interval}, 10}}\ downarrow{Compressie}\ pi(X) = {{underbrace{$, 1, 5}_{Eerste~interval}, underbrace{7, 8}_{Tweede~interval}, 10}}$$display$$
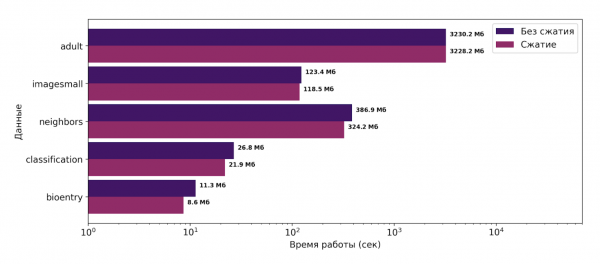
Deze methode kon het geheugenverbruik tijdens de uitvoering van het TANE-algoritme met 1 tot 25% verminderen. Het TANE-algoritme is een klassiek algoritme voor de ontdekking van functionele afhankelijkheden en gebruikt partities tijdens zijn werking. In de praktijk is gekozen voor het TANE-algoritme, omdat het veel eenvoudiger was om intervalopslag hierin te implementeren dan bijvoorbeeld in PYRO, om te evalueren of de voorgestelde aanpak werkt. De verkregen resultaten worden in de onderstaande afbeelding gepresenteerd. De X-as is logarithmisch.
Conferentie ADBIS-2019
Op basis van het onderzoek in september 2019 heb ik een artikel gepresenteerd Tijdens de 23ste Europese Conferentie over Vooruitgangen in Databases en Informatiesystemen (ADBIS-2019) benadrukte Bernhard Thalheim, een vooraanstaand persoon op het gebied van databases, mijn werk tijdens zijn presentatie. De onderzoeksresultaten vormden de basis van mijn scriptie in de masteropleiding wiskunde en mechanica aan de Staatsuniversiteit van Sint-Petersburg, waarin beide voorgestelde benaderingen (caching en compressie) werden geïmplementeerd in de algoritmen TANE en PYRO. De resultaten toonden aan dat de voorgestelde benaderingen universieel zijn, aangezien bij beide algoritmen en met beide benaderingen een aanzienlijke vermindering van het geheugengebruik en de uitvoeringstijd werd waargenomen.
Bron: habr.com
