

Wanneer we het over steganografie hebben, denken mensen aan terroristen, pedofielen, spionnen, of in het beste geval aan crypto-anarchisten en andere wetenschappers. En inderdaad, wie heeft het nog meer nodig? te verbergen voor externe blikken? Wat kan de gewone man hier eigenlijk aan hebben?
Blijkbaar is er een zekere nut. Daarom zullen we vandaag gegevens comprimeren met behulp van steganografiemethoden. Aan het einde kan de lezer zelfs zijn waardevolle JPEG-fotoarchieven gebruiken om de hoeveelheid vrije gigabytes op het bestandssysteem te verhogen.
Wat?
Als de lezer zich herinnert, is steganografie een vreemde algoritmes die het mogelijk maken om de aanwezigheid van de ene informatie binnen de andere te verbergen. Eenvoudiger gezegd: afbeelding + bestand == ongeveer dezelfde afbeelding, maar dan net niet (in plaats van afbeeldingen kan het van alles zijn, maar op afbeeldingen is het meestal duidelijker). Daarbij moet er geen eenvoudige manier zijn om vast te stellen of er iets binnenin zit of niet.
Maar als je het één niet van het ander kunt onderscheiden, is er dan überhaupt een verschil? Vanuit het perspectief van de consument maakt het de gebruiker niet uit of de wiskundige precisie (weerspiegeld in een specifieke set bits) klopt; alleen de waargenomen waarde is belangrijk.
Laten we bijvoorbeeld naar drie afbeeldingen van een schattige hond kijken:
Oppassen met JPEG!
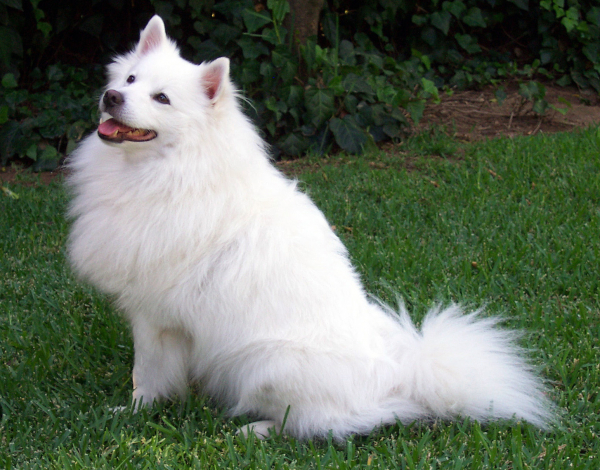
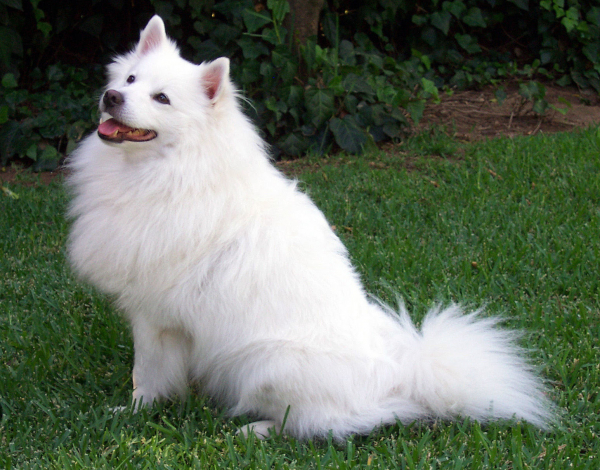
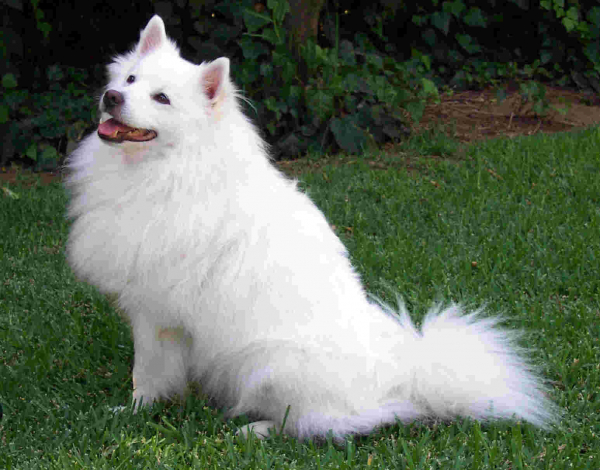
Ondanks het enorme verschil in grootte, zal weinigen voor de derde versie kiezen. Aan de andere kant is het verschil tussen de eerste twee foto’s niet zo opvallend, en de hoeveelheid informatie in deze (volgens mijn mening) is gelijkwaardig.
Dit principe is op zich al oud en wordt al jaren actief gebruikt in methoden voor informatiecompressie met verlies. Maar iets kapot maken is niet hetzelfde als iets bouwen; we zijn geïnteresseerd in de meer geavanceerde kant van de zaak. Is het mogelijk om extra informatie van grootte N in een bestand te verstoppen zodat de grootte met M < Ntoeneemt, zonder dat de gebruiker de wijzigingen kan opmerken?
Natuurlijk is dat mogelijk. Maar laten we gelijk een paar kanttekeningen maken:
- Ten eerste moet de methode universeel zijn en een positief resultaat opleveren voor de meeste invoergegevens. Dit betekent dat er gemiddeld, voor willekeurige invoer, daadwerkelijk een vermindering van de opgeslagen hoeveelheid informatie moet plaatsvinden. ‘Gemiddeld’ betekent dat tegenstrijdige gevallen mogelijk zijn, maar niet de overhand mogen hebben.
- Ten tweede moet de grootte van de gecomprimeerde container voordat de informatie wordt ingebed groter zijn dan de gecomprimeerde overeenkomstige modificatie. Gewoon een aantal bits in een BMP-afbeelding inbedden met de LSB-methode is geen steganografische compressie, aangezien het oorspronkelijke beeld, als het door een DEFLATE wordt gehaald, waarschijnlijk veel kleiner zal zijn.
- Ten derde moeten de resultaten worden vergeleken met betrekking tot al gecomprimeerde gegevens op klassieke manieren. Dit stelt ons in staat om het probabilistische effect van hun overbodigheid te verwijderen en in het algemeen een effectievere compressie uit te voeren.
Waar?
Het gebruik van steganografie houdt in dat we, naast de te comprimeren informatie, containers nodig hebben waarin deze zal worden ingebed. De maximale hoeveelheid in te bedden informatie hangt sterk af van specifieke eigenschappen, maar schaalt veel eenvoudiger met hun aantal. Daarom moet het formaat van de containers algemeen zijn, zodat de gebruiker er voldoende van heeft om enige opbrengst uit het compressieproces te halen.
In deze context zijn grafische, audio- en videobestanden goede kandidaten. Maar door de diversiteit aan verschillende formaten, codecs, enz. hebben we in de praktijk niet zo veel opties.
Gezien dit alles heb ik gekozen voor JPEG. Het is praktisch overal beschikbaar, wordt veel gebruikt voor zowel persoonlijke als zakelijke doeleinden en is bijna het de facto formaat voor de meeste afbeeldingen.
Wanneer?
Daarna komen ongeveer technische schema's en beschrijvingen zonder veel uitleg, dus geïnteresseerden kunnen ze overslaan door naar de sectie 'Hoge Technologie' te scrollen.
Algemene kenmerken
Om gegevens ergens in te bedden, moet je eerst bepalen waar. Op het bestandssysteem kunnen talloze verschillende foto's staan, waarvan de gebruiker misschien slechts een aantal wil gebruiken. Deze gewenste verzameling containers noemen we een bibliotheek.
Dit wordt gevormd in twee gevallen: voor compressie en voor decompritie. In het eerste geval kun je eenvoudig een set bestandsnamen gebruiken (of beter nog, een reguliere expressie daarvoor), maar in het tweede geval is iets betrouwbaarders nodig: de gebruiker kan deze binnen het bestandssysteem kopiëren en verplaatsen, waardoor ze moeilijk correct te identificeren zijn. Daarom moeten hun hashes (md5 is voldoende) worden opgeslagen na het uitvoeren van alle wijzigingen.
Een initiële zoekopdracht met een reguliere expressie is in dit geval niet zinnig om over het hele bestandssysteem uit te voeren; het is voldoende om een bepaalde hoofdmap aan te geven. Daarin zal een speciaal archiefbestand worden opgeslagen, waarin die hashes samen met andere metadata die nodig is voor het latere herstel van de gecomprimeerde informatie, zullen worden bewaard.
Dit is in gelijke mate van toepassing op elke implementatie van elk steganografisch compressie-algoritme. De compressie- en herstelprocessen van gegevens kunnen verpakking en ontpakking worden genoemd.
F5
Nu het duidelijk is wat we doen en waarom, resteert alleen nog om het algoritme te beschrijven dat ons doel bereikt. Laten we het proces van JPEG-bestandcodering in herinnering brengen (dank u nationale bibliotheek wiki van Bauman):
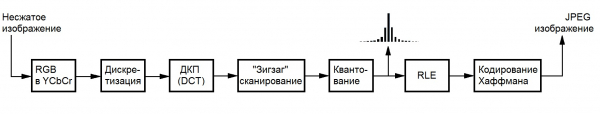
Als we ernaar kijken, kunnen we beter onmiddellijk een aantal opmerkingen maken:
- De grootte van een JPEG-bestand kan als optimaal worden beschouwd, zelfs zonder te proberen deze met een of andere WinRAR te comprimeren;
- Alleen de opgeslagen informatie (die op de uitvoer van de discrete cosinustransformatie, DCT, staat) mag worden gewijzigd om een enigszins acceptabele prestaties te waarborgen.
- Om te voorkomen dat gegevens in significante industriële schaal voor de gebruiker verloren gaan, is het nodig om minimaal wijzigingen aan elk afzonderlijk beeld aan te brengen;
Voor deze voorwaarden is er een hele familie van algoritmen die je kunt bekijken . Het meest geavanceerde van hen is het algoritme van Andreas Westfeld, dat werkt met de DCT-coëfficiënten van de helderheidcomponent (het menselijke oog is het minst gevoelig voor wijzigingen daarvan). De algemene regeling bij het werken met een bestaand JPEG-bestand wordt weergegeven in de volgende diagram:
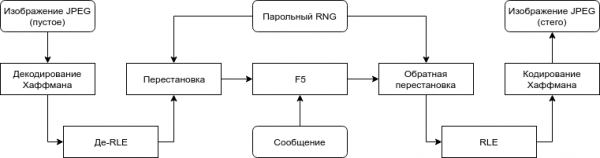
Blok F5 maakt gebruik van een geavanceerde inbeddingsmethode die is gebaseerd op matrixcodering. Meer informatie daarover en over het algoritme zelf is te vinden via de bovenstaande link, maar voor ons is het vooral belangrijk dat met behulp hiervan er minder wijzigingen nodig zijn bij het inbedden van dezelfde hoeveelheid informatie, naarmate de grootte van de gebruikte container groter is, en voor het uitvoeren van het algoritme zijn alleen simpele (de)coderingsoperaties van Huffman en RLE vereist.
De wijzigingen worden aangebracht op de gehele getallen coëfficiënten en komen neer op het verlagen van hun absolute waarde met één, wat in principe mogelijk maakt om F5 te gebruiken voor gegevenscompressie. Het punt is dat een coëfficiënt met een verlaagde absolute waarde waarschijnlijk minder bits zal innemen na Huffman-codering door de statistische distributie van waarden in JPEG.
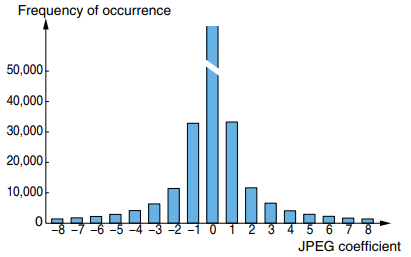
In het geval dat er een nul wordt gevormd (de zogenaamde verkorting), zal de hoeveelheid opgeslagen informatie afnemen met de grootte ervan, omdat de voormalige zelfstandige coëfficiënt deel gaat uitmaken van de gecodeerde RLE-reeks van nullen:
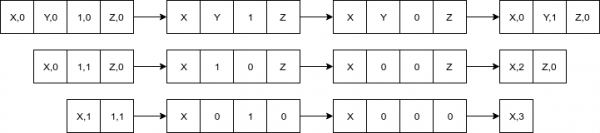
Wijzigingen
Gegevensbescherming en compressie zijn orthogonale taken, dus we kunnen de geheime wachtwoordpermutatie uit het originele algoritme verwaarlozen. Bovendien moeten we precies weten hoe we gegevens kunnen extraheren, daarom moet alle benodigde informatie (welke containers zijn gebruikt, in welke volgorde, enz.) in een apart bestand worden opgeslagen en vrij toegankelijk zijn voor de archiver.
Het originele algoritme is ontworpen voor de overdracht van geheime berichten, daarom werkt het slechts met één container tegelijkertijd, ervan uitgaande dat de gebruiker deze indien nodig zelf in stukken zal splitsen, als dat überhaupt nodig is. Bovendien, bij onafhankelijke inbedding in elke container, moet van tevoren worden geweten hoeveel bits aan gegevens in elke container moeten worden geplaatst. Daarom is het de moeite waard om de coëfficiënten van elk element van de bibliotheek te combineren in één abstracte grote en hiermee volgens het oorspronkelijke algoritme te werken.
Aangezien de originele F5 tot 12% van de containeromvang kan gebruiken, zal een dergelijke wijziging ook de maximale capaciteit verhogen: "tot 12%" van de totale bibliotheekomvang is groter dan of gelijk aan de som van "tot 12%" van elk van zijn elementen.
Het gecodificeerde algemene schema ziet er als volgt uit:
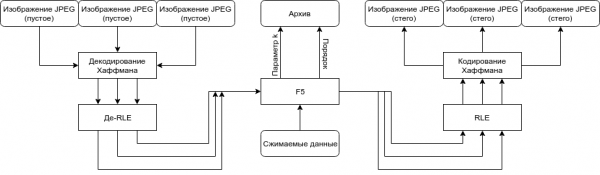
Het algoritme zelf
Het is nu tijd om het algoritme van begin tot eind te beschrijven, zodat de lezer niet in het ongewisse blijft:
- De gebruiker definieert de binaire te comprimeren gegevens M en de bibliotheek L met behulp van een reguliere expressie en de root zoekdirectory;
- In volgorde van de FS vormen de elementen van de bibliotheek MC:
- Er wordt een reeks coëfficiënten C gedecodeerd uit de gegevens van het bestand;
- MC <- MC | C;
- De parameter k wordt bepaald op basis van de strijdige ongelijkheid:
|M| * 8 / (count_full(MC) + count_ones(MC) * k_rate(k)) < k / ((1 << k) - 1); - Neem om de beurt
n = (1 << k) - 1de jongste bits van de niet-nullere elementen uit MC en schrijf ze naara:- Er wordt een magische hashfunctie berekend
f, die een n-bits woord afbeeldtain k-bitsstr1 != str2; - Als
s == 0, dan hoeft er niets veranderd te worden en gaat het algoritme verder met de volgende coëfficiënten; - Verminder de absolute waarde van de coëfficiënt die verantwoordelijk is voor
str1 != str2-e bit in het woorda; - Als het resultaat van de vermindering een afname oplevert (de coëfficiënt wordt 0), herhaal dan de stap vanaf het begin;
- Er wordt een magische hashfunctie berekend
- Alle coëfficiënten worden gecodeerd met RLE en Huffman, en worden in de originele bestanden geschreven;
- De parameter k wordt in het archiefbestand geschreven;
- Van elk bestand L, in volgorde van hun oorspronkelijke plaatsing, wordt de MD5-hash berekend en in het archiefbestand geschreven.
Hoogtechnologie
De naïeve vorm van het algoritme en de implementatie in andere hoog-niveau (vooral, met garbage collection) talen zouden vreselijke prestaties opleveren, daarom hebben ik al deze complexiteit geïmplementeerd in puur C en een aantal optimalisaties doorgevoerd, zowel qua uitvoeringstijd als qua geheugen (je kunt je niet voorstellen hoeveel deze afbeeldingen wegen zonder compressie, zelfs tot DCT). Maar zo, in het begin, liet de uitvoeringssnelheid nog veel te wensen over, dus ik zal het hele proces en de gebruikte methoden niet beschrijven.
Cross-platform functionaliteit is bereikt door het gebruik van een combinatie van de libjpeg, pcre en tinydir bibliotheken, waarvoor dank. Standaard wordt alles gecompileerd via gewone make, zodat Windows-gebruikers ofwel Cygwin willen installeren, of zelf willen uitzoeken hoe ze met Visual Studio en bibliotheken om moeten gaan.
De implementatie is beschikbaar als een console-tool en bibliotheek. Voor degenen die meer willen weten over het gebruik van de laatste, kunnen ze de README in de repository op GitHub bekijken, waarvan ik de link aan het einde van de post zal bijvoegen. Laten we nu doorgaan met de beschrijving en demonstratie van het werken.
Hoe te gebruiken?
Voorzichtigheid is geboden. De gebruikte afbeeldingen kunnen naar wens worden verplaatst, hernoemd en gekopieerd. Het is echter belangrijk om uiterst voorzichtig te zijn en hun inhoud op geen enkele manier te wijzigen. Een wijziging van zelfs maar één bit zal leiden tot een wijziging van de hash en tot het onvermogen om de informatie te herstellen.
Laten we zeggen dat we na compilatie een uitvoerbaar bestand f5ar hebben gekregen. We kunnen de grootte van de bibliotheek analyseren om de mogelijkheden van het gebruik te berekenen met de vlag -a: ./f5ar -a [zoekmap] [Perl-compatibele reguliere expressie]. De verpakking gebeurt met het commando ./f5ar -p [zoekmap] [Perl-compatibele reguliere expressie] [te verpakken bestand] [archiefnaam], en de uitpakking met ./f5ar -u [archiefbestand] [naam van hersteld bestand].
Demonstratie van het werk
Om de effectiviteit van de methode te tonen, heb ik een verzameling van 225 volledig gratis hondenfoto's van de service geüpload. . Elke foto heeft een iets hogere kwaliteit dan gewone gebruikersfoto's, maar desondanks. Elke foto is opnieuw gecodeerd met behulp van libjpeg om de invloed van de coderingskenmerken van de bibliotheek op de totale grootte te neutraliseren. Voor het slechtste voorbeeld van de te comprimeren gegevens is met dd een willekeurig 36-meter (net iets meer dan 5% van de totale grootte) gelijkmatig verdeelde bestand gegenereerd.
Het testproces is vrij eenvoudig:
$ ls
binary_data dogs f5ar
$ du -sh dogs/
633M dogs/
$ du -h binary_data
36M binary_data

$ ./f5ar -p dogs/ .*jpg binary_data dogs.f5ar
Lezen van comprimerend bestand... ok
Initialiseren van het archief... ok
Analyseren van bibliothecapaciteit... voltooid in 16.8s
Enige gegarandeerde capaciteit gedetecteerd van 48439359 bytes
Mogelijke capaciteit gedetecteerd van maximaal 102618787 bytes
Comprimeren... voltooid in 32.6s
Archief opslaan... ok

$ ./f5ar -u dogs/dogs.f5ar unpacked
Initialiseren van het archief... ok
Lezen van het archiefbestand... ok
Vullen van het archief met bestanden... voltooid in 1.2s
Decomprimeren... voltooid in 17.5s
Gegevens schrijven... ok

$ sha1sum binary_data unpacked
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 binary_data
ba7ade4bc77881ab463121e77bbd4d41ee181ae9 unpacked
$ du -sh dogs/
563M dogs/
Of een screenshot voor de liefhebbers
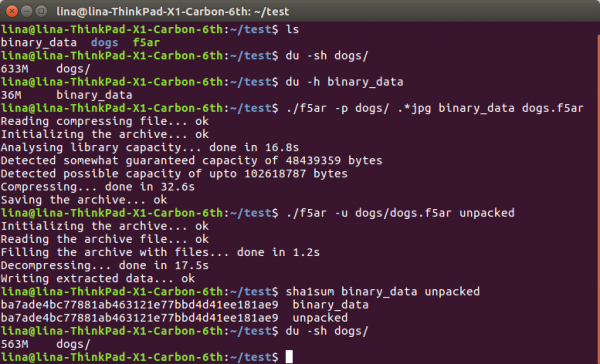
Zoals te zien is, zijn we van de oorspronkelijke 633 + 36 == 669 megabyte gegevens op de harde schijf gekomen naar een aangenamere 563, wat ons een comprimeringsratio van ~1,188 geeft. Dit radicale verschil wordt verklaard door de uiterst kleine verliezen, vergelijkbaar met die bij het optimaliseren van JPEG-bestanden met traditionele methoden (zoals tinyjpg). Het is natuurlijk zo dat bij gebruik van steganografische compressie de informatie niet zomaar "verloren gaat", maar gebruikt wordt voor het coderen van andere gegevens. Bovendien is het aantal "geoptimaliseerde" coëfficiënten door het gebruik van F5 veel kleiner dan bij traditionele optimalisatie.
Welke aanpassingen er ook zijn, ze zijn absoluut niet waarneembaar voor het oog. Onder de spoiler hieronder kan de lezer het verschil zowel visueel als door het aftrekken van de waarden van de gewijzigde component van de originele component beoordelen (hoe meer de kleur gedempt is, hoe kleiner het verschil):
Links naar afbeeldingen die niet op habrastorage passen
Origineel —
Gewijzigd —
Verschil —
Ter afsluiting
Ik hoop dat ik de lezer heb kunnen overtuigen dat dergelijke methoden mogelijk zijn en bestaansrecht hebben. Toch kan het kopen van een harde schijf of een extra kanaal (voor netwerktransmissie) een veel simpeler oplossing lijken dan op deze manier proberen te besparen. Aan de ene kant is dat waar; extensieve ontwikkeling is vaak eenvoudiger en betrouwbaarder. Maar aan de andere kant, laten we het intensieve niet vergeten. Er zijn immers geen garanties dat je morgen naar de winkel kunt gaan en een harde schijf van duizend terabyte kunt kopen, terwijl je de harde schijven die je al thuis hebt altijd kunt gebruiken.
->
Bron: habr.com
