

Zoals bekend biedt SAP een compleet scala aan software, zowel voor het beheer van transactionele gegevens als voor de verwerking van deze gegevens in analysemiddelen en rapportagesystemen. In het bijzonder is het SAP Business Warehouse (SAP BW) een instrumentarium voor het opslaan en analyseren van gegevens, met brede technische mogelijkheden. Ondanks zijn objectieve voordelen heeft het SAP BW-systeem één aanzienlijk nadeel: de hoge kosten voor opslag en verwerking van gegevens, wat vooral merkbaar is bij het gebruik van de cloudversie van SAP BW on HANA.
Wat als we in plaats van een SAP-oplossing beginnen met een non-SAP en bij voorkeur open source product? Bij X5 Retail Group hebben we gekozen voor GreenPlum. Dit lost natuurlijk het kostenprobleem op, maar er komen meteen vragen op die bij het gebruik van SAP BW praktisch standaard waren opgelost.
Hoe halen we gegevens uit de bronsystemen, die voor het overgrote deel SAP-oplossingen zijn?
‘HR-metrics’ werd het eerste project waarin we dit probleem moesten oplossen. Ons doel was het creëren van een opslagplaats voor HR-gegevens en het opstellen van analytische rapportages over het personeel. De belangrijkste gegevensbron is het transactionele systeem van SAP HCM, waarin alle personeels-, organisatie- en salarisactiviteiten worden vastgelegd.
Gegevensextractie
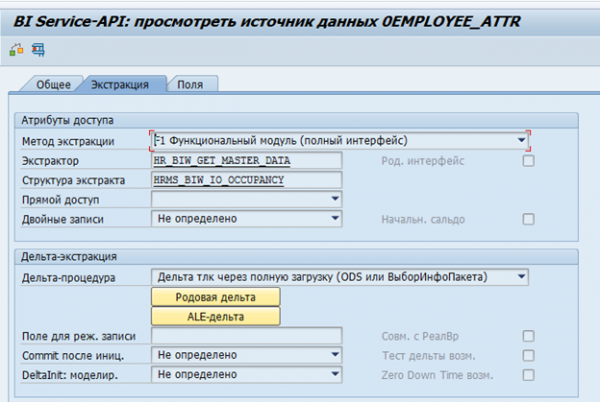
In SAP BW zijn er standaard gegevensextractoren voor SAP-systemen. Deze extractoren kunnen automatisch de benodigde gegevens verzamelen, de integriteit ervan controleren en de veranderingen in delta's bepalen. Bijvoorbeeld, de standaard gegevensbron voor de attributen van een werknemer is 0EMPLOYEE_ATTR:
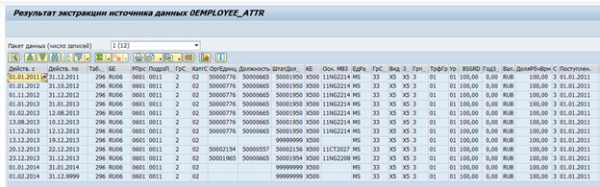
Het resultaat van de gegevensextractie voor één werknemer:
Indien nodig kan zo'n extractor worden aangepast aan specifieke vereisten of kan er een eigen extractor worden ontwikkeld.
De eerste idee was om de mogelijkheid voor hergebruik te overwegen. Helaas bleek dit een onuitvoerbare taak te zijn. Het grootste deel van de logica is aan de kant van SAP BW gerealiseerd, en het bleek niet mogelijk om de extractor aan de bron zonder problemen van SAP BW te scheiden.
Het werd duidelijk dat we een eigen mechanisme voor gegevensextractie uit SAP-systemen moesten ontwikkelen.
De structuur van gegevensopslag in SAP HCM
Om de vereisten voor een dergelijk mechanisme te begrijpen, moeten we eerst bepalen welke gegevens we precies nodig hebben.
De meeste gegevens in SAP HCM worden opgeslagen in platte SQL-tabellen. Op basis van deze gegevens visualiseren SAP-applicaties de organisatiestructuren, medewerkers en andere HR-informatie voor de gebruiker. Bijvoorbeeld, zo ziet de organisatiestructuur eruit in SAP HCM:
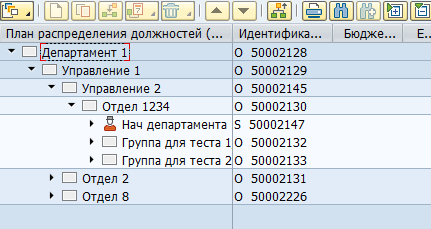
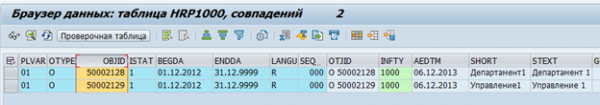
Fysiek wordt zo'n hiërarchie opgeslagen in twee tabellen — in hrp1000 de objecten en in hrp1001 de relaties tussen deze objecten.
Objecten 'Afdeling 1' en 'Management 1':
Relatie tussen objecten:
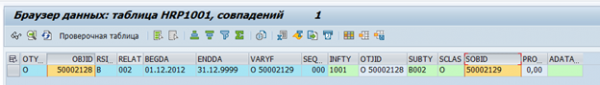
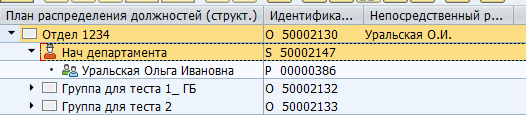
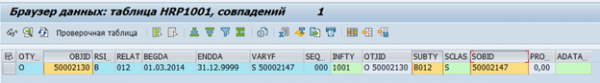
Er kunnen een enorm aantal typen objecten en typen relaties tussen hen zijn. Er bestaan zowel standaardrelaties tussen objecten als gepersonaliseerde voor specifieke behoeften. Bijvoorbeeld, de standaardrelatie B012 tussen de organisatie-eenheid en de functie geeft aan wie de leidinggevende van de afdeling is.
Weergave van de leidinggevende in SAP:
Opslag in de database tabel:
Gegevens over medewerkers worden opgeslagen in tabellen pa*. Bijvoorbeeld, gegevens over personeelsactiviteiten van een medewerker worden opgeslagen in tabel pa0000.
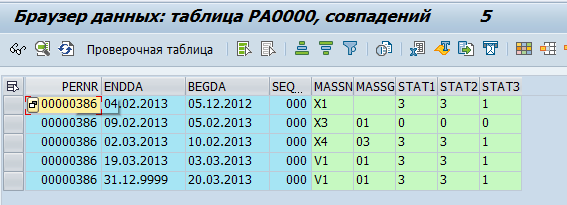
We hebben besloten dat GreenPlum de 'ruwe' gegevens zal ophalen, dat wil zeggen ze simpelweg zal kopiëren uit de SAP-tabellen. En vervolgens in GreenPlum zullen ze worden verwerkt en omgevormd tot fysieke objecten (bijvoorbeeld Afdeling of Medewerker) en metrics (bijvoorbeeld gemiddelde personeelssterkte).
Er waren ongeveer 70 tabellen gedefinieerd waarvan de gegevens naar GreenPlum overgebracht moesten worden. Daarna zijn we begonnen met het ontwikkelen van een manier om deze gegevens over te dragen.
SAP biedt een vrij groot aantal integratiemechanismen. Maar de eenvoudigste manier - directe toegang tot de database is verboden vanwege licentiebeperkingen. Daarom moeten alle integratiestromen worden gerealiseerd op het niveau van de server toepassingen.
Een volgend probleem was het ontbreken van gegevens over verwijderde records in de SAP-database. Wanneer een rij in de database wordt verwijderd, wordt deze fysiek verwijderd. Dat wil zeggen, het maken van een delta van veranderingen op basis van het tijdstip van wijziging was niet mogelijk.
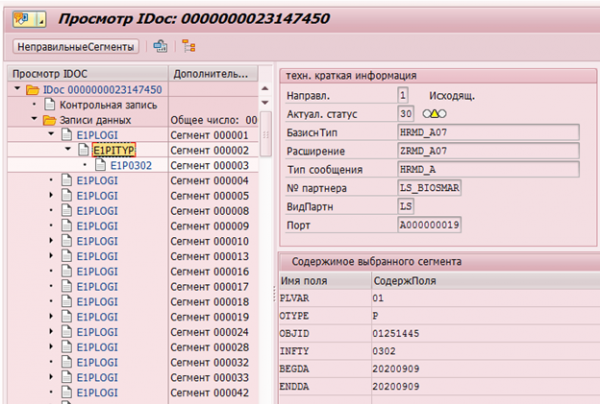
Natuurlijk zijn er in SAP HCM mechanismen voor het vastleggen van wijzigingen in gegevens. Bijvoorbeeld, voor latere overdracht naar ontvangende systemen zijn er wijzigingswijzers (change pointers), die alle wijzigingen vastlegden en op basis waarvan Idoc's (objecten voor overdracht naar externe systemen) worden gegenereerd.
Voorbeeld van een IDoc-wijziging van infotype 0302 voor een werknemer met personeelsnummer 1251445:
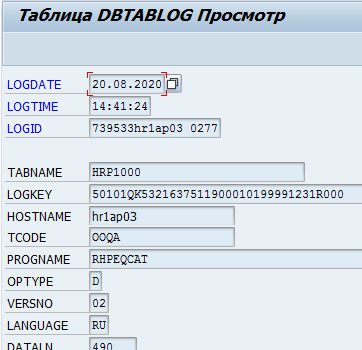
Of het bijhouden van logboeken van gegevenswijzigingen in de tabel DBTABLOG.
Voorbeeld van een logboek voor het verwijderen van een record met sleutel QK53216375 uit de tabel hrp1000:
Maar deze mechanismen zijn niet voor alle benodigde gegevens beschikbaar en hun verwerking op niveau van de applicatieserver kan behoorlijk wat middelen verbruiken. Daarom kan massale inschakeling van logging op alle benodigde tabellen leiden tot merkbare degradatie van de systeemprestaties.
Een volgend ernstig probleem waren de cluster tabellen. De gegevens over tijdschatting en salarisberekening in de RDBMS-versie van SAP HCM worden opgeslagen als een reeks logische tabellen voor elke werknemer voor elke berekening. Deze logische tabellen worden als binaire gegevens in de tabel pcl2 opgeslagen.
Cluster voor salarisberekening:
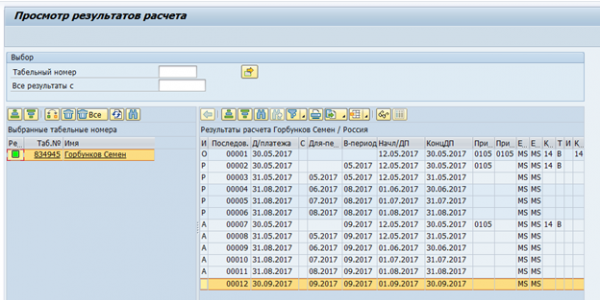
Gegevens uit cluster tabellen kunnen niet worden gelezen met een SQL-opdracht, maar vereisen het gebruik van macro-opdrachten in SAP HCM of speciale functionele modules. Dienovereenkomstig zal de leessnelheid van dergelijke tabellen vrij laag zijn. Aan de andere kant worden in dergelijke clusters gegevens opgeslagen die slechts één keer per maand nodig zijn – de definitieve salarisberekening en tijdschatting. Dus de snelheid is in dit geval niet zo cruciaal.
Bij het evalueren van opties voor het creëren van een delta voor gegevenswijzigingen, werd ook de optie van een volledige export overwogen. De optie om dagelijks gigabytes onveranderde gegevens tussen systemen te verzenden ziet er niet zo goed uit. Maar het heeft ook een aantal voordelen – er is geen noodzaak voor het implementeren van de delta aan de zijde van de bron, noch voor de implementatie van deze delta aan de kant van de ontvanger. Dit vermindert de kosten en tijd van implementatie en verhoogt de betrouwbaarheid van de integratie. Hierbij werd vastgesteld dat bijna alle wijzigingen in SAP HR plaatsvinden binnen een periode van drie maanden tot de huidige datum. Daarom werd besloten om dagelijks een volledige export van gegevens uit SAP HR te doen voor N maanden tot de huidige datum en een maandelijkse volledige export. De parameter N varieert afhankelijk van de specifieke tabel.
en varieert van 1 tot 15.
Voor de extractie van gegevens werd het volgende schema voorgesteld:
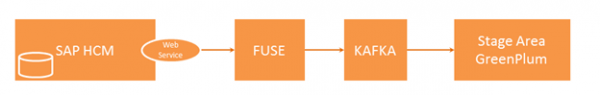
Het externe systeem genereert een verzoek en stuurt dit naar SAP HCM. Daar wordt het verzoek gecontroleerd op volledigheid van gegevens en bevoegdheden om toegang te krijgen tot de tabellen. Bij een succesvolle controle voert SAP HCM een programma uit dat de benodigde gegevens verzamelt en deze doorgeeft aan de integratieoplossing Fuse. Fuse bepaalt het benodigde onderwerp in Kafka en stuurt de gegevens daarheen. Vervolgens worden de gegevens uit Kafka doorgegeven aan de Stage Area GP.
In deze keten zijn we geïnteresseerd in de vraag van het extraheren van gegevens uit SAP HCM. Laten we hier nader op ingaan.
Schema van interactie tussen SAP HCM en FUSE.
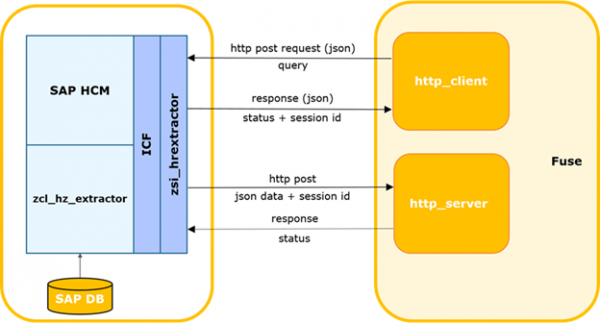
Het externe systeem bepaalt het tijdstip van de laatste succesvolle aanvraag in SAP.
Het proces kan worden gestart op een timer of een ander evenement. Ook kan er een timeout worden ingesteld voor het wachten op een gegevensrespons van SAP, wat het initiëren van een herhaald verzoek met zich meebrengt. Daarna wordt er een delta-verzoek gegenereerd en naar SAP gestuurd.
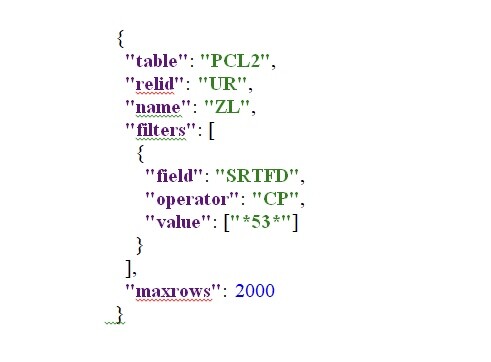
De gegevens van het verzoek worden in de body doorgegeven in json-formaat.
HTTP-methode: POST.
Voorbeeldvraag:
De SAP-service voert een controle van het verzoek uit op volledigheid, overeenstemming met de huidige SAP-structuur en de aanwezigheid van toegang bevoegdheid tot de gevraagde tabel.
In geval van fouten retourneert de service een antwoord met de bijbehorende code en beschrijving. Bij een succesvolle controle creëert deze een achtergrondproces voor de selectie, genereert en retourneert het synchronisch een unieke sessie-id.
Het externe systeem registreert een fout in het logboek. Bij een succesvolle respons wordt de sessie-id en de naam van de tabel waarvoor het verzoek is gedaan, doorgegeven.
Het externe systeem registreert de huidige sessie als open. Als er andere sessies zijn voor deze tabel, worden ze gesloten met een waarschuwing in het logboek.
De achtergrondtaak van SAP vormt een cursor op basis van opgegeven parameters en een gegevenspakket van bepaalde grootte. De grootte van het pakket is het maximale aantal records dat het proces uit de database leest. Standaard is dit gelijk aan 2000. Als er meer records in de database zijn dan de gebruikte pakketgrootte, wordt na de overdracht van het eerste pakket het volgende blok gevormd met de bijbehorende offset en een incrementeel pakketnummer. De nummers worden met 1 verhoogd en strikt opeenvolgend verzonden.
Vervolgens stuurt SAP een pakket naar de webservice van het externe systeem. Dit systeem voert controles uit op het binnenkomende pakket. Er moet een sessie zijn geregistreerd met de ontvangen id en deze moet zich in een open status bevinden. Als het pakketnummer > 1, moet het systeem een succesvolle ontvangst van het vorige pakket (package_id-1) hebben geregistreerd.
Bij een succesvolle controle parseert en slaat het externe systeem de gegevens in de tabel op.
Bovendien, als het pakket de vlag 'final' bevat en de serialisatie succesvol is verlopen, wordt het integratiemodule op de hoogte gesteld van de succesvolle afsluiting van de sessie en het module update de status van de sessie.
In geval van een controle/parsingfout wordt de fout gelogd en worden de pakketten voor deze sessie door het externe systeem afgewezen.
Evenzo, in het omgekeerde geval, wanneer het externe systeem een fout retourneert, wordt deze gelogd en wordt de verzending van pakketten stopgezet.
Voor het opvragen van gegevens aan de SAP HCM-kant is een integratiedienst gerealiseerd. De dienst is gebaseerd op het ICF-framework (SAP Internet Communication Framework — ). Hiermee kunt u gegevens opvragen uit het SAP HCM-systeem volgens specifieke tabellen. Bij het samenstellen van de gegevensaanvraag kunt u een lijst van specifieke velden en filterparameters opgeven om de benodigde gegevens te verkrijgen. De implementatie van de dienst veronderstelt daarentegen geen enkele bedrijfslogica. Algoritmes voor het berekenen van de delta, aanvraagparameters, controle van integriteit, enz. worden ook aan de kant van het externe systeem geïmplementeerd.
Dit mechanisme maakt het mogelijk om alle benodigde gegevens in enkele uren te verzamelen en door te geven. Deze snelheid ligt op de grens van acceptabel, daarom beschouwen wij deze oplossing als tijdelijk en hebben we deze gebruikt om te voldoen aan de behoefte aan een extractietool voor het project.
In het doelbeeld voor de extractietaak worden mogelijkheden voor het gebruik van CDC-systemen zoals Oracle Golden Gate of ETL-tools zoals SAP DS onderzocht.
Bron: habr.com
