

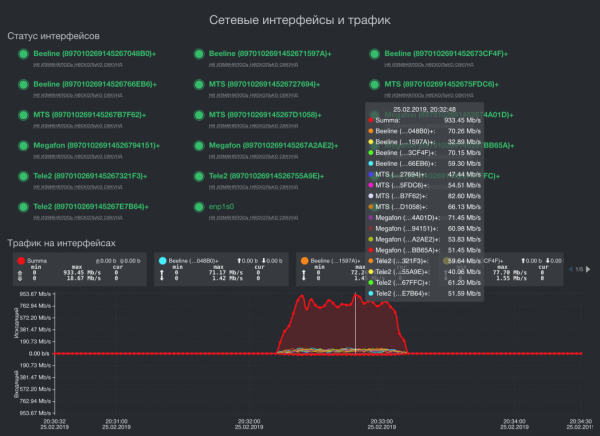
16 modems, 4 mobiele operators = Uitgaande snelheid 933,45 Mbit/s
Inleiding
Hallo! Dit is een artikel over hoe we onszelf een nieuw monitoring systeem hebben geschreven. Het verschilt van de bestaande systemen doordat het de mogelijkheid biedt voor hoogfrequente synchronisatie van metriekgegevens en een zeer laag verbruik van middelen. De pollfrequentie kan 0,1 milliseconde bereiken met een synchronisatieprecisie tussen de metriek van 10 nanoseconden. Alle binaire bestanden nemen 6 megabyte in beslag.
Over het project
We hebben een vrij specifiek product. We produceren een geïntegreerde oplossing voor het samenvoegen van bandbreedte en fouttolerantie van datatransmissiekanalen. Dit is wanneer er meerdere kanalen zijn, bijvoorbeeld Operator1 (40Mbit/s) + Operator2 (30Mbit/s) + Iets anders (5 Mbit/s), resulterend in één stabiel en snel kanaal, waarvan de snelheid ongeveer als volgt zal zijn: (40+30+5)x0,92=75×0,92=69 Mbit/s.
Dergelijke oplossingen zijn gewild waar de capaciteit van elk afzonderlijk kanaal onvoldoende is. Bijvoorbeeld in transport, bewakingssystemen en realtime streaming van video's, live uitzendingen van televisie- en radio-uitzendingen, elke landelijke locatie waar alleen vertegenwoordigers van de grote vier telecommunicatiebedrijven zijn en de snelheid op één modem/kanaal onvoldoende is.
Voor elk van deze richtingen brengen we een aparte lijn van apparaten uit, maar de softwarecomponent is bijna identiek en een kwaliteitsmonitoringsysteem is een van de belangrijkste modules. Zonder de juiste implementatie daarvan zou het product onmogelijk zijn.
In de loop van de jaren zijn we erin geslaagd een meerlaagse, snelle, cross-platform en lichtgewicht monitoring systeem te creëren. Dit willen we graag delen met de gewaardeerde gemeenschap.
Taakstelling
Het monitoring systeem zorgt voor het verkrijgen van metriekgegevens van twee fundamenteel verschillende klassen: realtime metriek en alle andere. Het monitoringsysteem had slechts de volgende vereisten:
- Hoogfrequente synchronisatie van realtime metriek en overdracht naar het communicatiebeheersysteem zonder vertraging.
Een hoge frequentie en synchronisatie van verschillende metrics is niet alleen belangrijk, maar absoluut noodzakelijk voor de analyse van de entropie van datatransmissiekanalen. Als de gemiddelde vertraging in één datatransmissiekanaal 30 milliseconden bedraagt, zal een synchronisatiefout van slechts één milliseconde tussen de overige metrics leiden tot een snelheidsdegradatie van ongeveer 5% van het resultaatkanaal. Als we de synchronisatie in 4 kanalen met 1 milliseconde missen, kan de snelheid gemakkelijk met 30% verminderen. Bovendien verandert de entropie in de kanalen zeer snel, dus als deze minder vaak dan eens in de 0,5 milliseconde wordt gemeten, zullen we bij snelle kanalen met lage vertraging een hoge snelheidsdegradatie tegenkomen. Uiteraard is een dergelijke precisie niet voor alle metrics en niet onder alle omstandigheden nodig. Wanneer de vertraging in een kanaal 500 milliseconden is, en we werken ook met dergelijke, is een fout van 1 milliseconde vrijwel onopgemerkt. Eveneens volstaat voor de metrics van vitale systemen een polling- en synchronisatiefrequentie van 2 seconden, maar het monitoringsysteem zelf moet in staat zijn om met zeer hoge pollingfrequenties en uiterst nauwkeurige metricsynchronisatie te werken. - Minimale middelen en een uniforme stack.
Het eindapparaat kan zowel een krachtige boordcomputer zijn die de situatie op de weg analyseert of biometrische gegevens van mensen vastlegt, als een single-board computer ter grootte van een hand die een speciale eenheid onder een kogelwerend vest draagt om real-time video door te geven onder slechte verbindingseisen. Ondanks deze verscheidenheid aan architecturen en rekencapaciteiten willen wij een uniforme softwarestack hebben. - Umbrella-architectuur
Metrics moeten verzameld en geaggregeerd worden op het eindapparaat, met een lokaal opslagsysteem en visualisatie in real-time en retrospectief. Bij aanwezigheid van een verbinding moeten de gegevens naar het centrale monitoring systeem worden verzonden. Wanneer er geen verbinding is, moet de verzendwachtrij zich ophopen en geen RAM gebruiken. - API voor integratie in het monitoring systeem van de klant, omdat niemand behoefte heeft aan meerdere monitoring systemen. De klant moet gegevens van alle apparaten en netwerken in één monitoringsysteem verzamelen.
Wat we hebben verkregen
Om de al uitgebreide longread niet te belasten, zal ik geen voorbeelden en metingen van alle monitoringsystemen geven. Dat zou een extra artikel vereisen. Ik zal gewoon zeggen dat we geen monitoringsysteem konden vinden dat in staat is om twee metrics tegelijkertijd te meten met een foutmarge van minder dan 1 milliseconde, en dat zowel op ARM-architectuur met 64 MB RAM als op x86_64-architectuur met 32 GB RAM even effectief werkt. Daarom hebben we besloten om de onze te schrijven, die in staat is om dit alles te doen. Dit is wat we hebben bereikt:
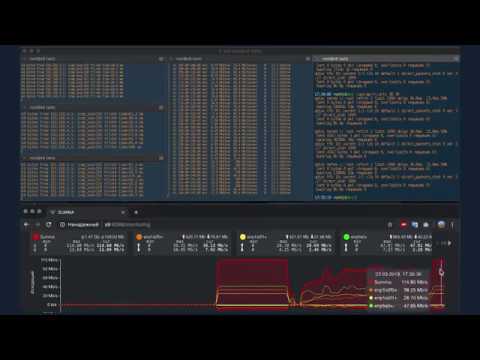
Som van de bandbreedte van drie kanalen voor verschillende netwerktopologieën
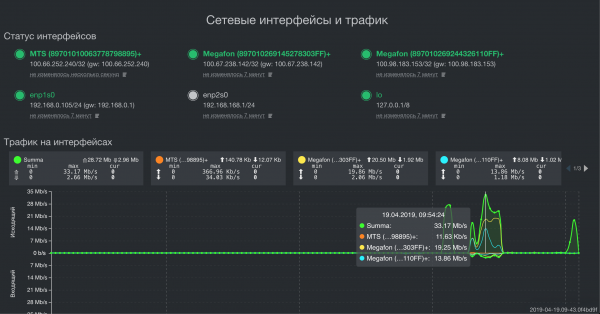
Visualisatie van enkele belangrijke metrics
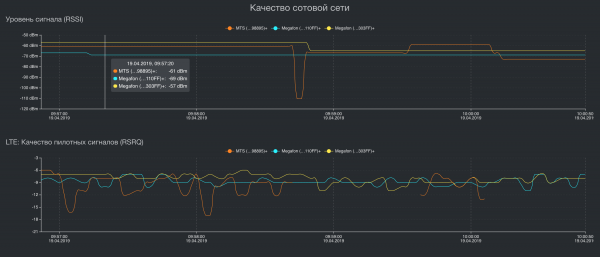
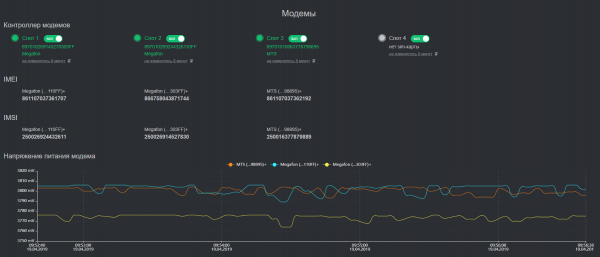
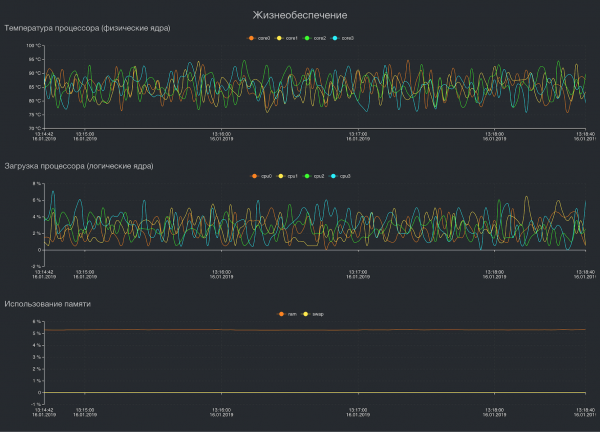
Architectuur
Als primaire programmeertaal, zowel op het apparaat als in de datacenters, gebruiken we Golang. Het heeft ons leven aanzienlijk vereenvoudigd door de implementatie van multitasking en de mogelijkheid om één statisch gelinkte uitvoerbare binaire bestand voor elke service te genereren. Hierdoor besparen we aanzienlijk op middelen, methoden en dataverkeer bij de deployment van services naar eindapparaten, en ook op ontwikkel- en debugtijd van de code.
Het systeem is gerealiseerd op basis van het klassieke modulaire principe en bevat verschillende subsysteemcomponenten:
- Registratie van metrics.
Elke metric wordt beheerd door een eigen thread en wordt gesynchroniseerd via kanalen. We hebben een synchronisatieprecisie van tot 10 nanoseconden weten te bereiken. - Opslag van metrics
Wij stonden voor de keuze om onze eigen opslag voor tijdreeksen te schrijven of iets bestaands te gebruiken. De database is nodig voor retrospectieve gegevens die voor latere visualisatie moeten worden gebruikt. Dat wil zeggen, er zijn geen gegevens over vertragingen in het kanaal elke 0,5 milliseconden of foutmeldingen in het transportsysteem, maar er is snelheid op elke interface elke 500 milliseconden. Naast de hoge eisen voor cross-platform compatibiliteit en laag verbruik van middelen, is het voor ons van cruciaal belang om de gegevens daar te kunnen verwerken waar ze worden opgeslagen. Dit bespaart enorm op rekenkracht. Sinds 2016 gebruiken we de database Tarantool in dit project en tot nu toe zien we geen vervanging daarvoor in de nabije toekomst. Flexibel, met een optimaal middelenverbruik en meer dan voldoende ondersteuning. Daarnaast heeft Tarantool een GIS-module. Deze is natuurlijk niet zo krachtig als PostGIS, maar voldoende voor onze behoeften bij het opslaan van enkele metriek verbonden aan locaties (relevant voor transport). - Visualisatie van metriek
Hier is alles relatief eenvoudig. We halen gegevens uit de opslag en tonen ze ofwel in realtime of retrospectief. - Synchronisatie van gegevens met het centrale monitoringsysteem.
Het centrale monitoringsysteem ontvangt gegevens van alle apparaten, slaat ze op met de opgegeven retrospectieve en geeft ze via API door aan het monitoringsysteem van de Klant. In tegenstelling tot klassieke monitoringsystemen, waarbij de 'centrale' gegevens verzamelt, hebben wij een omgekeerde opzet. Apparaten sturen zelf gegevens wanneer er verbinding is. Dit is een zeer belangrijk punt, omdat het mogelijk maakt om gegevens van het apparaat te verkrijgen voor de tijdsperiodes waarin het niet beschikbaar was en om kanalen en middelen niet te belasten op het moment dat het apparaat niet beschikbaar is. Als centrale monitoringsysteem gebruiken we de Influx-monitoringserver. In tegenstelling tot soortgelijke systemen kan deze retrospectieve gegevens importeren (dat wil zeggen, met een tijdstempel die verschilt van het moment van het ontvangen van de metriek). De verzamelde metriek wordt gevisualiseerd met een aangepaste versie van Grafana. Deze standaardstack is ook gekozen omdat hij kant-en-klare API-integraties heeft met vrijwel elk monitoringsysteem van de klant. - Synchronisatie van gegevens met het centrale apparaatbeheer systeem.
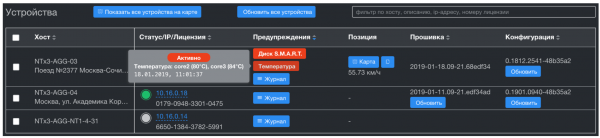
Het apparaatbeheersysteem implementeert Zero Touch Provisioning (firmware-updates, configuraties, enz.) en ontvangt in tegenstelling tot het monitoringssysteem alleen meldingen van problemen met apparaten. Dit zijn triggers voor de werking van interne hardware-bewakingsservices en alle metrics van de levensondersteunende systemen: temperatuur van de CPU en SSD, CPU-belasting, vrije ruimte en S.M.A.R.T. gezondheid van de schijven. De opslag van de subsysteem is ook gebouwd op Tarantool. Dit stelt ons in staat om aanzienlijke snelheid te behalen bij het aggregeren van tijdreeksen van duizenden apparaten, en lost volledig het probleem van gegevenssynchronisatie met deze apparaten op. Tarantool beschikt over een uitstekend queuesysteem en gegarandeerde levering. Deze belangrijke functie hebben we direct uit de doos gekregen, prachtig!
Netwerkbeheersysteem
Hier was eigenlijk een praktische sectie gepland met demonstratie van drie projecten op STM32 en STM8, speciaal voor dit artikel gemaakt met behulp van datasheets, met lampen, SPI, timers, PWM en interrupts:
Op dit moment is ons zwakste punt het centrale monitoringssysteem. Dit is voor 99,9% gerealiseerd op een standaard stack en heeft een aantal tekortkomingen:
- InfluxDB verliest gegevens bij stroomuitval. Gewoonlijk haalt de klant snel alles op wat van de apparaten komt en in de database zijn geen gegevens ouder dan 5 minuten, maar in de toekomst kan dit een probleem worden.
- Grafana heeft een aantal problemen met de aggregatie van gegevens en de synchroniciteit van hun weergave. Het meest voorkomende probleem is wanneer er een tijdreeks in de database staat met een interval van 2 seconden, beginnend vanaf bijvoorbeeld 00:00:00, maar Grafana begint gegevens te tonen in aggregatie met +1 seconde. Als resultaat ziet de gebruiker een onregelmatige grafiek.
- Overmatige hoeveelheid code voor API-integratie met externe monitoringsystemen. Dit kan veel compacter worden gemaakt en natuurlijk herschreven in Go :)
Ik neem aan dat jullie allemaal wel weten hoe Grafana eruitziet en haar problemen zonder mijn tussenkomst, daarom zal ik de post niet belasten met afbeeldingen.
Conclusie
Ik heb bewust ervoor gekozen om geen technische details te beschrijven, maar alleen het basisontwerp van dit systeem. Ten eerste, om het systeem technisch volledig te beschrijven, zou een ander artikel nodig zijn. Ten tweede zal dit niet voor iedereen interessant zijn. Laat in de comments weten welke technische details je graag zou willen weten.
Als iemand vragen heeft buiten dit artikel, kan je me bereiken op a.rodin @ qedr.com
Bron: habr.com
