

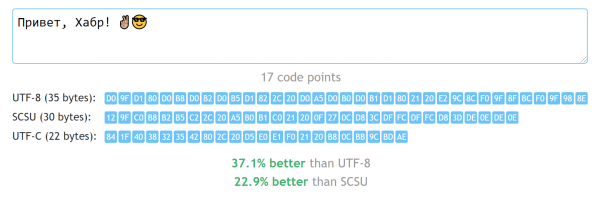
Als je een ontwikkelaar bent en de taak hebt om een codering te kiezen, is Unicode bijna altijd de juiste keuze. De specifieke manier van weergave hangt af van de context, maar meestal is er ook hier een universeel antwoord - UTF-8. Dit is goed omdat het alle Unicode-symbolen toestaat zonder te veel te verspillen. te veel bytes in de meeste gevallen. Voor talen die niet alleen het Latijnse alfabet gebruiken, betekent "niet te veel" echter minimaal twee bytes per teken. Is er een betere optie zonder terug te keren naar de prehistorische coderingen die ons beperken tot slechts 256 beschikbare symbolen?
Hieronder bied ik mijn poging aan om deze vraag te beantwoorden en een relatief eenvoudig algoritme te implementeren dat het mogelijk maakt om tekst in de meeste talen ter wereld op te slaan, zonder de overbodigheid die aanwezig is in UTF-8.
Disclaimer. Ik wil een paar belangrijke opmerkingen maken: de beschreven oplossing wordt niet gepresenteerd als een universele vervanging voor UTF-8, het is alleen geschikt voor een beperkte reeks gevallen (daarover hieronder) en het mag absoluut niet worden gebruikt voor interactie met externe API's (die er helemaal niet van op de hoogte zijn). Vaak zijn generieke compressie-algoritmes (bijvoorbeeld deflate) geschikter voor het compact opslaan van grote hoeveelheden tekstgegevens. Bovendien ontdekte ik tijdens het creëren van mijn oplossing een bestaande standaard binnen Unicode die hetzelfde probleem oplost - het is iets ingewikkelder (en vaak slechter), maar het is in ieder geval een geaccepteerde standaard en geen zelfgemaakte oplossing. Daarover zal ik ook vertellen.
Over Unicode en UTF-8
Laten we beginnen met een paar woorden over wat Unicode en UTF-8.
Zoals bekend, waren 8-bits coderingen vroeger populair. Het was eenvoudig: 256 symbolen kunnen genummerd worden van 0 tot 255, en de getallen van 0 tot 255 zijn uiteraard te representeren in één byte. Terugkerend naar de oorsprong, beperkt de ASCII-codering zich zelfs tot 7 bits, waardoor de meest significante bit in de byte-representatie nul is, en de meeste 8-bits coderingen compatibel zijn (ze verschillen alleen in het 'bovenste' gedeelte, waar de meest significante bit één is).
Wat zijn de verschillen tussen Unicode en die coderingen en waarom zijn er zoveel specifieke representaties - UTF-8, UTF-16 (BE en LE), UTF-32? Laten we het systematisch bekijken.
De belangrijkste Unicode-standaard beschrijft alleen de overeenstemming tussen tekens (en in sommige gevallen - afzonderlijke componenten van tekens) en hun nummers. En er zijn veel mogelijke nummers in deze standaard - van 0x00 tot 0x10FFFF (1 114 112 stuks). Als we een nummer in een dergelijk bereik in een variabele wilden plaatsen, zouden we met 1 of 2 bytes niet rondkomen. En omdat onze processors niet goed zijn ingericht voor de behandeling van driefnummers, zouden we 4 bytes per teken moeten gebruiken! Dit is wat UTF-32 is, maar juist vanwege deze 'verspilling' is dit formaat niet populair.
Gelukkig zijn de tekens binnen Unicode niet willekeurig geordend. Al deze elementen zijn verdeeld in 17 'vlakken', elk met 65536 (0x10000) «codepunten). Het begrip 'codepunt' hier is eenvoudigweg het nummer van een teken, dat door Unicode is toegewezen. Maar, zoals hierboven vermeld, zijn niet alleen afzonderlijke tekens in Unicode genummerd, maar ook hun componenten en uitvoeringsnotities (en soms komt er helemaal geen nummer aan te pas - misschien tijdelijk, maar dat is voor ons minder belangrijk). Daarom is het nauwkeuriger om altijd over het aantal nummers te praten, en niet over tekens. Echter, voor de kortheid zal ik hierna vaak het woord 'teken' gebruiken, waarmee ik de term 'codepunt' bedoel.
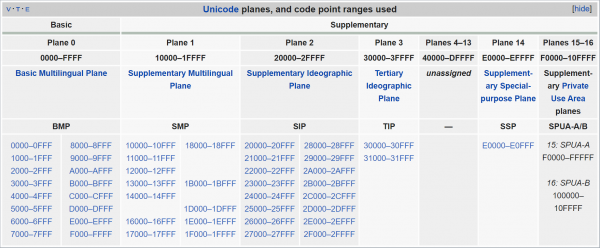
Unicode-vlakken. Zoals te zien is, is het merendeel (de vlakken van 4 tot 13) nog steeds niet in gebruik.
Het meest opmerkelijke is dat de gehele belangrijkste 'kern' zich in het nulvlak bevindt, dat de naam "Basic Multilingual Plane" draagt. Als een regel tekst in een van de moderne talen (inclusief het Chinees) bevat, kom je niet buiten dat vlak. Maar het is ook niet mogelijk om de rest van Unicode af te snijden - bijvoorbeeld, emoji's bevinden zich meestal aan het einde van het volgende vlak, "Supplementary Multilingual Plane" (dit strekt zich uit van 0x10000 tot 0x1FFFF). Daarom werkt UTF-16 als volgt: alle tekens die in Basic Multilingual Plane, worden gecodeerd 'zoals ze zijn', met het bijbehorende tweebitsgetal. Echter, sommige nummers in dit bereik vertegenwoordigen helemaal geen specifieke tekens, maar geven aan dat we na dit paar bytes nog een paar moeten overwegen - door de waarden van deze vier bytes samen te voegen, krijgen we een nummer dat het volledige toegestane bereik van Unicode omvat. Deze weergave wordt 'surrogaatparen' genoemd - mogelijk heeft u daar al van gehoord.
Zo vereist UTF-16 twee of (in zeer zeldzame gevallen) vier bytes voor één 'codepunt'. Dit is beter dan continu vier bytes te gebruiken, maar het Latijnse alfabet (en andere ASCII-tekens) verbruikt bij deze codering de helft van de ruimte aan nullen. UTF-8 is bedoeld om dit te verbeteren: ASCII neemt daarin, zoals voorheen, slechts één byte in beslag; codes van 0x80 tot 0x7FF — twee bytes; van 0x800 tot 0xFFFF — drie, en van 0x10000 tot 0x10FFFF — vier. Enerzijds gaat het goed met het Latijnse alfabet: de compatibiliteit met ASCII is teruggebracht, en de verdeling is meer gelijkmatig 'verspreid' van 1 tot 4 bytes. Maar alfabetten die anders zijn dan het Latijnse, profiteren helaas niet in vergelijking met UTF-16, en vele vereisen nu drie bytes in plaats van twee — het bereik dat door de tweebyte codering wordt gedekt, is 32 keer kleiner, van 0xFFFF tot 0x7FF, en het omvat nu geen Chinees meer, of bijvoorbeeld Georgisch. Voor het Cyrillische alfabet en nog vijf andere alfabetten is er gelukkig twee bytes per teken.
Waarom is dat zo? Laten we eens kijken hoe UTF-8 de codes van de tekens voorstelt:
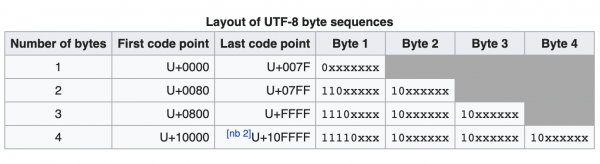
Direct voor de representatie van de getallen worden hier bits gebruikt, gemarkeerd met het teken x. Het is duidelijk dat er in de tweebyte codering slechts 11 van dergelijke bits (uit 16) zijn. De leidende bits vervullen hier alleen een functie voor beheer. In het geval van de vierbyte codering is er zelfs 21 bit gereserveerd voor het codepunt uit 32 — het lijkt erop dat drie bytes (die in totaal 24 bits geven) voldoende zouden zijn, maar de beheermarkers slokken te veel op.
Is dat slecht? Eigenlijk niet echt. Enerzijds — als we ons veel zorgen maken over de ruimte die beslagen wordt, hebben we compressie-algoritmes die gemakkelijk alle overbodige entropie en redundantie kunnen uitschakelen. Aan de andere kant was het doel van Unicode om de meest universele codering te geven. Bijvoorbeeld, een in UTF-8 gecodeerde string kunnen we toevertrouwen aan een code die voorheen alleen met ASCII werkte, en we hoeven niet bang te zijn dat het daar een teken uit het ASCII-bereik tegenkomt dat er eigenlijk niet is (want in UTF-8 zijn alle bytes die beginnen met de nulbit, inderdaad ASCII). En als we plotseling een klein staartje van een grote string willen afsnijden, zonder deze vanaf het begin te decoderen (of een deel van de informatie willen herstellen na een beschadigd stuk) — is het niet moeilijk om die offset te vinden waar een teken begint (het is genoeg om bytes over te slaan met een bitprefix 10).
Waarom dan iets nieuws uitvinden?
Tegelijkertijd zijn er af en toe situaties waarin compressie-algoritmen zoals deflate slecht toepasbaar zijn, maar je toch een compacte opslag van strings wilt bereiken. Persoonlijk heb ik met deze taak te maken gehad terwijl ik nadacht over de constructie voor een groot woordenboek dat woorden in willekeurige talen bevat. Enerzijds zijn de woorden heel kort, dus compressie is niet efficiënt. Anderzijds was de implementatie van de boom die ik overwoog, gericht op het feit dat elke byte van de opgeslagen string een aparte knoop in de boom genereerde, dus het minimaliseren van hun aantal was zeer nuttig. In mijn bibliotheek (net als in , waarop deze is gebaseerd) wordt een dergelijk probleem eenvoudig opgelost — strings verpakt in -woordenboek worden daar opgeslagen in . Maar zoals je gemakkelijk kunt begrijpen, werkt dit alleen goed voor een beperkte alfabet — een string in het Chinees kan je al niet meer in zo'n woordenboek plaatsen.
Daarnaast wil ik nog een vervelend nuancepunt opmerken dat zich voordoet bij het gebruik van UTF-8 in dergelijke datastructuren. Op de afbeelding hierboven is te zien dat bij het opslaan van een teken in de vorm van twee bytes, de bits die betrekking hebben op zijn nummer, niet aaneengeschakeld zijn, maar onderbroken door een paar bits 10 in het midden: 110xxxxx 10xxxxxx. Hierdoor, wanneer de lagere 6 bits van de tweede byte van de code van het teken overlopen (dat wil zeggen, er is een overgang 10111111 → 10000000), verandert ook de eerste byte. Het resultaat is dat de letter „п” wordt weergegeven door de bytes 0xD0 0xBF, en de volgende „р” — al door 0xD1 0x80. In de prefixboom leidt dit tot het splitsen van de ouderknop in twee — één voor het prefix 0xD0, en de andere voor 0xD1 (hoewel de hele Cyrillische tekst alleen met de tweede byte gecodeerd zou kunnen worden).
Wat ik heb bereikt
Toen ik met deze taak geconfronteerd werd, besloot ik om wat te experimenteren met bits, en tegelijkertijd mezelf iets beter te leren kennen met de Unicode-structuur in het algemeen. Het resultaat was het UTF-C coderingsformaat (de „C” staat voor compact), dat niet meer dan 3 bytes per codepunt verbruikt, en vaak slechts één extra byte vereist voor de hele gecodeerde string. Dit zorgt ervoor dat voor veel niet-ASCII alfabetten deze codering 30-60% compacter is dan UTF-8.
Ik heb voorbeelden van de implementatie van coderings- en decodering algoritmen gepresenteerd in de vorm van , u kunt ze vrij gebruiken in uw code. Maar ik wil toch benadrukken dat dit formaat in zekere zin een 'fiets' blijft, en ik raad aan het niet te gebruiken zonder te beseffen waarom u het nodig heeft. Het is tenslotte meer een experiment dan een serieuze 'verbetering van UTF-8'. Desondanks is de code daar netjes en beknopt geschreven, met veel commentaar en testdekking.
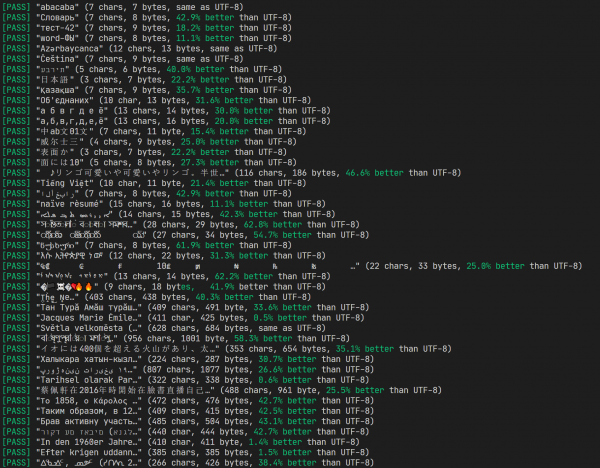
De resultaten van de tests en de vergelijking met UTF-8
Daarnaast heb ik , waar u de werking van het algoritme kunt beoordelen, en verder zal ik meer vertellen over de principes en het ontwikkelingsproces.
Overbodige bits verwijderen
Ik heb, natuurlijk, UTF-8 als basis genomen. Het eerste en meest voor de hand liggende dat je kunt veranderen, is het aantal controlebits in elke byte verminderen. Bijvoorbeeld, de eerste byte in UTF-8 begint altijd met 0, of met 11 — en het prefix 10 is alleen voor de volgende bytes. Laten we het prefix vervangen, 11 en een werkende opdracht krijgen. 1en bij de volgende bytes verwijderen we de prefixes helemaal. Wat krijgen we dan?
0xxxxxxx — 1 byte
10xxxxxx xxxxxxxx — 2 bytes
110xxxxx xxxxxxxx xxxxxxxx — 3 bytes
Stop, waar is de vierbyte notatie? Die is niet meer nodig — met de opschrijving over drie bytes hebben we nu 21 bits beschikbaar, en dat is ruim voldoende voor alle getallen tot 0x10FFFF.
Wat hebben we hier opgeofferd? Het belangrijkste is het ontdekken van de grenzen van symbolen vanuit een willekeurige plek in de buffer. We kunnen niet zomaar naar een willekeurige byte wijzen en vanaf daar het begin van het volgende symbool vinden. Dit is een beperking van ons formaat, maar in de praktijk komt de behoefte eraan niet vaak voor. Gewoonlijk zijn we in staat om de buffer vanaf het begin te doorlopen (vooral als het gaat om korte strings).
De situatie met de dekking van talen met 2 bytes is ook verbeterd: nu biedt het tweebyteformaat een bereik van 14 bits, wat codes tot 0x3FFF. De Chinezen hebben pech (hun hieroglyphen liggen voornamelijk in het bereik van 0x4E00 tot 0x9FFF), maar voor de Georgiërs en veel andere volkeren is het nu gemakkelijker — hun talen passen ook in 2 bytes per symbool.
We voeren de toestand van de encoder in
Laten we nu eens nadenken over de eigenschappen van de rijen zelf. In het woordenboek staan meestal woorden die met de symbolen van één alfabet zijn geschreven, en dat geldt ook voor veel andere teksten. Het zou goed zijn om dit alfabet een keer op te geven, en vervolgens alleen het nummer van de letter binnenin. Laten we bekijken of de indeling van de symbolen in de Unicode-tabel ons helpt.
Zoals hierboven vermeld, is Unicode verdeeld in vlakken per 65536 codes each. However, this division is not very useful (as mentioned, we are mostly in the zero plane). A more interesting division is into blocks. These ranges no longer have a fixed length and carry more meaning — as a rule, each combines characters from one alphabet.
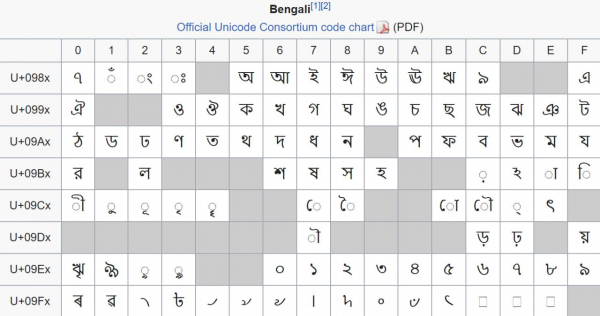
A block containing characters from the Bengali alphabet. Unfortunately, due to historical reasons, this is an example of not very dense packing — 96 characters are scattered chaotically across 128 code points of the block.
The beginnings of blocks and their sizes are always multiples of 16 — this is done simply for convenience. Additionally, many blocks start and end at values that are multiples of 128 or even 256 — for instance, the primary Cyrillic occupies 256 bytes from 0x0400 tot 0x04FF. This is quite convenient: if we save the prefix once 0x04, then any Cyrillic character can be recorded in a single byte. However, this means we lose the ability to revert to ASCII (and any other characters at all). Therefore, we do it like this:
- Two bytes
10yyyyyy yxxxxxxxnot only denote a character with numberyyyyyy yxxxxxxx, but also alter the current alphabet en een werkende opdracht krijgen.yyyyyy y0000000(i.e., we remember all bits except for the least significant ones, 7 bits.); - One byte
0xxxxxxxis a symbol from the current alphabet. It simply needs to be added to the offset we remembered in step 1. As long as we haven't changed the alphabet, the offset is zero, so we preserve compatibility with ASCII.
Similarly for codes that require 3 bytes:
- Three bytes
110yyyyy yxxxxxxx xxxxxxxxdenote a character with numberyyyyyy yxxxxxxx xxxxxxxx, change the current alphabet en een werkende opdracht krijgen.yyyyyy y0000000 00000000(we remembered everything except for the least significant ones, 15 bits), and set a flag that we are now in long mode (when switching the alphabet back to the two-byte one, we will reset this flag); - Two bytes
0xxxxxxx xxxxxxxxin long mode, this is a symbol from the current alphabet. Similarly, we add it to the offset from step 1. The only difference is that now we read two bytes (because we switched to that mode).
Sounds good: as long as we need to encode characters from the same 7-bit range of Unicode, we spend 1 extra byte at the start and only one byte per character.
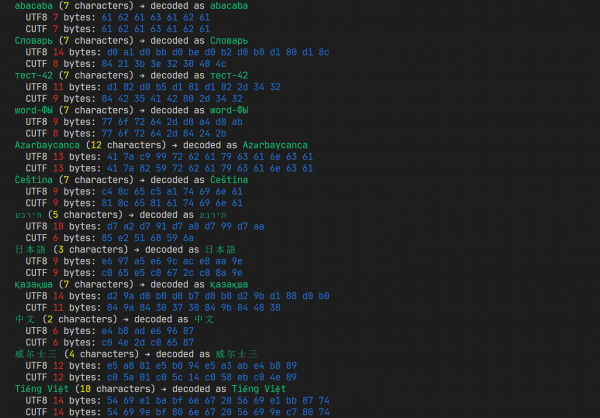
The work of one of the early versions. It already often surpasses UTF-8, but there's still room for improvement.
What has worsened? Firstly, we have acquired a state, namely the offset of the current alphabet and a flag for long mode.. Dit beperkt ons verder: nu kunnen dezelfde symbolen op verschillende manieren worden gecodeerd in verschillende contexten. Het zoeken naar substrings zal bijvoorbeeld rekening moeten houden met dit aspect, in plaats van alleen bytes te vergelijken. Ten tweede, zodra we het alfabet veranderden, ontstonden er problemen met de codering van ASCII-tekens (wat niet alleen het Latijnse alfabet is, maar ook basisinterpunctie, inclusief spaties) — ze vereisen een herhaalde verandering van het alfabet bij 0, dat wil zeggen opnieuw een extra byte (en dan nog een om terug te keren naar ons hoofdalfabet).
Één alfabet is goed, twee is beter
Laten we onze bitprefixen iets aanpassen door er nog één aan de drie hierboven beschreven toe te voegen:
0xxxxxxx — 1 byte in normale modus, 2 in lange modus
11xxxxxx — 1 byte
100xxxxx xxxxxxxx — 2 bytes
101xxxxx xxxxxxxx xxxxxxxx — 3 bytes
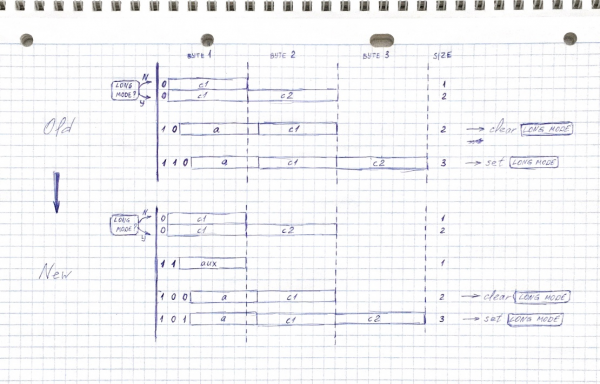
Nu is er in de tweebyte notatie één beschikbare bit minder — coderingstekens tot 0x1FFF, en niet 0x3FFF. Desondanks is dit nog steeds aanzienlijk meer dan bij de tweebyte codes van UTF-8, de meeste gangbare talen passen er nog steeds in, het meest opvallende verlies is de en , de Japanners zijn bedroefd.
Wat voor een nieuwe code 11xxxxxx? Это небольшой «загашник» размером в 64 символа, он дополняет наш основной алфавит, поэтому я назвал его вспомогательным (auxiliary) alfabet. Wanneer we het huidige alfabet wisselen, wordt een deel van het oude alfabet een hulpalfabet. Bijvoorbeeld, als we van ASCII op Cyrillisch schakelen — in de "schuilplaats" staan nu 64 symbolen, waaronder het Latijnse alfabet, cijfers, spatie en komma (de meest voorkomende invoegen in niet-ASCII teksten). Wanneer we terugschakelen naar ASCII — wordt een groot deel van het Cyrillische alfabet het hulpalfabet.
Dankzij de toegang tot twee alfabets, kunnen we omgaan met een grotere hoeveelheid teksten, met minimale kosten voor het schakelen van alfabetten (interpunctie zal meestal leiden tot terugkeer naar ASCII, maar daarna kunnen we veel niet-ASCII symbolen al uit het aanvullende alfabet halen, zonder opnieuw te schakelen).
Bonus: door het aanvullende alfabet een prefix te geven 11xxxxxx en de initiële verschuiving in te stellen op 0xC0, krijgen we gedeeltelijke compatibiliteit met CP1252. Met andere woorden, veel (maar niet allemaal) West-Europese teksten gecodeerd in CP1252 zullen er ook zo uitzien in UTF-C.
Hier ontstaat echter een moeilijkheid: hoe krijgen we het hulpalfabet uit het hoofdalfabet? We kunnen dezelfde verschuiving behouden, maar — helaas — hier speelt de Unicode-structuur tegen ons. Vaak bevindt het hoofddeel van het alfabet zich niet aan het begin van het blok (bijvoorbeeld, de Russische hoofdletter "А" heeft code 0x0410, hoewel het Cyrillische blok begint met 0x0400). Dus door de eerste 64 tekens in de ‘reserve’ te nemen, verliezen we mogelijk toegang tot het eindgedeelte van het alfabet.
Om dit probleem op te lossen, heb ik handmatig enkele blokken doorgenomen die overeenkomen met verschillende talen en heb ik de verschuiving van het hulpalfabet binnen het hoofdalfabet aangegeven. De Latijnse letters heb ik, als uitzondering, helemaal opnieuw gerangschikt, alsof het base64 is.
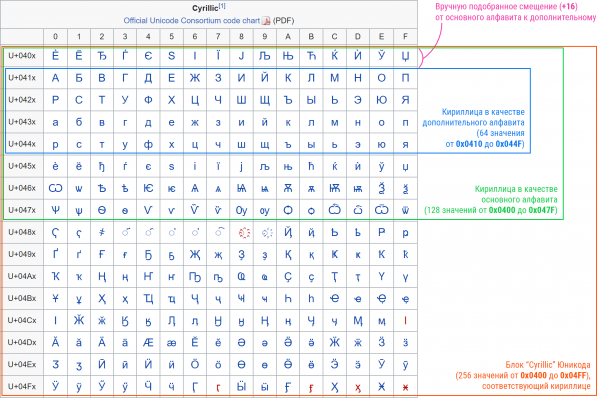
Laatste handtekeningen
Laten we tenslotte nadenken waar we nog iets kunnen verbeteren.
Laten we opmerken dat het formaat 101xxxxx xxxxxxxx xxxxxxxx in staat is om cijfers tot 0x1FFFFF, en Unicode eindigt eerder, op 0x10FFFF. Met andere woorden, het laatste codepunt zal worden weergegeven als 10110000 11111111 11111111. Dus kunnen we zeggen dat als de eerste byte eruitziet als 1011xxxx (waar xxxx groter is dan 0), dan betekent dit iets anders. Bijvoorbeeld, we kunnen daar nog eens 15 tekens aan toevoegen, die altijd beschikbaar zijn voor codering met één byte, maar ik heb besloten het anders te doen.
Laten we kijken naar de Unicode-blokken die nu drie bytes vereisen. Over het algemeen zijn dit, zoals al gezegd, Chinese karakters — maar daar is moeilijk iets mee te doen, ze zijn er 21.000. Daarnaast zijn er ook de hiragana en katakana — en die zijn er al veel minder, minder dan tweehonderd. En aangezien we de Japanners hebben genoemd — daar liggen ook emoji's (in werkelijkheid zijn ze overal verspreid in Unicode, maar de belangrijkste blokken zijn in het bereik 0x1F300 – 0x1FBFF). Als we denken aan het feit dat er nu emoji's bestaan die uit meerdere codepunten zijn samengesteld (bijvoorbeeld emoji bestaat uit maar liefst 7 codes!), dan is het droevig om voor elk daarvan drie bytes te besteden (7×3 = 21 bytes voor één teken, dat is echt problematisch).
Dus kiezen we enkele geselecteerde bereiken waar de emoji's, hiragana en katakana overeenkomen, hernummeren we deze in één continue lijst en coderen we deze in twee bytes in plaats van drie:
1011xxxx xxxxxxxx
Uitstekend: de eerder genoemde emoji , bestaande uit 7 codepunten, neemt in UTF-8 25 bytes in beslag, maar we hebben deze in gepast 14 laten we zeggen twee bytes per codepunt). Trouwens, Habr weigerde het te verwerken (zowel in de oude als in de nieuwe editor), dus ik moest het als afbeelding invoegen.
Laten we nog een probleem proberen op te lossen. Zoals we ons herinneren, is het hoofdalfabet in wezen de hogere 6 bits, die we in gedachten houden, en plakken aan de code van elk te decoderen symbool. In het geval van Chinese karakters, die zich in het blok bevinden 0x4E00 – 0x9FFF, is dit ofwel bit 0 of 1. Dit is niet erg handig: we moeten voortdurend het alfabet tussen deze twee waarden wisselen (dat wil zeggen, drie bytes verbruiken). Maar laten we opmerken dat we in de lange modus het aantal symbolen dat we coderen met behulp van de korte modus van de code kunnen aftrekken (na alle eerder genoemde trucs is dat 10240) — dan verschuift het bereik van de karakters naar 0x2600 – 0x77FF, en in dat geval zijn de hogere 6 bits (uit 21) in dit hele bereik gelijk aan 0. Op deze manier zullen de reeksen karakters twee bytes per karakter gebruiken (wat optimaal is voor zo'n groot bereik), zonder dat er alfabetswitches optreden.
Alternatieve oplossingen: SCSU, BOCU-1
Kenners van Unicode, die alleen de titel van het artikel hebben gelezen, zullen waarschijnlijk snel herinneren dat er binnen de Unicode-standaarden (SCSU) is, dat een methode voor codering beschrijft die veel lijkt op de in dit artikel beschreven.
Ik geef eerlijk toe: ik kwam pas diep in het schrijven van mijn oplossing achter het bestaan ervan. Als ik er vanaf het begin van had geweten, zou ik waarschijnlijk geprobeerd hebben een implementatie ervan te schrijven in plaats van mijn eigen benadering te verzinnen.
Het is interessant dat SCSU ideeën gebruikt die zeer vergelijkbaar zijn met de ideeën die ik zelf heb ontwikkeld (in plaats van het concept van ‘alfabetten’ worden ‘vensters’ gebruikt, en er zijn er meer beschikbaar dan bij mij). Tegelijkertijd heeft dit formaat ook nadelen: het ligt iets dichter bij compressie-algoritmes dan bij codering. In het bijzonder biedt de standaard veel representatiemethoden, maar zegt niet hoe je de optimale moet kiezen — daarvoor moet de encoder enige heuristieken toepassen. Daarom zal een SCSU-encoder die een goede compressie biedt, complexer en omvangrijker zijn dan mijn algoritme.
Ter vergelijking heb ik een relatief eenvoudige implementatie van SCSU naar JavaScript overgezet — qua codevolume blijkt het vergelijkbaar te zijn met mijn UTF-C, maar in een aantal gevallen toonde het resultaten die tientallen procenten slechter waren (soms kan het ook beter presteren, maar niet veel). Bijvoorbeeld, teksten in het Hebreeuws en Grieks codeerde UTF-C met maar liefst 60% beter dan SCSU (waarschijnlijk vanwege hun compacte alfabetten).
Daarnaast wil ik toevoegen dat er naast SCSU ook een andere manier van compacte weergave van Unicode bestaat — , maar deze richt zich op compatibiliteit met MIME (wat ik niet nodig had), en gebruikt een iets andere benadering van codering. Ik heb de efficiëntie ervan niet beoordeeld, maar ik denk niet dat deze hoger zal zijn dan die van SCSU.
Mogelijke aanpassingen
Het algoritme dat ik heb gepresenteerd is niet universeel by design (hierin verschillen mijn doelen waarschijnlijk het meest van die van de Unicode-consortium). Ik heb al vermeld dat het voornamelijk is ontwikkeld voor één taak (het opslaan van een meertalige woordenlijst in een prefixboom), en sommige van zijn kenmerken zijn misschien niet geschikt voor andere taken. Maar het feit dat het geen standaard is, kan ook een voordeel zijn — je kunt het gemakkelijk aanpassen aan je behoeften.
Bijvoorbeeld, je kunt eenvoudigweg het bestaan van status schrappen, de codering stateless maken — gewoon de variabelen niet bijwerken uitschakelen, auxOffs en is21Bit in de encoder en decoder. In dat geval is het niet mogelijk om reeksen van symbolen uit één alfabet efficiënt in te pakken, maar dat garandeert wel dat hetzelfde symbool altijd op dezelfde manier wordt gecodeerd, ongeacht de context.
Daarnaast kan de encoder worden afgestemd op een specifieke taal door de standaardstatus aan te passen — bijvoorbeeld, gericht op Russische teksten, de instellingen in het begin van de encoder en decoder vaststellen offs = 0x0400 en auxOffs = 0. Dit is vooral zinvol in de stateless modus. In het algemeen zal dit lijken op het gebruik van de oude 8-bits codering, maar het biedt nog steeds de mogelijkheid om symbolen uit de hele Unicode indien nodig in te voegen.
Een ander tekortkoming, eerder genoemd — in volumineuze tekst gecodeerd in UTF-C is er geen snelle manier om de grens van een symbool te vinden, dichtbij een willekeurig byte. Door de laatste, laten we zeggen, 100 bytes van de gecodeerde buffer af te snijden, loop je het risico onbruikbare data te krijgen waar je niets mee kunt. Voor het opslaan van meergigabyte logs is de codering niet geschikt, maar in het algemeen kan dit worden opgelost. Een byte 0xBF mag nooit als de eerste byte voorkomen (maar kan als de tweede of derde verschijnen). Daarom kan bij codering een reeks worden ingevoegd 0xBF 0xBF 0xBF Elke, laten we zeggen, 10 KB — dan is het bij behoefte om de grens te vinden voldoende om het geselecteerde stuk te scannen totdat een vergelijkbare marker wordt gevonden. Direct achter de laatste 0xBF zal het begin van het teken zijn. (Bij decodering moet deze reeks van drie bytes natuurlijk worden genegeerd.)
Samenvattend
Als je tot hier hebt gelezen — gefeliciteerd! Hopelijk heb je, net als ik, iets nieuws geleerd (of oude kennis opgefrist) over hoe Unicode werkt.
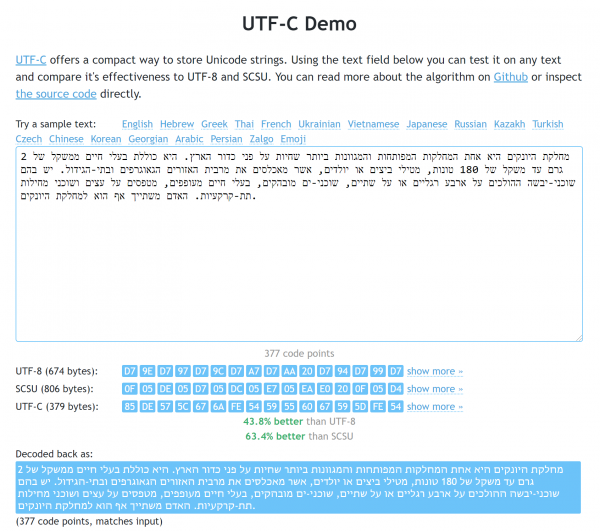
Demonstratiepagina. Aan de hand van het Hebreeuws zijn de voordelen ten opzichte van zowel UTF-8 als SCSU zichtbaar.
Je zou de bovengenoemde overpeinzingen niet moeten beschouwen als een inbreuk op de standaarden. Echter, over het algemeen ben ik tevreden met de resultaten van mijn werkzaamheden, dus ben ik blij om ze : bijvoorbeeld, de JS-bibliotheek in geminimaliseerde vorm weegt slechts 1710 bytes (en heeft uiteraard geen afhankelijkheden). Zoals ik eerder noemde, kun je het werken met deze bibliotheek bekijken op (daar is ook een set teksten waarmee je het kunt vergelijken met UTF-8 en SCSU).
Tot slot wil ik nog eens de aandacht vestigen op de gevallen waarin het gebruik van UTF-C niet aan te raden is:
- Als je strings lang genoeg zijn (meer dan 100-200 tekens). In dat geval moet je overwegen compressie-algoritmen zoals deflate toe te passen.
- Als je nodig hebt ASCII-transparantie, dat wil zeggen dat het belangrijk voor je is dat er in de gecodeerde reeksen geen ASCII-codes voorkomen die niet in de originele string zaten. Deze behoefte kan worden vermeden als je bij interactie met externe API's (bijvoorbeeld bij het werken met databases) de resultaat van de codering doorgeeft als een abstracte set bytes, en niet als strings. Anders loop je het risico onverwachte kwetsbaarheden te krijgen.
- Als je snel de grenzen van de tekens wilt vinden op een willekeurige offset (bijvoorbeeld, bij beschadiging van een deel van de string). Dit is mogelijk, maar alleen door de string vanaf het begin te scannen (of door de aanpassing toe te passen die in het vorige deel is beschreven).
- Als je snel bewerkingen op tekenreeksen wilt uitvoeren (deze sorteren, substring-zoeken, samenvoegen). Hiervoor moeten de tekenreeksen eerst worden gedecodeerd, waardoor UTF-C trager is dan UTF-8 in deze gevallen (maar sneller dan compressie-algoritmen). Aangezien dezelfde tekenreeks altijd op dezelfde manier wordt gecodeerd, vereist een exacte vergelijking van decodering geen, en kan het byte voor byte worden uitgevoerd.
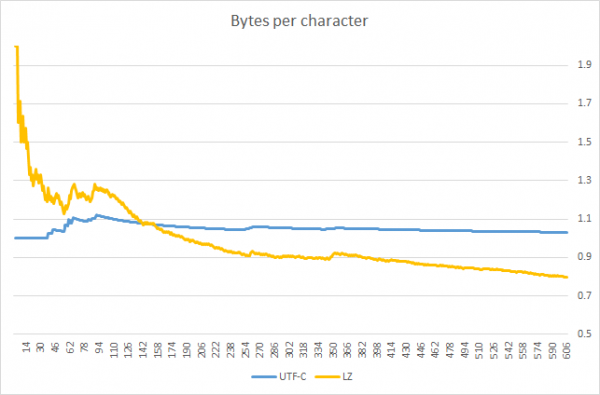
Update: gebruiker heb ik een grafiek gepost die de toepassingsgrens van UTF-C benadrukt. Hieruit blijkt dat UTF-C effectiever is dan algemeen compressie-algoritme (de varianten van LZW) zolang de te comprimeren tekenreeks korter is dan ~140 tekens (ik wil er wel op wijzen dat de vergelijking op één tekst is uitgevoerd; voor andere talen kan het resultaat verschillen).
Bron: habr.com
