

Laat me een technische geschiedenis vertellen.
Jaren geleden ontwikkelde ik een applicatie met ingebouwde samenwerkingsfunctionaliteiten. Het was een handige experimentele stack die het volledige potentieel van de vroege React en CouchDB gebruikte. Het synchroniseerde gegevens in real-time via JSON. . Het werd gebruikt voor het interne werk van het bedrijf, maar de brede toepasbaarheid en het potentieel in andere gebieden waren voor de hand liggend.
Toen we probeerden deze technologie aan potentiële klanten te verkopen, stuitten we op een onverwachte obstakel. In de demonstratievideo zag onze technologie er geweldig uit en werkte deze perfect, daar was geen twijfel over. De video toonde precies hoe het werkte, en er werd niets nagebootst. We bedachten en codeerden een realistisch gebruiksscenario voor de software.
In feite was dat het probleem. Onze demo werkte precies zoals alle andere applicaties die ze nagemaakt hadden. Concreet gezegd, informatie werd onmiddellijk van A naar B verzonden, zelfs als het grote media-bestanden waren. Na inloggen zagen alle gebruikers nieuwe berichten. Met de applicatie konden verschillende gebruikers helder samenwerken aan hetzelfde project, zelfs als de internetverbinding ergens in een dorp wegviel. Dit werd impliciet gesuggereerd in elk in After Effects gemonteerd productvideo.
Hoewel iedereen wist wat de Refresh-knop deed, begreep niemand echt dat de webapplicaties die ze vroegen ons te maken, vaak hun beperkingen hadden. En dat als ze ooit niet meer nodig zijn, de gebruikerservaring totaal anders zou zijn. Meestal merkten ze op dat ze konden 'chatten' en hun gesprekspartners notities konden achterlaten, dus vroegen ze zich af wat het verschil was met bijvoorbeeld Slack. Ugh!
Het ontwerp van dagelijkse synchronisaties
Als je al ervaring hebt met softwareontwikkeling, dan moet het je irriteren dat je moet onthouden dat de meeste mensen gewoon niet naar een afbeelding van de interface kunnen kijken en begrijpen wat het zal doen bij interactie. Laat staan wat er binnen de software zelf gebeurt. Weten wat kan gaat gebeuren, is voor een groot deel het resultaat van het weten wat er niet kan gebeuren en wat er niet zou moeten gebeuren. Dit vereist niet alleen wat de software doet, maar ook hoe de verschillende onderdelen met elkaar zijn afgestemd en communiceren.
Een klassiek voorbeeld hiervan is een gebruiker die twintig minuten naar spinner.gif, zich afvragend wanneer het werk eindelijk zal eindigen. De ontwikkelaar zou begrijpen dat het proces waarschijnlijk vastloopt en dat de gif nooit van het scherm zal verdwijnen. Deze animatie imiteert het uitvoeren van werkzaamheden, maar heeft geen verband met de staat ervan. In dergelijke gevallen zijn sommige techneuten geneigd om met hun ogen te rollen, verbaasd over de mate van misleiding bij gebruikers. Maar let op, wie van hen wijst naar de draaiende klok en zegt dat deze eigenlijk stil staat?
Dit is de essentie van de waarde van realtime. Tegenwoordig worden databases in realtime nog steeds zeer beperkt gebruikt, en velen staan er met wantrouwen tegenover. De meeste van deze databases neigen naar een NoSQL-stijl, waardoor oplossingen op basis van Mongo vaak worden gebruikt, waarvan het beter is ze te vergeten. Maar voor mij betekent dit dat ik comfortabel kan werken met CouchDB, en ook het ontwerp van structuren kan bestuderen die niet alleen door een bureaucratische figuur met gegevens kunnen worden gevuld. Ik denk dat ik mijn tijd efficiënter besteed.
Maar het werkelijke onderwerp van deze post is wat ik vandaag gebruik. Niet uit keuze, maar door een onverschillig en blind toegepaste bedrijfsbeleid. Daarom zal ik een Volledig Eerlijke en Onpartijdige vergelijking geven van twee nauw verwante producten voor het werken met databases in realtime van Google.
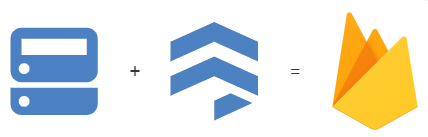
Beide hebben het woord Fire in hun namen. De ene herinner ik met genegenheid. De andere is voor mij een ander soort vuur. Ik haast me niet om hun namen te noemen, want zodra ik dat doe, komen we bij het eerste grote probleem - de namen.
De eerste heet Firebase Real-Time Database, en de tweede is Firebase Cloud Firestore. Beide zijn producten van de Firebase suite Google. Hun API’s heten respectievelijk firebase.database(…) en firebase.firestore(…).
Dit is ontstaan omdat Real-Time Database gewoon de oorspronkelijke Firebase voor het werd overgenomen door Google in 2014. Vervolgens besloot Google een parallel product te creëren dat een kopie van Firebase op basis van big data van het bedrijf is, en noemde het Firestore met een cloud. Ik hoop dat je nog niet in de war bent. Als je toch in de war bent, maak je geen zorgen, ik heb dit deel van het artikel zelf tien keer herschreven.
Omdat het nodig is om aan te geven Firebase met betrekking tot Firebase, en Firestore met betrekking tot Firebase, tenminste om je te laten begrijpen enkele jaren geleden op Stack Overflow.
Als er een prijs was voor de slechtste naamgeving van softwareproducten, dan zou dit geval zeker een van de kandidaten zijn. De Hamming-afstand tussen deze namen is zo klein dat zelfs ervaren ingenieurs in de war raken, die de ene naam typen terwijl hun hoofd aan iets anders denkt. Dit zijn de falende plannen, bedacht met de beste bedoelingen; zij vervulden de profetie dat de database in brand zou staan. En ik maak geen grapje. Degene die deze naamgevingsschema bedacht, was de oorzaak van bloed, zweet en tranen.
Pyrrhusoverwinning
Je zou kunnen denken dat Firestore een vervanging is van Firebase, zijn nakomeling van de volgende generatie, maar dat zou een misvatting zijn. Firestore is zeker niet geschikt als vervanging voor Firebase. Het lijkt alsof iemand al het interessante eruit heeft gehaald en een groot deel van het overblijvende op verschillende manieren verwarrend heeft gemaakt.
Echter, een snelle blik op de twee producten kan je in de war brengen: het lijkt alsof ze hetzelfde doen, via grotendeels dezelfde API en zelfs in dezelfde databasesessie. De verschillen zijn subtiel en worden alleen ontdekt bij een grondige vergelijkende studie van de uitgebreide documentatie. Of wanneer je probeert perfect werkende code van Firebase te porteren zodat deze met Firestore werkt. Zelfs dan ontdek je dat de database-interface opflikkert zodra je probeert een muis-drag-in-real-time uit te voeren. Nogmaals, ik maak geen grapje.
De Firebase-client is beleefd in de zin dat hij wijzigingen buffert en automatisch opnieuw probeert bij updates, waarbij de laatste schrijfoperatie prioriteit krijgt. Firestore heeft echter een limiet van 1 schrijfoperatie per document per gebruiker per seconde, en deze limiet wordt door de server opgelegd. Bij het werken ermee moet je zelf een manier vinden om deze te omzeilen en een snelheid-beperker voor updates te implementeren, zelfs wanneer je gewoon je applicatie probeert te bouwen. Dat wil zeggen, Firestore is een realtime-database zonder realtime-client, die zich voordoet als een met behulp van de API.
Hier beginnen we de eerste tekenen van de zin van het bestaan van Firestore te zien. Misschien heb ik het mis, maar ik vermoed dat iemand hoog in het management van Google na de aankoop van Firebase gewoon zei: ‘Nee, oh mijn god, nee. Dit is onaanvaardbaar. Niet onder mijn leiding.’
Hij kwam uit zijn vertrekken en verkondigde:
‘Eén groot JSON-document? Nee. Je moet de gegevens opsplitsen in afzonderlijke documenten, elk met een maximale grootte van 1 megabyte.’
Het lijkt erop dat deze beperking de eerste schok met een voldoende gemotiveerde gebruikersbasis niet zal overleven. Je weet dat dit waar is. Op ons werk hebben we bijvoorbeeld meer dan duizend presentaties, en dat is volkomen normaal.
Met zo'n beperking moet je accepteren dat één ‘document’ in de database niet lijkt op enig object dat een gebruiker een document zou noemen.
‘Arrays van arrays, die andere elementen recursief kunnen bevatten? Nee. Arrays zullen alleen objecten of getallen van vaste lengte bevatten, zoals bedoeld door de Heer.’
Dus als je hoopt GeoJSON in je Firestore te plaatsen, zul je ontdekken dat dit niet mogelijk is. Niets meer-dimensionaals is toegestaan. Ik hoop dat je houdt van Base64 en/of JSON binnen JSON.
‘Importeren en exporteren van JSON via HTTP, commandoregeltools of de beheerderspaneel? Nee. Je kunt alleen gegevens importeren en exporteren via Google Cloud Storage. Het lijkt er nu op dat het zo heet. En wanneer ik ‘je’ zeg, richt ik me alleen tot diegenen die de bevoegdheid hebben van Project Owner. Iedereen anderen kan gewoon tickets aanmaken.’
Zoals je ziet, is het eenvoudig om het datamodel van FireBase te beschrijven. Het bevat één enorm JSON-document dat JSON-sleutels verbindt met URL-paden. Als je het volgende schrijft met HTTP PUT in / FireBase:
{
  "hello": "world"
}
Dan GET /hello zal retourneren "world". In wezen werkt het precies zoals je verwacht. De verzameling objecten van FireBase /my-collection/:id is gelijk aan een JSON-woordenboek {"my-collection": {...}} in de root, waarvan de inhoud toegankelijk is via /my-collection:
{
  "id1": {...object},
  "id2": {...object},
  "id3": {...object},
  // ...
}
Het werkt uitstekend, zolang elke invoer een ID heeft zonder conflicten, waarvoor het systeem een standaardoplossing biedt.
Met andere woorden, de database is 100% compatibel met JSON (*) en werkt uitstekend met HTTP, bijvoorbeeld via CouchDB. Maar meestal gebruik je het via een realtime API, die websockets, autorisatie en abonnementen abstraheert. Het beheerpaneel biedt beide mogelijkheden, zodat je zowel realtime bewerkingen kunt uitvoeren als JSON kunt importeren/exporteren. Als je in je code hetzelfde volgt, zul je versteld staan van de hoeveelheid gespecialiseerde code die verdwijnt, wanneer je begrijpt dat patch en diff JSON 90% van de routinematige taken voor de verwerking van de persistente toestand kunnen oplossen.
Het datamodel van Firestore lijkt op JSON, maar verschilt op enkele cruciale punten. Ik heb al het ontbreken van arrays binnen arrays genoemd. Het model van sub-collecties is dat ze eerste-klasse concepten zijn, gescheiden van het JSON-document dat ze bevat. Omdat er geen kant-en-klare serialisatie voor is, is er een gespecialiseerde uitvoeringsroute nodig voor het ophalen en schrijven van gegevens. Voor het verwerken van je eigen collecties moet je je eigen scripts en tools schrijven. Het beheerpaneel stelt je alleen in staat om kleine wijzigingen per veld aan te brengen en heeft geen import-/exportmogelijkheden.
Ze hebben een realtime NoSQL-database omgevormd tot een trage niet-SQL met auto-aggregatie en een aparte kolom niet-JSON. Iets in de geest van GraftQL.
Heet Java
Als Firestore betrouwbaarder en schaalbaarder moet worden, dan is de ironie dat de gemiddelde ontwikkelaar een minder betrouwbaar systeem krijgt dan bij het kiezen van FireBase 'uit de doos'. De software die de Zeurende Databasebeheerder nodig heeft, vereist een niveau van inspanning en expertise dat gewoon onrealistisch is voor de niche waarin het verondersteld wordt een goed product te zijn. Het is alsof HTML5 Canvas helemaal geen vervanging is voor Flash, als er geen ontwikkelingshulpmiddelen en afspeelsoftware zijn. Bovendien is Firestore verstrikt geraakt in de zoektocht naar datakwaliteit en steriele validatie, wat gewoon niet past bij de manier waarop de gemiddelde zakelijke gebruiker het liefst werkt: voor hem is alles optioneel, omdat alles tot het einde toe een concept is.
Het belangrijkste nadeel van FireBase is dat de client jaren eerder werd ontwikkeld dan gepland, nog voordat de meeste webontwikkelaars zich bewust waren van immutabiliteit. Hierdoor gaat FireBase ervan uit dat je gegevens zult aanpassen, en benut het de voordelen van gebruikersgeboden immutabiliteit niet. Bovendien hergebruikt het geen gegevens in de aan de gebruiker gepresenteerde snapshots, waardoor het uitvoeren van een diff veel moeilijker is. Voor grote documenten is het transactiemechanisme op basis van wijzigbare diffs gewoon niet toereikend. Mensen, we hebben al WeakMap in JavaScript. Dat is handig.
Als je de gegevens de juiste vorm geeft en de bomen niet te omvangrijk maakt, kun je dit probleem omzeilen. Maar ik ben benieuwd of FireBase veel interessanter zou zijn geworden als ontwikkelaars echt een goede client-API zouden hebben uitgebracht die immutabiliteit combineert met serieuze praktische adviezen over de database-structuur. In plaats daarvan lijken ze te hebben geprobeerd iets te repareren wat niet kapot was, en dat heeft het alleen maar slechter gemaakt.
Ik ken niet alle logica die ten grondslag lag aan de creatie van Firestore. Redeneringen over motieven die zich binnen een zwart gat voordoen – dat is ook een deel van het vermaak. Zo'n tegenstelling tussen twee uiterst vergelijkbare, maar niet vergelijkbare databases komt tamelijk zelden voor. Alsof iemand dacht: «Firebase is gewoon een functie die we kunnen emuleren in Google Cloud», maar nog niet de conceptie van echte wereldvereisten of het creëren van nuttige oplossingen die aan al deze vereisten voldoen heeft ontdekt. «Laat de ontwikkelaars maar denken. Maak de UI gewoon mooi… Of kunnen we er meer vuur aan toevoegen?»
Ik begrijp een paar dingen over datastructuren. Ik zie duidelijk dat het concept van «alles in één grote JSON-boom» een poging is om elke gewaarwording van grootschalige structuur uit de database te abstraheren. Verwachten dat software zomaar om kan gaan met elke twijfelachtige fractal van datastructuur – dat is gewoon waanzin. Ik hoef zelfs maar te bedenken hoe slecht alles kan zijn, ik heb strenge code-audits uitgevoerd en heb gezien wat jullie, mensen, niet eens dromen.. Maar ik weet ook hoe goede structuren eruitzien, en Ik kan me een wereld voorstellen waarin Firestore heel logisch zou lijken en de mensen die het hebben gemaakt zouden denken dat ze goed werk hebben geleverd. Maar we leven niet in die wereld.
De ondersteuning voor het opbouwen van queries in FireBase is onder de maat volgens elke norm; deze bestaat vrijwel niet. Het moet echt verbeteren of op z'n minst heroverwogen worden. Maar Firestore is ook niet veel beter, omdat het beperkt is tot dezelfde eendimensionale indexen die je in eenvoudige SQL vindt. Als je queries nodig hebt die mensen uitvoeren met chaotische gegevens, heb je full-text search, filters op meerdere reeksen en een willekeurige gebruikersdefinieerbare volgorde nodig. Bij nader inzien zijn de mogelijkheden van eenvoudige SQL op zichzelf te beperkt. Bovendien zijn de enige SQL-queries die mensen in productie kunnen uitvoeren, snelle queries. Je hebt een gespecialiseerde oplossing voor indexeren met doordachte datastructuren nodig. Voor alles wat daarbuiten valt, zou er op zijn minst een incrementele map-reduce of iets dergelijks moeten zijn.
Als je hier informatie over zoekt in de Google-documenten, hoop ik dat je naar iets als BigTable en BigQuery wordt geleid. Echter, al deze oplossingen worden omringd door een dergelijke overvloed aan dichte jargon van bedrijfsverkoop, dat je snel terugkeert en weer iets anders gaat zoeken.
Het laatste dat je nodig hebt bij een realtime database, is iets dat door mensen is gemaakt en voor mensen, die werken volgens een loonstructuur voor het leiderschap.
(*) Dit is een grap, er is geen concept zoals .
Adverteervermelding
Zoek je een server voor project-debugging, ontwikkeling en hosting? Dan zijn wij precies jouw klant 🙂 Dagtarief voor servers met de meest uiteenlopende configuraties, antiDDoS en Windows-licenties zijn al bij de prijs inbegrepen.
Bron: habr.com
