

In de zomer neemt zowel de koopactiviteit als de intensiteit van veranderingen aan de infrastructuur van webprojecten traditioneel af, vertelt ons Kapitein Obvious. Gewoon omdat zelfs IT'ers soms op vakantie gaan. En CTO's ook. Het is dus moeilijker voor degenen die op hun post blijven, maar daar gaat het nu niet om: misschien is de zomer daarom de beste tijd om rustig na te denken over het bestaande back-upplan en een plan voor verbetering op te stellen. De ervaring van Egor Andreev uit , waar hij over sprak op de conferentie .
Bij het opzetten van back-up locaties en het maken van back-ups zijn er verschillende valkuilen waarin je kunt vallen. En daarin mag je absoluut niet vallen. Perfectionisme en... luiheid zijn wat ons hierin, zoals in veel andere zaken, verwoest. We proberen alles perfect te doen, maar perfectie is niet nodig! We moeten alleen bepaalde dingen goed doen en deze tot een goed einde brengen, zodat ze normaal functioneren.
Failover is niet iets leuks of een gimmick 'om het maar te hebben'; het is iets dat precies één doel moet dienen — de downtime verminderen, zodat de service, het bedrijf minder geld verliest. En in alle methoden voor het maken van back-ups stel ik voor om het volgende in overweging te nemen: waar zit het geld?
De eerste valkuil: wanneer we grote betrouwbare systemen bouwen en bezig zijn met back-ups — verminderen we het aantal storingen. Dit is een gevaarlijke misvatting. Wanneer we met back-ups bezig zijn, verhogen we waarschijnlijk het aantal storingen. En als we alles goed doen, verminderen we samen de downtime. Er zullen meer storingen zijn, maar ze zullen plaatsvinden met lagere kosten. Want wat zijn back-ups? — dat is het compliceren van het systeem. Elke complicatie is slecht: we krijgen meer schroefjes, meer tandwielen, met andere woorden, meer elementen — en dus een grotere kans op defecten. En ze zullen echt kapotgaan. En vaker kapotgaan. Een simpel voorbeeld: stel dat we een website hebben met PHP, MySQL. En het moet dringend worden geback-upt.
Laten we een tweede platform nemen en een identiek systeem bouwen… De complexiteit verdubbelt — we hebben twee entiteiten. Bovendien moeten we enkele logica voor gegevensoverdracht van de ene naar de andere plaats aanbrengen — dat wil zeggen, gegevens replicatie, het kopiëren van statische inhoud, enzovoort. De logica van replicatie is meestal erg ingewikkeld, waardoor de totale complexiteit van het systeem niet 2, maar 3, 5 of zelfs 10 keer groter kan zijn.
De tweede valkuil: wanneer we echt grote complexe systemen bouwen, fantaseren we over wat we uiteindelijk willen bereiken. Voilà: we willen een superbetrouwbaar systeem dat volledig zonder downtime werkt, dat binnen een halve seconde overschakelt (of beter nog, onmiddellijk), en we beginnen onze dromen werkelijkheid te maken. Maar hier is ook een nuance: hoe korter de gewenste overschakeltijd, des te complexer de logica van het systeem wordt. Hoe moeilijker we deze logica moeten maken, hoe vaker het systeem zal falen. En je kunt in een zeer ongewenste situatie terechtkomen: we proberen koste wat het kost de downtime te verminderen, maar in werkelijkheid maken we alles ingewikkelder, en wanneer er iets misgaat, zal de downtime uiteindelijk groter zijn. Vaak merk je dan dat het beter zou zijn geweest om niet te reserveren. Het zou beter zijn als het één enkel goed functionerend systeem was met een duidelijke tijd voor downtime.
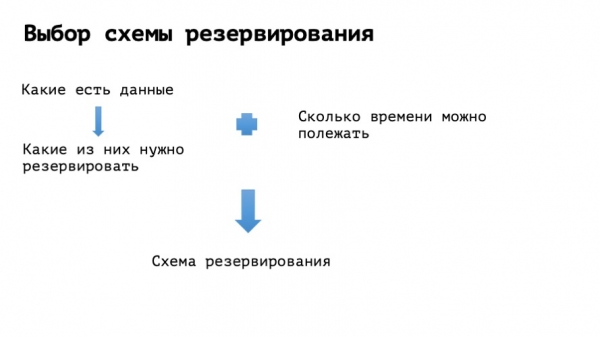
Hoe kunnen we dit bestrijden? We moeten stoppen met onszelf te bedriegen, te stoppen met onszelf te vleien dat we hier een ruimteschip gaan bouwen, en in plaats daarvan realistisch begrijpen hoe lang een project kan liggen. En op basis van deze maximale tijd kiezen we welke methoden we zullen gebruiken om de betrouwbaarheid van ons systeem te verhogen.
Het is tijd voor "verhalen uit het leven"...
Voorbeeld nummer één
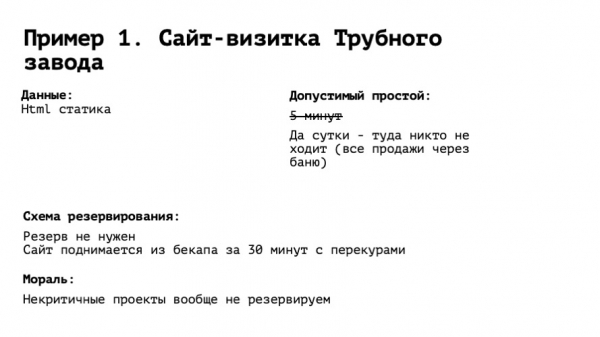
Stel je een visitekaartjeswebsite voor van de nummer 1 buizenfabriek in stad N. Er staat met grote letters – BUZENFABRIEK №1. Iets lager staat de slogan: "Onze buizen zijn de rondste buizen in N". Onderaan staat het telefoonnummer van de directeur en zijn naam. We begrijpen dat we moeten reserveren – het is immers een zeer belangrijke zaak! We beginnen te onderzoeken waar het uit bestaat. Html-statisch – dat wil zeggen een paar plaatjes waar de directeur met zijn partner aan tafel in de sauna een deal bespreekt. We beginnen na te denken over de downtime. Het valt ons in: het moet daar vijf minuten liggen, niet langer. En dan is de vraag: hoeveel verkopen zijn er eigenlijk gedaan via onze website? Hoeveel? Wat betekent "nul"? Dat betekent: omdat de directeur alle vier deals van vorig jaar aan diezelfde tafel heeft gemaakt, met diezelfde mensen, met wie zij ook in de sauna zitten en aan tafel zitten. We begrijpen dat, zelfs als de website een dag stil ligt, er niets ergs aan de hand zal zijn.
Afgaand op de input, hebben we één dag om dit verhaal op te zetten. We beginnen na te denken over het reserveringsschema. En we kiezen het meest ideale schema voor reservering voor dit voorbeeld: we gebruiken geen reservering. Deze hele opzet kan door elke admin binnen een halfuur worden opgezet met een paar pauzes. Een webserver instellen, de bestanden plaatsen – dat is alles. Het zal werken. Er is niets waar je op moet letten, en er is niets dat bijzondere aandacht behoeft. Dus de conclusie uit voorbeeld één is zeer duidelijk: diensten die niet gereserveerd hoeven te worden, hoeven niet te worden gereserveerd.
Voorbeeld nummer twee
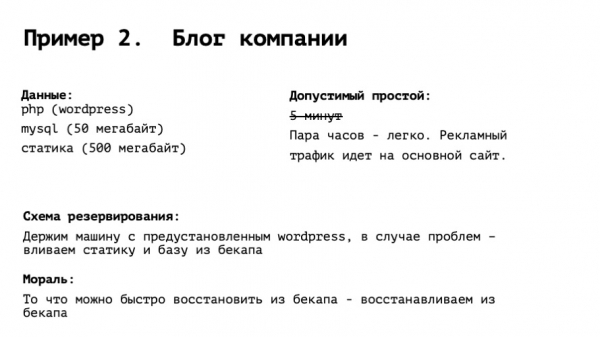
Bedrijf Blog: speciaal opgeleide mensen schrijven hier nieuws, bijvoorbeeld over onze deelname aan een bepaalde beurs of de lancering van een nieuw product, en ga zo maar door. Laten we zeggen dat dit standaard PHP is met WordPress, een kleine database en een beetje statische content. Natuurlijk komt het weer in me op dat we in geen geval meer dan vijf minuten stil mogen liggen! Maar laten we verder denken. Wat doet deze blog? Mensen komen via Yandex of Google op basis van bepaalde zoekopdrachten, via organisch verkeer. Geweldig. Maar hoe zit het met de verkoop? Een onthulling: niet echt. Advertentieverkeer gaat naar de hoofdwebsite, die op een andere server draait. We beginnen na te denken over een back-upplan voor de blog. Idealiter zouden we dit binnen een paar uur weer moeten kunnen opzetten, dus daar moeten we ons goed op voorbereiden. Het is verstandig om een server in een ander datacenter te nemen, de omgeving daarop op te zetten - met een webserver, PHP, WordPress, MySQL - en dit in stand-by te houden. Zodra we merken dat er iets mis is gegaan, moeten we twee dingen doen: een MySQL-dump van 50 MB terugzetten, dat gaat in een minuut, en een aantal afbeeldingen uit de back-up herstellen. Dat is ook niet te veel werk. Op deze manier kan alles binnen een halfuur weer draaien. Geen replicaties of godsonzijdank automatische failover. Conclusie: wat we snel uit de back-up kunnen herstellen, hoeven we niet te reserveren.
Voorbeeld nummer drie, iets ingewikkelder
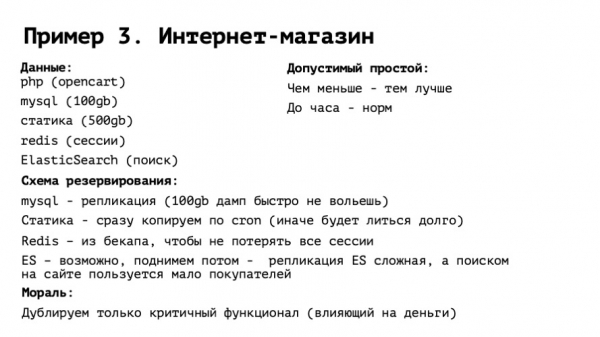
Webwinkel. PHP met open heart, een beetje aangepast, MySQL met een solide database. Vrij veel statische content (want in een webwinkel zijn er mooie HD-afbeeldingen en zo), Redis voor sessies en Elasticsearch voor zoekfuncties. We beginnen na te denken over downtime. En hier is het natuurlijk duidelijk dat een webwinkel niet een dag zonder problemen kan stilvallen. Hoe langer het stil ligt, hoe meer geld we verliezen. We moeten spoed maken. Maar hoe snel? Ik denk dat als we een uur stil liggen, niemand gek zelfs wordt. Ja, we verliezen iets, maar als we ons gaan inspannen - wordt het alleen maar erger. We bepalen het toegestane downtime-schema per uur.
Hoe kan dit allemaal gereserveerd worden? De machine is hoe dan ook nodig: een uur is vrij kort. Mysql: hier is replicatie nodig, echte replicatie, want binnen een uur zal 100 GB aan dump waarschijnlijk niet binnenkomen. Statica, plaatjes: ook hier kan 500 GB in een uur mogelijk niet binnenkomen. Dus het is beter om de plaatjes meteen te kopiëren. Redis: hier wordt het interessanter. De sessies liggen in Redis — we kunnen het gewoon niet opbergen. Omdat dat niet goed zou zijn: alle gebruikers zullen uitloggen, hun winkelwagentjes zullen leeg zijn, enzovoort. Mensen zouden opnieuw hun login en wachtwoord moeten invoeren, en veel mensen kunnen dan afhaken en hun aankoop niet voltooien. Ook zal de conversie dalen. Aan de andere kant, Redis met de laatst ingelogde gebruikers hoeft waarschijnlijk ook niet per se actueel te zijn. Een goede compromis zou zijn om Redis te nemen en het vanuit een backup te herstellen, van gisteren, of als je het elk uur maakt — van een uur geleden. Gelukkig is het herstel daarvan uit de backup slechts het kopiëren van één bestand. En het meest interessante verhaal is Elasticsearch. Wie heeft ooit MySQL-replicatie opgezet? Wie heeft ooit Elasticsearch-replicatie opgezet? En wie heeft het succesvol laten werken? Ik doel erop: we zien in ons systeem een bepaalde entiteit. Het lijkt nuttig — maar het is complex.
Complex in the sense that our engineering colleagues have no experience working with it. Or they have negative experience. Or we understand that this is still quite a new technology with nuances or immaturity. We think... Damn, Elastic is also large; it takes a long time to restore from backup, what to do? We understand that Elastic is used for searching in our case. But how does our online store sell? We go to the marketers and ask where people come from. They respond: "90% come straight from Yandex Market to the product page." And either they buy or they don’t. Therefore, search is only necessary for 10% of users. And to maintain Elastic replication, especially between different data centers in various zones, there are indeed many nuances. What’s the solution? We take Elastic on a reserved platform and don’t do anything with it. If it takes a long time, we might bring it up someday, but that’s not certain. Essentially, the conclusion is more or less the same: we don’t reserve services that don’t affect costs. To keep the scheme simpler.
Example number four, even more complex.
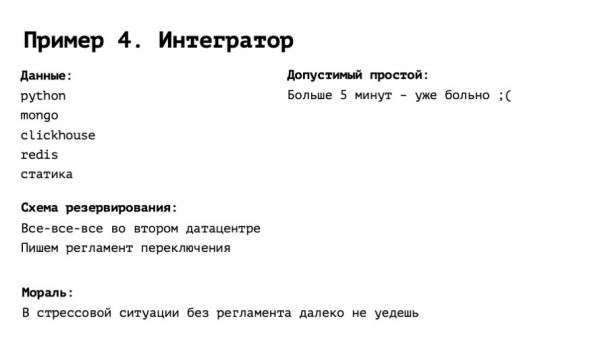
Integrator: flower sales, taxi calls, product sales, basically, anything. A serious entity that operates 24/7 for a large number of users. With a fully featured interesting stack, where there are intriguing databases, solutions, high load, and most importantly, it cannot be down for more than 5 minutes. Not only because people won’t buy, but because they will see that this thing isn’t working, get upset, and might not come back a second time.
Okay. Five minutes. What are we going to do about it? In this case, we professionally build a true backup platform with full replication of everything, and possibly even automate switching to this platform as much as possible. In addition to this, we must not forget to do one important thing: write the switching regulation. The regulation, even if you have everything automated, can be very simple. Along the lines of "run this specific Ansible script", "check this option in Route 53", and so forth — but it should be a precise list of actions.
Het lijkt allemaal duidelijk. Het overschakelen van replicatie is een triviale taak, of het schakelt automatisch over. Het herschrijven van de domeinnaam in DNS valt onder dezelfde categorie. Het probleem is dat wanneer zo'n project faalt, de paniek toeslaat, en zelfs de meest ervaren systeembeheerders kunnen hieraan onderhevig zijn. Zonder duidelijke instructies zoals 'open de terminal, ga hierheen, het adres van onze server is nog steeds zo' is het moeilijk om binnen een tijdslimiet van 5 minuten voor herstelstand te zorgen. En bovendien, wanneer we deze procedure gebruiken, is het gemakkelijk om wijzigingen in de infrastructuur te documenteren en de reglementen overeenkomstig aan te passen.
Maar als het reserveringssysteem erg complex is en we op een bepaald moment een fout maken, kunnen we zowel onze back-upomgeving uithalen, en bovendien de data op beide locaties in rook laten opgaan — dat zou behoorlijk treurig zijn.
Voorbeeld nummer vijf, complete hardcore.
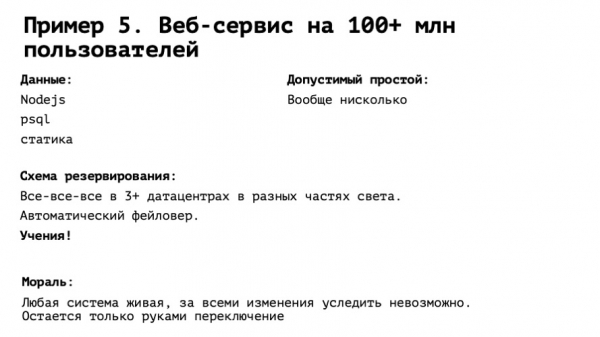
Een internationale service met honderden miljoenen gebruikers over de hele wereld. Alle tijdzones die er maar zijn, highload op de maximale capaciteit, uitvallen kan echt niet. Eén minuut — en het wordt droevig. Wat te doen? Wederom, een volledige reservering. We hebben alles gedaan wat ik in het vorige voorbeeld zei, en nog een beetje meer. Een ideale wereld, en onze infrastructuur — die is qua devops-standaarden IaaC. Dat wil zeggen, alles staat in git, je hoeft alleen de knop in te drukken.
Wat ontbreekt er? Eén ding — oefeningen. Zonder die kunnen we niet. Het lijkt erop dat alles perfect is, alles is onder controle. We drukken op de knop, alles gebeurt. Zelfs als dat zo is — en we weten dat dat niet het geval is — werkt ons systeem samen met andere systemen. Bijvoorbeeld, DNS van Route 53, S3-opslag, integratie met verschillende API's. We kunnen niet alles voorzien in dit theoretische experiment. En totdat we de schakelaar daadwerkelijk overhalen — zullen we niet weten of het werkt of niet.
Dat is waarschijnlijk alles. Wees niet lui en overdrijf niet. En moge de uptime met jullie zijn!
Bron: habr.com
