

RAID-algoritmen werden in 1987 aan het publiek gepresenteerd. Nog steeds blijven ze de meest gevraagde technologie voor gegevensbeveiliging en versnelling van gegevens toegankelijkheid in de opslagsector. Maar de leeftijd van IT-technologie die de 30 jaar heeft overschreden, is eerder een teken van ouderdom dan van volwassenheid. De reden hiervoor is de vooruitgang die onvermijdelijk nieuwe mogelijkheden met zich meebrengt. In een tijd waarin er feitelijk geen andere opslagmedia waren dan HDD's, maakten RAID-algoritmen het mogelijk om beschikbare opslagbronnen het meest efficiënt te gebruiken. Maar met de komst van SSD's is de situatie drastisch veranderd. Tegenwoordig is RAID bij het werken met solid-state drives eerder een 'knelling' op hun prestaties. Daarom is er voor het volledig benutten van de snelheidseigenschappen van SSD's een totaal andere benadering nodig.
Naast de duidelijke verschillen in werkwijzen tussen HDD en SSD, hebben deze typen opslagmedia nog een belangrijke eigenschap: elke harde schijf kan gegevens herschrijven met een granulariteit van één blok (meestal 4KB). Voor SSD's is het herschrijven van gegevens echter een veel ingewikkelder proces:
- Gewijzigde gegevens worden naar een nieuwe locatie gekopieerd. De granulariteit is hetzelfde blok, maar bestaat uit verschillende pagina's en heeft een grootte van 256KB - 4MB. Dat wil zeggen, bij het wijzigen van diezelfde 4KB moeten ook alle aangrenzende pagina's die samen een enkel blok vormen, worden gekopieerd.
- ‘Oude’ blokken worden gemarkeerd als niet-gebruikt, zodat ze later door de 'garbage collector' (Garbage Collector) kunnen worden gewist.
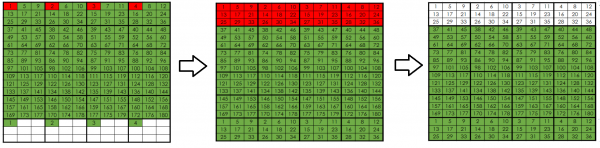
Sequentiële schrijfacties / herschrijfacties op SSD
In het geval van sequentieel schrijven / herschrijven speelt deze eigenschap van SSD's geen grote rol wat betreft hun prestaties, omdat de blokken dicht naast elkaar liggen en de 'garbage collector' zijn werk prima op de achtergrond doet. Maar in de praktijk, vooral in de Enterprise-segment, wordt voor SSD's meestal gebruikgemaakt van willekeurige gegevenstoegang. En deze gegevens worden op willekeurige plaatsen op de drives geschreven.
Hoe meer gegevens op de SSD worden geschreven, hoe moeilijker het wordt voor de "garbage collector" om te werken, omdat de fragmentatie aanzienlijk toeneemt. Op een gegeven moment stopt het reinigingsproces van de schijf met het zijn van "op de achtergrond": de prestaties van de SSD dalen aanzienlijk, omdat een aanzienlijk deel daarvan door de Garbage Collector wordt opgeëist.
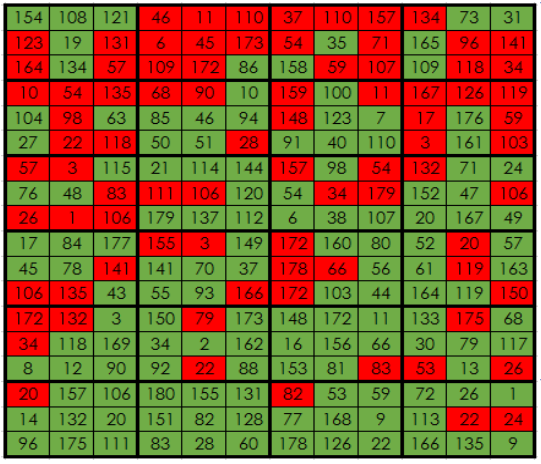
De werkelijke locatie van gegevens op de SSD bij dagelijks gebruik
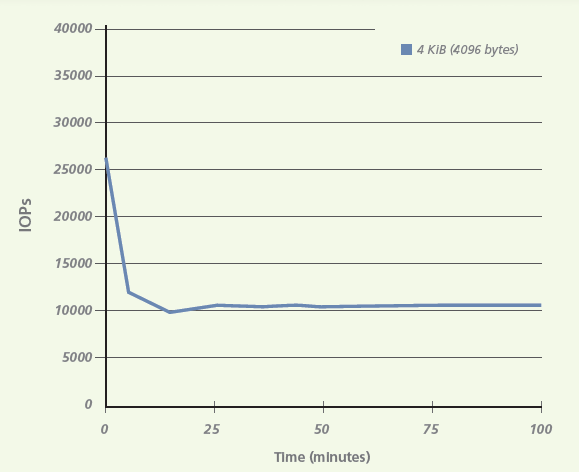
Om het effect van de werking van de "garbage collector" afhankelijk van de schrijfmethode op de schijf te illustreren, kunnen we eenvoudige tests uitvoeren: sequentieel en willekeurig schrijven in blokken van 4 KB op een 100 GB-schijf. (Bron - bedrijf )
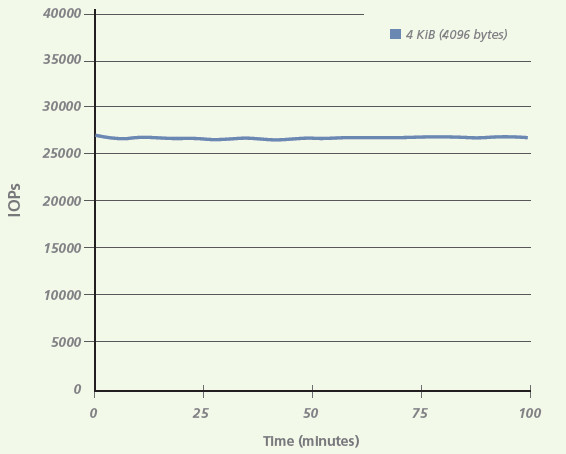
Prestaties bij sequentieel schrijven
Prestaties bij willekeurig schrijven
Zoals uit de tests blijkt, kan de daling van de prestaties meer dan twee keer bedragen. En dit is slechts een enkele schijf. In het geval van het gebruik van SSD's in een RAID-groep neemt het aantal herschrijfoperaties aanzienlijk toe, dankzij de verwerking met parity.
In het algemeen bestaat er voor SSD's, vanwege hun werkeigenschappen, een parameter zoals de write amplification. Dit is de verhouding tussen het volume gegevens dat naar de schijf is geschreven, en het volume gegevens dat de host daadwerkelijk heeft verzonden. En voor de meest populaire RAID5 is deze verhouding ~3,5.
Uiteindelijk benutten systemen met klassieke RAID in wezen slechts ~10% van hun werkelijke snelheid en schalen slecht in prestaties bij het verhogen van het aantal schijven tot meer dan tien.
Ook moet worden opgemerkt dat overmatige schrijfbewerkingen niet alleen de prestaties van de SSD verlagen, maar ook de niet oneindige levensduur ervan verkorten, waardoor de levensduur van de schijf wordt ingekort.
, die de kern vormt van alle AccelStor-producten, is ontwikkeld als alternatief voor de klassieke RAID-algoritmes bij het werken met SSD's. De innovativiteit van de technologie is zowel erkend door verschillende patenten en prijzen (onder andere op de Flash Memory Summit 2016) als door de resultaten van onafhankelijke tests (bijvoorbeeld SPC1).
Essentie bestaat uit het omzetten van alle inkomende schrijfvraagstukken, met name van het type random, in een set blokken die zo veel mogelijk lijkt op de modus van sequentieel schrijven vanuit het perspectief van de schijf. Hierdoor vindt schrijven op SSD plaats in de meest comfortabele modus voor hen, en de uiteindelijke prestaties overtreffen die van alle systemen met klassieke RAID.
Alle SSD's in AccelStor-systemen zijn verdeeld in twee symmetrische groepen FlexiRemap®. De grootte van de groep hangt af van het model en bestaat uit 5-11 drives. Voor fouttolerantie binnen de groep wordt pariteit toegepast zoals bij RAID5. Beide groepen worden samen gebruikt, waardoor ze een gemeenschappelijke opslagruimte vormen. Daarom zal de uiteindelijke fouttolerantie vergelijkbaar zijn met een RAID50-array, bestaande uit twee groepen: het systeem kan de uitval van maximaal twee SSD's weerstaan, maar niet meer dan één in elke FlexiRemap®-groep.
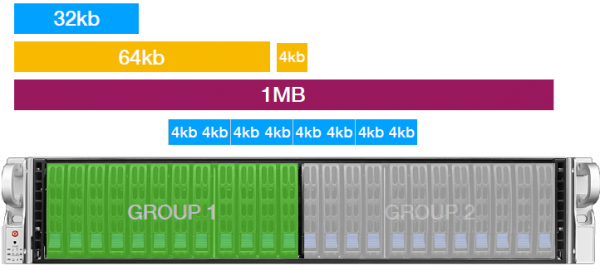
Alle inkomende schrijfvraagstukken worden verdeeld in blokken van 4KB, die in een round robin-modus op beide FlexiRemap®-groepen worden geschreven. Ondertussen houdt het systeem voortdurend rekening met de vraag naar de geschreven blokken en probeert het, bij wijziging, soortgelijke blokken zo dicht mogelijk bij elkaar te schrijven. Het resultaat is een virtuele analogie van tiering, als we het in termen van opslagsystemen zeggen. In dit geval wordt het werk van de 'garbage collector' aanzienlijk vergemakkelijkt: ongebruikte blokken zullen immers altijd dicht bij elkaar liggen.
Het moet worden opgemerkt dat in tegenstelling tot producten van concurrenten geen gebruikmaken van functionaliteit voor het cachen van inkomende verzoeken in het RAM van de controller. Alle inkomende datablocks worden onmiddellijk op de SSD geschreven. De host ontvangt een bevestiging van een succesvolle schrijfbeurt pas na de fysieke plaatsing van de gegevens op de opslagmedia. In het RAM worden alleen tabellen opgeslagen voor de plaatsing van blokken op de SSD om de toegang te versnellen en te bepalen waar het volgende datablock moet worden geschreven. Natuurlijk zijn er voor de betrouwbaarheid kopieën van deze tabellen ook op de opslagmedia geplaatst. Hierdoor hebben AccelStor-systemen geen cachebescherming in de vorm van een batterij/condenser nodig (hoewel de mogelijkheid bestaat om een verbinding met een UPS tot stand te brengen – voor een 'zachte' uitschakeling in geval van stroomproblemen).
Dankzij een dergelijke aanpak van het organiseren van de opslag, kan de 'garbage collector' daadwerkelijk op de achtergrond werken zonder een significante impact op de snelheid van de opslagmedia, wat uiteindelijk mogelijk maakt om binnen het systeem tot 90% van de SSD-prestaties te recyclen. Dit is de reden voor de hoge IOPS-waarden in de AccelStor-systemen in vergelijking met All Flash systemen, die op RAID-algoritmen zijn gebaseerd.
Een andere belangrijke eigenschap van de FlexiRemap® technologie is de significante vermindering van overbodige schrijfoperaties op SSD's. De schrijfverhouding (write amplification) voor AccelStor-systemen is slechts 1.3, wat in algemene termen betekent dat de levensduur van de opslagmedia meer dan 2.5 keer zo lang is in vergelijking met RAID5!
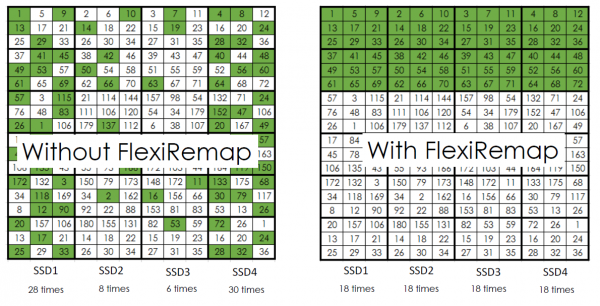
Dankzij de constante controle van het systeem over het data-plaatsingsbeleid op de SSD's, slijten alle opslagmedia gelijkmatig. Deze aanpak stelt ons in staat om hun levensduur te voorspellen en tijdig een signaal naar de beheerder te sturen over het verbruik van schrijfbronnen.
Het is duidelijk dat SSD's kunnen uitvallen. In dat geval zal het systeem onmiddellijk beginnen met het rebuilden naar een van de hot spare-schijven. De FlexiRemap®-groep, die zich in een degraded-toestand bevindt, schakelt over naar 'alleen-lezen' modus, en alle schrijfverzoeken worden naar de tweede groep gestuurd. Dit beschermingsmechanisme is ontworpen om de rebuild-operatie te versnellen en de kans op uitval van een andere schijf binnen dezelfde groep te verlagen. Het is geen geheim dat tijdens een rebuild alle schijven in de groep worden blootgesteld aan een verhoogde belasting door de interferentie van lees-, schrijf- en hersteloperaties op de hot spare. Dit verhoogt de kans op de uitval van een andere schijf. En hoe meer schrijfoperaties, hoe langer de rebuild zal duren.
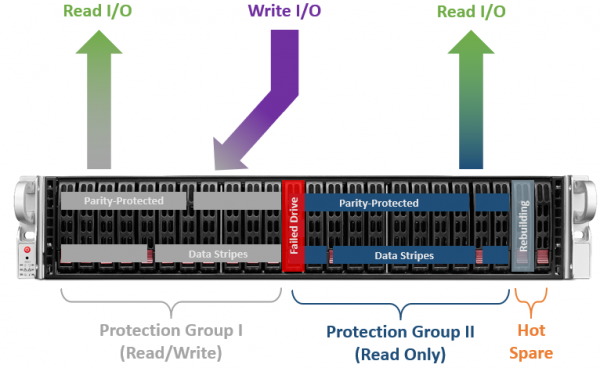
Na het voltooien van het herstelproces en het terugbrengen van de FlexiRemap®-groep naar een normale toestand, zal er een kleine scheefstand in de schrijfbron tussen de twee groepen ontstaan. Daarom zullen toekomstige schrijfoperaties vaker op de herstelde groep plaatsvinden (natuurlijk met de nodige afweging dat de uiteindelijke systeemprestaties niet te veel worden belast).
Het vergroten van de prestaties van All Flash-systemen die gebaseerd zijn op RAID-algoritmen boven bepaalde waarden (~280K IOPS@4K random write) is zelfs met complexe caching-systemen niet mogelijk. De FlexiRemap®-technologie, dankzij een volledig andere benadering van de organisatie van de opslagruimte, overwint deze barrière moeiteloos en verlengt bovendien de levensduur van SSD's aanzienlijk. Dus systemen hebben aanzienlijke voordelen ten opzichte van andere All Flash-arrays op veel fronten (IOPS/$, GB/$, TCO, ROI), waardoor ze uitstekende kandidaten zijn voor sleutelposities in datacenters van klanten om resource-intensieve taken aan te pakken.
Bron: habr.com
