

In onze tijd is het ondenkbaar om een project op basis van Kubernetes te hebben zonder de ELK-stack, waarmee zowel applicatie- als systeemcomponentlogs van de cluster worden opgeslagen. In onze praktijk gebruiken wij de EFK-stack met Fluentd in plaats van Logstash.
Fluentd is een moderne, veelzijdige logverzamelaar die steeds populairder wordt en is aangesloten bij de Cloud Native Computing Foundation, waardoor de ontwikkeling ervan gericht is op gebruik in combinatie met Kubernetes.
Het feit dat we Fluentd in plaats van Logstash gebruiken, verandert de essentie van het softwaresysteem niet, maar Fluentd heeft specifieke nuances die voortkomen uit zijn multifunctionaliteit.
Bijvoorbeeld, toen we EFK begonnen te gebruiken in een project met een zware belasting en een hoge schrijfsnelheid van logs, stuitten we erop dat sommige berichten in Kibana meerdere keren werden weergegeven. In dit artikel leggen we uit waarom dit fenomeen zich voordoet en hoe we het probleem kunnen oplossen.
Probleem van documentduplicatie
In onze projecten is Fluentd uitgerold als DaemonSet (wordt automatisch in één exemplaar op elke node van de Kubernetes-cluster gestart) en houdt het stdout-logs van containers bij in /var/log/containers. Na verzameling en verwerking worden de logs in de vorm van JSON-documenten naar ElasticSearch gestuurd, dat wordt uitgevoerd in zowel cluster- als standalone-modus, afhankelijk van de schaal van het project en de prestaties en beschikbaarheidseisen. Kibana wordt gebruikt als grafische interface.
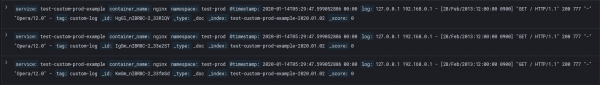
Bij het gebruik van Fluentd met een bufferplugin stuitten we op een situatie waarin sommige documenten in ElasticSearch volledig identieke inhoud hebben en alleen van identificatie verschillen. Je kunt dit bevestigen met behulp van een voorbeeld van de Nginx-log. In het logbestand bestaat dit bericht in een enkel exemplaar:
127.0.0.1 192.168.0.1 - [28/Feb/2013:12:00:00 +0900] "GET / HTTP/1.1" 200 777 "-" "Opera/12.0" -Echter, in ElasticSearch zijn er verschillende documenten die dit bericht bevatten:
{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "HgGl_nIBR8C-2_33RlQV",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28\/Feb\/2013:12:00:00  0900] \"GET \/ HTTP\/1.1\" 200 777 \"-\" \"Opera\/12.0\" -",
    "tag": "custom-log"
  }
}

{
  "_index": "test-custom-prod-example-2020.01.02",
  "_type": "_doc",
  "_id": "IgGm_nIBR8C-2_33e2ST",
  "_version": 1,
  "_score": 0,
  "_source": {
    "service": "test-custom-prod-example",
    "container_name": "nginx",
    "namespace": "test-prod",
    "@timestamp": "2020-01-14T05:29:47.599052886 00:00",
    "log": "127.0.0.1 192.168.0.1 - [28\/Feb\/2013:12:00:00  0900] \"GET \/ HTTP\/1.1\" 200 777 \"-\" \"Opera\/12.0\" -",
    "tag": "custom-log"
  }
}
Soms kan er meer dan twee herhalingen zijn.
Tijdens het vastleggen van dit probleem zijn er veel waarschuwingen in de Fluentd-log zichtbaar met de volgende inhoud:
2020-01-16 01:46:46 +0000 [warn]: [test-prod] kon de buffer niet legen. retry_time=4 next_retry_seconds=2020-01-16 01:46:53 +0000 chunk="59c37fc3fb320608692c352802b973ce" error_class=Fluent::Plugin::ElasticsearchOutput::RecoverableRequestFailure error="kon logs niet naar de Elasticsearch-cluster duwen ({:host=>\"elasticsearch\", :port=>9200, :scheme=>\"http\", :user=>\"elastic\", :password=>\"obfuscated\"}): tijdslimiet overschreden"Deze waarschuwingen treden op wanneer ElasticSearch geen antwoord kan geven op een verzoek binnen de ingestelde request_timeout, waardoor het overgedragen bufferfragment niet kan worden gewist. Vervolgens probeert Fluentd het bufferfragment opnieuw naar Elasticsearch te sturen, en na een willekeurig aantal pogingen slaagt de operatie:
2020-01-16 01:47:05 +0000 [warn]: [test-prod] herhaling geslaagd. chunk_id="59c37fc3fb320608692c352802b973ce"
2020-01-16 01:47:05 +0000 [warn]: [test-prod] herhaling geslaagd. chunk_id="59c37fad241ab300518b936e27200747"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] herhaling geslaagd. chunk_id="59c37fc11f7ab707ca5de72a88321cc2"
2020-01-16 01:47:05 +0000 [warn]: [test-dev] herhaling geslaagd. chunk_id="59c37fb5adb70c06e649d8c108318c9b"
2020-01-16 01:47:15 +0000 [warn]: [kube-system] herhaling geslaagd. chunk_id="59c37f63a9046e6dff7e9987729be66f"
ElasticSearch beschouwt echter elk van de overgedragen bufferfragmenten als uniek en kent ze unieke waarden voor het _id-veld toe bij het indexeren. Dit is hoe kopieën van berichten ontstaan.
In Kibana ziet het er als volgt uit:
Oplossing van het probleem
Er zijn verschillende oplossingen voor dit probleem. Een daarvan is de mechanismen voor het genereren van een unieke hash voor elk document, ingebouwd in de fluent-plugin-elasticsearch. Als deze mechanismen worden gebruikt, herkent ElasticSearch duplicaten bij het verzenden en voorkomt het de duplicatie van documenten. Het is echter belangrijk op te merken dat deze oplossing het gevolg van het probleem aanpakt en de fout door een gebrek aan time-out niet oplost, daarom hebben we besloten deze oplossing niet te gebruiken.
We gebruiken een buffer-plugin aan de uitgang van Fluentd om te voorkomen dat logs verloren gaan bij korte netwerkproblemen of verhoogde logschrijfinintensiteit. Als ElasticSearch om welke reden dan ook een document niet onmiddellijk in de index kan schrijven, komt het document in een wachtrij die op de schijf wordt opgeslagen. Daarom is het, om de bron van het probleem dat leidt tot de eerder beschreven fout te verhelpen, noodzakelijk om de juiste waarden voor de bufferparameters in te stellen, zodat de uitvoerbuffer van Fluentd genoeg capaciteit heeft en op tijd kan worden geleegd.
Het is belangrijk op te merken dat de waarden van de parameters waar we het hieronder over zullen hebben, individueel zijn voor elk specifiek geval van buffergebruik in uitvoerplugins, omdat ze afhankelijk zijn van verschillende factoren: de intensiteit van het loggen door de services, de prestaties van het opslagsysteem, de belasting van de netwerkverbinding en de bandbreedte. Om geschikte maar niet overmatige bufferinstellingen voor elk afzonderlijk geval te verkrijgen en langdurige blindelingspellen te vermijden, kan gebruik worden gemaakt van diagnostische informatie die Fluentd in zijn log tijdens de werking schrijft, waardoor snel de correcte waarden kunnen worden verkregen.
Op het moment van de probleemvaststelling zag de configuratie er als volgt uit:
 @type file
        path /var/log/fluentd-buffers/kubernetes.test.buffer
        flush_mode interval
        retry_type exponential_backoff
        flush_thread_count 2
        flush_interval 5s
        retry_forever
        retry_max_interval 30
        chunk_limit_size 8M
        queue_limit_length 8
        overflow_action block
Bij het oplossen van het probleem werden handmatig de waarden van de volgende parameters ingesteld:
chunk_limit_size — de grootte van de chunks waarin de berichten in de buffer worden verdeeld.
- flush_interval — de tijdsinterval waarna de buffer wordt geleegd.
- queue_limit_length — het maximale aantal chunks in de wachtrij.
- request_timeout — de tijdsduur voor de verbinding tussen Fluentd en ElasticSearch.
De totale grootte van de buffer kan worden berekend door de parameters queue_limit_length en chunk_limit_size te vermenigvuldigen, wat kan worden opgevat als ‘het maximale aantal chunks in de wachtrij, elk met een opgegeven volume’. Bij een onvoldoende buffer-grootte verschijnt de volgende waarschuwing in de logs:
2020-01-21 10:22:57 +0000 [warn]: [test-prod] gegevens konden niet in de buffer worden geschreven door buffer overflow action=:blockDit betekent dat de buffer niet snel genoeg wordt geleegd binnen de toegewezen tijd, en de gegevens die binnenkomen in de volle buffer worden geblokkeerd, wat zal leiden tot verlies van sommige logs.
De buffer kan op twee manieren worden vergroot: door ofwel de grootte van elke chunk in de wachtrij te vergroten, ofwel het aantal chunks dat in de wachtrij kunnen staan.
Als de chunk-grootte chunk_limit_size meer dan 32 megabyte is, accepteert ElasticSearch deze niet, omdat het binnenkomende pakket te groot zou zijn. Daarom, als een verdere vergroting van de buffer nodig is, kan het beter zijn om de maximale wachtrijlengte queue_limit_length te vergroten.
Wanneer de buffer niet meer overloopt en er alleen een melding is over een tekort aan timeout, kan men beginnen met het verhogen van de parameter request_timeout. Echter, als de waarde groter dan 20 seconden wordt ingesteld, zullen de volgende waarschuwingen in de Fluentd-logs beginnen te verschijnen:
2020-01-21 09:55:33 +0000 [warn]: [test-dev] buffer flush nam langer dan slow_flush_log_threshold: elapsed_time=20.85753920301795 slow_flush_log_threshold=20.0 plugin_id="postgresql-dev" Dit bericht heeft verder geen invloed op de werking van het systeem en betekent dat de tijd voor het legen van de buffer langer is dan opgegeven door de slow_flush_log_threshold parameter. Dit is debug-informatie en we gebruiken deze bij het bepalen van de waarde voor request_timeout.
Het algemene algoritme voor afstemming ziet er als volgt uit:
- Stel de waarde van request_timeout in op gegarandeerd hoger dan nodig (honderden seconden). Tijdens de afstemming is de belangrijkste criterium voor de juistheid van deze instelling het verdwijnen van waarschuwingen over een tekort aan timeout.
- Wacht op berichten over het overschrijden van de drempel van slow_flush_log_threshold. In de tekst van de waarschuwing staat in het veld elapsed_time de werkelijke tijd voor het legen van de buffer.
- Stel de waarde van request_timeout hoger in dan de maximale waarde van elapsed_time die is verkregen tijdens de observatieperiode. We berekenen de waarde van request_timeout als elapsed_time + 50%.
- Om waarschuwingen over langdurige bufferopruiming uit het logboek te verwijderen, kan de waarde van slow_flush_log_threshold verhoogd worden. We berekenen deze waarde als elapsed_time + 25%.
De eindwaarden van deze parameters, zoals eerder opgemerkt, zijn individueel voor elk geval. Door het bovenstaande algoritme te volgen, zorgen we ervoor dat de fout die leidt tot het herhalen van berichten wordt opgelost.
In de onderstaande tabel is te zien hoe het aantal fouten per dag, dat leidt tot dubbele berichten, verandert tijdens het zoeken naar waarden van de hierboven beschreven parameters:
node-1
node-2
node-3
node-4
Voor/Na
Voor/Na
Voor/Na
Voor/Na
kon de buffer niet worden gewist
1749/2
694/2
47/0
1121/2
opnieuw geprobeerd, geslaagd
410/2
205/1
24/0
241/2
Het is ook belangrijk om op te merken dat de verkregen instellingen hun relevantie kunnen verliezen naarmate het project groeit en het aantal logs toeneemt. Een van de eerste tekenen van een tekort aan de ingestelde time-out is het terugkeren van berichten over langdurige bufferopruiming in de Fluentd-log, dat wil zeggen het overschrijden van de drempel van slow_flush_log_threshold. Vanaf dat moment is er nog een kleine speling voor het overschrijden van de parameter request_timeout, dus je moet tijdig reageren op deze berichten en opnieuw het proces van het zoeken naar optimale instellingen uitvoeren, zoals hierboven beschreven.
Conclusie
De fijnafstelling van de uitgangsbuffer van Fluentd is een van de belangrijkste stappen in de configuratie van de EFK-stack, die de stabiliteit van de werking en de correcte plaatsing van documenten in de indexen bepaalt. Door je te baseren op het beschreven configuratie-algoritme, kun je er zeker van zijn dat alle logs in de juiste volgorde zonder duplicaten en verlies in de ElasticSearch-index worden vastgelegd.
Lees ook andere artikelen op onze blog:
Bron: habr.com
