

Hallo, lezers van Habr. Met dit artikel beginnen we een cyclus die zal vertellen over ons ontwikkelde hypergeconvergeerde systeem AERODISK vAIR. Aanvankelijk wilden we in dit eerste artikel alles over alles vertellen, maar het systeem is nogal complex, dus we nemen het stap voor stap.
We starten ons verhaal met de geschiedenis van de totstandkoming van het systeem, duiken in het bestandssysteem ARDFS, dat de basis vormt voor vAIR, en zullen ook een beetje reflecteren op de positionering van deze oplossing op de Russische markt.
In toekomstige artikelen zullen we meer gedetailleerd ingaan op verschillende architectonische componenten (cluster, hypervisor, load balancer, monitoringsysteem, enz.), het configuratieproces, we zullen licentievraagstukken behandelen, aparte stress-tests laten zien en natuurlijk zullen we het hebben over load testing en sizing. Ook zullen we een apart artikel wijden aan de community-versie van vAIR.
AERODISK — is dit niet een verhaal over een SAN? Of waarom zijn we überhaupt begonnen met hyperconverged?
De oorspronkelijke idee om onze eigen hyperconverged oplossing te creëren kwam ergens rond 2010. Toen waren er nog geen AERODISK of soortgelijke (commerciële) hypergeconvergeerde systemen op de markt. Onze taak was als volgt: uit een set servers met lokale schijven, verbonden via een interconnect met het Ethernet-protocol, moesten we een verspreide opslag maken en virtuele machines en een softwaresysteem daarboven draaien. Dit alles moest gerealiseerd worden zonder een SAN (omdat er simpelweg geen geld was voor een SAN en de bijbehorende infrastructuur, en we hadden op dat moment nog geen eigen SAN ontwikkeld).
We hebben veel open source-oplossingen uitgeprobeerd en hebben uiteindelijk de taak opgelost, maar de oplossing was erg complex en moeilijk te repliceren. Bovendien viel de oplossing in de categorie van 'Werkt het? Raak het niet aan!'. Daarom, na het oplossen van die taak, hebben we de idee om het resultaat van ons werk om te vormen tot een volwaardig product niet verder ontwikkeld.
Na die zaak hebben we ons van dit idee afgekeerd, maar het gevoel dat deze taak volkomen oplosbaar is, bleef ons toch bij, en het nut van zo'n oplossing was meer dan duidelijk. Verdere HCI-producten van buitenlandse bedrijven hebben dat gevoel alleen maar bevestigd.
Daarom zijn we medio 2016 teruggekeerd naar deze taak in het kader van de creatie van een volwaardig product. Toen hadden we nog geen enkele relatie met investeerders, dus moesten we de ontwikkelstand zelf aanschaffen van ons niet al te grote budget. Na het vinden van tweedehands servers en switches op Avito, zijn we aan de slag gegaan.
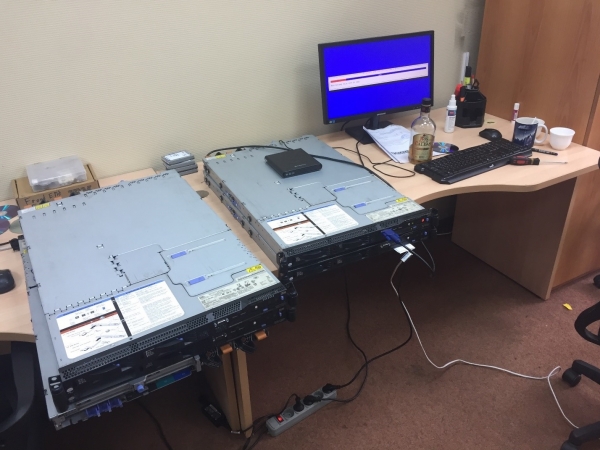
De belangrijkste initiële taak was het creëren van een eigen, zij het eenvoudige, bestandssysteem dat automatisch en gelijkmatig gegevens kon verdelen in de vorm van virtuele blokken over een n-aantal knooppunten in een cluster, die onderling verbonden zijn via Ethernet. Tegelijkertijd moest het bestandssysteem goed en eenvoudig schaalbaar zijn en onafhankelijk van aangrenzende systemen, d.w.z. het moest verhandelbaar zijn van vAIR in de vorm van "gewoon opslag".
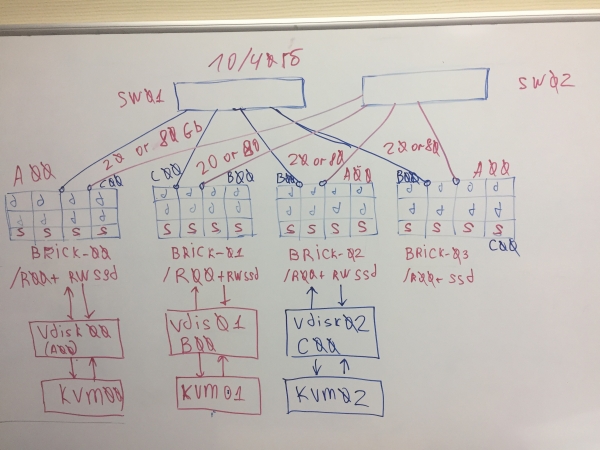
Het eerste concept van vAIR
We hebben bewust afgezien van het gebruik van kant-en-klare open source-oplossingen voor het organiseren van een gedistribueerde opslag (ceph, gluster, lustre en dergelijke) ten gunste van onze eigen ontwikkeling, omdat we al veel projectervaring met hen hadden. Uiteraard zijn deze oplossingen op zich geweldig, en vóór ons werk aan Aerodisk hebben we meerdere integratieprojecten met hen gerealiseerd. Maar het is een ander verhaal om een specifieke taak voor een klant uit te voeren, personeel op te leiden en mogelijk ondersteuning van een grote leverancier te kopen, dan om een gemakkelijk reproduceerbaar product te creëren dat voor verschillende taken zal worden gebruikt, waarvan wij als leverancier misschien zelf niet eens weten. Voor het tweede doel waren bestaande open source-producten niet geschikt, daarom besloten we zelf een gedistribueerd bestandssysteem te ontwikkelen.
Na twee jaar hebben meerdere ontwikkelaars (die hun werk aan vAIR combineerden met hun werk aan de klassieke opslag Engine) een bepaald resultaat bereikt.
Tegen 2018 hadden we een eenvoudig bestandssysteem geschreven en dit aangevuld met de nodige omhulling. Het systeem verbond via interne interconnectie fysieke (lokale) schijven van verschillende servers tot één platte pool en "sneed" ze in virtuele blokken, waarna uit de virtuele blokken blokapparaten werden gecreëerd met een bepaalde mate van fouttolerantie, waarop met behulp van de hypervisor KVM virtuele machines werden gecreëerd en uitgevoerd.
We hebben niet te veel aandacht besteed aan de naam van het bestandssysteem en hebben het eenvoudig ARDFS genoemd (gok maar wat het betekent))
Dit prototype zag er goed uit (niet visueel, dat was er toen nog niet) en toonde goede prestaties en schaalbaarheid. Na het eerste echte resultaat hebben we dit project opgestart, met een volledige ontwikkelomgeving en een apart team dat zich uitsluitend met vAIR bezighield.
Juist op dat moment was de algemene architectuur van de oplossing volgroeid, die tot nu toe geen ingrijpende wijzigingen heeft ondergaan.
Laten we ons onderdompelen in het ARDFS-bestandssysteem
ARDFS vormt de basis van vAIR, dat zorgt voor gedistribueerde fouttolerante opslag van de gegevens van het hele cluster. Een van (maar niet de enige) onderscheidende kenmerken van ARDFS is dat het geen extra dedicated servers onder meting en beheer gebruikt. Dit was oorspronkelijk bedoeld om de configuratie van de oplossing te vereenvoudigen en de betrouwbaarheid ervan te vergroten.
Opslagstructuur
Binnen alle knooppunten van het cluster organiseert ARDFS een logische pool van alle beschikbare schijfruimte. Het is belangrijk te begrijpen dat een pool nog geen gegevens en geen geformatteerde ruimte is, maar gewoon een indeling, d.w.z. dat alle knooppunten met een geïnstalleerde vAIR bij het toevoegen aan het cluster automatisch worden toegevoegd aan de gezamenlijke pool van ARDFS en de schijfruimte automatisch gemeenschappelijk wordt voor het hele cluster (en beschikbaar voor toekomstige gegevensopslag). Deze aanpak maakt het mogelijk om knooppunten on-the-fly toe te voegen en te verwijderen zonder enige significante impact op het reeds werkende systeem. Dit betekent dat je het systeem heel gemakkelijk kunt schalen met 'stenen', door knooppunten naar behoefte toe te voegen of weg te halen in het cluster.
Bovenop de ARDFS-pool worden virtuele schijven (opslagobjecten voor virtuele machines) gebouwd, die zijn samengesteld uit virtuele blokken van 4 megabyte. Gegevens worden rechtstreeks op de virtuele schijven opgeslagen. Op het niveau van de virtuele schijven wordt ook een schema voor fouttolerantie vastgesteld.
Zoals je misschien al hebt geraden, gebruiken we voor de fouttolerantie van het opslag systeem geen RAID (Redundant Array of Independent Disks), maar RAIN (Redundant Array of Independent Nodes). Dat wil zeggen, de fouttolerantie wordt gemeten, geautomatiseerd en beheerd op basis van nodes, niet op basis van schijven. Schijven zijn uiteraard ook opslagobjecten, ze worden, net als alles, gemonitord en met hen kunnen alle standaardbewerkingen worden uitgevoerd, inclusief het opzetten van een lokale hardware RAID, maar het cluster opereert specifiek op nodes.
In situaties waarin je echt RAID wilt (bijvoorbeeld in scenario's die meerdere uitval op kleine clusters ondersteunen), staat niets het gebruik van lokale RAID-controllers in de weg, en daarbovenop een uitgestrekt opslag- en RAIN-architectuur te maken. Dit scenario is heel goed mogelijk en wordt door ons ondersteund, daarom zullen we het beschrijven in het artikel over typische gebruiksscenario's van vAIR.
Fouttolerantie schema's van opslag
Er kunnen twee fouttolerantie schema's van virtuele schijven in vAIR zijn:
1) Replicatiefactor of gewoon replicatie – deze fouttolerantiemethode is zo eenvoudig 'als een stok en een touw'. Het omvat synchrone replicatie tussen nodes met een factor van 2 (2 kopieën per cluster) of 3 (3 kopieën, respectievelijk). RF-2 stelt de virtuele schijf in staat om de uitval van één node in het cluster te weerstaan, maar 'slurpt' de helft van de nuttige capaciteit op, terwijl RF-3 de uitval van 2 nodes in het cluster kan weerstaan, maar al 2/3 van de nuttige capaciteit voor zichzelf reserveert. Dit schema lijkt sterk op RAID-1, dat wil zeggen, een virtuele schijf geconfigureerd in RF-2 is bestand tegen de uitval van een enkele node in het cluster. In dit geval is alles met de gegevens in orde en stopt zelfs de invoer/uitvoer niet. Wanneer de uitgevallen node weer functioneel is, begint het automatische herstel/synchronisatie van gegevens.
Hieronder staan voorbeelden van gegevensverdeling RF-2 en RF-3 in normale modus en in uitvalsituaties.
We have a virtual machine with 8MB of unique (useful) data, running on 4 vAIR nodes. It's clear that in reality such a small volume is unlikely, but for a diagram reflecting the logic of ARDFS, this example is the most understandable. AB represents virtual blocks of 4MB containing unique data of the virtual machine. In RF-2, two copies of these blocks A1+A2 and B1+B2 are created, respectively. These blocks are "distributed" across the nodes, avoiding the overlap of the same data on a single node, meaning that copy A1 will not be on the same node as copy A2. The same goes for B1 and B2.
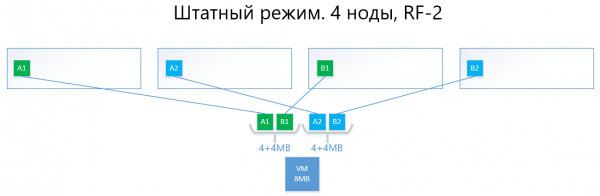
In the event of a failure of one of the nodes (for example, node #3, where copy B1 is located), this copy is automatically activated on a node where there is no copy of its copy (that is, copy B2).
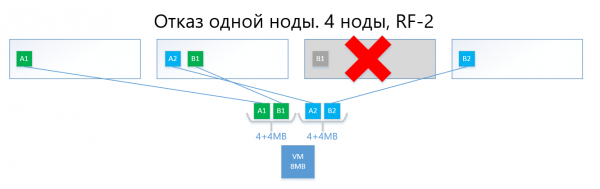
Thus, the virtual disk (and VM, respectively) can easily withstand the failure of one node in the RF-2 scheme.
The replication scheme, despite its simplicity and reliability, suffers from the same issue as RAID1 – there is little usable space.
2) Erasure coding, also known as "redundant coding" or "erasure code," exists to resolve the problem mentioned above. EC is a redundancy scheme that ensures high data availability with lower overhead costs for disk space compared to replication. The principle of this mechanism is similar to RAID 5, 6, 6P.
During encoding, the EC process divides the virtual block (by default 4MB) into several smaller "data chunks" depending on the EC scheme (for example, the 2+1 scheme divides each 4MB block into 2 chunks of 2MB). Then this process generates "parity chunks" of no more than one of the previously divided parts for the "data chunks." When decoding, EC generates the missing chunks by reading the "surviving" data throughout the cluster.
For example, a virtual disk with an EC scheme of 2 + 1, implemented on 4 nodes of the cluster, can easily withstand the failure of one node in the cluster just as RF-2 does. At the same time, the overhead costs will be lower, in particular, the usable capacity coefficient for RF-2 is 2, while for EC 2+1 it will be 1.5.
To put it simply, the essence is that the virtual block is divided into 2-8 (the reason for between 2 and 8 is explained below) "chunks," and "chunks" of the same volume are computed for these chunks as parity.
Uiteindelijk worden de gegevens en pariteit gelijkmatig verdeeld over alle knooppunten in de cluster. Net als bij replicatie verdeelt ARDFS automatisch de gegevens over de knooppunten, zodat dezelfde gegevens (kopieën van de gegevens en hun pariteit) niet op één knooppunt worden opgeslagen, om het risico te vermijden dat gegevens verloren gaan doordat de gegevens en hun pariteit zich plotseling op één opslagknooppunt bevinden dat uitvalt.
Hieronder een voorbeeld met dezelfde virtuele machine van 8 MB en 4 knooppunten, maar met het EC-schema 2+1.
Blokken A en B worden elk in twee stukken van 2 MB verdeeld (in twee omdat 2+1), dat wil zeggen A1+A2 en B1+B2. In tegenstelling tot de replicatie is A1 geen kopie van A2, het is een virtueel blok A dat in twee delen is gesplitst, hetzelfde geldt voor blok B. We krijgen in totaal twee sets van 4 MB, elk met twee stukken van twee megabyte. Vervolgens wordt voor elk van deze sets pariteit berekend van maximaal één stuk (dus 2 MB), wat resulteert in nog eens + 2 stukken pariteit (A-P en B-P). In totaal hebben we 4×2 gegevens + 2×2 pariteit.
Vervolgens worden de stukken "uitgelegd" over de knooppunten, zodat de gegevens niet overlappen met hun pariteit. Dat wil zeggen, A1 en A2 zullen niet op hetzelfde knooppunt liggen als A-P.
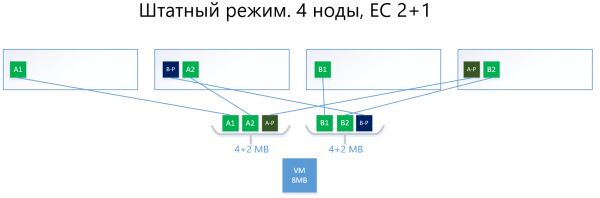
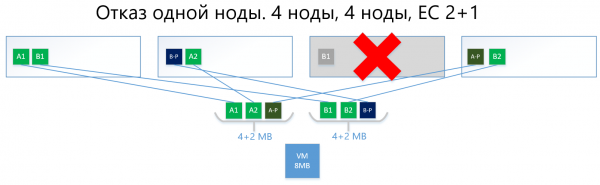
In het geval van uitval van een knooppunt (neh, laten we zeggen, ook de derde) zal het uitgevallen blok B1 automatisch worden hersteld uit de pariteit B-P, die op knooppunt nummer 2 is opgeslagen, en zal worden geactiveerd op het knooppunt waar geen B-pariteit aanwezig is, oftewel het stuk B-P. In dit voorbeeld is dat knooppunt nummer 1.
Ik ben er zeker van dat de lezer zich afvraagt:
"Alles wat u hebt beschreven, is al lang gerealiseerd door concurrenten en in open source-oplossingen, wat is het verschil met uw EC-implementatie in ARDFS?"
En daarna komen de interessante kenmerken van de werking van ARDFS.
Erasure coding met de nadruk op flexibiliteit
Aanvankelijk hebben we een vrij flexibele EC-schema X+Y in gedachten, waarbij X een getal van 2 tot 8 is, en Y een getal van 1 tot 8 is, maar altijd kleiner dan of gelijk aan X. Dit schema is ontworpen voor flexibiliteit. Het verhogen van het aantal datastukken (X), waaruit het virtuele blok wordt gedeeld, vermindert de overhead, oftewel vergroot de bruikbare ruimte.
Het verhogen van het aantal pariteitsstukken (Y) verhoogt de betrouwbaarheid van de virtuele schijf. Hoe groter de waarde van Y, des te meer knooppunten in de cluster kunnen uitvallen. Uiteraard vermindert het verhogen van de hoeveelheid pariteit de bruikbare capaciteit, maar dat is de prijs voor betrouwbaarheid.
De afhankelijkheid van de prestaties ten opzichte van EC-schema's is bijna rechtlijnig: hoe meer 'stukken', hoe lager de prestaties; hierbij is een gebalanceerde blik vereist.
Deze aanpak stelt beheerders in staat om het uitgestrekte opslagsysteem maximaal flexibel te configureren. Binnen de ARDFS-pool kunnen verschillende fouttolerantieschema's en hun combinaties worden gebruikt, wat ook naar onze mening zeer nuttig is.
Hieronder staat een vergelijkingstabel van verschillende (niet alle mogelijke) RF- en EC-schema's.
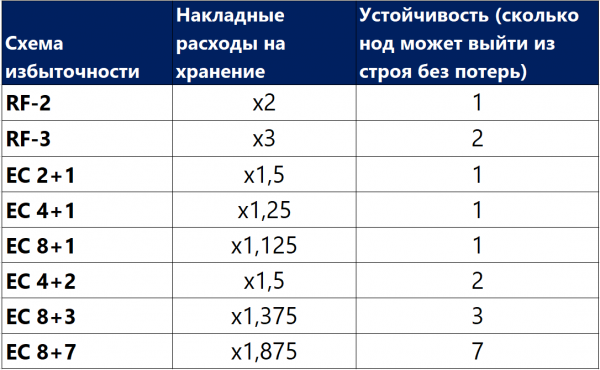
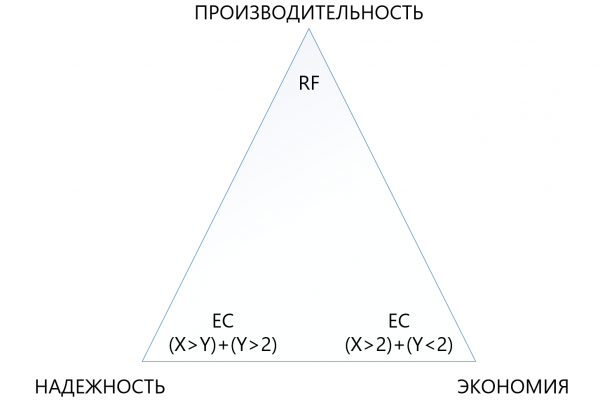
Uit de tabel blijkt dat zelfs de meest 'extreme' combinatie EC 8+7, die tegelijkertijd tot 7 knooppunten in de cluster kan verliezen, minder nuttige ruimte 'opslokt' (1,875 tegen 2) dan standaard replicatie, en 7 keer beter beschermd is, waardoor dit beschermingsmechanisme, hoewel complexer, veel aantrekkelijker wordt in situaties waar maximale betrouwbaarheid vereist is bij beperkte schijfruimte. Het is daarbij belangrijk te begrijpen dat elke 'plus' voor X of Y extra overhead op de prestaties met zich meebrengt, dus binnen de driehoek van betrouwbaarheid, besparingen en prestaties moet heel zorgvuldig worden gekozen. Om deze reden zullen we een apart artikel wijden aan de sizing van verwijderende codering.
Betrouwbaarheid en autonomie van het bestandssysteem
ARDFS wordt lokaal op alle knooppunten van de cluster uitgevoerd en synchroniseert deze via speciale Ethernet-interfaces met eigen middelen. Een belangrijk punt is dat ARDFS niet alleen gegevens, maar ook metadata met betrekking tot opslag zelfstandig synchroniseert. Tijdens het ontwikkelen van ARDFS hebben we parallel verschillende bestaande oplossingen bestudeerd en we hebben ontdekt dat veel synchronisatie van systeemmetadata van het bestandssysteem via een externe gedistribueerde database wordt gedaan, die we ook gebruiken voor synchronisatie, maar alleen voor configuraties en niet voor de metadata van het bestandssysteem (hierover en andere verwante subsystemen in het volgende artikel).
Metadata synchronisatie van het bestandssysteem met behulp van een externe database is natuurlijk een werkbare oplossing, maar dan zou de consistentie van de gegevens die op ARDFS zijn opgeslagen, afhankelijk zijn van de externe database en haar gedrag (en dat is, laten we eerlijk zijn, een wispelturig onderwerp), wat wij als een nadeel beschouwen. Waarom? Als de metadata van het bestandssysteem beschadigd raakt, kunnen de gegevens zelf ook 'tot ziens' zeggen, daarom hebben we besloten een moeilijkere, maar betrouwbaardere weg in te slaan.
We hebben het subsysteem voor metadata-synchronisatie voor ARDFS zelf ontwikkeld, en het werkt volledig onafhankelijk van de aangrenzende subsystemen. Met andere woorden, geen enkel ander subsysteem kan de gegevens van ARDFS beschadigen. Naar onze mening is dit de meest betrouwbare en juiste aanpak, maar of dat daadwerkelijk zo is, zal de tijd ons leren. Bovendien biedt deze aanpak een extra voordeel. ARDFS kan onafhankelijk van vAIR worden gebruikt, simpelweg als een uitgestrekte opslag, wat we zeker zullen benutten in toekomstige producten.
Uiteindelijke hebben we met de ontwikkeling van ARDFS een flexibel en betrouwbaar bestandssysteem gecreëerd, dat keuze biedt, waar je kunt besparen op capaciteit of alles op prestaties kunt inzetten, of de opslag superbetrouwbaar kunt maken tegen een redelijke prijs, maar de prestaties kunt verlagen.
Samen met een eenvoudige licentiepolitiek en een flexibele leveringsmodel (terugkijkend, vAIR wordt gelicentieerd per knooppunt en geleverd als software of als PAK) stelt dit ons in staat om de oplossing zeer precies af te stemmen op de diverse eisen van klanten en deze balans in de toekomst eenvoudig te behouden.
Voor wie is dit wonder nodig?
Enerzijds zou je kunnen zeggen dat er al spelers op de markt zijn met serieuze oplossingen op het gebied van hyperconvergentie, en waar wij eigenlijk in stappen. Het lijkt waar te zijn, MAAR...
Aan de andere kant, wanneer we ‘in het veld’ gaan en met klanten praten, zien wij en onze partners dat het helemaal niet zo is. Er zijn veel taken voor hyperconvergentie, soms wisten mensen gewoon niet dat zulke oplossingen bestaan, soms leek het te duur, soms waren er mislukte tests van alternatieve oplossingen, en soms is het zelfs verboden om te kopen vanwege sancties. Kortom, het veld bleek onontdekt, daarom zijn we begonnen om de woestenij te cultiveren))).
Wanneer is opslag beter dan hyperconvergentie?
Tijdens ons werk met de markt worden we vaak gevraagd wanneer het het beste is om de klassieke architectuur met opslagruimte (SХД) toe te passen en wanneer hyper-convergentie. Veel bedrijven die hyper-convergente systemen (GКС) produceren (vooral degenen zonder SХД in hun portfolio) zeggen: "SХД is achterhaald, alleen hyper-convergent!" Dit is een dappere uitspraak, maar het weerspiegelt de realiteit niet helemaal.
Eerlijk gezegd, de SХД-markt verschuift inderdaad richting hyper-convergentie en soortgelijke oplossingen, maar er is altijd een "maar".
Ten eerste, bestaande datacenters en IT-infrastructuren die volgens de klassieke architectuur met SХД zijn gebouwd, zijn niet zomaar opnieuw op te bouwen. Daarom is de modernisering en uitbreiding van dergelijke infrastructuren nog een erfgoed voor de komende 5-7 jaar.
Ten tweede, de infrastructuren die momenteel in massa worden gebouwd (we hebben het hier over Rusland) worden grotendeels gebouwd volgens de klassieke architectuur met het gebruik van SХД. Dit komt niet omdat mensen niet op de hoogte zijn van hyper-convergentie, maar omdat de hyper-convergente markt nieuw is, oplossingen en standaarden nog niet zijn gevestigd, IT-professionals nog niet opgeleid zijn, er weinig ervaring is, en datacenters moeten hier en nu worden gebouwd. Deze trend zal nog 3-5 jaar aanhouden (en dan hebben we nog het erfgoed, zie punt 1).
Ten derde is er een puur technische beperking van extra kleine vertragingen van 2 milliseconden bij het opslaan (zonder rekening te houden met de lokale cache, natuurlijk), die de prijs zijn voor gedistribueerde opslag.
En laten we het gebruik van grote fysieke servers niet vergeten, die houden van verticale schaalvergroting van het opslagsysteem.
Er zijn veel noodzakelijke en populaire taken waarbij SХД beter presteert dan GКС. Natuurlijk zullen fabrikanten zonder SХД in hun productportfolio het hier niet mee eens zijn, maar we zijn bereid om dit goed onderbouwd te betwisten. Uiteraard zullen we, als ontwikkelaars van beide producten, in een van onze toekomstige publicaties zeker een vergelijking maken tussen SХД en GКС, waarin we duidelijk zullen demonstreren under welke voorwaarden elk type beter is.
En waar zullen hyper-convergente oplossingen beter presteren dan SХД?
Op basis van de bovenstaande stellingen kunnen drie duidelijke conclusies worden getrokken:
- Daar waar extra 2 milliseconden vertraging bij opslag, die consistent ontstaan in elke productieve omgeving (momenteel gaat het niet om synthetische tests, daar kun je ook nanoseconden laten zien), niet kritisch zijn, is hyper-convergentie geschikt.
- Waar de belasting van grote fysieke servers kan worden omgezet in veel kleine virtuele servers en verdeeld over knooppunten, daar is hyper-convergentie ook goed inzetbaar.
- Waar horizontale schaling belangrijker is dan verticale schaling, daar zijn HCI-oplossingen ook geweldig.
Wat zijn dit voor oplossingen?
- Alle standaard infrastructuur diensten (directory service, e-mail, document beheer, file servers, kleine of gemiddelde ERP en BI systemen, enzovoort). We noemen dit 'gemeenschappelijke computing'.
- De infrastructuur van cloudproviders, waar snel en gestandaardiseerd horizontaal uitgebreid moet worden en eenvoudig een groot aantal virtuele machines voor klanten kan worden opgezet.
- Infrastructuur virtuele desktops (VDI), waar veel kleine gebruikers-verdere virtuele machines starten en rustig 'drijven' in een uniforme cluster.
- Filiaalnetwerken, waar in elk filiaal een standaard, fouttolerante, maar toch goedkope infrastructuur van 15-20 virtuele machines nodig is.
- Elke gedistribueerde computing (bijvoorbeeld big data-diensten). Waar de belasting niet 'diep' gaat, maar 'breed'.
- Testomgevingen, waar extra kleine vertragingen acceptabel zijn, maar er budgettaire beperkingen zijn, omdat dit tests zijn.
Op dit moment hebben we AERODISK vAIR precies voor deze taken ontwikkeld en richten we ons daarop (voorlopig met succes). Het kan binnenkort veranderen, aangezien de wereld niet stilstaat.
Dus...
Dit markeert het einde van het eerste deel van een grote cyclus van artikelen; in het volgende artikel zullen we het hebben over de architectuur van de oplossing en de gebruikte componenten.
We staan open voor vragen, suggesties en constructieve discussies.
Bron: habr.com
