

3. Structuurvarianten bij het gebruik van globalen
Een structuur zoals een geordende boom heeft verschillende specifieke gevallen. Laten we kijken naar diegenen die praktische waarde hebben bij het werken met globalen.
3.1 Specifiek geval 1. Eén knoop zonder takken
 Globalen kunnen niet alleen als een array worden gebruikt, maar ook als gewone variabelen. Bijvoorbeeld als een teller:
Set ^counter = 0  ; instellen van de teller
Set id=$Increment(^counter) ;  atomair incrementeer
Bij deze kan de global naast een waarde ook takken hebben. Het een sluit het ander niet uit.
3.2 Specifiek geval 2. Eén top en meerdere takken
Over het algemeen is dit een klassieke key-value database. En als we als waarde een tuple van waarden opslaan, krijgen we een gewone tabel met een primaire sleutel.
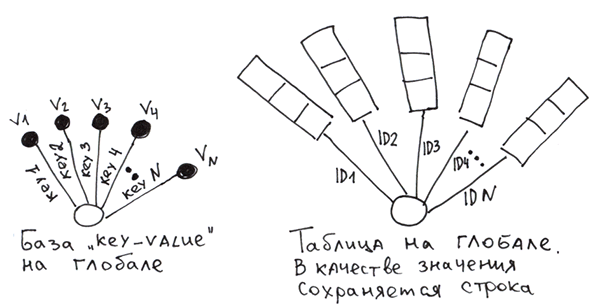
Om een tabel op globalen te implementeren, moeten we zelf de kolomwaarden tot rijen vormen, en deze dan in de global opslaan op basis van de primaire sleutel. Om bij het lezen de rij weer in kolommen te kunnen splitsen, kan men gebruikmaken van:
- scheidingstekens.
Set ^t(id1) = "col11/col21/col31" Set ^t(id2) = "col12/col22/col32" - een strikte schema, waarbij elk veld een vooraf gedefinieerd aantal bytes occupy. Zoals het in relationele databases gebeurt.
- een speciale functie $LB (beschikbaar in Cache), die een rij van waarden samenstelt.
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^t(id2) = $LB("col12", "col22", "col32")
Interessant is dat het maken van iets vergelijkbaars met secundaire indexen in relationele databases op globalen niet moeilijk is. We noemen deze structuren index-globalen. Een index-globalen is een hulpbomen voor snelle zoekopdrachten op velden die geen samengestelde delen van de primaire sleutel van de hoofdglobalen zijn. Voor het invullen en gebruik is extra code nodig.
Laten we een index-globalen maken op de eerste kolom.
Set ^i("col11", id1) = 1
Set ^i("col12", id2) = 1
Nu moeten we voor snelle informatieopvraging по de eerste kolom kijken in de global ^i en de primaire sleutels (id) vinden die overeenkomen met de gewenste waarde van de eerste kolom.
Bij het invoegen van een waarde kunnen we zowel de waarde als de index-globalen voor de benodigde velden direct aanmaken. En voor de betrouwbaarheid wikkelen we dit in een transactie.
TSTART
Set ^t(id1) = $LB("col11", "col21", "col31")
Set ^i("col11", id1) = 1
TCOMMIT
Details over hoe te maken in M , .
Deze tabellen zullen net zo snel werken als in traditionele databases (of zelfs sneller), als de functies voor het invoegen/bijwerken/verwijderen van rijen zijn geschreven in COS/M en gecompileerd zijn.Deze bewering heb ik getest met massale INSERT- en SELECT-commando's in een tabel met twee kolommen, inclusief het gebruik van de commando's TSTART en TCOMMIT (transacties).
Ik heb geen complexere scenario's getest met gelijktijdige toegang en parallelle transacties.
Zonder het gebruik van transacties was de snelheid van invoegen bij een miljoen waarden 778.361 invoegen/seconde.
Bij 300 miljoen waarden was dat 422.141 invoegen/seconde.
Bij gebruik van transacties was het 572.082 invoegen/seconde bij 50 miljoen invoegen. Alle bewerkingen werden uitgevoerd uit gecompileerde M-code.
De harde schijven zijn standaard, geen SSD's. RAID5 met Write-back. Processor Phenom II 1100T.
Voor een vergelijkbare test met een SQL-database moet je een opgeslagen procedure schrijven die in een lus invoegen uitvoert. Bij het testen van MySQL 5.5 (InnoDB-opslag) heb ik met deze methodiek geen cijfers gekregen die hoger zijn dan 11K invoegen per seconde.
Ja, de implementatie van tabellen in globals lijkt ingewikkelder dan in relationele databases. Daarom hebben industriële databases op globals SQL-toegang om het werken met tabelgegevens te vereenvoudigen.
 Als de datastructuur niet vaak verandert, is de invoegsnelheid niet kritiek en kan de hele database gemakkelijk worden gepresenteerd in genormaliseerde tabellen, is het makkelijker om met SQL te werken, omdat dit een hoger abstractieniveau biedt.
 In dit specifieke geval wilde ik laten zien dat globals kunnen fungeren als een constructeur voor het creëren van andere databases. Als een assembler waarop je andere talen kunt schrijven. En hier zijn voorbeelden van hoe je op globals equivalenten kunt creëren
Als je een niet-standaard database met minimale inspanning wilt creëren, is het de moeite waard om naar globals te kijken.
3.3 Specifiek geval 3. Twee-niveau boom, met een vast aantal takken per tweede niveau knooppunt
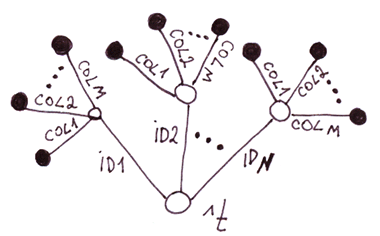 Je hebt waarschijnlijk al geraden: dit is een alternatieve implementatie van tabellen in globals. Laten we deze implementatie vergelijken met de vorige.
Tabellen in een twee-niveau boom vs. in een een-niveau boom.
Nadelen
Voordelen
- Langzamer voor invoegen, aangezien je het aantal knooppunten moet instellen gelijk aan het aantal kolommen.
- Hogere schijfruimte. Aangezien de globale indexen (zoals indices van arrays) met kolomnamen ruimte op de schijf innemen en gedupliceerd worden voor elke rij.
- Snellere toegang tot de waarden van afzonderlijke kolommen, omdat er geen behoefte is om de rij te parseren. Volgens mijn tests is het 11,5% sneller met 2 kolommen en nog meer met een groter aantal kolommen.
- Eenvoudiger om het gegevensschema te wijzigen
- Duidelijker code
Uitvoer: voor de liefhebber. Aangezien snelheid een van de belangrijkste voordelen van globalen is, heeft het bijna geen zin om deze implementatie te gebruiken, omdat het waarschijnlijk niet sneller zal werken dan tabellen in relationele databases.
3.4 Algemene situatie. Bomen en geordende bomen
Elke datastructuur die kan worden weergegeven in de vorm van een boom, past perfect op globalen.
3.4.1 Objecten met subobjecten
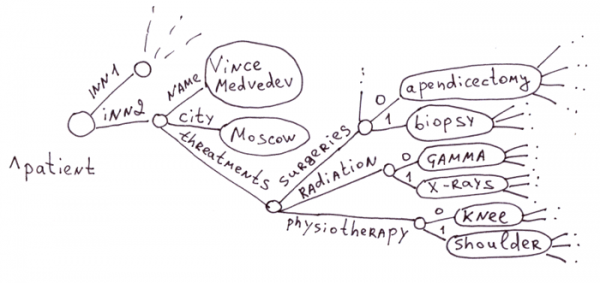
Dit is het traditionele toepassingsgebied van globalen. In de geneeskunde zijn er enorm veel ziekten, medicijnen, symptomen, behandelingsmethoden. Voor elke patiënt een tabel met miljoenen velden maken is niet efficiënt. Bovendien zouden 99% van de velden leeg zijn.
Stel je een SQL-database voor met tabellen: "patiënt" ~ 100.000 velden, "Medicijn" — 100.000 velden, "Therapie" — 100.000 velden, "Complicaties" — 100.000 velden, enz. of je kunt een database maken van duizenden tabellen, elk voor een specifiek type patiënt (en die kunnen elkaar overlappen!), behandelingen, medicijnen, en nog eens duizenden tabellen voor de relaties tussen deze tabellen.
Globalen zijn perfect voor de geneeskunde, omdat ze het mogelijk maken om voor elke patiënt een nauwkeurige beschrijving van zijn medische geschiedenis, verschillende therapieën, medicijnhandelingen, in de vorm van een boom te creëren, zonder onnodige schijfcapaciteit te verspillen aan lege kolommen, zoals dat het geval zou zijn in een relationele situatie.
 Met globalen is het handig om een database te maken met gegevens over mensen, wanneer het belangrijk is om zo veel mogelijk diverse informatie over de klant te verzamelen en te systematiseren. Dit is gewild in de geneeskunde, de banksector, marketing, archivering en andere gebieden
.
Zeker, in SQL is het ook mogelijk om een boom te emuleren met slechts een paar tabellen (, ,,,,,,,,,), maar dit is aanzienlijk moeilijker en zal trager werken. Je zou in wezen een globale structuur moeten schrijven die op tabellen werkt en al het werk met tabellen onder een abstractielaag moet verbergen. Het is onjuist om een lager-niveau technologie (globals) te emuleren met middelen van een hoger-niveau technologie (SQL). Het is niet praktisch.
Het is geen geheim dat het wijzigen van datamodellen in gigantische tabellen (ALTER TABLE) een aanzienlijke tijd kan duren. MySQL bijvoorbeeld, voert een ALTER TABLE ADD|DROP COLUMN uit door alle informatie van de oude naar de nieuwe tabel volledig te kopiëren (ik heb engines MyISAM en InnoDB getest). Dit kan een actieve database met miljarden records dagen, zo niet weken, vastzetten.
 Het veranderen van de datastructuur, wanneer we globals gebruiken, kost ons niets. Op elk moment kunnen we willekeurige nieuwe eigenschappen aan elk object toevoegen, op elk niveau van de hiërarchie. Wijzigingen met betrekking tot het hernoemen van takken kunnen op de achtergrond worden uitgevoerd terwijl de database actief is.
Daarom zijn globals een uitstekende keuze als het gaat om het opslaan van objecten met een groot aantal optionele eigenschappen.
Bovendien, laat me je herinneren, is de toegang tot elk van de eigenschappen onmiddellijk, aangezien in de global alle paden binaire bomen zijn.
Database op basis van globals zijn over het algemeen een soort documentgeoriënteerde databases, met de mogelijkheid om hiërarchische informatie op te slaan. Daarom kunnen globals concurreren met documentgeoriënteerde databases op het gebied van het opslaan van medische dossiers. Maar dat is nog steeds niet helemaal hetzelfde.Laten we ter vergelijking eens kijken naar MongoDB. In dit domein verliest het van globals om de volgende redenen:
- De documentgrootte. De eenheid van opslag is tekst in JSON-formaat (meer precies BSON) met een maximale grootte van ongeveer 16MB. Deze beperking is er speciaal om ervoor te zorgen dat de JSON-database niet traag wordt bij het parseren, als er een enorme JSON-document in is opgeslagen en daarna op velden moet worden geraadpleegd. In dit document moet alle informatie over de patiënt geconcentreerd zijn. We weten allemaal hoe dik patiëntendossiers kunnen zijn. De maximale grootte van 16MB voor een dossier stelt onmiddellijk een limiet aan patiënten wiens dossiers scans van MRI's, röntgenfoto's en andere onderzoeken bevatten. In één tak van de global kan echter informatie van gigabytes tot terabytes worden opgeslagen. In principe zou ik hier kunnen stoppen, maar ik ga door.
- Tijd voor bewustzijn/wijzigingen/verwijdering van nieuwe eigenschappen in de patiëntenkaart. Zo'n database moet de hele kaart in geheugen laden (dat is een grote hoeveelheid!), BSON parseren, een nieuwe knoop toevoegen/wijzigen/verwijderen, de indexen bijwerken, verpakken in BSON en op schijf opslaan. Voor de globale is het voldoende om gewoon naar een specifieke eigenschap te verwijzen en ermee te werken.
- Toegankelijkheid van afzonderlijke eigenschappen. Bij meerdere eigenschappen in het document en zijn hiërarchische structuur zal de toegang tot afzonderlijke eigenschappen sneller zijn omdat elk pad in globalen een B-tree is. In BSON moet het document daarentegen lineair worden geparsed om de benodigde eigenschap te vinden.
3.3.2 Associatieve arrays
Associatieve arrays (zelfs met geneste arrays) passen perfect in globalen. Bijvoorbeeld zo'n array uit PHP wordt weergegeven in de eerste afbeelding van 3.3.1.
$a = array(
  "name" => "Vince Medvedev",
  "city" => "Moscow",
  "threatments" => array(
    "surgeries" => array("apedicectomy", "biopsy"),
    "radiation" => array("gamma", "x-rays"),
    "physiotherapy" => array("knee", "shoulder")
  )
);
3.3.3 Hiërarchische documenten: XML, JSON
Worden ook gemakkelijk opgeslagen in globalen. Voor opslag kunnen verschillende indelingen worden gebruikt.
XML
De eenvoudigste manier om XML in globalen te structureren is door eigenschappen van tags in de knopen op te slaan. En als er snelle toegang tot tag-eigenschappen nodig is, kunnen we deze in aparte vertakkingen plaatsen.
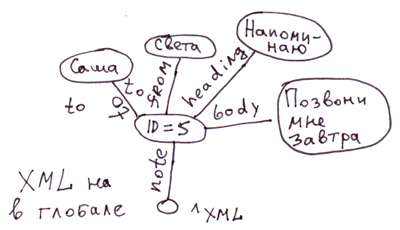
<note id="5">
<to>Vasya</to>
<from>Sveta</from>
<heading>Herinnering</heading>
<body>Bel me morgen!</body>
</note>
In COS zou dit overeenkomen met de code:
Set ^xml("note")="id=5"
Set ^xml("note","to")="Sasha"
Set ^xml("note","from")="Sveta"
Set ^xml("note","heading")="Herinnering"
Set ^xml("note","body")="Bel me morgen!"
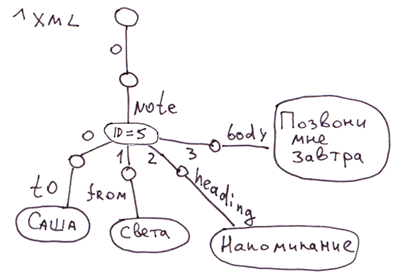
Opmerking: Voor XML, JSON, associatieve arrays kunnen veel verschillende manieren van representatie op globalen worden bedacht. In dit geval hebben we de volgorde van geneste tags in de tag note niet weerspiegeld. In de globalen ^xml worden geneste tags in alfabetische volgorde weergegeven. Voor een strikte weergave van de volgorde kan bijvoorbeeld deze representatie worden gebruikt:
JSON.
De eerste afbeelding in sectie 3.3.1 toont de representatie van dit JSON-document:
var document = {
  "name": "Vince Medvedev",
  "city": "Moscow",
  "threatments": {
    "surgeries": ["apedicectomy", "biopsy"],
    "radiation": ["gamma", "x-rays"],
    "physiotherapy": ["knee", "shoulder"]
  },
};
3.3.4 Gelijkaardige structuren met hiërarchische relaties
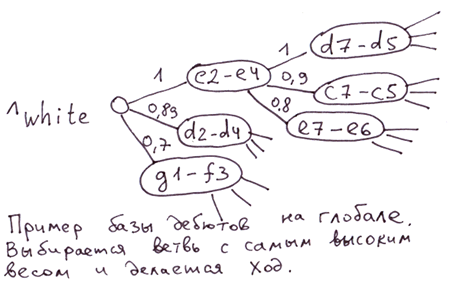
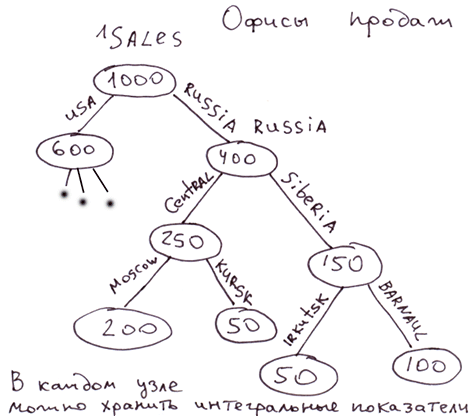
Voorbeelden: structuur van verkoopkantoren, locatie van mensen in een MLM-structuur, database van schaakopeningen.
Database van openingen. Je kunt de waarde van de globale knooppuntindex gebruiken als een beoordeling van de kracht van de zet. Om de sterkste zet te kiezen, hoef je alleen maar takken met het grootste gewicht te selecteren. In de globale structuur zullen alle takken op elk niveau worden gesorteerd op kracht van de zet.
De structuur van verkooppunten, de structuur van mensen in MLM. In de knooppunten kunnen bepaalde cache-waarden worden opgeslagen die de kenmerken van de hele subboom weerspiegelen. Bijvoorbeeld, de verkoopvolumes van deze subboom. Op elk moment kunnen we een cijfer verkrijgen dat de prestaties van elke tak weerspiegelt.
4. In welke gevallen is het het voordeligst om globals te gebruiken.
In de eerste kolom staan de gevallen waarin je aanzienlijke winst in snelheid zult behalen door globals te gebruiken, en in de tweede kolom wanneer de ontwikkeling of datamodel vereenvoudigd wordt.
Snelheid
Gemak van gegevensverwerking/voorstelling.
- Invoegen [met automatische sortering op elk niveau], [indexeren op de primaire sleutel].
- Verwijdering van subbomen.
- Objecten met een hoge mate van geneste eigenschappen waarvoor individuele toegang nodig is.
- Hiërarchische structuur met de mogelijkheid om kindertakken te doorlopen, zelfs als ze niet bestaan.
- Diepgaande traversering van subbomen.
- Objecten/entiteiten met een enorme hoeveelheid optionele [en/of geneste] eigenschappen/entiteiten.
- Schema-loze gegevens. Wanneer nieuwe eigenschappen vaak kunnen ontstaan en oude kunnen verdwijnen.
- Er moet een niet-standaard database worden gemaakt.
- Pads en besluitbomen. Wanneer paden handig kunnen worden weergegeven als een boom.
- Verwijdering van hiërarchische structuren zonder gebruik te maken van recursie.
Vervolg .
Disclaimer: Dit artikel en mijn opmerkingen hierover zijn mijn mening en hebben geen relatie met de officiële positie van de onderneming InterSystems.
Bron: habr.com
