

Ik nodig u uit om de transcriptie van de lezing van eind 2019 door Alexander Valjalkin "Go optimalisaties in VictoriaMetrics" te bekijken.
— een snelle en schaalbare DBMS voor het opslaan en verwerken van gegevens in de vorm van tijdreeksen (een record vormt tijd en een set bijbehorende waarden voor die tijd, bijvoorbeeld verkregen door periodieke polls van sensorstatussen of het verzamelen van statistieken).
Hier is de link naar de video van deze lezing —
Laat me een beetje over mezelf vertellen. Ik ben Alexander Valjalkin. Hier is . Ik ben gepassioneerd door Go en prestatie-optimalisatie. Ik heb veel verschillende nuttige en minder nuttige bibliotheken geschreven. Ze beginnen meestal met fast, of met quick de prefix.
Op dit moment werk ik aan VictoriaMetrics. Wat is het en wat doe ik daar? Daarover zal ik in deze presentatie vertellen.
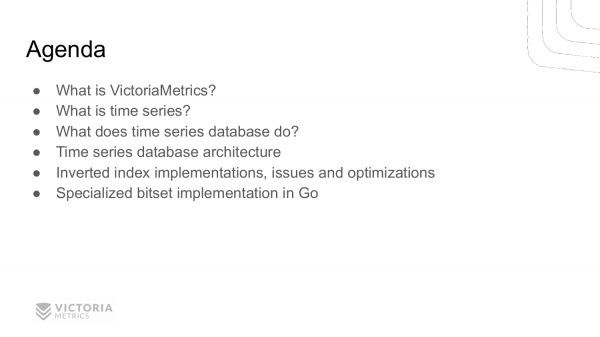
Het plan voor de lezing is als volgt:
- In het begin vertel ik u wat VictoriaMetrics is.
- Daarna leg ik uit wat tijdreeksen zijn.
- Vervolgens vertel ik hoe een tijdreeksdatabase werkt.
- Daarna bespreek ik de architectuur van de database: waaruit deze bestaat.
- En dan gaan we naar de optimalisaties die aanwezig zijn in VictoriaMetrics. Dit betreft de optimalisatie van de omgekeerde index en optimalisatie voor bitset-implementatie op Go.
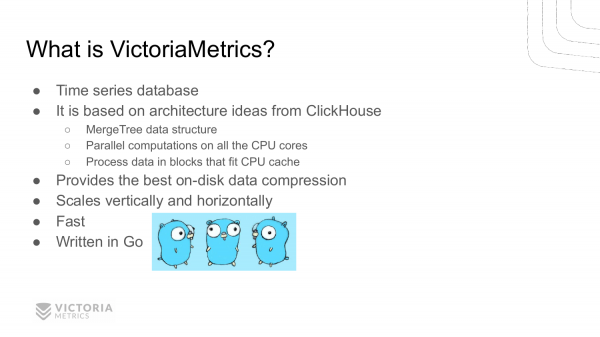
Weet iemand in de zaal wat VictoriaMetrics is? Wauw, al veel mensen weten het. Dit is goed nieuws. Voor degenen die het niet weten: het is een database voor tijdreeksen. Het is gebaseerd op de architectuur van ClickHouse, op sommige details van de implementatie van ClickHouse. Bijvoorbeeld, dingen zoals: MergeTree, parallelle uitvoering op alle beschikbare CPU-kernen en prestatieoptimalisatie door te werken met datablokken die in de CPU-cache worden geplaatst.
VictoriaMetrics biedt de beste gegevenscompressie vergeleken met andere databases voor tijdreeksen.
Het schaalt verticaal — dat wil zeggen, u kunt meer processors en meer RAM aan één computer toevoegen. VictoriaMetrics maakt met succes gebruik van deze beschikbare bronnen en verhoogt de lineaire prestaties.
VictoriaMetrics schaalt ook horizontaal — dat wil zeggen, u kunt extra knooppunten aan de VictoriaMetrics-cluster toevoegen, en de prestaties zullen bijna lineair groeien.
Zoals u al vermoedden, is VictoriaMetrics een snelle database, want ik kan geen andere schrijven. En het is geschreven in Go, daarom vertel ik hierop deze meet-up.
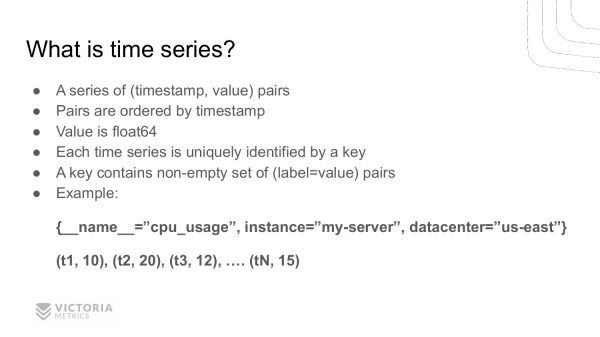
Wie weet wat een tijdreeks is? Ook veel mensen weten dit. Een tijdreeks is een reeks paren (timestamp, waarde), waarbij deze paren op tijd zijn gesorteerd. De waarde is een zwevend getal – float64.
Elke tijdreeks wordt uniek geïdentificeerd door een sleutel. Waaruit bestaat deze sleutel? Deze bestaat uit een niet-lege set van sleutel-waarde paren.
Hier is een voorbeeld van een tijdreeks. De sleutel van deze reeks is een lijst van paren: __name__="cpu_usage" – dit is de naam van de metriek, instance="my-server" – dit is de computer waarop deze metriek is verzameld, datacenter="us-east" – dit is het datacenter waar deze computer staat.
We hebben de naam van de tijdreeks, bestaande uit drie sleutel-waarde paren. Deze sleutel komt overeen met een lijst van paren (timestamp, value). t1, t3, t3, ..., tN – dit zijn timestamps, 10, 20, 12, ..., 15 – de overeenkomstige waarden. Dit is het cpu-gebruik op dit moment voor deze reeks.
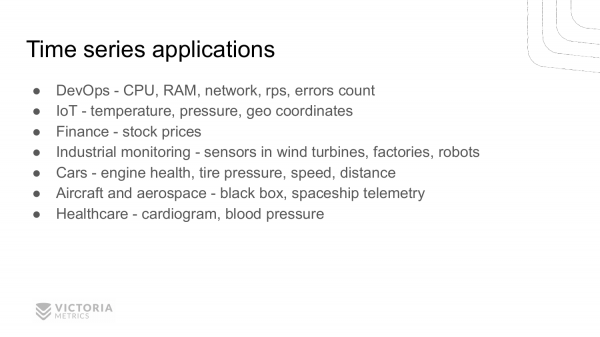
Waar kunnen tijdreeksgegevens worden gebruikt? Heeft iemand ideeën?
- In DevOps kunnen we de CPU-, RAM-, netwerk-, rps-, foutenaantallen etc. meten.
- IoT – we kunnen temperatuur, druk, geolocaties en nog meer meten.
- Ook in de financiële sector – we kunnen de prijzen van verschillende aandelen en valuta's monitoren.
- Bovendien kunnen tijdreeksen worden gebruikt voor het monitoren van productieprocessen in fabrieken. We hebben gebruikers die VictoriaMetrics gebruiken voor het monitoren van windturbines en voor robots.
- Tijdreeksen zijn ook nuttig voor het verzamelen van informatie van sensoren van verschillende apparaten. Bijvoorbeeld, voor een motor; voor het meten van de druk in banden; voor het meten van snelheid, afstand; voor het meten van brandstofverbruik, enz.
- Tijdreeksen kunnen ook worden gebruikt voor het monitoren van vliegtuigen. In elk vliegtuig is er een zwarte doos die tijdreeksen verzamelt van verschillende gezondheidsparameters van het vliegtuig. Tijdreeksen worden ook gebruikt in de luchtvaartindustrie.
- Gezondheidszorg – dit betreft bloeddruk, pols, enz.
Misschien zijn er nog meer toepassingen die ik vergeten ben, maar ik hoop dat jullie begrijpen dat tijdreeksen actief worden gebruikt in de moderne wereld. En het volume van hun gebruik groeit elk jaar.
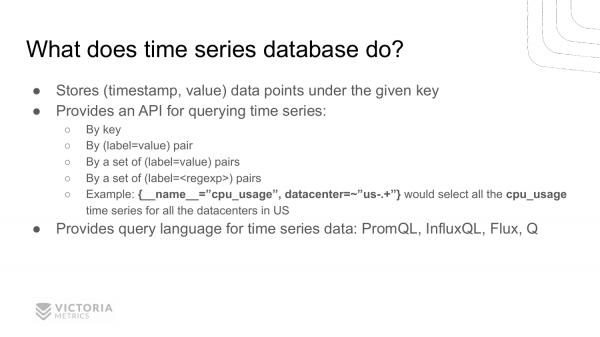
Waarom heeft een database voor tijdreeksen nodig? Waarom kan men geen reguliere relationele database gebruiken voor het opslaan van tijdreeksen?
Omdat tijdreeksen meestal een grote hoeveelheid informatie bevatten die moeilijk op te slaan en te verwerken is in normale databases. Daarom zijn er gespecialiseerde databases voor tijdreeksen ontstaan. Deze databases slaan punten efficiënt op (timestamp, value) met een specifieke sleutel. Ze bieden een API om opgeslagen gegevens op te vragen via de sleutel, één sleutel-waarde paar, meerdere van deze paren of via regexp. Bijvoorbeeld, als u de CPU-belasting van al uw services in het datacenter in Amerika wilt vinden, moet u deze pseudo-query gebruiken.
Gewoonlijk bieden databases voor tijdreeksen gespecialiseerde querytalen aan, omdat SQL voor tijdreeksen niet erg goed geschikt is. Hoewel er databases zijn die SQL ondersteunen, is het niet erg goed toepasbaar. Betere querytalen zijn zoals , , , . Ik hoop dat iemand minstens één van deze talen heeft gehoord. Over PromQL heeft waarschijnlijk veel mensen gehoord. Dit is de querytaal van Prometheus.
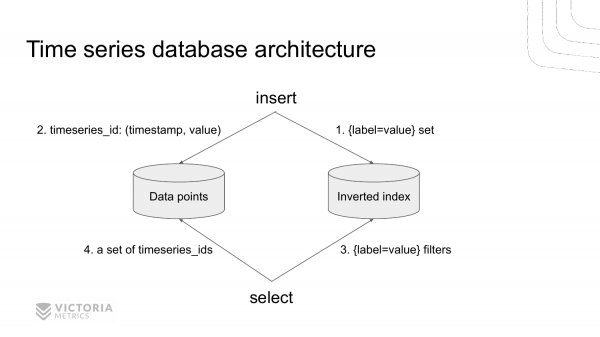
Zo ziet de architectuur van een moderne database voor tijdreeksen eruit, aan de hand van VictoriaMetrics.
Het bestaat uit twee delen. Een opslag voor de omgekeerde index en een opslag voor de waarden van tijdreeksen. Deze opslagplaatsen zijn gescheiden.
Wanneer er een nieuwe invoer in de database komt, raadplegen we eerst de omgekeerde index om de identificatie van de tijdreeks te vinden op basis van de opgegeven set label=value voor deze metric. We vinden deze identificatie en slaan de waarde op in de gegevensopslag.
Wanneer er een verzoek binnenkomt om gegevens uit de TSDB op te halen, kijken we eerst in de omgekeerde index. We halen alle timeseries_ids records op die overeenkomen met de opgegeven set. label=valueVervolgens halen we alle noodzakelijke gegevens op uit de opgeslagen gegevens, geïndexeerd op timeseries_ids.
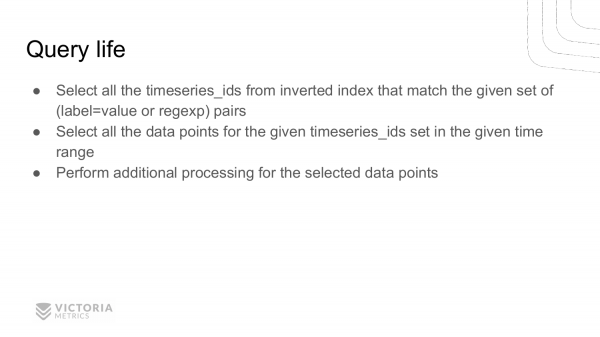
Laten we een voorbeeld bekijken van hoe een database voor tijdreeksen een inkomend select-verzoek verwerkt.
- Als eerste haalt het alle
timeseries_idsgegevens uit de omgekeerde index die de opgegeven paren bevattenlabel=value, of voldoen aan de opgegeven reguliere expressie. - Daarna haalt het alle data points uit de gegevensopslag over de opgegeven tijdsperiode voor de gevonden
timeseries_ids. - Daarna voert de database berekeningen uit op deze data points, volgens het verzoek van de gebruiker. En vervolgens geeft het antwoord terug.
In deze presentatie zal ik u vertellen over het eerste deel. Dit is de zoektocht timeseries_ids naar de omgekeerde index. U kunt later het tweede en derde deel bekijken , of wachten totdat ik andere presentaties heb voorbereid 🙂
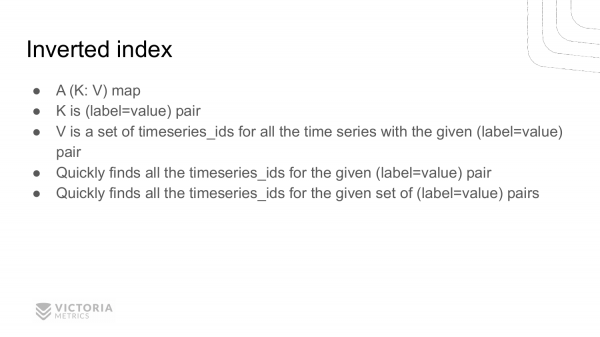
Laten we beginnen met de omgekeerde index. Veel mensen kunnen denken dat dit eenvoudig is. Wie weet wat een omgekeerde index is en hoe het werkt? Oh, al niet zoveel mensen. Laten we proberen te begrijpen wat het is.
Eigenlijk is het heel eenvoudig. Het is gewoon een woordenboek dat een sleutel aan een waarde koppelt. Wat is een sleutel? Dit paar label=value, waar label en value is een reeks. En de waarden zijn een set timeseries_ids, die het opgegeven paar bevat label=value.
Een omgekeerde index maakt het mogelijk om snel alle timeseries_ids, te vinden die bepaalde label=value.
En het maakt het ook mogelijk om snel te vinden timeseries_ids tijdreeksen voor meerdere paren label=value, of voor paren label=regexp. Hoe gebeurt dit? Door het vinden van de doorsnede van een verzameling timeseries_ids voor elk paar label=value.
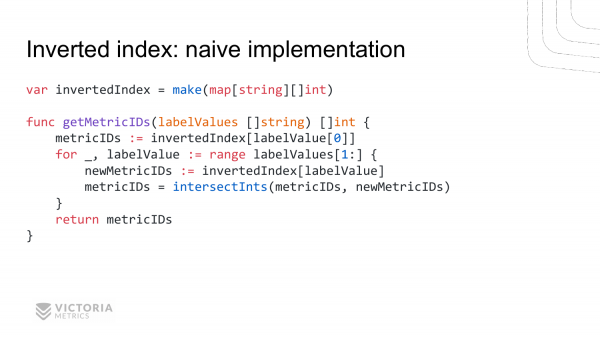
Laten we verschillende implementaties van de omgekeerde index bekijken. We beginnen met de eenvoudigste naïeve implementatie. Het ziet er als volgt uit.
Functie getMetricIDs krijgt een lijst van reeksen. Elke reeks bevat label=value. Deze functie retourneert een lijst metricIDs.
Hoe werkt dit? Hier hebben we een globale variabele genaamd invertedIndex. Dit is een gewone woordenboek (map), die een reeks aan een slice van int's koppelt. De reeks bevat label=value.
Implementatie van de functie: we halen metricIDs voor de eerste label=value, dan lopen we door alle andere label=value, we halen metricIDs voor hen. En we roepen de functie aan intersectInts, waarover later meer zal worden verteld. En deze functie retourneert de doorsnede van deze lijsten.
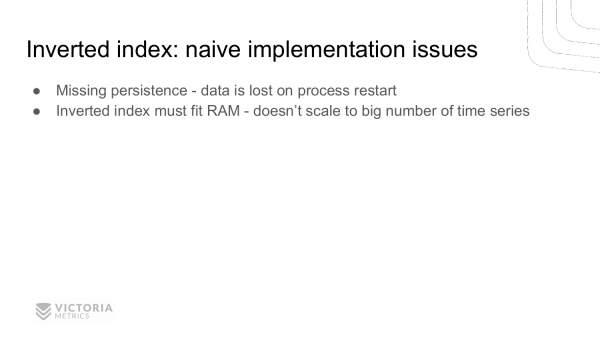
Zoals u kunt zien, is de implementatie van de omgekeerde index niet zo moeilijk. Maar dit is een naïeve implementatie. Wat zijn de nadelen? Het grootste nadeel van de naïeve implementatie is dat zo'n omgekeerde index in ons werkgeheugen wordt opgeslagen. Na het opnieuw opstarten van de applicatie raken we deze index kwijt. Er is geen opslag van deze index op de schijf. Voor een database is zo'n omgekeerde index waarschijnlijk niet geschikt.
Een tweede nadeel is ook gerelateerd aan geheugen. De omgekeerde index moet in het werkgeheugen passen. Als deze groter wordt dan de grootte van het werkgeheugen, dan krijgen we vanzelfsprekend een out of memory-fout. En het programma zal niet werken.
Dit probleem kan worden opgelost met behulp van kant-en-klare oplossingen zoals , ofwel .
In het kort hebben we een database nodig die snel drie operaties kan uitvoeren.
- De eerste operatie is het schrijven
van sleutel-waardein deze database. Dit doet het heel snel, waarbijvan sleutel-waardede willekeurige strings zijn. - De tweede operatie is een snelle zoekopdracht naar een waarde op basis van een gegeven sleutel.
- En de derde operatie is een snelle zoekopdracht naar alle waarden op basis van een gegeven prefix.
LevelDB en RocksDB zijn databases die zijn ontwikkeld door Google en Facebook. Eerst kwam LevelDB. Daarna namen de mensen van Facebook LevelDB en verbeterden het, wat leidde tot RocksDB. Momenteel draait bijna alle interne database binnen Facebook op RocksDB, ook hebben ze MySQL naar RocksDB gemigreerd. Ze noemden het .
Een omgekeerde index kan worden geïmplementeerd met behulp van LevelDB. Hoe doe je dat? We slaan op als sleutel label=value. En als waarde de identificatie van de tijdreeks waar het paar aanwezig is. label=value.
Als we veel tijdreeksen hebben met dit paar label=value, dan zullen er veel regels in deze database zijn met dezelfde sleutel en verschillende timeseries_ids. Om een lijst van alle timeseries_ids, die beginnen met deze label=prefix, maken we een range scan, waarvoor deze database geoptimaliseerd is. Dat wil zeggen, we kiezen alle regels die beginnen met label=prefix en krijgen de benodigde timeseries_ids.
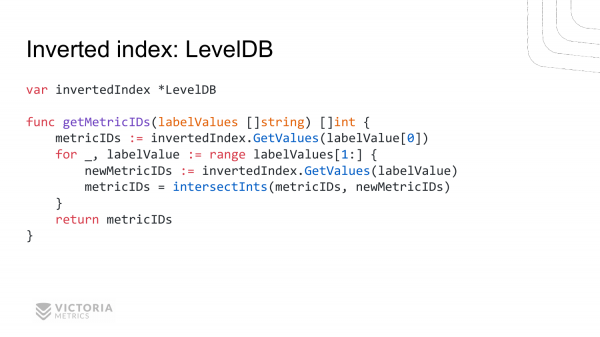
Hier is een voorbeeldimplementatie van hoe het eruit zou zien in Go. We hebben een omgekeerde index. Dit is LevelDB.
De functie is dezelfde als bij de naïeve implementatie. Het herhaalt bijna regel voor regel de naïeve implementatie. Het enige verschil is dat we in plaats van aan te roepen map we de omgekeerde index aanroepen. We halen alle waarden voor de eerste label=value. Dan lopen we door alle overgebleven paren label=value en halen de bijbehorende sets metricIDs voor hen. Vervolgens vinden we de doorsnede.
Het lijkt allemaal goed, maar deze oplossing heeft nadelen. VictoriaMetrics heeft aanvankelijk de omgekeerde index op basis van LevelDB geïmplementeerd. Maar uiteindelijk moesten ze daar vanaf zien.
Waarom? Omdat LevelDB langzamer is dan de naïeve implementatie. In de naïeve implementatie halen we onmiddellijk de gehele slice op voor de gegeven sleutel. metricIDsDit is een zeer snelle operatie — de hele slice is klaar voor gebruik.
Bij LevelDB moet je echter bij elke aanroep van de functie GetValues alle regels doorlopen die beginnen met label=value. En voor elke regel de waarde ophalen timeseries_ids. Van zulke timeseries_ids verzamel je de slice van deze timeseries_ids. Het is duidelijk dat dit veel langzamer is dan gewoon de normale map op sleutel aanroepen.
Een tweede nadeel is dat LevelDB in C is geschreven. Het aanroepen van C-functies vanuit Go is niet erg snel. Het kost honderden nanoseconden. Dit is niet snel, omdat het in vergelijking met een gewone functie-aanroep, geschreven in Go, die 1-5 nanoseconden kost, tientallen keren langzamer is. Voor VictoriaMetrics was dit een fatale tekortkoming 🙂
Daarom heb ik mijn eigen implementatie van een omgekeerde index geschreven. En ik heb het genoemd .
Mergeset is gebaseerd op de datastructuur MergeTree. Deze datastructuur is overgenomen van ClickHouse. Het is duidelijk dat mergeset geoptimaliseerd moet zijn voor snelle zoekopdrachten timeseries_ids op een gegeven sleutel. Mergeset is volledig in Go geschreven. Je kunt bekijken . De implementatie van mergeset bevindt zich in een mapje . Je kunt proberen te begrijpen wat daar gebeurt.
De API van mergeset lijkt sterk op die van LevelDB en RocksDB. Dit betekent dat het snel nieuwe records kan opslaan en snel records kan ophalen op basis van een gegeven prefix.
Over de nadelen van mergeset zullen we later praten. Laten we nu bespreken welke problemen er bij VictoriaMetrics in productie zijn ontstaan bij de implementatie van de omgekeerde index.
Waarom zijn ze ontstaan?
De eerste reden is de hoge churn rate. In het Nederlands betekent dit de frequente wisseling van tijdseries. Dit gebeurt wanneer een tijdserie eindigt en er een nieuwe begint, of wanneer er veel nieuwe tijdseries beginnen. Dit komt vaak voor.
De tweede reden is het grote aantal tijdseries. In het begin, toen monitoring populair werd, was het aantal tijdseries klein. Bijvoorbeeld, voor elke computer moet je de belasting van de CPU, het geheugen, het netwerk en de schijf monitoren. 4 tijdseries per computer. Stel dat je 100 computers hebt, dan zijn dat 400 tijdseries. Dit is erg weinig.
In de loop van de tijd hebben mensen bedacht dat je gedetailleerdere informatie kunt meten. Bijvoorbeeld, in plaats van alleen de belasting van de hele CPU te meten, kun je de belasting van elk CPU-kern afzonderlijk meten. Als je 40 CPU-cores hebt, heb je dus 40 keer meer tijdseries om de belasting van de CPU te meten.
Maar dat is nog niet alles. Elke processor core kan verschillende staten hebben, zoals idle, wanneer deze niet actief is. Daarnaast is er het gebruik in de user space, het gebruik in de kernel space en andere staten. En elke staat kan ook gemeten worden als een aparte tijdreeks. Dit verhoogt het aantal reeksen met 7 tot 8 keer.
We hebben uit één metriek 40 x 8 = 320 metrische waarden alleen voor één computer verkregen. Vermenigvuldig dit met 100, en we krijgen 32.000 in plaats van 400.
Daarna kwam Kubernetes. En dat heeft het nog erger gemaakt, omdat in Kubernetes veel verschillende services kunnen worden gehost. Elke service in Kubernetes bestaat uit veel pods. Dit moet allemaal gemonitord worden. Bovendien hebben we een constante uitrol van nieuwe versies van jouw services. Voor elke nieuwe versie moeten nieuwe tijdreeksen worden aangemaakt. Uiteindelijk groeit het aantal tijdreeksen exponentieel en komen we de uitdaging tegen van het grote aantal tijdreeksen, wat high-cardinality wordt genoemd. VictoriaMetrics gaat hiermee succesvol om in vergelijking met andere tijdreeks databases.
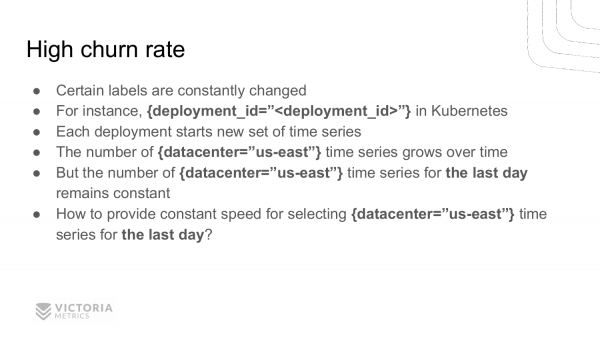
Laten we high churn rate nader bekijken. Wat veroorzaakt high churn rate in productie? Omdat bepaalde waarden van labels en tags voortdurend veranderen.
Neem bijvoorbeeld Kubernetes, waarin het begrip bestaat. deployment, dat is wanneer een nieuwe versie van jouw applicatie wordt uitgerold. De ontwikkelaars van Kubernetes besloten om de id van de deployment toe te voegen aan het label.
Wat heeft dit veroorzaakt? Dat onze oude tijdreeksen bij elke nieuwe deployment worden onderbroken, en in plaats daarvan beginnen nieuwe tijdreeksen met een nieuwe label waarde. deployment_id. Dergelijke reeksen kunnen honderden duizenden en zelfs miljoenen zijn.
Een belangrijke functie hiervan is dat het totale aantal tijdreeksen toeneemt, maar het aantal tijdreeksen dat momenteel actief is en waar gegevens naartoe worden gestuurd, constant blijft. Deze toestand wordt high churn rate genoemd.
Het voornaamste probleem van high churn rate is het waarborgen van een constante zoek snelheid voor alle tijdreeksen op basis van een opgegeven set van labels over een bepaalde tijdsperiode. Gewoonlijk is dit een tijdsperiode van het afgelopen uur of de afgelopen dag.
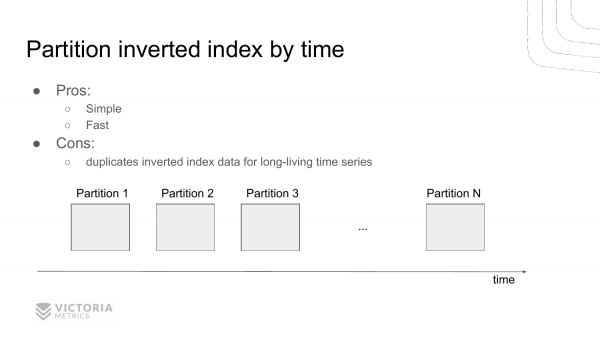
Hoe los je dit probleem op? Hier is de eerste optie. We splitsen de omgekeerde index in onafhankelijke delen op tijd. Dat wil zeggen, er verstrijkt een bepaalde tijdsperiode, we stoppen met het werken met de huidige omgekeerde index. En we maken een nieuwe omgekeerde index aan. Nog een andere tijdsperiode verstrijkt en we maken weer een nieuwe index aan.
Bij het ophalen van deze omgekeerde indices vinden we een set omgekeerde indices die binnen het opgegeven interval vallen. En dus kiezen we daaruit de id's van de tijdreeksen.
Dit bespaart middelen omdat we geen delen hoeven te doorlopen die niet binnen het opgegeven interval vallen. Dat wil zeggen, meestal, als we gegevens van het afgelopen uur kiezen, slaan we de verzoeken voor de vorige tijdsintervallen over.
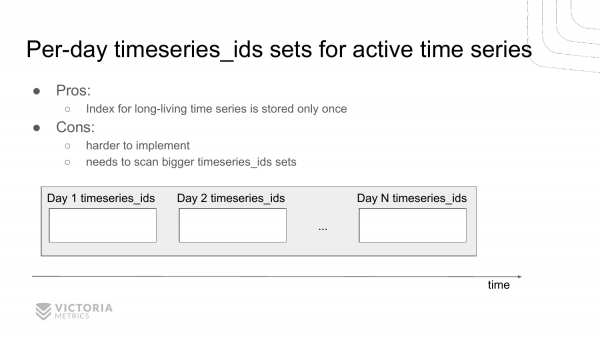
Er is nog een andere oplossing voor dit probleem. Dit is het bijhouden van een aparte lijst van id's van tijdreeksen voor elke dag, die op die dag zijn voorgekomen.
Het voordeel van deze oplossing ten opzichte van de vorige oplossing is dat we geen informatie over tijdreeksen dupliceren die niet verdwijnen in de loop van de tijd. Ze zijn constant aanwezig en veranderen niet.
Het nadeel is dat zo'n oplossing moeilijker te implementeren en te debuggen is. En VictoriaMetrics heeft voor deze oplossing gekozen. Dit is historisch zo ontstaan. Deze oplossing presteert ook goed in vergelijking met de vorige. Omdat deze oplossing niet is gerealiseerd vanwege de noodzaak om gegevens in elke partition te dupliceren voor tijdreeksen die niet veranderen, dat wil zeggen, die niet verdwijnen in de loop van de tijd. VictoriaMetrics is in de eerste plaats geoptimaliseerd voor schijfruimteverbruik, en de vorige implementatie verslechterde het schijfruimteverbruik. Deze implementatie is beter voor het minimaliseren van schijfruimteverbruik, daarom is deze gekozen.
We moesten ermee strijden. De strijd bestond eruit dat we in deze implementatie alsnog aanzienlijk meer moesten kiezen timeseries_ids voor gegevens dan wanneer de omgekeerde index op tijd is gesplitst.
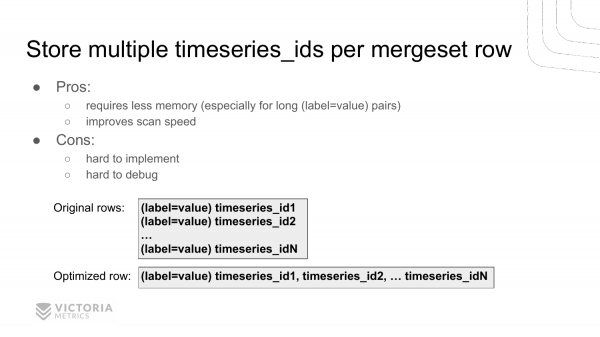
Hoe hebben we dit probleem opgelost? We hebben het op een originele manier opgelost - door meerdere identificators van tijdreeksen in elke record van de omgekeerde index op te slaan in plaats van één identificator. Dat wil zeggen, we hebben een sleutel label=value, dat in elke tijdreeks voorkomt. En nu bewaren we meerdere timeseries_ids in één record.
Hier is een voorbeeld. Vroeger hadden we N records, en nu hebben we één record waarvan het prefix hetzelfde is als dat van alle andere. Het vorige record bevatte alle id's van de tijdreeksen.
Dit heeft de scansnelheid van zo'n omgekeerde index tot 10 keer verhoogd. En het heeft het geheugengebruik voor de cache verminderd, omdat we nu de string label=value slechts één keer in de cache opslaan in plaats van N keer. En deze string kan groot zijn als je lange strings in de tags en labels opslaat, die Kubernetes graag erin stopt.
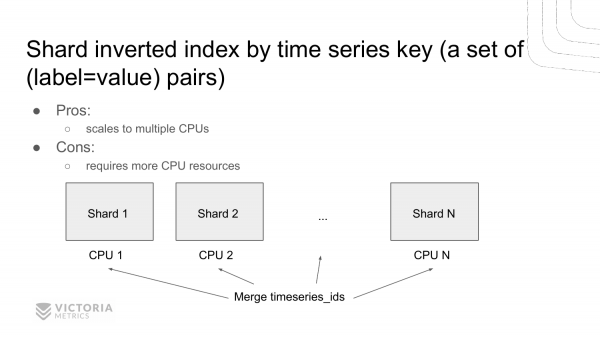
Een andere manier om de zoekopdracht in de omgekeerde index te versnellen, is sharding. Maak meerdere omgekeerde indexen in plaats van één en shard de gegevens tussen hen op sleutel. Dit zijn een set key=value paren. Dat wil zeggen, we krijgen verschillende onafhankelijke omgekeerde indexen die we parallel op meerdere processors kunnen ondervragen. Eerdere implementaties konden alleen in één processor modus werken, dat wil zeggen, gegevens alleen op één core scannen. Deze oplossing maakt het mogelijk om gegevens onmiddellijk op meerdere cores te scannen, zoals ClickHouse graag doet. Dit is wat we van plan zijn om te implementeren.
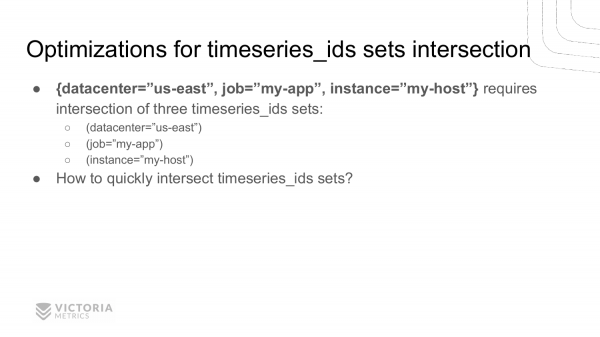
En laten we nu terugkeren naar onze schapen – naar de functie van de intersectie timeseries_ids. Laten we bekijken welke implementaties mogelijk zijn. Deze functie stelt ons in staat om te vinden timeseries_ids voor een gegeven set label=value.
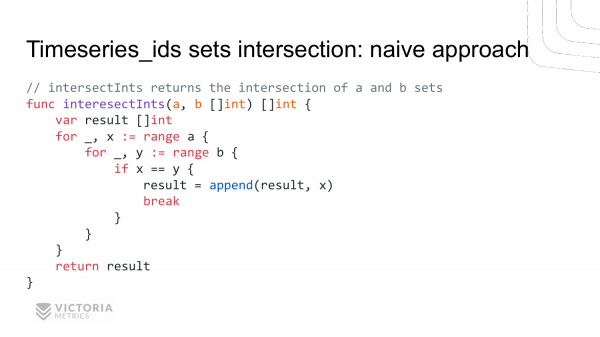
De eerste optie is de naïeve implementatie. Twee geneste lussen. Hier krijgen we de invoer van de functie intersectInts twee slices — a en b. Als uitvoer moet het ons de intersectie van deze slices teruggeven.
De naïeve implementatie ziet er als volgt uit. We lopen door alle waarden van de slice a, binnen deze lus lopen we door alle waarden van de slice b. En we vergelijken ze. Als ze gelijk zijn, hebben we de intersectie gevonden. En we slaan het op in resultaat.
Wat zijn de nadelen? Kwadratische complexiteit — dat is haar belangrijkste nadeel. Bijvoorbeeld, als je slices van a en b één miljoen hebt, zal deze functie je nooit een antwoord teruggeven. Omdat het een triljoen iteraties moet maken, wat erg veel is, zelfs voor moderne computers.
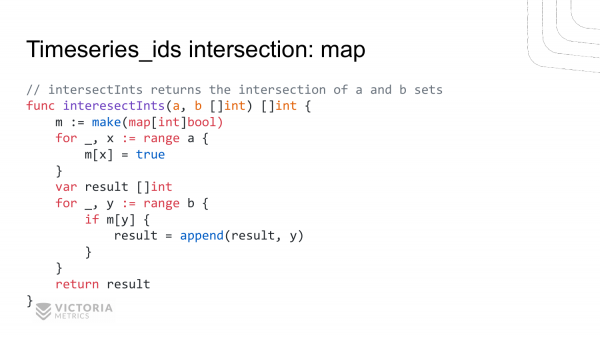
De tweede implementatie is gebaseerd op een map. We maken een map. We plaatsen alle waarden uit de slice a. Vervolgens lopen we met een aparte lus door de slice b. En we controleren – is deze waarde uit de slice aanwezig? b in map. Als het er is, voegen we het toe aan het resultaat.
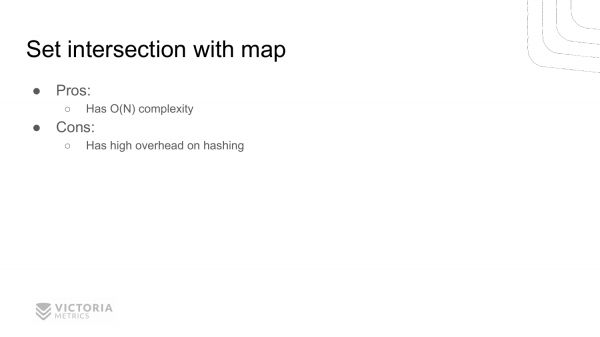
Wat zijn de voordelen? Het voordeel is dat hier alleen lineaire complexiteit is. Dat wil zeggen, de functie wordt veel sneller uitgevoerd voor grote afmetingen van slices. Voor een slice van een miljoen elementen wordt deze functie uitgevoerd in 2 miljoen iteraties, in tegenstelling tot een triljoen iteraties zoals in de vorige functie.
Een nadeel is dat deze functie meer geheugen vereist om deze map te maken.
Een tweede nadeel is de grote overhead voor hashing. Dit nadeel is niet heel voor de hand liggend. Ook voor ons was het niet zo voor de hand liggend, daarom was in het begin de implementatie van de intersection in VictoriaMetrics via map. Maar latere profiling toonde aan dat de meeste CPU-tijd ging naar schrijven in de map en het controleren van de aanwezigheid van waarden in deze map.
Waarom wordt er in deze gevallen CPU-tijd besteed? Omdat Go in deze regels de hashing-operatie uitvoert. Dat wil zeggen, het berekent de hash van de sleutel om vervolgens op de gegeven index in de HashMap te kunnen verwijzen. De hash-berekeningsoperatie vindt plaats in tientallen nanoseconden. Dit is traag voor VictoriaMetrics.
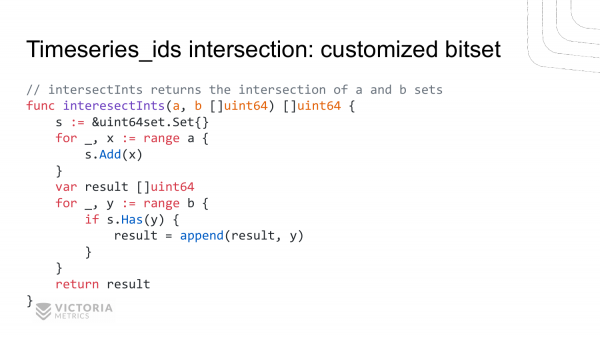
Ik besloot een bitset te implementeren, speciaal geoptimaliseerd voor deze situatie. Zo ziet de intersection van twee slices er nu uit. We maken hier een bitset aan. We voegen elementen uit de eerste slice toe. Vervolgens controleren we de aanwezigheid van deze elementen in de tweede slice. En voegen ze toe aan het resultaat. Het verschilt bijna niet van het vorige voorbeeld. Het enige wat we hier hebben veranderd is de toegang tot de map door middel van aangepaste functies. add en has.
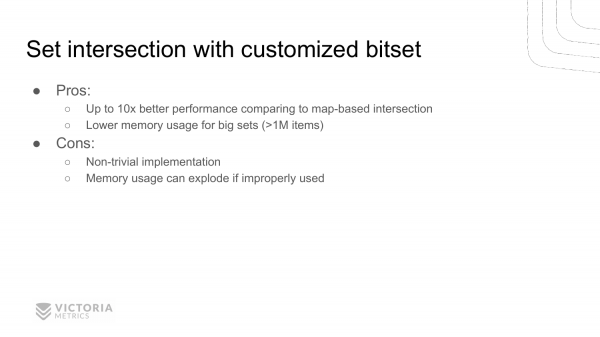
Op het eerste gezicht lijkt het misschien langzamer te werken, als er eerder een standaard map werd gebruikt en hier nog enkele functies worden aangeroepen, maar profiling toont aan dat deze aanpak 10 keer sneller is dan de standaard map voor het geval van VictoriaMetrics.
Bovendien gebruikt het veel minder geheugen in vergelijking met de implementatie op map. Omdat we hier bits opslaan in plaats van achtbyte waarden.
Het nadeel van deze implementatie is dat deze niet zo voor de hand liggend is, niet triviaal.
Een ander nadeel dat velen misschien niet opmerken, is dat deze implementatie in sommige gevallen slecht kan presteren. Dat wil zeggen, het is geoptimaliseerd voor een specifieke situatie, namelijk het geval van het kruisen van ids van tijdreeksen in VictoriaMetrics. Dit betekent niet dat het geschikt is voor alle gevallen. Als het verkeerd wordt gebruikt, krijgen we geen prestatieverbetering, maar een out of memory error en een vertraging van de prestaties.
Laten we de implementatie van deze structuur bekijken. Als je het wilt zien, het bevindt zich in de bronbestanden van VictoriaMetrics, in de map . Het is specifiek geoptimaliseerd voor het geval van VictoriaMetrics, waar timeseries_id een 64-bits waarde is, waarvan de eerste 32 bits constant zijn en alleen de laatste 32 bits veranderen.
Deze datastructuur wordt niet op de schijf opgeslagen, maar werkt alleen in het geheugen.
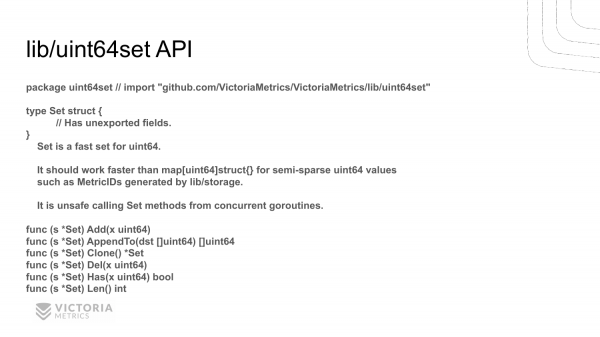
Hier is de API. Het is niet erg ingewikkeld. De API is afgestemd op het specifieke gebruiksvoorbeeld van VictoriaMetrics. Dat wil zeggen, er zijn geen overbodige functies. Hier zijn de functies die expliciet door VictoriaMetrics worden gebruikt.
Er zijn functies add, die nieuwe waarden toevoegt. Er is een functie has, die nieuwe waarden controleert. En er is een functie del, die waarden verwijdert. Er is een hulpfunctie len, die de grootte van de verzameling retourneert. De functie clone kopieert de verzameling. En de functie appendto zet deze set om in een slice timeseries_ids.
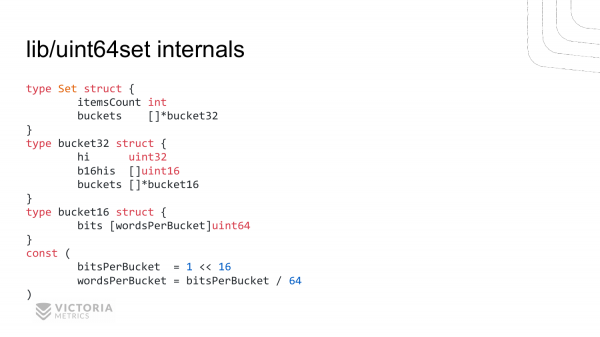
Zo ziet de implementatie van deze datastructuur eruit. In de set zijn er twee elementen:
ItemsCount– dit is een hulpprofiel om snel het aantal items in de set terug te geven. Het was mogelijk om zonder dit hulpprofiel te werken, maar het moest hieraan worden toegevoegd omdat VictoriaMetrics vaak in zijn algoritmen de lengte van de bitset opvraagt.Het tweede veld is
bucketsbucket32.Dit is een slice van de structuurbucket32.In elke structuur wordt hethiveld opgeslagen. Dit zijn de bovenste 32 bits. En twee slices —enbucketsuitb16hisbucket16
structuren.
Hier worden de bovenste 16 bits van het tweede deel van de 64-bits structuur opgeslagen. En hier worden de bitsets voor de onderste 16 bits van elk byte opgeslagen. Bucket64 bestaat uit een arrayuint64. b16his De lengte wordt berekend met behulp van deze constanten. In één 2^16=65536 kan maximaal bestaat uit een array bits worden opgeslagen. Als je dit deelt door 8, komt dat uit op 8 kilobyte. Als je het nogmaals door 8 deelt, dan is dat 1000 waardes. Dat wil zeggen, Bucket16
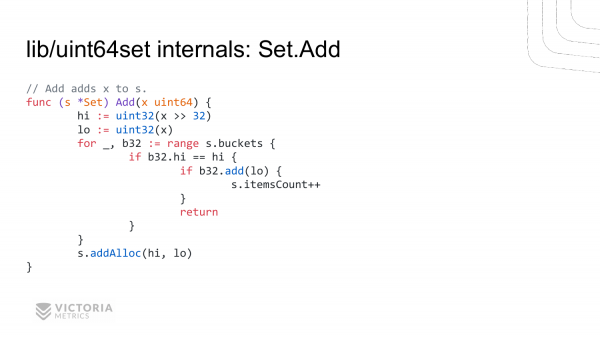
is onze 8-kilobyte structuur.
Laten we eens kijken naar hoe een van de methoden van deze structuur voor het toevoegen van een nieuwe waarde is geïmplementeerd. Alles begint met bestaat uit een array waarden. We berekenen de bovenste 32 bits, we berekenen de onderste 32 bits. We doorlopen alle buckets. We vergelijken de bovenste 32 bits in elke bucket met de toegevoegde waarde. En als ze overeenkomen, roepen we de functie aan add in de structuur b32 buckets. En we voegen daar de onderste 32 bits aan toe. En als dit iets opleverde true, dan betekent dat dat we zo'n waarde daar hebben toegevoegd en dat we eerder geen waarde hadden. Als het teruggeeft false, dan was die waarde al aanwezig. Vervolgens verhogen we het aantal elementen in de structuur.
Als we de benodigde bucket met de juiste hi-waarde niet vonden, dan roepen we de functie addAlloc, die een nieuwe bucket, in de bucket-structuur toevoegt.
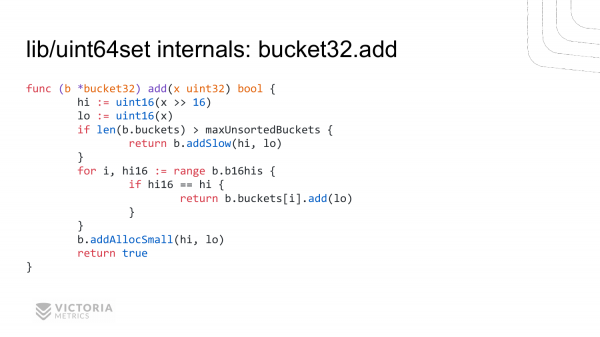
Dit is de implementatie van de functie b32.add. Het lijkt op de vorige implementatie. We berekenen de bovenste 16 bits, de onderste 16 bits.
Daarna doorlopen we alle bovenste 16 bits. We zoeken naar overeenkomsten. En bij een overeenkomst roepen we de methode add aan, die we op de volgende pagina zullen bekijken voor b16his.
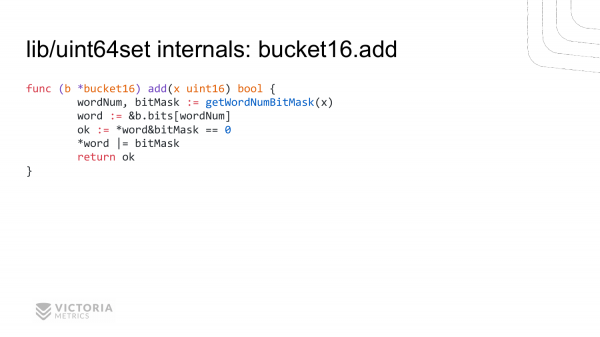
En hier is het onderste niveau, dat maximaal geoptimaliseerd moet worden. We berekenen de id-waarde in het slice bit, evenals bestaat uit een array bitmask . Dit is de mask voor deze 64-bits waarde, waarmee we kunnen controleren of dit bit aanwezig is, of het instellen ervan. We controleren of dit bit is ingesteld en stellen het in, en geven de aanwezigheid terug. Dit is de realisatie die onze intersectie-operatie met ids van tijdreeksen 10 keer sneller maakte in vergelijking met gewone maps.In VictoriaMetrics zijn er naast deze optimalisatie nog veel andere optimalisaties. De meeste van deze optimalisaties zijn niet zomaar toegevoegd, maar na codeprofilering in productie.
Dit is de belangrijkste regel voor optimalisatie - voeg geen optimalisatie toe in de veronderstelling dat dit een knelpunt zal zijn, want het kan zijn dat er geen knelpunt is. Optimalisatie verslechtert meestal de kwaliteit van de code. Daarom is het het beste om alleen te optimaliseren na profilering en bij voorkeur in productie, zodat het echte gegevens zijn. Voor degenen die geïnteresseerd zijn, kunnen jullie de bronbestanden van VictoriaMetrics bekijken en andere optimalisaties onderzoeken die daar aanwezig zijn.
Ik heb een vraag over bitset. Het lijkt erg op de implementatie van C++ vector bool, geoptimaliseerde bitset. Hebben jullie de implementatie daarvandaan gehaald?
Ik heb een vraag over bitset. Het lijkt erg op de implementatie van C++ vector bool, geoptimaliseerde bitset. Hebben jullie de implementatie daar vandaan gehaald?
Nee, daar komt het niet vandaan. Bij de implementatie van deze bitset ben ik uitgegaan van de kennis van de structuur van deze ids timeseries, zoals die worden gebruikt in VictoriaMetrics. De structuur is zodanig dat de bovenste 32 bits meestal constant zijn. De onderste 32 bits kunnen variëren. Hoe lager de bit, hoe vaker deze kan veranderen. Daarom is deze implementatie specifiek geoptimaliseerd voor deze datastructuur. De C++ implementatie, voor zover ik weet, is geoptimaliseerd voor de algemene situatie. Als je optimalisatie voor de algemene situatie doet, betekent dit dat het niet de meest optimale oplossing zal zijn voor een specifiek geval.
Ik raad je aan ook de presentatie van Alexey Milovid te bekijken. Hij sprak ongeveer een maand geleden over optimalisaties in ClickHouse voor specifieke specialisaties. Hij legt net uit dat in het algemeen de C++ implementatie of een andere implementatie is afgestemd op goed presteren in het algemeen. Het kan slechter werken dan een gespecialiseerde implementatie op specifieke kennis, zoals in ons geval, wanneer we weten dat de bovenste 32 bits meestal constant zijn.
Ik heb een tweede vraag. Wat is het fundamentele verschil met InfluxDB?
Er zijn veel fundamentele verschillen. Wat betreft prestaties en geheugenverbruik, toont InfluxDB in tests tot tien keer meer geheugenverbruik voor high cardinality tijdreeksen, wanneer je er veel van hebt, bijvoorbeeld miljoenen. Bijvoorbeeld, VictoriaMetrics verbruikt 1 GB per miljoen actieve reeksen, terwijl InfluxDB daarbij 10 GB verbruikt. En dat is een groot verschil.
Een tweede fundamenteel verschil is dat InfluxDB vreemde querytalen heeft – Flux en InfluxQL. Deze zijn niet erg gebruiksvriendelijk voor het werken met tijdreeksen in vergelijking met , dat wordt ondersteund in VictoriaMetrics. PromQL is de querytaal van Prometheus.
En nog een verschil is dat InfluxDB een enigszins vreemde datamodel heeft, waarbij elke regel meerdere fields kan bevatten met verschillende sets tags. Deze regels zijn ook verdeeld over verschillende tabellen. Deze extra complicaties maken het moeilijker om met deze database te werken. Het is moeilijk te onderhouden en te begrijpen.
Bij VictoriaMetrics is alles veel eenvoudiger. Daar vertegenwoordigt elke tijdreeks een sleutel-waarde. De waarde is een set punten – (timestamp, value), en de sleutel is een set label=value. Er is geen scheiding tussen velden en metingen. Dit stelt je in staat om willekeurige gegevens te kiezen en deze vervolgens te combineren, optellen, aftrekken, vermenigvuldigen en delen, in tegenstelling tot InfluxDB, waar berekeningen tussen verschillende rijen nog steeds niet zijn geïmplementeerd, voor zover ik weet. Zelfs als ze zijn geïmplementeerd, is het moeilijk; je moet veel code schrijven.
Ik heb een verduidelijkende vraag. Heb ik het goed begrepen dat er een probleem was waar je het over had, namelijk dat deze omgekeerde index niet in het geheugen past, waardoor er partitionering is?
In het begin liet ik een naïeve implementatie van een omgekeerde index zien op een standaard Go-map. Een dergelijke implementatie is niet geschikt voor databases, omdat deze omgekeerde index niet op schijf wordt opgeslagen, terwijl een database gegevens op schijf moet opslaan, zodat deze gegevens na een herstart toegankelijk blijven. In deze implementatie zult u de omgekeerde index verliezen bij het herstarten van de toepassing. En u verliest de toegang tot alle gegevens, omdat u ze niet kunt vinden.
Hallo! Bedankt voor de presentatie! Mijn naam is Pavel. Ik kom van Wildberries. Ik heb een paar vragen voor je. Vraag één. Denk je niet dat als je een andere benadering had gekozen bij het bouwen van de architectuur van je toepassing en de gegevens op tijd had gepartitioneerd, je waarschijnlijk gegevensoverlap zou kunnen maken bij het zoeken, op basis van het feit dat in één partitioneerde gegevens voor één tijdsinterval zitten, zodat je je geen zorgen hoeft te maken over het feit dat je stukken op verschillende manieren verspreid zijn? Vraag nummer 2 — omdat je een soortgelijke algoritme met bitset en al het andere implementeert, heb je misschien geprobeerd om gebruik te maken van processorinstructies? Heb je misschien dergelijke optimalisaties geprobeerd?
Ik zal meteen op de tweede reageren. We zijn daar nog niet aan toegekomen. Maar als het nodig is, zullen we dat wel doen. En welke was de eerste vraag?
Je besprak twee scenario's. En je zei dat je de tweede had geselecteerd met een complexere implementatie. En je hebt de eerste, waar de gegevens op tijd zijn gepartitioneerd, niet gekozen.
Ja. In het eerste geval zou het totale indexvolume groter zijn omdat we in elke partition dubbele gegevens voor die tijdreeksen zouden moeten opslaan die door al deze partitions heen gaan. En als je churn rate voor de tijdreeksen laag is, dat wil zeggen, als steeds dezelfde reeksen worden gebruikt, dan zouden we in het eerste geval veel meer schijfruimte verliezen in vergelijking met de tweede situatie.
Dat klopt – tijdpartitionering is een goede optie. Dit gebruikt Prometheus. Maar Prometheus heeft een ander nadeel. Bij het samenvoegen van deze datablokken moet het meta-informatie over alle labels en tijdreeksen in het geheugen houden. Daarom, als de datablokken groot zijn die hij samenvoegt, stijgt het geheugengebruik enorm tijdens het samenvoegen, in tegenstelling tot VictoriaMetrics. Bij het samenvoegen verbruikt VictoriaMetrics helemaal geen geheugen, een paar kilobytes worden verbruikt, ongeacht de grootte van de samengevoegde datablokken.
Het algoritme dat je gebruikt, verbruikt geheugen. Daarin worden de tijdreekslabels gemarkeerd waarvan waarden aanwezig zijn. En op die manier controleer je het gelijktijdig bestaan in de ene datarray en de andere. En je begrijpt – vond de intersectie plaats of niet. Gewoonlijk implementeren databases cursors, iterators, die hun huidige staat opslaan en door gesorteerde gegevens lopen, wat zorgt voor een eenvoudige complexiteit van deze bewerkingen.
Waarom gebruiken we geen cursors voor het kruisen van gegevens?
Ja.
In onze LevelDB of in de mergeset worden precies de gesorteerde rijen opgeslagen. We kunnen met een cursor erdoorheen lopen en de intersectie vinden. Maar waarom doen we dat niet? Omdat het langzaam is. Omdat cursors vereisen dat voor elke regel een functie moet worden aangeroepen. Het aanroepen van een functie kost 5 nanoseconden. En als je 100.000.000 rijen hebt, betekent dat dat we een halve seconde alleen al besteden aan het aanroepen van functies.
Dat is zo, ja. En mijn laatste vraag. Deze vraag klinkt misschien een beetje vreemd. Waarom kunnen we niet alle benodigde aggregaten berekenen op het moment van gegevensinvoer en ze in de benodigde vorm opslaan? Waarom enorme hoeveelheden opslaan in systemen zoals VictoriaMetrics, ClickHouse, enzovoort, om daar vervolgens veel tijd aan te besteden?
Ik zal een voorbeeld geven om het duidelijker te maken. Stel je voor, hoe werkt een kleine speelgoed snelheidsmeter? Het registreert de afstand die je hebt afgelegd en voegt deze voortdurend toe aan de ene waarde en de tijd aan de andere. En dan deelt het. Zo krijg je de gemiddelde snelheid. Je kunt iets soortgelijks doen. Alle noodzakelijke feiten ter plekke optellen.
Goed, ik begrijp de vraag. Jouw voorbeeld heeft zeker waarde. Als je weet welke aggregaten je nodig hebt, is dat de beste implementatie. Maar het probleem is dat mensen deze metrics, bepaalde gegevens, in ClickHouse opslaan en nog niet weten hoe ze in de toekomst deze zullen aggregeren en filteren, dus moeten ze alle ruwe gegevens opslaan. Als je echter weet dat je iets gemiddeld moet berekenen, waarom zou je dan niet direct die berekening maken in plaats van een heleboel ruwe waarden op te slaan? Maar dit alleen als je zeker weet wat je nodig hebt.
Overigens ondersteunen databases voor het opslaan van tijdreeksen het tellen van aggregaten. Bijvoorbeeld, Prometheus ondersteunt . Dat wil zeggen, dit is mogelijk als je weet welke aggregaten je nodig hebt. In VictoriaMetrics is dit nog niet mogelijk, maar meestal wordt Prometheus ervoor geplaatst, waarin je dit kunt doen met opname regels.
Bijvoorbeeld, bij mijn vorige baan moesten we het aantal gebeurtenissen in een glijdend venster gedurende het laatste uur tellen. Het probleem was dat we een aangepaste implementatie in Go moesten maken, dat wil zeggen, een service voor het tellen van die dingen. Deze service was uiteindelijk niet triviaal, omdat het ingewikkeld is om dat te berekenen. De implementatie kan eenvoudig zijn als je aggregaten op vaste tijdsintervallen wilt tellen. Maar als je evenementen in een glijdend venster wilt tellen, is het niet zo eenvoudig als het lijkt. Ik denk niet dat dit tot nu toe in ClickHouse of in tijdreeks-databases is geïmplementeerd, omdat het moeilijk te implementeren is.
En nog een vraag. We hebben het nu gehad over het nemen van gemiddelden, en ik herinnerde me dat er ooit zoiets was als Graphite met de backend Carbon. En het kon oude gegevens filteren, dat wil zeggen, één punt per minuut, één punt per uur, enz. In principe is dat behoorlijk handig als we ruwe gegevens nodig hebben, laten we zeggen, voor een maand, en alles daarbuiten kan gefilterd worden. Maar Prometheus en VictoriaMetrics ondersteunen deze functionaliteit niet. Is het de bedoeling om dit in de toekomst te ondersteunen? Zo niet, waarom dan niet?
Bedankt voor je vraag. Onze gebruikers stellen deze vraag periodiek. Ze vragen wanneer we ondersteuning voor downsampling zullen toevoegen. Hier zijn een paar problemen. Ten eerste begrijpt elke gebruiker onder downsampling iets anders: de een wil een willekeurig punt binnen een gegeven interval, de ander wil de maximale, minimale of gemiddelde waarden. Als er vanuit meerdere systemen gegevens naar je database worden geschreven, kun je ze niet zomaar over één kam scheren. Het kan zijn dat voor elk systeem een andere downsampling nodig is. Dat is lastig te implementeren.
En het tweede punt is dat VictoriaMetrics, net als ClickHouse, geoptimaliseerd is voor het werken met grote hoeveelheden ruwe gegevens, waardoor het mogelijk is om een miljard rijen in minder dan een seconde door te spitten, mits je veel kernen in je systeem hebt. Scannen van tijdreeksdata in VictoriaMetrics – 50.000.000 punten per seconde per kern. En deze prestaties schalen met het aantal beschikbare kernen. Als je bijvoorbeeld 20 kernen hebt, dan kom je op een scanning van een miljard punten per seconde. Deze eigenschap van VictoriaMetrics en ClickHouse vermindert de behoefte aan downsampling.
Een ander kenmerk is dat VictoriaMetrics deze gegevens effectief comprimeert. Compressie in productie ligt gemiddeld tussen 0,4 en 0,8 byte per punt. Elk punt bestaat uit een timestamp + waarde. En het wordt gemiddeld tot minder dan één byte gecomprimeerd.
Sergio. Ik heb een vraag. Wat is de minimale tijdsquantum voor registratie?
Één milliseconde. Onlangs hadden we een gesprek met andere ontwikkelaars van tijdreeksdatabases. Hun minimale tijdsquantum is één seconde. In Graphite bijvoorbeeld is dat ook één seconde. Bij OpenTSDB is dat ook één seconde. In InfluxDB – nanoseconde nauwkeurigheid. In VictoriaMetrics – één milliseconde, omdat Prometheus één milliseconde gebruikt. VictoriaMetrics werd oorspronkelijk ontwikkeld als remote storage voor Prometheus. Maar nu kan het ook gegevens van andere systemen opslaan.
De persoon met wie ik sprak, zegt dat zij seconde-nauwkeurigheid hebben — voor hen is dat voldoende, omdat het afhangt van het type gegevens dat in de tijdreeksdatabase wordt opgeslagen. Als het DevOps-gegevens of infrastructuurgegevens zijn die je verzamelt met een interval van 30 seconden tot een minuut, dan is seconde-nauwkeurigheid voldoende, daar heb je niet minder van nodig. Maar als je deze gegevens verzamelt vanuit high frequency trading systems, heb je nanoseconde-nauwkeurigheid nodig.
Milliseconde nauwkeurigheid in VictoriaMetrics is geschikt voor zowel DevOps-gevallen als voor de meeste gevallen die ik aan het begin van de presentatie noemde. Het enige waarvoor het misschien niet geschikt is, zijn high-frequency trading systemen.
Dank je! En nog een vraag. Hoe zit het met de compatibiliteit in PromQL?
Volledige terugwaartse compatibiliteit. VictoriaMetrics ondersteunt volledig PromQL. Daarnaast voegt het ook extra geavanceerde functionaliteit toe aan PromQL, die wordt genoemd . Over deze geavanceerde functionaliteit is er een presentatie op YouTube. Ik heb er over gesproken tijdens de Monitoring Meetup in de lente in Sint-Petersburg.
Telegram kanaal .
Alleen geregistreerde gebruikers kunnen deelnemen aan de enquête. , alstublieft.
Wat houdt u tegen om VictoriaMetrics als langdurige opslagoplossing voor Prometheus te gebruiken? (Laat het achter in de comments, dan voeg ik het toe aan de enquête))
71,4%Gebruik geen Prometheus5
28,6%Wist niet over VictoriaMetrics2
7 gebruikers hebben gestemd. 12 gebruikers hebben zich onthouden.
Bron: habr.com
