

Hallo, Habr-bewoners. Zoals gebruikelijk blijven we interessant materiaal delen in de aanloop naar de start van nieuwe cursussen. Vandaag hebben we speciaal voor jullie een artikel over Google Cloud Spanner vertaald, ter gelegenheid van de lancering van de cursus. .
Oorspronkelijk gepubliceerd op .
Als bedrijf dat een breed scala aan cloudgebaseerde POS-oplossingen aanbiedt voor retailers, restauranthouders en online verkopers wereldwijd, gebruikt Lightspeed verschillende soorten databaseplatforms voor tal van transactionele, analytische en zoektoepassingen. Elk van deze databaseplatforms heeft zijn eigen sterke en zwakke punten. Daarom, toen Google Cloud Spanner op de markt bracht - veelbelovende functies die ongekend zijn in de wereld van relationele databases, zoals vrijwel onbeperkte horizontale schaalbaarheid en een SLA van 99,999% - konden we de kans niet laten liggen om het in handen te krijgen!
Om een uitgebreid overzicht van onze ervaringen met Cloud Spanner te geven, evenals de beoordelingscriteria die we hebben gebruikt, zullen we de volgende onderwerpen bespreken:
- Onze beoordelingscriteria
- Cloud Spanner in het kort
- Onze beoordeling
- Onze conclusies
1. Onze beoordelingscriteria
Voordat we de kenmerken van Cloud Spanner in detail behandelen, incluis de overeenkomsten en verschillen met andere oplossingen op de markt, laten we eerst de belangrijkste gebruikscases bespreken die we in gedachten hadden bij het overwegen waar we Cloud Spanner in onze infrastructuur zouden uitrollen:
- Als een vervanging voor de (voorkeurs) traditionele SQL-databaseoplossing
- Als een OLTP-oplossing met OLAP-ondersteuning
Opmerking: Om de zaken eenvoudig en gemakkelijk te vergelijken, vergelijkt dit artikel Cloud Spanner met MySQL-opties van de GCP Cloud SQL en Amazon AWS RDS oplossingen.
Het gebruik van Cloud Spanner als vervanging voor een traditionele SQL-databaseoplossing
In een omgeving van traditionele databases, wanneer de respons tijd op een database-query zich dicht bij of zelfs boven vooraf gedefinieerde drempelwaarden van de applicatie komt (voornamelijk door een toename van het aantal gebruikers en/of aanvragen), zijn er verschillende manieren om de respons tijd terug te brengen naar acceptabele niveaus. Veel van deze oplossingen vereisen echter handmatige tussenkomst.
Bijvoorbeeld, de eerste stap die je moet nemen, is kijken naar de verschillende database-instellingen die met prestaties te maken hebben en deze af te stemmen zodat ze het beste aansluiten bij de gebruiksscenario's van applicaties. Als dit niet voldoende is, kun je ervoor kiezen om de database verticaal of horizontaal te schalen.
Verticale schaling van de applicatie houdt in dat de serverinstantie wordt bijgewerkt, meestal door meer processors/kernen, meer RAM, snellere opslag, enzovoort toe te voegen. Het toevoegen van meer hardwarebronnen resulteert in een hogere databaseprestaties, gemeten in transacties per seconde en de latentie van transacties voor OLTP-systemen. Relationele databasesystemen (die een multithreading-aanpak gebruiken), zoals MySQL, schalen goed verticaal.
Dit heeft enkele nadelen, maar de meest voor de hand liggende is de maximale servergrootte op de markt. Zodra de limiet van de grootste serverinstantie is bereikt, is er nog maar één weg: horizontale schaling.
Horizontale schaling is een aanpak waarbij er meer servers aan de cluster worden toegevoegd om in feite de prestaties lineair te verhogen met het aantal servers. De meeste van traditionele databasesystemen schalen slecht horizontaal of helemaal niet. Bijvoorbeeld, MySQL kan horizontaal schalen voor leesoperaties door slave-lezers toe te voegen, maar kan niet horizontaal schalen voor schrijfoperaties.
Aan de andere kant kan Cloud Spanner, vanwege zijn natuur, gemakkelijk horizontaal schalen met minimale tussenkomst.
Volledig functionele DBMS als een dienst moet vanuit verschillende hoeken worden beoordeeld. We hebben de populairste cloud DBMS genomen — voor Google, GCP Cloud SQL en voor Amazon, AWS RDS. Bij onze beoordeling hebben we ons gefocust op de volgende categorieën:
- Functievergelijkingen: SQL-extent, DDL, DML; verbindingsbibliotheken/connectors, ondersteuning voor transacties, enzovoort.
- Ondersteuning voor ontwikkeling: eenvoud van ontwikkeling en testen.
- Beheerondersteuning: instancebeheer — zoals opschalen en afschalen en upgrades van instanties; SLA, back-up en herstel; beveiliging/toegangscontrole.
Gebruik van Cloud Spanner als OLTP-oplossing met ondersteuning voor OLAP
Hoewel Google niet expliciet stelt dat Cloud Spanner bedoeld is voor analytische verwerking, deelt het enkele kenmerken met andere systemen, zoals Apache Impala & Kudu en YugaByte, die zijn ontworpen voor OLAP-werkbelastingen.
Zelfs als er maar een kleine kans zou zijn dat Cloud Spanner een consistent horizontaal schaalbaar HTAP-motor (hybride transactionele/analytische verwerking) bevat met (meer of minder) een bruikbare set OLAP-functies, zouden we denken dat dit onze aandacht waard is.
Met dat in gedachten hebben we de volgende categorieën overwogen:
- Gegevensinvoer, indexen en ondersteuning voor partitionering
- Queryprestaties en DML
2. Cloud Spanner in het kort
Google Spanner is een clustergebaseerd relationeel databasesysteem (RDBMS) dat Google gebruikt voor verschillende van zijn eigen diensten. Google maakte het begin 2017 openbaar voor gebruikers van Google Cloud Platform.
Hier zijn enkele van de kenmerken van Cloud Spanner:
- Sterk consistente schaalbare cluster RDBMS: maakt gebruik van hardwarematig tijdssynchronisatie om gegevensconsistentie te waarborgen.
- Ondersteuning voor cross-table transacties: transacties kunnen meerdere tabellen omvatten — niet beperkt tot één tabel (in tegenstelling tot Apache HBase of Apache Kudu).
- Tabellen op basis van primaire sleutel: alle tabellen moeten een gedefinieerde primaire sleutel (PK) hebben, die uit meerdere kolommen van de tabel kan bestaan. Tabelgegevens worden opgeslagen in PK-volgorde, wat ze zeer efficiënt en snel maakt voor zoeken op PK. Net als andere systemen op basis van PK moet de implementatie worden gemodelleerd met een blik op vooraf doordachte use-cases voor optimale prestaties. .
- Afwisselende tabellen: tabellen kunnen fysieke afhankelijkheden van elkaar hebben. De rijen van een kindertabel kunnen worden gekoppeld aan de rijen van een ouder tabel. Deze aanpak versnelt het vinden van relaties die kunnen worden gedefinieerd tijdens de datamodellering, bijvoorbeeld bij het samenbrengen van klanten en hun facturen.
- Indexen: Cloud Spanner ondersteunt secundaire indexen. Een index bestaat uit de geïndexeerde kolommen en alle kolommen van de primaire sleutel. Indien gewenst kan een index ook andere niet-geïndexeerde kolommen bevatten. Een index kan afwisselend met de ouder tabel worden gebruikt om zoekopdrachten te versnellen. Op indexen zijn verschillende beperkingen van toepassing, zoals het maximale aantal extra kolommen dat in de index mag worden opgeslagen. Ook kunnen zoekopdrachten via indexen minder rechttoe rechtaan zijn dan in andere RDBMS.
Cloud Spanner kiest alleen in zeldzame gevallen automatisch een index. In het bijzonder kiest Cloud Spanner geen secundaire index automatisch als de query om enige kolommen vraagt die niet zijn opgeslagen in ».
- Service Level Agreement (SLA): implementatie in één regio met een SLA van 99,99%; multiregionale implementaties met 99,999% SLA. Hoewel de SLA zelf slechts een overeenkomst is en geen garantie, denk ik dat de medewerkers van Google inderdaad enkele gegevens hebben om zo'n serieuze bewering te doen. (Ter referentie, 99,999% betekent 26,3 seconden onbeschikbaarheid van de service per maand.)
- Meer:
Opmerking: Het Apache Tephra-project voegt uitgebreide ondersteuning voor transacties toe aan Apache HBase (ook nu geïmplementeerd in Apache Phoenix als bètaversie).
Onze beoordeling
Dus, we hebben allemaal de beweringen van Google over de voordelen van Cloud Spanner gelezen - praktisch onbeperkte horizontale schaalvergroting met behoud van hoge consistentie en een zeer hoge SLA. Hoewel deze vereisten in elk geval uiterst moeilijk te bereiken zijn, was het onze bedoeling ze niet tegen te spreken. Laten we ons in plaats daarvan concentreren op andere zaken die veel databasegebruikers bezighouden: eerlijkheid en gebruiksvriendelijkheid.
We hebben Cloud Spanner beoordeeld als een vervanging voor Sharded MySQL.
Google Cloud SQL en Amazon AWS RDS, de twee meest populaire OLTP-databases op de cloudmarkt, beschikken over een zeer uitgebreide set functies. Om echter deze databases grootserchalig te kunnen opschalen dan de grootte van één knooppunt, moet u applicaties partitioneren. Deze aanpak creëert extra complexiteit zowel voor de applicaties als voor het beheer. We hebben bekeken hoe Spanner past in het scenario waarin meerdere segmenten samenkomen in één instantie en welke functies (indien aanwezig) wellicht moeten worden opgeofferd.
Ondersteuning voor SQL, DML en DDL, evenals een connector en bibliotheken?
Bij het starten met enige database moet u eerst een datamodel maken. Als u denkt dat u JDBC Spanner kunt verbinden met uw favoriete SQL-tool, zult u merken dat u uw gegevens ermee kunt opvragen, maar dat u deze niet kunt gebruiken om tabellen te maken of te wijzigen (DDL) of voor enige invoer-/bijwerk-/verwijderoperaties (DML). De officiële JDBC van Google ondersteunt geen van beide.
"Momenteel ondersteunen de drivers geen DML- of DDL-verklaringen."
Spanner-documentatie
Met de GCP-console is de situatie niet beter - u kunt alleen SELECT-query's verzenden. Gelukkig is er een JDBC-driver van de gemeenschap met ondersteuning voor DML en DDL, inclusief transacties. . Hoewel deze driver uiterst nuttig is, is het verbazingwekkend dat Google geen eigen JDBC-driver aanbiedt. Gelukkig biedt Google een vrij brede ondersteuning voor clientbibliotheken (op basis van gRPC): C#, Go, Java, node.js, PHP, Python en Ruby.
Het bijna verplichte gebruik van aangepaste API's van Cloud Spanner (vanwege het gebrek aan DDL en DML in JDBC) leidt tot bepaalde beperkingen voor de bijbehorende codegebieden, zoals verbindingspulsen of database-koppeling frameworks (bijvoorbeeld Spring MVC). Over het algemeen kunt u bij het gebruik van JDBC vrij kiezen welke verbindingspool u het liefst gebruikt (bijvoorbeeld HikariCP, DBCP, C3PO, enz.), die goed is getest en goed werkt. In het geval van aangepaste Spanner API's moeten we vertrouwen op frameworks/pools van koppelingen/sessies die we zelf hebben gemaakt.
Een op de primaire sleutel (PK) gerichte structuur stelt Cloud Spanner in staat om zeer snel toegang te krijgen tot gegevens via PK, maar leidt ook tot enkele problemen met query's.
- U kunt de waarde van de primaire sleutel niet bijwerken; u moet eerst de record met de oorspronkelijke PK verwijderen en deze opnieuw invoegen met de nieuwe waarde. (Dit lijkt op andere PK-georiënteerde databases/opslagmechanismen.)
- Alle UPDATE- en DELETE-operators moeten de PK in de WHERE-clausule opgeven, dus er kunnen geen lege DELETE all-operators zijn — er moet altijd een subquery zijn, bijvoorbeeld: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Het ontbreken van een auto-increment optie of iets dergelijks dat een volgorde voor het PK-veld vaststelt. Om dit te laten werken, moet de overeenkomstige waarde aan de kant van de applicatie worden gecreëerd.
Secundaire indices?
Google Cloud Spanner heeft ingebouwde ondersteuning voor secundaire indices. Dit is een zeer fijne functie die niet altijd aanwezig is in andere technologieën. Apache Kudu ondersteunt momenteel helemaal geen secundaire indices, en Apache HBase ondersteunt indices niet rechtstreeks, maar kan ze toevoegen via Apache Phoenix.
Indices in Kudu en HBase kunnen worden gemodelleerd als een afzonderlijke tabel met een andere samenstelling van primaire sleutels, maar de atomariteit van de operaties, die worden uitgevoerd op de oudertabel en de gerelateerde index-tabellen, moet op applicatieniveau worden uitgevoerd en is niet triviaal in een juiste implementatie.
Zoals vermeld in de review van Cloud Spanner, kunnen de indices verschillen van de indices in MySQL. Daarom moet er bijzondere voorzichtigheid worden betracht bij het opbouwen van queries en het profileren, om ervoor te zorgen dat de juiste index daar wordt gebruikt waar deze nodig is.
Weergaven?
Een zeer populair en nuttig object in een database zijn weergaven. Ze kunnen nuttig zijn voor een groot aantal use cases; twee van mijn favorieten zijn het niveau van logische abstractie en het niveau van veiligheid. Helaas ondersteunt Cloud Spanner GEEN weergaven. Dit beperkt ons echter slechts gedeeltelijk, aangezien er geen detailniveau voor kolomniveaus is in de toegangstoegang, waar weergaven een acceptabele oplossing kunnen zijn.
In de documentatie van Cloud Spanner, in het gedeelte waar de quotas en beperkingen in detail worden beschreven (), is er onder andere één die problematisch kan zijn voor sommige toepassingen: Cloud Spanner heeft standaard een limiet van maximaal 100 databases per instantie. Dit kan een aanzienlijke belemmering vormen voor een database die bedoeld is om uit te breiden naar meer dan 100 databases. Gelukkig hebben we na een gesprek met onze technische vertegenwoordiger van Google ontdekt dat deze limiet vrijwel naar elke waarde kan worden verhoogd via de klantenservice van Google.
Ondersteuning voor ontwikkeling?
Cloud Spanner biedt een vrij goede ondersteuning voor programmeertalen om met zijn API te werken. Officieel ondersteunde bibliotheken zijn beschikbaar voor C#, Go, Java, node.js, PHP, Python en Ruby. De documentatie is redelijk gedetailleerd, maar net als bij andere geavanceerde technologieën is de gemeenschap vrij klein in vergelijking met de meest populaire database-technologieën, wat kan leiden tot langere oplostijden voor minder gebruikelijke gebruikssituaties of problemen.
En hoe zit het met ondersteuning voor lokale ontwikkeling?
We hebben geen manier gevonden om een Cloud Spanner-instantie in een lokale omgeving te creëren. Het dichtstbijzijnde dat we konden krijgen, was een Docker-image , wat in principe vergelijkbaar is, maar in de praktijk sterk verschilt. Bijvoorbeeld, CockroachDB kan gebruikmaken van PostgreSQL JDBC. Aangezien de ontwikkelomgeving zo dicht mogelijk bij de productieomgeving moet liggen, is Cloud Spanner niet ideaal, omdat je afhankelijk moet zijn van een volledige Spanner-instantie. Om kosten te besparen kun je kiezen voor een instantie in één regio.
Ondersteuning voor beheer?
Een Cloud Spanner-instantie creëren is heel eenvoudig. Je hoeft alleen maar te kiezen tussen het creëren van een multi-regionale of een instantie voor één regio, de regio('s) en het aantal knooppunten op te geven. Binnen minder dan een minuut is de instantie opgestart en klaar voor gebruik.
Enkele elementaire metrics zijn direct beschikbaar op de Spanner-pagina in de Google-console. Gedetailleerdere weergaves zijn beschikbaar via Stackdriver, waar je ook de drempelwaarden voor metrics en meldingsbeleid kunt instellen.
Toegang tot middelen?
MySQL biedt uitgebreide en zeer gedetailleerde instellingen voor gebruikersrechten/rollen. Toegang tot een specifieke tabel of zelfs slechts een subset van de kolommen kan eenvoudig worden ingesteld. Cloud Spanner gebruikt het Google Identity & Access Management (IAM) hulpmiddel, waarmee beleidsregels en machtigingen alleen op zeer hoog niveau kunnen worden ingesteld. De meest gedetailleerde optie is database-niveau machtigingen, die niet passen in de meeste productiegevallen. Deze beperking dwingt je om extra beveiligingsmaatregelen toe te voegen aan je code, infrastructuur of beide om ongeoorloofd gebruik van Spanner-bronnen te voorkomen.
Back-ups?
Simpel gezegd, er zijn geen back-ups in Cloud Spanner. Hoewel de hoge eisen van Google SLA kunnen garanderen dat je geen gegevens verliest door hardware- of databasefouten, zijn menselijke fouten, toepassingdefecten, enz. niet uitgesloten. We kennen allemaal de regel: hoge beschikbaarheid vervangt geen verstandige back-upstrategie. Op dit moment is de enige manier om gegevens te back-uppen door ze via software uit de database naar een aparte opslagomgeving te streamen.
Queryprestaties?
Voor het laden van gegevens en het testen van query's hebben we de Yahoo! Cloud Serving Benchmark gebruikt. De onderstaande tabel toont de YCSB-werklast met een lees/write verhouding van 95% tot 5%.
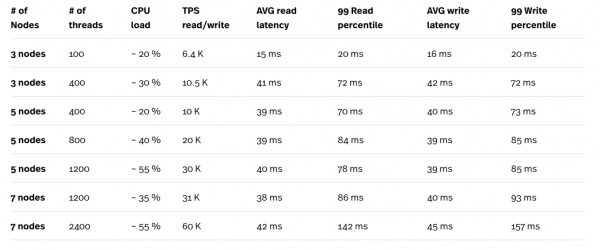
* De belastingstest werd uitgevoerd op een rekenmachine (CE) n1-standard-32 (32 vCPU, 120 GB geheugen), en de testinstantie was nooit de beperkende factor in de tests.
** Het maximale aantal threads in één YCSB-instantie is 400. In totaal moesten er zes parallelle instanties van YCSB-tests worden uitgevoerd om in totaal 2400 threads te krijgen.
Kijkend naar de testresultaten, vooral de combinatie van CPU-belasting en TPS, zien we duidelijk dat Cloud Spanner goed schaalt. De hoge belasting, veroorzaakt door een groot aantal threads, wordt gecompenseerd door het hoge aantal knooppunten in de Cloud Spanner-cluster. Hoewel de vertraging vrij hoog lijkt, vooral bij het gebruik van 2400 threads, kan het nodig zijn om opnieuw te testen met 6 kleinere instanties van de rekengine om nauwkeuriger cijfers te krijgen. Elke instantie zal één YCSB-test uitvoeren in plaats van één grote CE-instantie met 6 parallelle tests. Dit maakt het gemakkelijker om de vertragingen van Cloud Spanner-verzoeken en de vertragingen, toegevoegd door de netverbinding tussen Cloud Spanner en de CE-instantie waarop de test wordt uitgevoerd, te onderscheiden.
Hoe presteert Cloud Spanner als OLAP?
Partitionering?
Het splitsen van gegevens in fysiek en/of logisch onafhankelijke segmenten, ook wel partities genoemd, is een zeer populaire strategie die aanwezig is in de meeste OLAP-mechanismen. Partities kunnen de queryprestaties en onderhoudbaarheid van de database aanzienlijk verbeteren. Verder onderzoek naar partities zou in een apart artikel (of artikelen) plaatsvinden, dus laten we gewoon het belang van een partitioneringsschema en sub-partitionering opmerken. De mogelijkheid om gegevens in partities en zelfs verder in subpartities te splitsen is de sleutel tot de prestaties van analytische queries.
Cloud Spanner ondersteunt geen partities als zodanig. Het verdeelt de interne gegevens in de zogenaamde split-en op basis van de bereikwaarden van de primaire sleutel. De splitsing gebeurt automatisch om de belasting in de Cloud Spanner-cluster te balanceren. Een handig kenmerk van Cloud Spanner is dat het de basisbelasting van de bovenliggende tabel (de tabel die niet afwisselend is met een andere) splitst. Spanner bepaalt automatisch of split gegegevens vaker worden gelezen dan gegevens in andere split-en, en kan besluiten om verder te splitsen. Hierdoor kunnen meer knooppunten bij de aanvraag betrokken zijn, wat ook effectief de doorvoer verhoogt.
Gegevensinvoer?
De Cloud Spanner-methode voor grote gegevens is dezelfde als bij een gewone upload. Om maximale prestaties te bereiken, moet u enkele aanbevelingen volgen, waaronder:
- Sorteer uw gegevens op de primaire sleutel.
- Verdeel ze in 10*aantal knooppunten apart secties.
- Creëer een set werkopdrachten die gegevens parallel uploaden.
Bij een dergelijke gegevensupload worden alle knooppunten van Cloud Spanner gebruikt.
We hebben de A YCSB-werklast gebruikt om een dataset van 10M rijen te genereren.
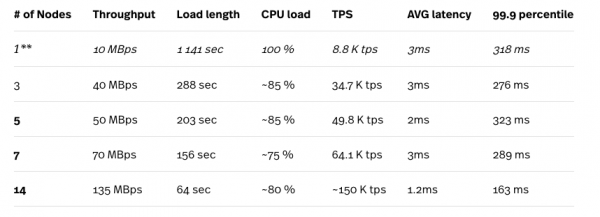
* De belastingstest werd uitgevoerd op het rekenmachine-engine n1-standard-32 (32 vCPU, 120 GB geheugen), en de testinstantie was nooit de bottleneck in de tests.
** Een configuratie van 1 knooppunt wordt niet aanbevolen voor enige productiebelasting.
Zoals hierboven vermeld, beheert Cloud Spanner automatisch splitsingen op basis van hun belasting, waardoor de resultaten verbeteren na meerdere opeenvolgende testherhalingen. De hier gepresenteerde resultaten zijn de beste die we hebben behaald. Kijkend naar de bovenstaande cijfers, kunnen we zien hoe Cloud Spanner goed opschaalt met het toenemen van het aantal knooppunten in het cluster. De cijfers die opvallen, vertegenwoordigen uitzonderlijk lage gemiddelde latenties, die contrasteren met de resultaten van gemengde werklasten (95% lezen en 5% schrijven), zoals hierboven is beschreven.
Schaalvergroting?
Het vergroten en verkleinen van het aantal Cloud Spanner-knooppunten is een taak die met één klik kan worden uitgevoerd. Als u snel gegevens wilt uploaden, kunt u overwegen de instantie tot het maximum te verhogen (in ons geval waren dat 25 knooppunten in de regio US-EAST), en vervolgens het aantal knooppunten te verminderen tot dat geschikt is voor uw normale belasting, nadat alle gegevens in de database zijn, rekening houdend met de limiet van 2 TB/knooppunt.
We werden herinnerd aan deze limiet, zelfs met een veel kleinere database. Na verschillende runs van belastingstests had onze database een grootte van ongeveer 155 GB, en bij het verlagen tot een instantie van 1 knooppunt kregen we de volgende fout:
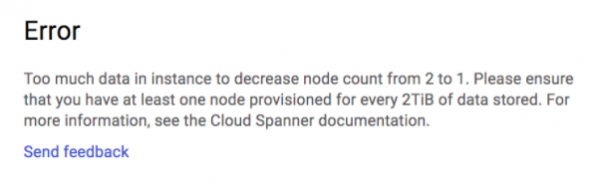
We slaagden erin om te verkleinen van 25 tot 2 instanties, maar we zaten vast op twee knooppunten.
Het verhogen en verlagen van het aantal knooppunten in de Cloud Spanner-cluster kan worden geautomatiseerd met behulp van de REST API. Dit kan bijzonder nuttig zijn om piekbelasting op het systeem tijdens drukke uren te verminderen.
De prestaties van OLAP-queries?
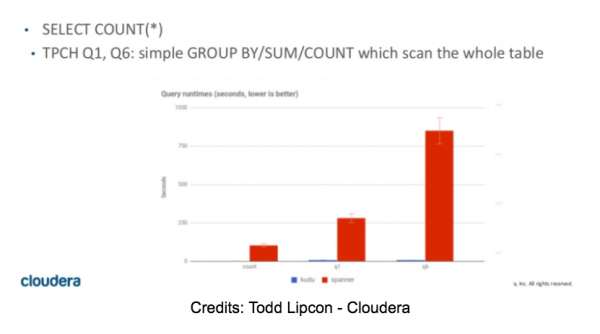
Aanvankelijk waren we van plan om aanzienlijke tijd aan onze evaluatie van Spanner in dit deel te besteden. Na verschillende SELECT COUNT-queries realiseerden we ons onmiddellijk dat het testen kort zou zijn en dat Spanner GEEN geschikte OLAP-engine zou zijn. Ongeacht het aantal knooppunten in de cluster, duurde een eenvoudige query om het aantal rijen in een tabel van 10M rijen op te halen van 55 tot 60 seconden. Bovendien resulteerde elke query die meer geheugen vereiste voor het opslaan van tussentijdse resultaten in een OOM-fout.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M unieke waarden) -> SpoolingHashAggregateIterator kreeg geen geheugen tijdens de nieuwe rij.
Enkele cijfers voor TPC-H-queries zijn te vinden in het artikel van Todd Lipkon , dia's 42 en 43. Deze cijfers komen overeen met onze eigen resultaten (helaas).
4. Onze conclusies
Gezien de huidige staat van de functies van Cloud Spanner, is het moeilijk voor te stellen dat het een eenvoudige vervanging kan zijn voor bestaande OLTP-oplossingen, vooral wanneer uw behoeften groter worden dan wat het kan bieden. Er zou aanzienlijke tijd nodig zijn om een oplossing te bouwen rekening houdend met de tekortkomingen van Cloud Spanner.
Toen we begonnen met de evaluatie van Cloud Spanner, verwachtten we dat de beheermogelijkheden op hetzelfde niveau zouden zijn of minstens niet zover verwijderd van andere Google SQL-oplossingen. Maar we waren verrast door de volledige afwezigheid van back-ups en de zeer beperkte toegang tot hulpbronnen. Om nog maar te zwijgen van het gebrek aan weergaven, het ontbreken van een lokale ontwikkelomgeving, niet-ondersteunde sequenties, JDBC zonder ondersteuning voor DML en DDL, enzovoort.
Dus, waar kan iemand heen als ze een transactionele database moeten opschalen? Het lijkt erop dat er op de markt momenteel geen enkele oplossing is die geschikt is voor alle gebruiksscenario's. Er zijn veel oplossingen met gesloten en open broncode (sommige worden in dit artikel genoemd), elk met hun sterke en zwakke punten, maar geen van deze biedt SaaS met een SLA van 99,999% en een hoge mate van consistentie. Als een hoog SLA-niveau uw belangrijkste doel is en u niet van plan bent om een eigen oplossing voor meerdere cloudomgevingen te bouwen, kan Cloud Spanner de oplossing zijn die u zoekt. Maar u moet zich bewust zijn van al zijn beperkingen.
Eerlijkheidshalve moet worden opgemerkt dat Cloud Spanner pas in het voorjaar van 2017 voor het publiek is vrijgegeven, dus het is redelijk om te verwachten dat sommige van zijn huidige tekortkomingen uiteindelijk zullen verdwijnen (hoewel we hopen van niet), en wanneer dat gebeurt, kan dat de spelregels veranderen. Uiteindelijk is Cloud Spanner niet slechts een side-project voor Google. Google gebruikt het als basis voor andere Google-producten. En toen Google onlangs Megastore in Google Cloud Storage verving door Cloud Spanner, maakte dat Google Cloud Storage strikt consistent voor objectlijsten op mondiale schaal (wat nog steeds niet geldt voor ).
Dus er is nog hoop... we hopen het.
Dat is alles. Net als de auteur van het artikel blijven wij ook hopen, wat denkt u hierover? Laat het ons weten in de reacties.
Iedereen is welkom om onze te bezoeken, waarin we uitgebreid vertellen over de cursus van OTUS.
Bron: habr.com
