

We zullen de werking van Zabbix met TimescaleDB als backend bespreken. We laten zien hoe je vanaf nul kunt beginnen en hoe je kunt migreren vanaf PostgreSQL. Ook geven we vergelijkende prestatietests van de twee configuraties.
HighLoad++ Siberië 2019. Zaal 'Tomsk'. 24 juni, 16:00. Theses en . De volgende HighLoad++ conferentie vindt plaats op 6 en 7 april 2020 in Sint-Petersburg. Details en tickets .
Andrey Gushchin (hierna - AG): – Ik ben een engineer van de technische ondersteuning van ZABBIX (hierna - 'Zabbix'), trainer. Ik werk al meer dan 6 jaar in de technische ondersteuning en heb rechtstreeks met de prestaties te maken gehad. Vandaag zal ik praten over de prestaties die TimescaleDB kan bieden in vergelijking met standaard PostgreSQL 10. Daarnaast een inleidend gedeelte over hoe het in het algemeen werkt.
De belangrijkste prestatietaken: van gegevensverzameling tot gegevensopschoning
Laten we beginnen met dat er bepaalde prestatietaken zijn waarmee elk monitoringsysteem te maken krijgt. De eerste prestatietaak is het snel verzamelen en verwerken van gegevens.
Een goed monitoringsysteem moet snel en tijdig alle gegevens ontvangen, deze verwerken volgens triggerexpressies, wat betekent dat ze op basis van bepaalde criteria (in verschillende systemen is dit anders) moeten worden verwerkt en in de database moeten worden opgeslagen, zodat deze gegevens later kunnen worden gebruikt.
De tweede prestatietaak is het opslaan van de historie. Het is vaak noodzakelijk om gegevens in de database op te slaan en snelle en gemakkelijke toegang te hebben tot deze metrics die over een bepaalde periode zijn verzameld. Het belangrijkste is dat deze gegevens gemakkelijk toegankelijk zijn, zodat je ze kunt gebruiken in rapporten, grafieken, triggers, in bepaalde drempelwaarden, voor notificaties, enzovoort.
De derde prestatietaak is het opschonen van de historie, dat wil zeggen wanneer je zo'n dag hebt dat je geen gedetailleerde metrics hoeft op te slaan die over 5 jaar zijn verzameld (zelfs maanden of twee maanden). Bepaalde knooppunten in het netwerk zijn verwijdert of bepaalde hosts, metrics zijn al niet meer nodig omdat ze verouderd zijn en niet meer worden verzameld. Dit moet allemaal worden opgeschoond, zodat je database niet te groot wordt. En over het algemeen is het opschonen van de historie meestal een serieuze uitdaging voor de opslag – het heeft vaak een grote impact op de prestaties.
Hoe om te gaan met cacheproblemen?
Ik ga nu specifiek praten over 'Zabbix'. In 'Zabbix' worden de eerste en tweede oproepen opgelost met caching.
Gegevensverzameling en -verwerking: we gebruiken het RAM-geheugen om al deze gegevens op te slaan. Hierover zal nu meer worden verteld.
Aan de databasezijde is er ook bepaalde caching voor de belangrijkste selecties – voor grafieken en andere zaken.
Caching aan de zijde van de Zabbix-server: we hebben ConfigurationCache, ValueCache, HistoryCache, TrendsCache. Wat is dat precies?
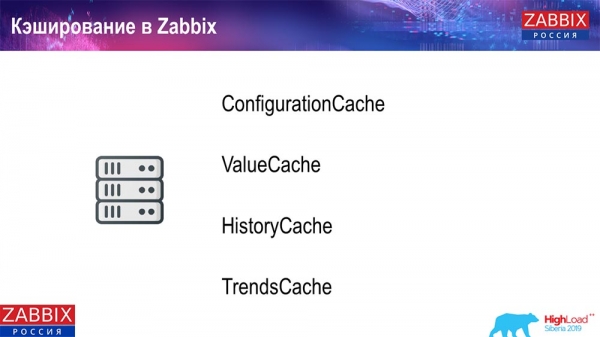
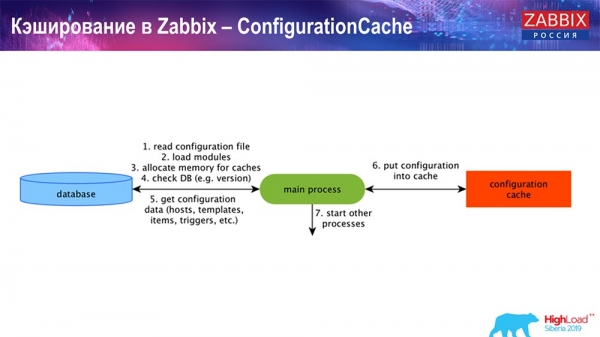
ConfigurationCache is de belangrijkste cache waarin we metrics, hosts, data-items, triggers opslaan; alles wat nodig is voor de verwerking van pre-processing, gegevensverzameling, van welke hosts te verzamelen en met welke frequentie. Dit alles wordt in ConfigurationCache opgeslagen om niet naar de database te hoeven gaan en onnodige verzoeken te creëren. Na de start van de server vernieuwen we deze cache (maken we aan) en werken we deze periodiek bij (afhankelijk van de configuratie-instellingen).
Caching in Zabbix. Gegevensverzameling
Hier is het schema behoorlijk groot:
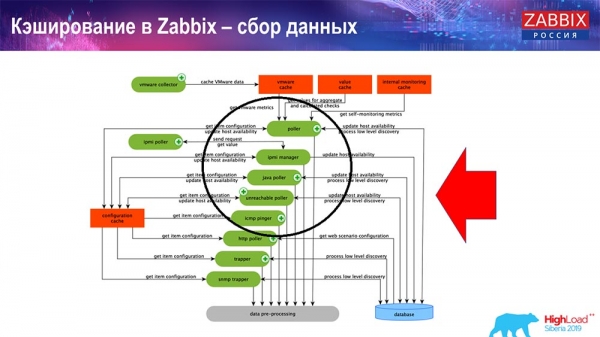
De belangrijkste punten in het schema zijn deze verzamelaars:
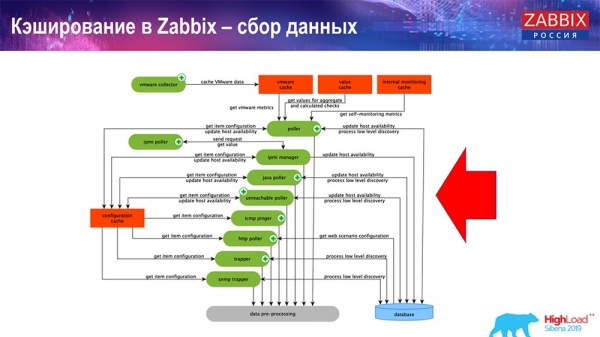
Dit zijn de procesgroepen die verantwoordelijk zijn voor verschillende soorten verzameling. Ze verzamelen gegevens via icmp, ipmi, verschillende protocollen en sturen alles door naar de pre-processing.
PreProcessing HistoryCache
Als we berekende data-items hebben (iedereen die bekend is met 'Zabbix' weet dit), dat wil zeggen, berekende aggregatie-data-items, dan halen we ze rechtstreeks uit ValueCache. Hoe dit wordt gevuld, vertel ik later. Alle deze verzamelaars gebruiken ConfigurationCache om hun taken te verkrijgen en sturen deze vervolgens door naar de pre-processing.
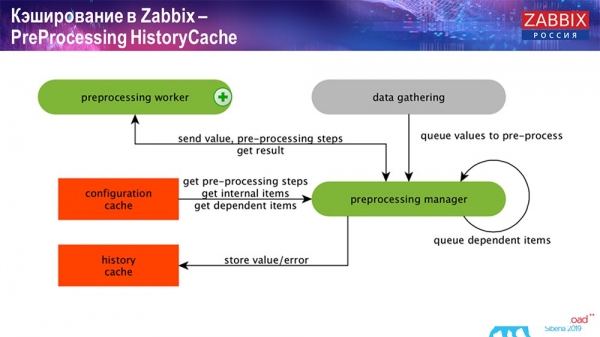
De pre-processing gebruikt ook ConfigurationCache om de stappen van de pre-processing te verkrijgen en verwerkt deze gegevens op verschillende manieren. Sinds versie 4.2 is dit voor ons uitgevoerd op de proxy. Dit is erg handig, omdat de pre-processing een vrij zware operatie is. En als je een zeer grote 'Zabbix' hebt, met een groot aantal data-items en een hoge verzamelingsfrequentie, dan vergemakkelijkt dit de werkzaamheden aanzienlijk.
Nadat we deze gegevens op een of andere manier hebben verwerkt met pre-processing, slaan we ze op in HistoryCache zodat ze verder kunnen worden verwerkt. Hiermee eindigt de gegevensverzameling. We gaan over naar het hoofdproces.
Werking van History syncer
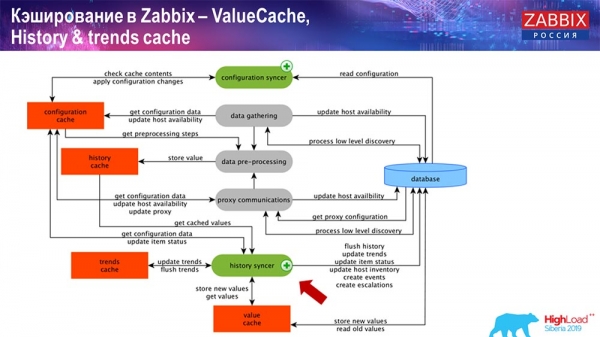
Het belangrijkste proces in 'Zabbix' (aangezien dit een monolithische architectuur is) is de History syncer. Dit is het hoofdproces dat zich bezighoudt met de atomische verwerking van elk datatelement, dat wil zeggen elke waarde:
- de waarde komt binnen (hij haalt deze uit HistoryCache);
- controleert in Configuration syncer: zijn er triggers voor berekening - berekent deze;
als die er zijn - maakt gebeurtenissen aan, maakt een escalatie aan om een waarschuwing te creëren als dat nodig is volgens de configuratie; - legt triggers vast voor latere verwerking, aggregatie; als je aggregeert over het afgelopen uur enzovoort, onthoudt deze waarde ValueCache, zodat je niet de geschiedenis tabel hoeft te raadplegen; op deze manier wordt ValueCache gevuld met de benodigde gegevens die nodig zijn voor het berekenen van triggers, berekende elementen enzovoort;
- vervolgens schrijft de History syncer alle gegevens naar de database;
- de database schrijft ze naar de schijf - hiermee eindigt het verwerkingsproces.
Databases. Caching
Aan de databasezijde, wanneer je grafieken of rapporten over gebeurtenissen wilt bekijken, zijn er verschillende caches. Maar in het kader van deze presentatie zal ik daar niet over spreken.
Voor MySQL is er Innodb_buffer_pool, plus een heleboel andere caches die ook kunnen worden ingesteld.
Maar dit zijn de belangrijkste:
- shared_buffers;
- effective_cache_size;
- shared_pool.
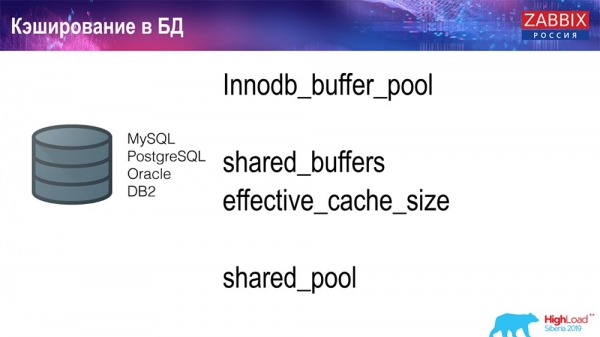
Voor alle databases heb ik aangegeven dat er bepaalde caches zijn die het mogelijk maken om de gegevens die vaak nodig zijn voor queries in het werkgeheugen te houden. Daar hebben ze hun eigen technologieën voor.
Over de prestaties van de database
Er is dus een concurrentiële omgeving, dat wil zeggen dat de 'Zabbix'-server gegevens verzamelt en schrijft. Bij een herstart leest hij ook uit de geschiedenis om ValueCache te vullen enzovoort. Je kunt ook scripts en rapporten hebben die gebruik maken van de 'Zabbix'-API, die is gebouwd op basis van de webinterface. 'Zabbix'-API gaat de database in en haalt de benodigde gegevens op om grafieken, rapporten of een lijst van gebeurtenissen, recente problemen te verkrijgen.
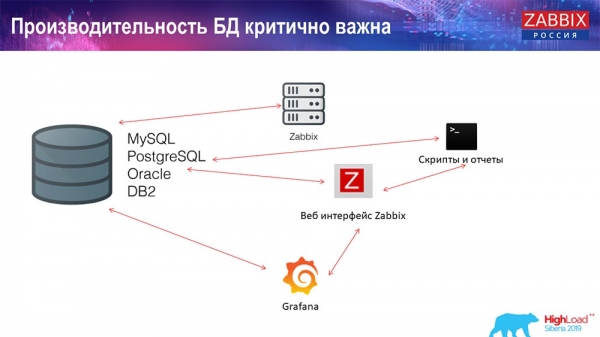
Een zeer populaire oplossing voor visualisatie is Grafana, dat door onze gebruikers wordt gebruikt. Het kan direct toegang krijgen via zowel de 'Zabbix'-API als de database. Het creëert ook bepaalde concurrentie voor het verkrijgen van gegevens: er is een fijnere, goede databankinstelling nodig om te voldoen aan snelle resultaatverrichting en testen.
Geschiedenis wissen. In Zabbix is er een Housekeeper
De derde oproep die wordt gebruikt in Zabbix is het wissen van de geschiedenis door middel van de Housekeeper. De Housekeeper houdt zich aan alle instellingen; dat wil zeggen, we hebben in de gegevenselementen aangegeven hoe lang we gegevens willen bewaren (in dagen), hoe lang we trends willen bewaren en de dynamiek van wijzigingen.
Ik heb niet verteld over de TrendCache, die we on-the-fly berekenen: gegevens komen binnen, we aggregeren ze over een periode van één uur (meestal zijn dit cijfers van het afgelopen uur), het gemiddelde/minimale aantal en we schrijven dit eenmaal per uur in de tabel voor dynamiek veranderingen (‘Trends’). De Housekeeper wordt gestart en verwijdert gegevens uit de database met reguliere selects, wat niet altijd efficiënt is.
Hoe kun je begrijpen dat dit niet efficiënt is? Je kunt op de prestatiediagrammen van interne processen zo'n beeld zien:
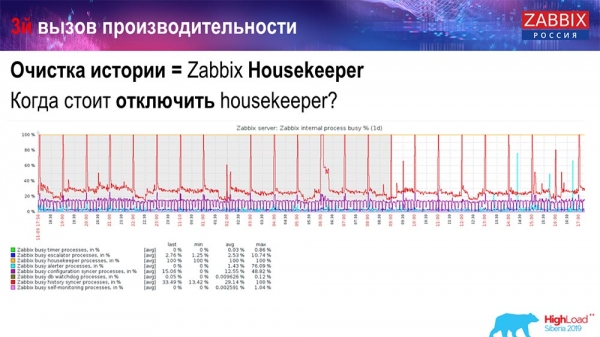
Je hebt de History syncer die constant bezig is (rode grafiek). En de ‘oranje’ grafiek, die bovenop loopt. Dit is de Housekeeper, die gestart wordt en wacht op de database om alle rijen te verwijderen die hij heeft opgegeven.
Laten we een Item ID nemen: we moeten de laatste 5000 verwijderen; dat kan natuurlijk via de indexen. Maar meestal is de dataset groot genoeg zodat de database dit van de schijf moet lezen en in de cache moet laden, wat een dure operatie voor de database is. Afhankelijk van de grootte kan dit leiden tot bepaalde prestatieproblemen.
De Housekeeper kan eenvoudig worden uitgeschakeld – we hebben de welbekende webinterface. In de instellingen van Administration general (instellingen voor de Housekeeper) schakelen we het interne housekeeping voor de interne geschiedenis en trends uit. Bijgevolg beheert de Housekeeper dit niet meer:
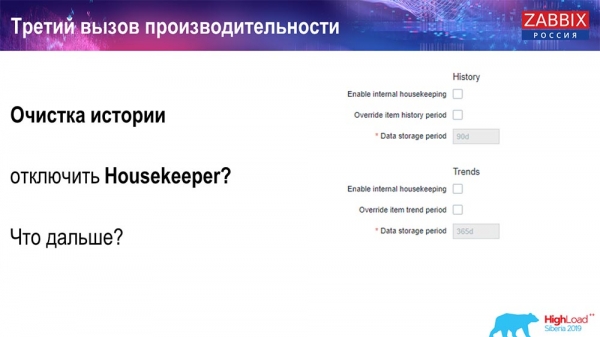
Wat kan je verder doen? Je hebt het uitgeschakeld, je grafieken zijn in balans… Welke problemen kunnen er in dat geval verder zijn? Wat kan helpen?
Partitionering (sektieering)
Dit wordt meestal op verschillende manieren ingesteld op elke relationele database die ik heb genoemd. MySQL heeft zijn eigen technologie. Maar over het algemeen zijn ze heel vergelijkbaar als we het hebben over PostgreSQL 10 en MySQL. Natuurlijk zijn er veel interne verschillen in hoe dit alles is geïmplementeerd en hoe dit van invloed is op de prestaties. Maar over het algemeen leidt het creëren van een nieuwe partitionering vaak ook tot bepaalde problemen.
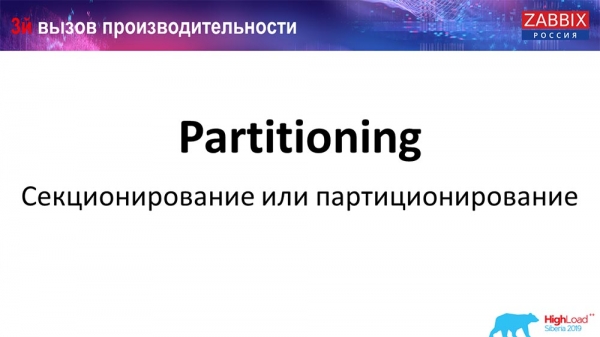
Afhankelijk van uw setup (hoeveel gegevens er per dag worden aangemaakt), wordt meestal de minimale instelling gekozen - dit is 1 dag/partitie, en voor 'trends', de dynamiek van veranderingen - 1 maand/nieuwe partitie. Dit kan variëren als u een zeer grote setup heeft.
Laat me meteen iets zeggen over de omvang van de setup: tot 5.000 nieuwe waarden per seconde (de zogenaamde nvps) wordt beschouwd als een kleine 'setup'. Gemiddeld ligt het tussen de 5.000 en 25.000 waarden per seconde. Alles daarboven wordt beschouwd als grote en zeer grote installaties, die zeer zorgvuldige configuratie van de database vereisen.
Bij zeer grote installaties is 1 dag misschien niet optimaal. Persoonlijk heb ik MySQL-partities gezien van 40 gigabyte per dag (en ze kunnen nog groter zijn). Dit is een zeer grote hoeveelheid gegevens die problemen kan veroorzaken. Het moet worden verminderd.
Waarom is partitionering nodig?
Wat partitionering oplevert, weet ik zeker dat iedereen kent - dat is het segmenteren van tabellen. Vaak zijn dit aparte bestanden op schijf en spanne-query's. Het selecteert optimaler één partitie als dat deel uitmaakt van de normale partitionering.
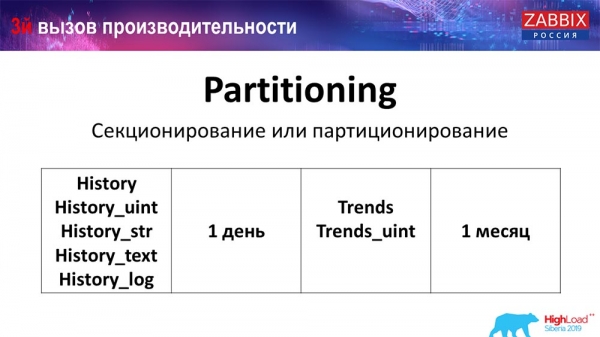
Voor 'Zabbix' wordt specifiek gebruikgemaakt van bereik, dat wil zeggen dat we een timestamp gebruiken (een normaal getal, tijd sinds het begin van het tijdperk). U stelt het begin van de dag/einde van de dag in, en dat is de partitie. Als u daarom gegevens vraagt van twee dagen geleden, worden deze sneller vanuit de database opgehaald omdat er slechts één bestand in de cache hoeft te worden geladen en gepresenteerd (en geen grote tabel).
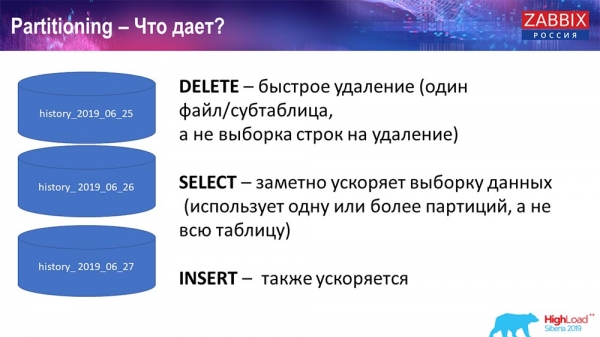
Veel databases versnellen ook de insert (invoeren in één child-tabel). Terwijl ik abstract spreek, is dit ook mogelijk. Partitionering helpt vaak.
Elasticsearch voor NoSQL
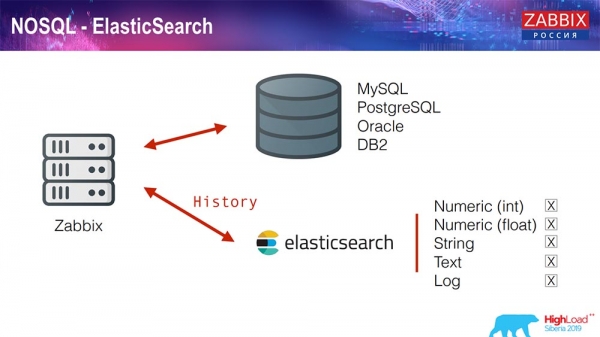
Onlangs, in 3.4, hebben we een oplossing voor NoSQL geïmplementeerd. We hebben de mogelijkheid toegevoegd om in Elasticsearch te schrijven. U kunt aparte typen kiezen: ofwel schrijft u nummers, of bepaalde tekens; we hebben string-tekst, logs die u in Elasticsearch kunt schrijven… Het webinterface zal ook toegang krijgen tot Elasticsearch. Dit werkt op bepaalde momenten uitstekend, maar op dit moment kan het worden gebruikt.
TimescaleDB. Hyper-tabellen
Voor 4.4.2 hebben we één ding opgemerkt, namelijk TimescaleDB. Wat is dat? Het is een uitbreiding voor PostgreSQL, wat betekent dat het een native interface heeft voor PostgreSQL. Bovendien maakt deze uitbreiding het mogelijk om veel efficiënter met tijdseriesgegevens te werken en automatische partitionering te hebben. Hoe ziet dat eruit:
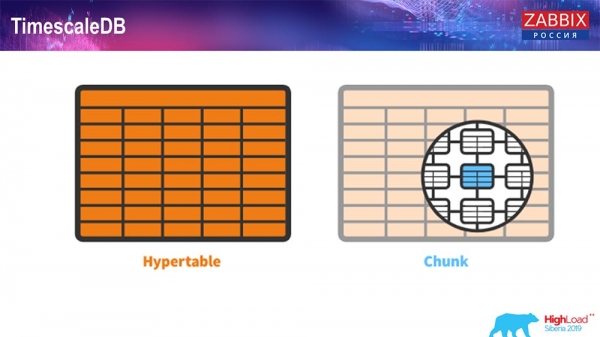
Dit is een hypertable – er is een dergelijk begrip in Timescale. Dit is een hypertable die je creëert, en daarin bevinden zich chunks. Chunks zijn partitionen, dit zijn child-tables, voor zover ik weet. Dit is echt efficiënt.
TimescaleDB en PostgreSQL
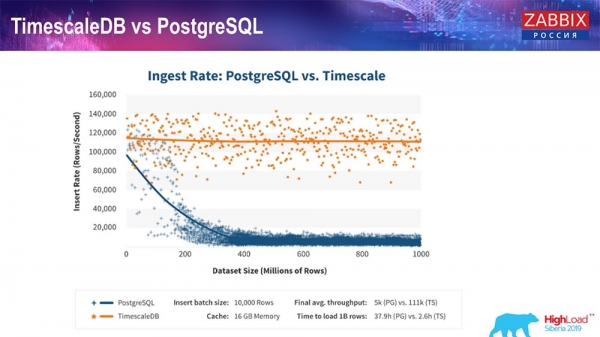
Volgens de producenten van TimescaleDB gebruiken zij een meer correct algoritme voor het verwerken van queries, in het bijzonder insert-opdrachten, waardoor een vrijwel constante prestaties mogelijk is bij een toenemende grootte van de dataset-insert. Dat betekent dat na 200 miljoen rijen, PostgreSQL normaal gesproken aanzienlijk begint in te zakken en de prestaties letterlijk tot nul verliezen, terwijl Timescale het mogelijk maakt om inserts zo efficiënt mogelijk uit te voeren, ongeacht de hoeveelheid gegevens.
Hoe installeer je TimescaleDB? Heel eenvoudig!
Het staat in de documentatie beschreven – je kunt het installeren via pakketten voor elke… Het is afhankelijk van de officiële PostgreSQL-pakketten. Je kunt het ook handmatig compileren. Het is zo dat ik het moest compileren voor de database.
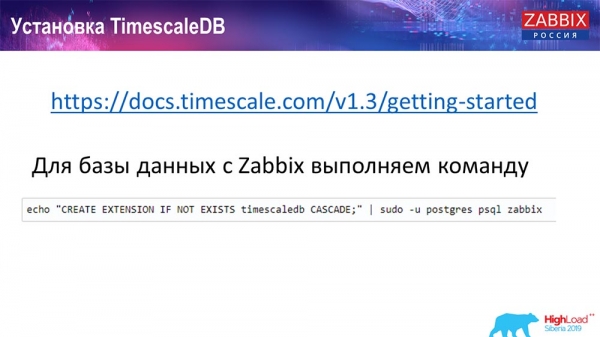
Bij Zabbix activeren we gewoon de Extention. Ik denk dat degenen die Extention in PostgreSQL hebben gebruikt... Je activeert gewoon de Extention en creëert deze voor de Zabbix-database die je gebruikt.
En de laatste stap…
TimescaleDB. Migratie van geschiedenis-tabellen
Je moet een hypertable maken. Hiervoor is er een speciale functie – Create hypertable. In de eerste parameter geef je de tabel op die in deze database nodig is (waarvoor je een hypertable moet creëren).
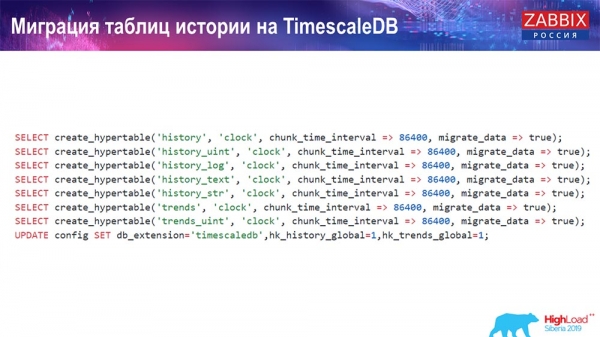
Het veld waarop je moet creëren en chunk_time_interval (dit is het interval van chunks (partitionen) die gebruikt moeten worden). 86 400 is één dag.
Parameter migrate_data: als je deze op true zet, worden alle huidige gegevens naar de vooraf gemaakte chunks verplaatst.
Ik heb zelf migrate_data gebruikt – dit kost behoorlijk wat tijd, afhankelijk van de grootte van je database. Ik had meer dan een terabyte – de creatie duurde meer dan een uur. In sommige gevallen heb ik tijdens het testen historische gegevens voor tekst (history_text) en string (history_str) verwijderd om ze niet te verplaatsen – ze waren voor mij eigenlijk niet interessant.
En de laatste update die we doen in onze db_extention: we installeren timescaledb, zodat de database en, in het bijzonder, onze 'Zabbix', begrijpen dat er een db_extention is. Deze activeert het en gebruikt de juiste syntaxis en queries naar de database, gebruikmakend van de 'features' die nodig zijn voor TimescaleDB.
Serverconfiguratie
Ik heb twee servers gebruikt. De eerste server is een relatief kleine virtuele machine, met 20 processoren en 16 gigabyte RAM. Ik heb hierop 'PostgreSQL' 10.8 ingesteld:
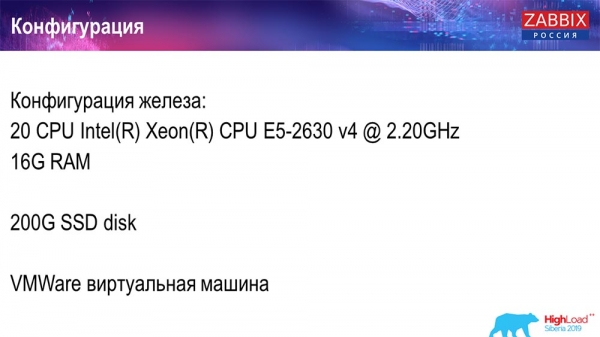
Het besturingssysteem was Debian, het bestandssysteem – xfs. Ik heb minimale instellingen gedaan om precies deze database te gebruiken, afgezien van wat Zabbix zelf zal gebruiken. Op deze machine was de Zabbix-server, PostgreSQL en de load agents geïnstalleerd.
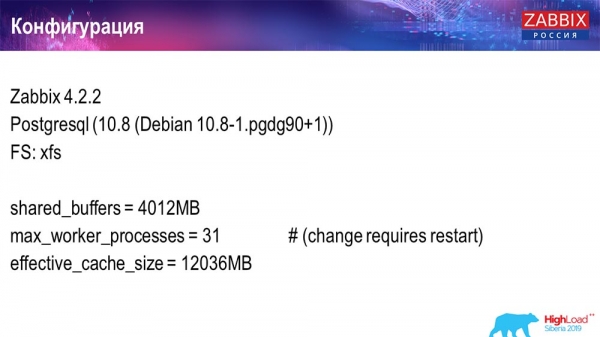
Ik gebruikte 50 actieve agents, die LoadableModule gebruiken om snel verschillende resultaten te genereren. Deze genereerden rijen, getallen enzovoorts. Ik vulde de database met een grote hoeveelheid gegevens. Aanvankelijk bevatte de configuratie 5.000 gegevenspunten per host, en elk gegevenspunt had ongeveer één trigger – zodat dit een echte setup was. Soms is zelfs meer dan één trigger nodig voor gebruik.
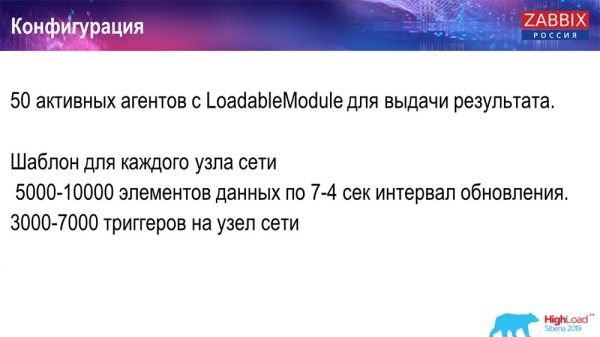
Het update-interval en de belasting ontdekte ik door niet alleen 50 agents te gebruiken (ik voegde er nog meer toe), maar ook met behulp van dynamische gegevenspunten en het update-interval verlaagde tot 4 seconden.
Prestatie-test. PostgreSQL: 36.000 NVPs
De eerste keer dat ik opstartte, was mijn eerste setup op een schone PostgreSQL 10 op deze hardware (35.000 waarden per seconde). Over het algemeen, zoals te zien op het scherm, duurt het invoeren van gegevens fracties van seconden – alles gaat goed en snel, SSD's (200 gigabyte). Het enige is dat 20 GB redelijk snel vol raken.
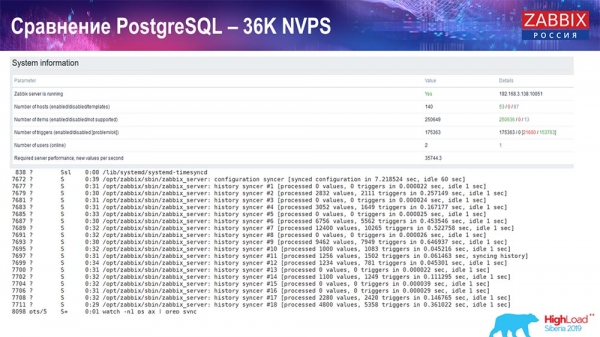
Er zullen nog veel van dergelijke grafieken zijn. Dit is het standaard prestatie-dashboard van de Zabbix-server.
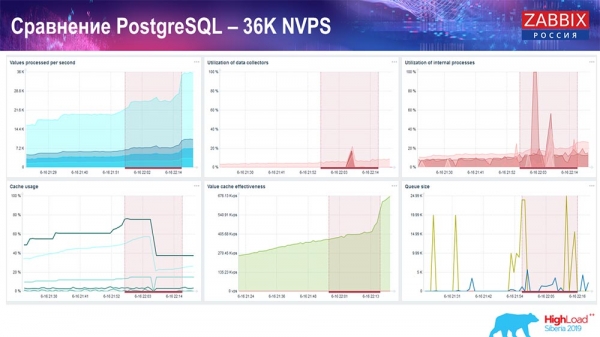
De eerste grafiek – aantal waarden per seconde (blauw, linksboven), 35.000 waarden in dit geval. Dit (boven in het midden) is de belasting van de verzamelingprocessen, en dit (rechtsboven) is de belasting van de interne processen: history syncers en housekeeper, die hier (onderin het midden) genoeg tijd in beslag nam.
Deze grafiek (onderaan in het midden) toont het gebruik van ValueCache – hoeveel hits ValueCache heeft voor triggers (duizenden waarden per seconde). Een andere belangrijke grafiek is de vierde (onderaan links), die het gebruik van HistoryCache laat zien, waar ik eerder over sprak, dat fungeert als een buffer voordat het in de database wordt ingevoegd.
Prestatie test. PostgreSQL: 50.000 NVP's
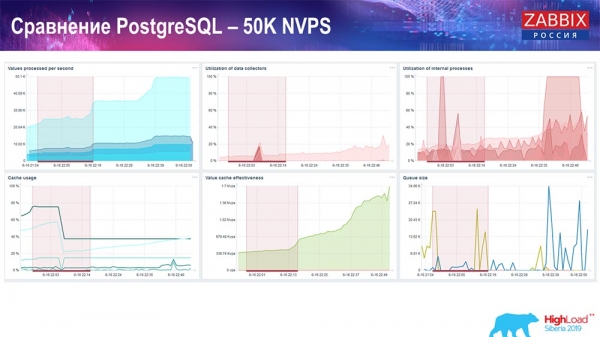
Daarna verhoogde ik de belasting tot 50.000 waarden per seconde op dezelfde hardware. Bij het laden door 'Housekeeper' werden 10.000 waarden al in 2-3 seconden geschreven met berekening. Dit wordt eigenlijk weergegeven in de volgende screenshot:
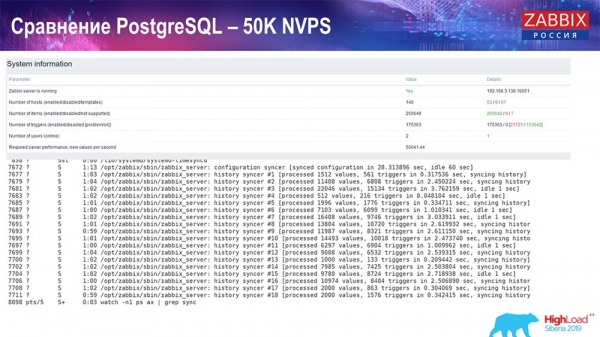
'Housekeeper' begint al de werking te verstoren, maar over het algemeen blijft de belasting van de history syncers nog steeds rond de 60% (de derde grafiek, rechtsboven). HistoryCache begint al tijdens het werken met 'Housekeeper' actief vol te lopen (onderaan links). Het was ongeveer een halve gigabyte en vulde voor 20% op.
Prestatie test. PostgreSQL: 80.000 NVP's
Vervolgens verhoogde ik het tot 80.000 waarden per seconde:
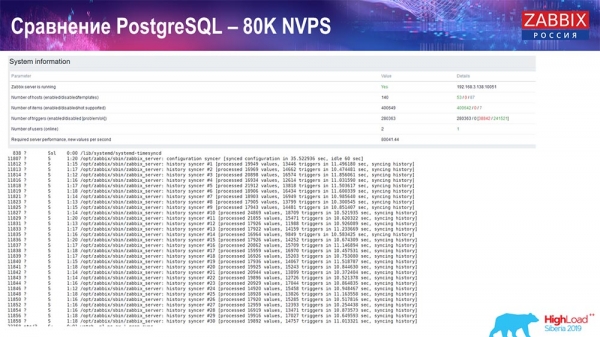
Dit waren ongeveer 400.000 gegevens elementen, 280.000 triggers. De invoer, zoals te zien is, had al een aanzienlijke belasting op de history syncers (er waren er 30). Hierna verhoogde ik verschillende parameters: history syncers, cache… Op deze hardware begon de belasting van de history syncers te stijgen tot het maximum, praktisch 'in de plank' – respectievelijk begon HistoryCache een zeer hoge belasting te ervaren:
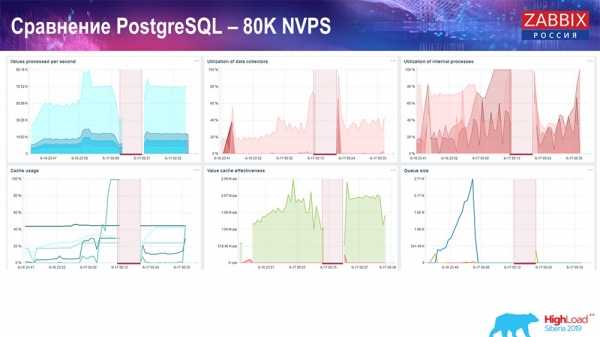
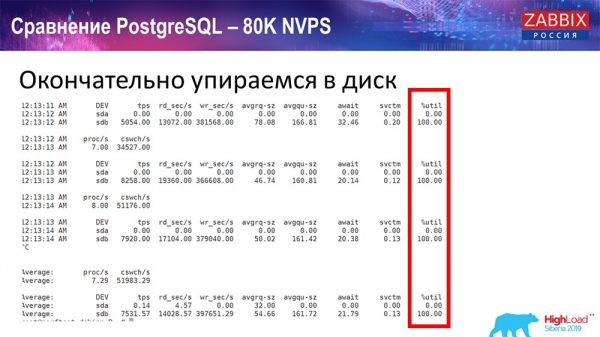
De hele tijd hield ik toezicht op alle parameters van het systeem (hoe de CPU wordt gebruikt, werkgeheugen) en ontdekte ik dat de schijfutilisatie maximaal was – ik had de maximale capaciteit van deze schijf op deze hardware, op deze virtuele machine bereikt. 'Postgres' begon bij zo'n intensiteit de gegevens vrij actief te flushen, en de schijf kon het schrijven en lezen al niet meer bijhouden...
Ik nam een andere server, die al 48 processoren en 128 gigabyte RAM had:
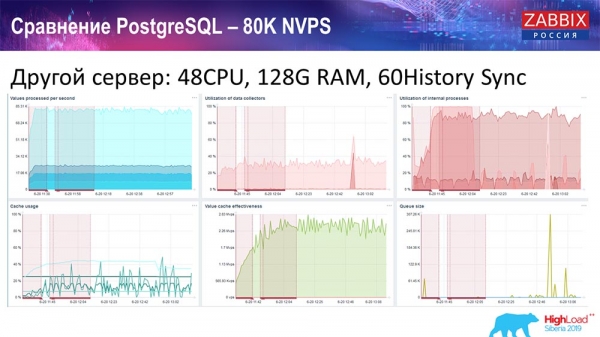
Ik heb het ook 'geoptimaliseerd' – ik installeerde History syncer (60 stuks) en bereikte een acceptabele snelheid. In feite zijn we niet 'in de plank', maar dit is waarschijnlijk de limiet van de prestaties, waar iets mee gedaan moet worden.
Prestatie test. TimescaleDB: 80.000 NVP's
Mijn belangrijkste doel was om TimescaleDB te gebruiken. Op elke grafiek is een daling te zien:
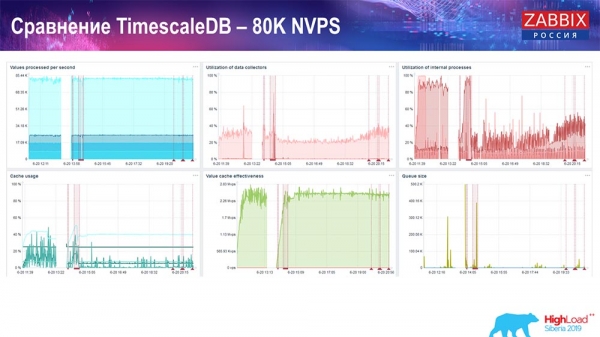
Deze uitval betreft precies de migratie van gegevens. Na dit proces is het laadprofiel van de history-syncers op de 'Zabbix'-server, zoals je kunt zien, aanzienlijk veranderd. Het is bijna drie keer sneller in staat om gegevens in te voegen en gebruikt minder HistoryCache – waardoor je data tijdig geleverd worden. Nogmaals, 80.000 waarden per seconde is een behoorlijk hoog tempo (natuurlijk niet voor 'Yandex'). Over het geheel genomen is het een grote setup met één server.
PostgreSQL prestatietest: 120.000 NVP's
Daarna verhoogde ik de waarde van het aantal gegevenselementen tot een half miljoen en kreeg een gemeten waarde van 125.000 per seconde:
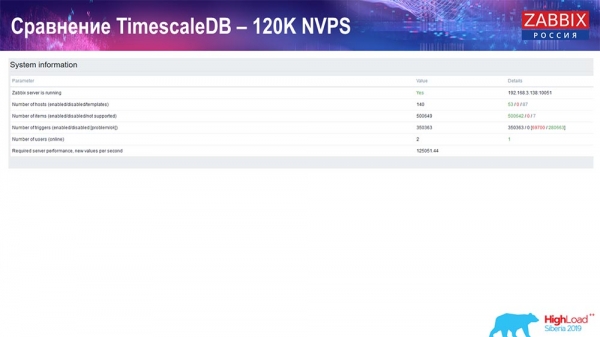
En ik kreeg de volgende grafieken:
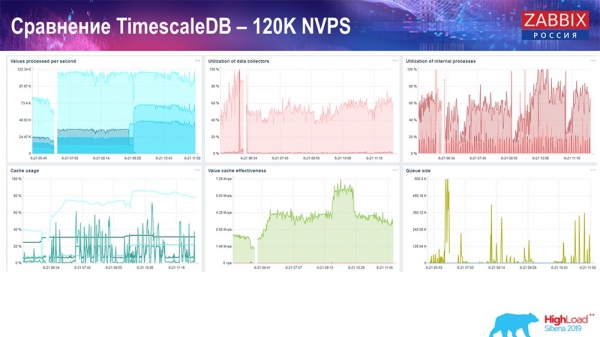
In principe is dit een werkende setup, hij kan een vrij lange tijd draaien. Maar omdat ik slechts een schijf van 1,5 terabyte had, was ik die binnen een paar dagen kwijt. Het belangrijkste is dat er ondertussen nieuwe partities in TimescaleDB werden aangemaakt, en dit ging qua prestaties volledig onopvallend, wat je niet kunt zeggen over MySQL.
Over het algemeen worden partities 's nachts aangemaakt omdat dit de invoeging en het werken met tabellen volledig blokkeert, wat kan leiden tot degradatie van de dienst. In dit geval is dat niet het geval! De belangrijkste taak was om de mogelijkheden van TimescaleDB te testen. Het resultaat was: 120.000 waarden per seconde.
Er zijn ook voorbeelden in de 'community':
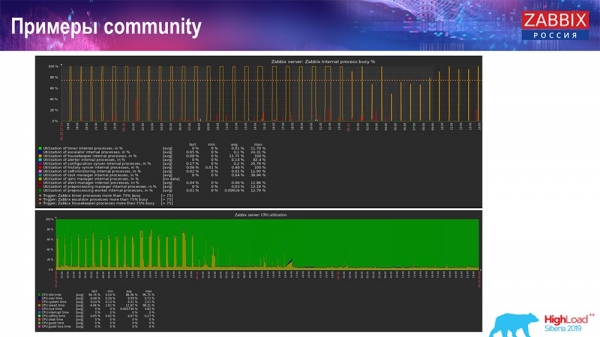
Iemand heeft ook TimescaleDB ingeschakeld en het gebruik van io.weight daalde op de processor; en het gebruik van interne proces elementen nam ook af dankzij de inschakeling van TimescaleDB. Bovendien zijn dit reguliere schijven, dat wil zeggen een gewone virtuele machine op reguliere schijven (geen SSD)!
Voor kleine setups die vastlopen op schijfprestaties, lijkt TimescaleDB mij een zeer goede oplossing. Het zal goed helpen om door te werken tot je migreert naar snellere hardware voor de database.
Ik nodig jullie allemaal uit voor onze evenementen: Conference – in Moskou, Summit – in Riga. Maak gebruik van onze kanalen – 'Telegram', forum, IRC. Als je vragen hebt, kom dan naar onze stand, we kunnen over alles praten.
Vragen uit het publiek
Vraag uit het publiek (hierna - A): - Als TimescaleDB zo eenvoudig in te stellen is en het zo'n prestatiewinst biedt, zou het dan misschien moeten worden gebruikt als beste praktijk voor de configuratie van 'Zabbix' met 'Postgres'? Zijn er ook valkuilen en nadelen aan deze oplossing, of kan ik, als ik besluit 'Zabbix' te gebruiken, gewoon 'Postgres' nemen, 'Timescale' er meteen op installeren, het gebruiken en me geen zorgen maken over problemen?
AG: - Ja, ik zou zeggen dat het een goed advies is: gebruik 'Postgres' meteen met de TimescaleDB-extensie. Zoals ik al zei, zijn er veel positieve feedbacks, ondanks dat deze 'feature' experimentieel is. Maar eigenlijk tonen tests aan dat dit een uitstekende oplossing is (met TimescaleDB), en ik denk dat het zich verder zal ontwikkelen! We volgen de ontwikkeling van deze extensie en zullen aanpassen wat nodig is.
We hebben zelfs tijdens de ontwikkeling vertrouwt op een van hun bekende 'features': daar kon je een beetje anders met chunks werken. Maar later hebben ze dit in de volgende release verwijderd, en moesten we ons niet meer op deze code baseren. Ik zou aanraden deze oplossing op veel setups te gebruiken. Als je MySQL gebruikt… Voor gemiddelde setups werkt elke oplossing redelijk goed.
A: - Op de laatste grafieken, afkomstig van de community, was er een grafiek met 'Housekeeper':
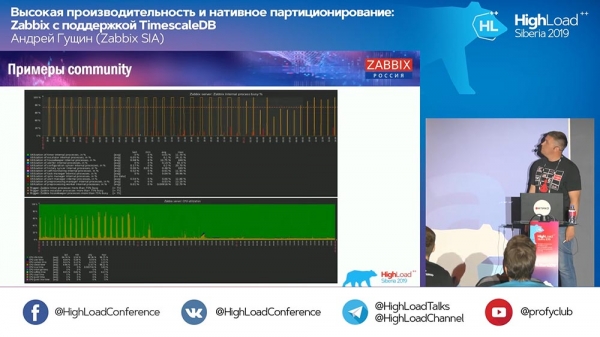
Hij bleef werken. Wat doet 'Housekeeper' in het geval van TimescaleDB?
AG: - Ik kan nu niet precies zeggen - ik kijk naar de code en zal er meer gedetailleerd over vertellen. Hij gebruikt specifiek TimescaleDB-query's niet om chunks te verwijderen, maar aggregeert op een andere manier. Voor nu kan ik deze technische vraag niet beantwoorden. We zullen het vandaag of morgen op de stand verduidelijken.
A: - Ik heb een vergelijkbare vraag - over de performance van het verwijderen in 'Timescale'.
A (antwoord uit het publiek): - Als je gegevens uit een tabel verwijdert, en je doet dat via delete, moet je door de tabel lopen - verwijderen, opruimen, alles markeren voor toekomstige vacuum. In 'Timescale', omdat je chunks hebt, kun je droppen. Om het eenvoudig te zeggen, je vertelt letterlijk het bestand dat in big data ligt: 'Verwijder!'
«Timescale» begrijpt simpelweg dat er geen dergelijk chunk meer is. En omdat het integreert met de query planner, vangt het uw voorwaarden in de select of in andere operaties via hooks en begrijpt het meteen dat deze chunk niet meer bestaat – «Ik ga daar niet meer naartoe!» (gegevens ontbreken). Dat is alles! Dit betekent dat het scannen van de tabel wordt vervangen door het verwijderen van een binaire bestand, waardoor dit snel gaat.
A: – We hebben het onderwerp niet-SQL al besproken. Voor zover ik weet, hoeft «Zabbix» de gegevens niet echt aan te passen; het is meer een soort log. Is het mogelijk om gespecialiseerde databases te gebruiken die hun gegevens niet kunnen wijzigen, maar die veel sneller kunnen opslaan, accumuleren en leveren – zoals Clickhouse of iets dat op Kafka lijkt? Kafka is toch ook een log! Kan er een integratie plaatsvinden?
AG: – Het exporteren is mogelijk. We hebben een bepaalde «feature» sinds versie 3.4: u kunt alle historische bestanden, evenementen en dergelijke in bestanden schrijven; en vervolgens met een bepaalde handler naar elke andere database verzenden. Veel mensen herschrijven direct naar de database. In real-time schrijven history-sinkers dit alles naar bestanden, roteren deze bestanden, enzovoort, en u kunt dit naar «Clickhouse» overbrengen. Ik kan niets zeggen over plannen, maar mogelijk zal de verdere ondersteuning van NoSQL-oplossingen (zoals «Clickhouse») doorgaan.
A: – Dus, kan men volledig van PostgreSQL afkomen?
AG: – Zeker, het moeilijkste deel van «Zabbix» zijn de historische tabellen, die de meeste problemen veroorzaken, en de evenementen. In dit geval, als u de evenementen niet lang opslaat en de geschiedenis met trends in een andere snelle opslag bijhoudt, dan denk ik dat er verder geen problemen zullen zijn.
A: – Kunt u inschatten hoe veel sneller alles zal werken als we naar «Clickhouse» overstappen?
AG: – Ik heb het niet getest. Ik denk dat het mogelijk is om dezelfde cijfers vrij eenvoudig te bereiken, gezien het feit dat «Clickhouse» zijn eigen interface heeft, maar ik kan niets definitiefs zeggen. Het is beter om te testen. Het hangt allemaal af van de configuratie: hoeveel hosts u heeft, enzovoort. Invoeren is één ding, maar je moet die gegevens ook ophalen – met Grafana of iets anders.
A: – Dus we spreken over een gelijke competitie en niet over een groot voordeel van deze snelle databases?
AG: – Ik denk dat wanneer we integreren, er meer nauwkeurige tests zullen zijn.
A: – Waar is de goede oude RRD gebleven? Wat heeft de overgang naar SQL-databases veroorzaakt? Oorspronkelijk werden alle metrics op RRD verzameld.
AG: – In «Zabbix» was RRD misschien in een zeer oude versie aanwezig. Er waren altijd al SQL-databases – de klassieke benadering. De klassieke benadering is MySQL, PostgreSQL (die al heel lang bestaan). We hebben de algemene interface voor SQL-databases, maar RRD hebben we praktisch nooit gebruikt.

Een beetje reclame 🙂
Bedankt dat je bij ons blijft. Houd je van onze artikelen? Wil je meer interessante inhoud zien? Ondersteun ons door een bestelling te plaatsen of ons aan vrienden aan te bevelen, , een unieke variant van entry-level servers, die we voor jou hebben bedacht: (opties beschikbaar met RAID1 en RAID10, tot 24 cores en tot 40GB DDR4).
Dell R730xd is 2 keer goedkoper in datacenter Equinix Tier IV in Amsterdam? Alleen bij ons in Nederland! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — vanaf $99! Lees over hoe
Bron: habr.com
