

Iedereen praat over ontwikkelings- en testprocessen, het trainen van personeel, het verhogen van motivatie, maar deze processen zijn onvoldoende wanneer elke minuut downtime van de service astronomische kosten met zich meebrengt. Wat te doen wanneer je financiële transacties uitvoert onder strikte SLA-eisen? Hoe verhoog je de betrouwbaarheid en fouttolerantie van je systemen, zonder de ontwikkeling en testing erbij te betrekken?
De volgende HighLoad++ conferentie vindt plaats op 6 en 7 april 2020 in St. Petersburg. Details en tickets vindt u op . 9 november, 18:00. HighLoad++ Moskou 2018, zaal 'Delhi + Calcutta'. Samenvattingen en .
Evgeny Kuzovlev (hierna – EK): – Vrienden, hallo! Mijn naam is Evgeny Kuzovlev. Ik ben van EcommPay, specifiek van de EcommPay IT-afdeling, de IT-divisie van de groep bedrijven. En vandaag gaan we het hebben over downtimes - hoe deze te vermijden en hoe de gevolgen te minimaliseren als vermijden niet mogelijk is. Het thema is als volgt: 'Wat te doen als een minuut downtime 100.000 dollar kost'? Voorafgaand aan ons gesprek kan ik zeggen dat de cijfers vergelijkbaar zijn.
Waar bezig is EcommPay IT mee?
Wie zijn wij? Waarom sta ik hier voor jullie? Waarom heb ik het recht om jullie hier iets te vertellen? En waarover gaan we hier dieper in op ingaan?
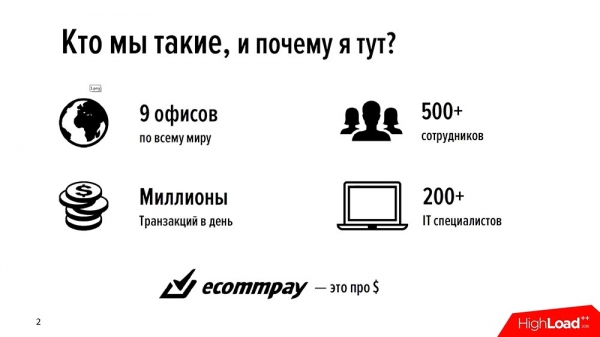
De groep bedrijven EcommPay is een internationale acquirer. We verwerken betalingen over de hele wereld – in Rusland, Europa, en Zuidoost-Azië (All Around the World). We hebben 9 kantoren, in totaal 500 medewerkers, en ongeveer iets minder dan de helft van hen zijn IT-specialisten. Alles wat we doen, alles waarmee we geld verdienen, hebben we zelf gedaan.
Al onze producten (en we hebben er vrij veel – in onze lijn van grote IT-producten hebben we ongeveer 16 verschillende componenten) hebben we zelf geschreven; we schrijven zelf, we ontwikkelen zelf. En momenteel verwerken we ongeveer een miljoen transacties per dag (miljoenen – dat is waarschijnlijk de juiste manier om het te zeggen). We zijn een vrij jong bedrijf – we bestaan ongeveer zes jaar.
Zes jaar geleden was dit een start-up, toen een groep mensen met een bedrijf samenkwam. Ze waren verenigd door een idee (er was verder niets behalve het idee), en we renden. Zoals elke start-up gingen we sneller... Voor ons was snelheid belangrijker dan kwaliteit.
Op een gegeven moment stopten we: we realiseerden ons dat we niet meer met dezelfde snelheid en kwaliteit konden leven en dat we in de eerste plaats de nadruk op kwaliteit moesten leggen. In dat moment besloten we een nieuw platform te ontwikkelen dat correct, schaalbaar en betrouwbaar zou zijn. We begonnen met de ontwikkeling, testing en investering in dit platform, maar op een gegeven moment begrepen we dat de ontwikkeling en testing ons niet in staat stelden om een nieuwe kwaliteitsniveau van de service te bereiken.
Je ontwikkelt een nieuw product, je zet het in productie, maar toch zal er ergens iets misgaan. Vandaag gaan we het hebben over hoe we een nieuw kwaliteitsniveau kunnen bereiken (hoe we dat hebben gedaan, onze ervaring), waarbij we ontwikkeling en testing buiten beschouwing laten; we bespreken wat operationeel beschikbaar is – wat de operatie zelf kan doen, wat het kan aanbieden aan de testing om de kwaliteit te beïnvloeden.
Downtimes. De geboden van operatie.
Altijd de belangrijkste hoeksteen waar we het vandaag over gaan hebben – downtime. Een vreselijk woord. Als we downtime hebben, is alles slecht. We rennen om het op te lossen, de beheerders houden de server in de lucht – laten we hopen dat hij niet valt, zoals in dat lied wordt gezongen. Daar gaan we het vandaag over hebben.
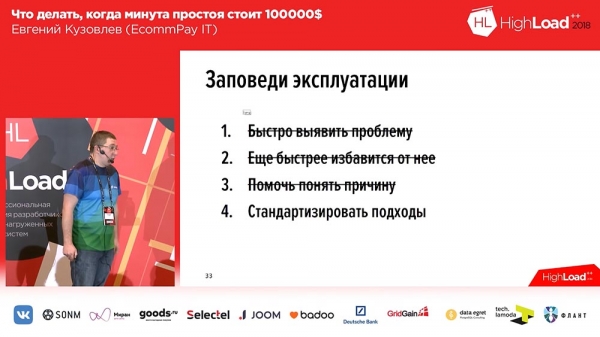
Toen we onze benaderingen begonnen te veranderen, hebben we 4 geboden geformuleerd. Ze zijn gepresenteerd op de dia's:
Deze geboden zijn vrij eenvoudig:
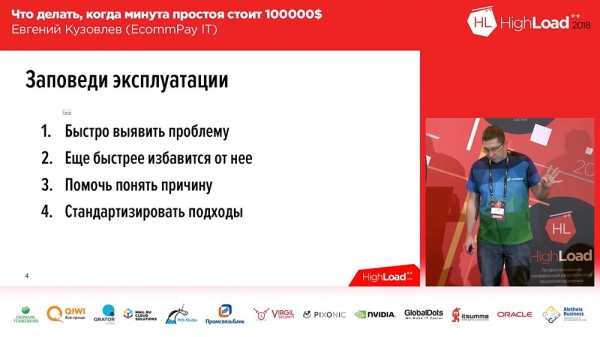
- Identificeer het probleem snel.
- Verhelp het nog sneller.
- Help de oorzaak te begrijpen (later, voor de ontwikkelaars).
- En standaardiseer de benaderingen.
Ik wil uw aandacht vestigen op punt nr. 2. We verhelpen het probleem, we lossen het niet op. Oplossen is secundair. Voor ons is het primair dat de gebruiker van dit probleem wordt beschermd. Het zal bestaan in een soort geïsoleerde omgeving, maar die omgeving zal op geen enkele manier met hem in contact komen. We zullen door deze vier groepen problemen lopen (sommige uitgebreider, andere minder uitgebreid), en ik zal uitleggen wat we gebruiken en welke relevante ervaringen we hebben met oplossingen.
Probleemoplossing: wanneer ze zich voordoen en wat ermee te doen?
Maar laten we niet in volgorde beginnen, laten we beginnen met punt № 2 – hoe kunnen we snel van het probleem afkomen? Er is een probleem – we moeten het oplossen. "Wat moeten we hiermee doen?" – is de centrale vraag. En toen we gingen nadenken over hoe we het probleem konden oplossen, hebben we enkele eisen geformuleerd waaraan de probleemoplossing moet voldoen.
Om deze eisen te formuleren, stelden we ons de vraag: "Wanneer hebben we problemen?" En problemen, zo bleek, komen voor in vier gevallen:
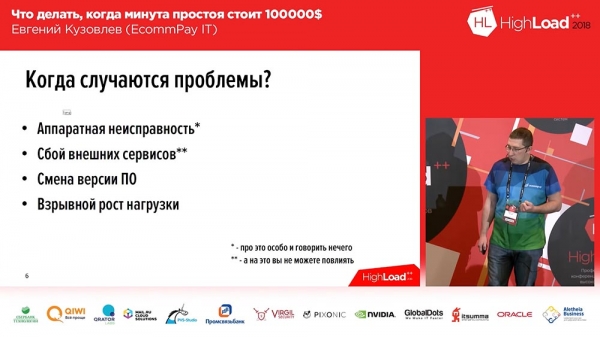
- Hardwarefout.
- Fout van externe services.
- Wijziging van softwareversie (de zogenaamde deployment).
- Explosieve toename in belasting.
We zullen het niet hebben over de eerste twee. Hardwarefouten zijn relatief eenvoudig op te lossen: alles moet gedupliceerd zijn. Als het om schijven gaat – moeten ze in RAID worden samengesteld, als het om servers gaat – moet de server gedupliceerd zijn, en als het om uw netwerkstructuur gaat – moet u een tweede kopie van de netwerkstructuur plaatsen, dat wil zeggen dat u het moet dupliceren. En als er iets faalt, schakelt u over naar de reservevermogen. Hier is het moeilijk om iets meer te zeggen.
De tweede is de fout van externe services. Voor de meeste systemen is dit helemaal geen probleem, maar niet voor ons. Aangezien we betalingen verwerken, zijn we een aggregator die tussen de gebruiker (die zijn kaartgegevens invoert) en de banken, betalingssystemen («Visa», «MasterCard», «Mir») staat. Het is gebruikelijk dat onze externe services (betalingssystemen, banken) storingen hebben. We kunnen hierop geen invloed uitoefenen, net als u (als u dergelijke services hebt).
Wat moeten we dan doen? Hier zijn twee opties. Ten eerste, als u kunt, moet u deze service op de een of andere manier dupliceren. Bijvoorbeeld, als we kunnen, redirecten we het verkeer van de ene service naar de andere: we verwerkten bijvoorbeeld kaarten via «Sberbank», en als er problemen zijn bij «Sberbank», dan redirecten we het verkeer [bij wijze van spreken] naar «Raiffeisen». Ten tweede kunnen we zeer snel storingen van externe services opmerken, en daarom zullen we in het volgende deel van de presentatie over de reactietijd praten.
Feitelijk kunnen we van deze vier specifiek invloed uitoefenen op het wijzigen van softwareversies - acties ondernemen die de situatie in de context van deployments en de explosieve groei van de belasting verbeteren. Dat hebben we gedaan. Hier weer een kleine opmerking…
Enkele van deze vier problemen kunnen onmiddellijk worden opgelost als je een cloud hebt. Als je in de clouds van 'Microsoft Azure', 'Ozon' zit, of onze clouds gebruikt van 'Yandex' of 'Mail', dan wordt in ieder geval hardwarefalen hun probleem en heb je het meteen goed in de context van hardwareproblemen.
Wij zijn een enigszins niet-standaard bedrijf. Hier praat iedereen over 'Kubernetes' en clouds - wij hebben geen 'Kubernetes' en geen clouds. Wat we wel hebben zijn racks met hardware in veel datacenters, en op deze hardware moeten we leven, we moeten alles hiervoor verantwoorden. Dus in deze context zullen we praten. Dus, over de problemen. De eerste twee hebben we terzijde gelaten.
Wijziging van softwareversie. Basisprincipes
Onze ontwikkelaars hebben geen toegang tot de productieomgeving. Waarom is dat zo? Gewoon omdat we gecertificeerd zijn volgens PCI DSS, en onze ontwikkelaars simpelweg niet in de 'prod' mogen komen. Punt. Helemaal. Daarom eindigt de verantwoordelijkheid van de ontwikkeling precies op het moment dat de ontwikkeling de build aan de release doorgeeft.
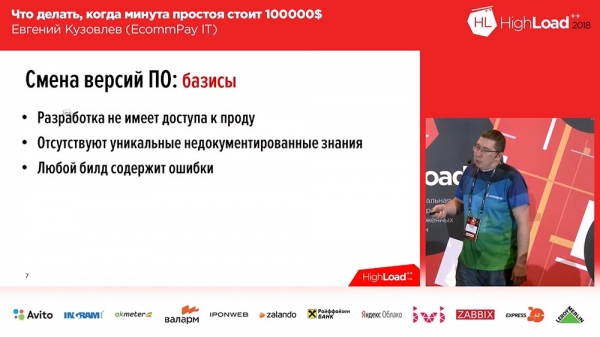
Onze tweede basis, die ook erg helpt, is dat er geen unieke, niet gedocumenteerde kennis is. Ik hoop dat dit ook voor jou geldt. Want als dat niet zo is, krijg je problemen. Problemen zullen ontstaan wanneer deze unieke, niet gedocumenteerde kennis niet op het juiste moment op de juiste plaats aanwezig is. Stel, je hebt één persoon die weet hoe je een specifiek component moet deployen - die persoon is er niet, hij is met verlof of ziek - en dan heb je problemen.
En de derde basis waar we naartoe zijn gekomen. We zijn er door pijn, bloed en tranen gekomen - we zijn tot de conclusie gekomen dat elke build van ons fouten bevat, zelfs als deze zonder fouten lijkt te zijn. We hebben voor onszelf besloten: wanneer we iets deployen, wanneer we iets in productie brengen - onze build heeft fouten. We hebben eisen geformuleerd waaraan ons systeem moet voldoen.
Vereisten voor het wijzigen van softwareversie
Deze vereisten zijn drie:
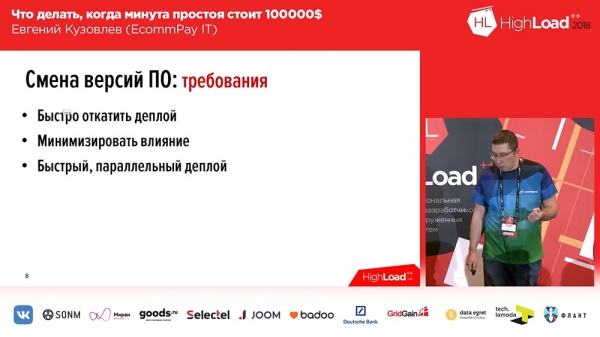
- We moeten de deployment snel kunnen terugdraaien.
- We moeten de impact van een mislukte deployment minimaliseren.
- En we moeten in staat zijn om snel parallel te deployen.
In die volgorde! Waarom? Omdat, in de eerste plaats, bij het deployen van een nieuwe versie de snelheid niet belangrijk is, maar het wel belangrijk is om snel terug te kunnen draaien als er iets misgaat en de impact minimaal te houden. Maar als je een reeks versies in productie hebt waarvan blijkt dat er een fout in zit (zoals een donderslag bij heldere hemel, er is geen deployment geweest, maar de fout is aanwezig) – dan is de snelheid van de volgende deployment van groot belang. Wat hebben we gedaan om aan deze eisen te voldoen? We hebben een dergelijke methodologie toegepast:
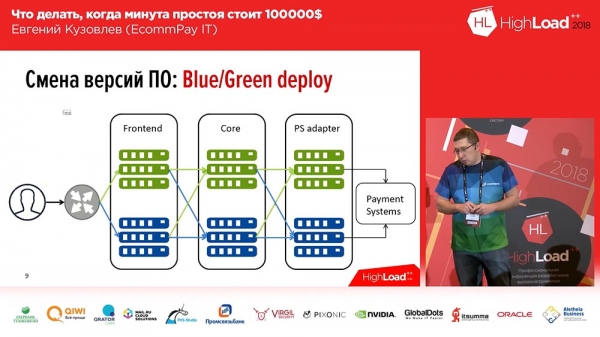
Het is vrij bekend, we hebben het niet uitgevonden – het is Blue/Green deploy. Wat is dat? Voor elke groep servers waarop jouw applicaties draaien, moet er een kopie zijn. Een 'warme' kopie: er is geen verkeer naar deze kopie, maar dit verkeer kan op elk moment naar deze kopie worden geleid. Deze kopie bevat de vorige versie. En op het moment van deployment voer je de code uit op de inactieve kopie. Daarna schakel je een deel van het verkeer (of het volledige verkeer) over naar de nieuwe versie. Om de stroom verkeer van de oude versie naar de nieuwe te veranderen, hoef je slechts één actie te ondernemen: je moet in de upstream de load balancer veranderen, de richting veranderen – van de ene upstream naar de andere. Dit is erg handig en lost het probleem van snelle schakeling en snelle terugdraaiing op.Hier is ook de oplossing voor de tweede vraag – minimalisatie: je kunt slechts een deel van je verkeer naar de nieuwe lijn, naar de lijn met de nieuwe code sturen (laat ons bijvoorbeeld zeggen 2%). En die 2% is niet 100%! Als je 100% van je verkeer verliest bij een mislukte deployment – dat is verschrikkelijk, als je 2% van je verkeer verliest – dat is onplezierig, maar niet rampzalig. Sterker nog, gebruikers zullen dit waarschijnlijk niet eens opmerken, omdat in sommige gevallen (niet alle) dezelfde gebruiker, door op F5 te drukken, naar een andere, werkende versie zal gaan.
Blue/Green deploy. Routing
Het is echter niet zo eenvoudig als 'Blue/Green deployen'... Al onze componenten kunnen in drie groepen worden verdeeld:
- dit is de frontend (betalingspagina's die onze klanten zien);
- de core processing;
- de adapter voor interactie met betalingssystemen (banken, 'MasterCard', 'Visa'...).
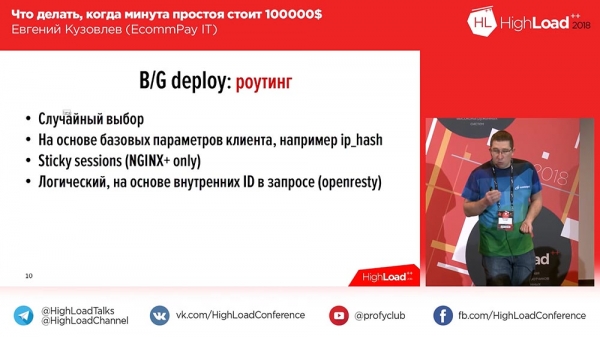
En hier is een nuance – de nuance heeft te maken met de routing tussen de lijnen. Als je gewoon 100% van het verkeer overschakelt, heb je deze problemen niet. Maar als je 2% wilt overschakelen, beginnen de vragen: "Hoe doe je dat?" Het eenvoudigste is direct: je kunt willekeurig kiezen, Round Robin in nginx instellen, en dan gaat 2% naar links, 98% naar rechts. Maar dat is niet altijd geschikt.
Bij ons bijvoorbeeld, interacteert de gebruiker niet met het systeem met slechts één aanvraag. Dat is normaal: 2, 3, 4, 5 aanvragen – jouw systemen kunnen ook zo zijn. En als het belangrijk voor je is dat alle aanvragen van de gebruiker naar dezelfde lijn komen als de eerste aanvraag, of (tweede punt) dat alle aanvragen van de gebruiker naar een nieuwe lijn gaan na de overschakeling (hij kan eerder met het systeem hebben gewerkt, vóór de overschakeling), dan is deze willekeurige verdeling niet geschikt voor jou. Dan zijn er de volgende opties:
De eerste optie, de eenvoudigste – op basis van de basisparameters van de cliënt (IP Hash). Je hebt een IP, en je verdeelt het naar rechts en links op basis van het IP-adres. Dan komt het tweede geval dat ik beschreef in werking, wanneer er een deployment is geweest, de gebruiker al met jouw systeem kon beginnen werken, en vanaf het moment van de deployment alle aanvragen naar de nieuwe lijn gaan (naar dezelfde, zeg maar).Als dit om een of andere reden niet geschikt voor je is en je moet verplicht de aanvragen naar de lijn sturen waar de initiële aanvraag van de gebruiker binnenkwam, dan heb je twee opties...
De eerste optie: je kunt de betaalde nginx+ nemen. Daar is een mechanisme voor Sticky sessions, dat bij de eerste aanvraag van de gebruiker een sessie instelt en deze aan de ene of andere upstream koppelt. Alle daaropvolgende aanvragen van de gebruiker binnen de levensduur van de sessie worden naar dezelfde upstream gestuurd waar de sessie was ingesteld.Dit werkte voor ons niet, omdat we al gewone nginx hadden. Overschakelen naar nginx+ was niet zozeer duur, maar het was voor ons een beetje pijnlijk en niet echt correct. "Sticky sessions" werkten voor ons bijvoorbeeld niet om de eenvoudige reden dat "Sticky sessions" geen routing mogelijk maken op basis van "Of-of". Je kunt instellen dat we "Sticky sessions" doen op basis van het IP-adres of het IP-adres en cookies of op basis van postparameters, maar "Of-of" is al moeilijker.
Daarom zijn we bij de vierde optie gekomen. We hebben nginx 'op steroïden' genomen (dit is openresty) – het is dezelfde nginx, maar met ondersteuning voor het insluiten van last scripts. Je kunt een last script schrijven, deze aan de 'openresty' geven, en dit last script zal worden uitgevoerd wanneer een verzoek van een gebruiker aankomt.
En we hebben eigenlijk zo'n script geschreven, we hebben 'openresty' geïnstalleerd en in dit script doorlopen we 6 verschillende parameters via een 'of'-conca- tenatie. Afhankelijk van de aanwezigheid van een bepaalde parameter weten we of de gebruiker op de ene pagina of de andere, op de ene lijn of de andere is aangekomen.
Blue/Green deploy. Voordelen en nadelen
Natuurlijk had het misschien iets eenvoudiger gekund (bijvoorbeeld door dezelfde 'Sticky sessions' te gebruiken), maar we hebben ook nog een nuance dat niet alleen de gebruiker met ons interactie heeft binnen de verwerking van één transactie... Maar dat ook betalingssystemen met ons interageren: nadat we de transactie hebben verwerkt (door een verzoek naar het betalingsysteem te sturen), ontvangen we een callback.
En stel je voor, als we binnen onze cirkel het IP-adres van de gebruiker in alle verzoeken kunnen doorgeven en op basis van de IP-adressen van de gebruikers kunnen segmenteren, dan gaan we niet tegen 'Visa' zeggen: 'Hé, wij zijn zo'n retrobedrijf, we lijken internationaal te zijn (op de site en in Rusland)... Maar geef ons alsjeblieft het IP-adres van de gebruiker ook door in een extra veld, jouw gestandaardiseerde protocol'! Het is duidelijk dat ze daar niet mee akkoord zullen gaan.
Daarom was dat voor ons niet bruikbaar – we hebben openresty gemaakt. Bij het routeren hebben we het dus zo gekregen:'Blue/Green deploy' heeft, zoals gezegd, zijn voordelen en nadelen.
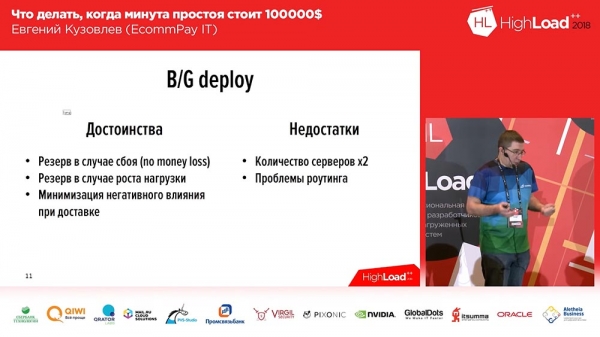
Er zijn twee nadelen:
- je moet je bezighouden met routering;
- het tweede grote nadeel – zijn de kosten.
Je hebt twee keer zoveel servers nodig, je hebt twee keer zoveel operationele middelen nodig, je moet twee keer zoveel moeite steken in het onderhouden van deze hele zoo.
Overigens, er is nog één voordeel waar ik eerder niet op inging: je hebt een reserve voor het geval de belasting toeneemt. Als je een explosieve groei in belasting ervaart, met een groot aantal gebruikers dat binnenkomt, dan activeer je eenvoudigweg een tweede lijn in een 50/50 verdeling – en je hebt meteen x2 servers in je cluster, totdat je het probleem van de servercapaciteit hebt opgelost.
Hoe maak je een snelle deployment?
We hebben besproken hoe we het probleem van minimalisering en snelle rollback kunnen aanpakken, maar de vraag blijft: 'Hoe kunnen we snel deployen'?
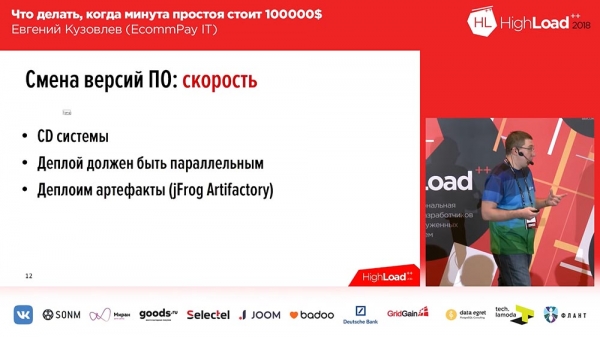
Hier is het kort samengevat en eenvoudig.- Je moet een CD-systeem (Continuous Delivery) hebben – zonder dat gaat het niet. Als je één server hebt, kun je handmatig deployen. Wij hebben ongeveer anderhalve duizend servers en handmatig deployen is een onmogelijkheid; we zouden een afdeling moeten hebben ter grootte van deze zaal alleen om te deployen.
- Deployment moet parallel zijn. Als je sequential deployments hebt, ben je in de problemen. Één server is prima, maar anderhalve duizend servers deployen zal de hele dag duren.
- Daarnaast, om te versnellen, is dit waarschijnlijk niet meer noodzakelijk. Bij het deployen wordt meestal het project gebouwd. Als je een webproject hebt, is er een frontend-gedeelte (je maakt web-pakketten en verzamelt met npm – iets in die geest) en dit proces duurt in principe niet lang – ongeveer 5 minuten, maar deze 5 minuten kunnen cruciaal zijn. Daarom doen wij bijvoorbeeld niet zo: we hebben die 5 minuten verwijderd, we deployen artefacten.
Wat is een artefact? Een artefact is een gebouw dat al volledig is gebouwd. Dit artefact wordt opgeslagen in een artefactopslag. In het verleden hebben we twee van zulke opslagplaatsen gebruikt – Nexus en nu jFrog Artifactory. We hebben aanvankelijk 'Nexus' gebruikt omdat we deze aanpak gingen toepassen in java-toepassingen (het was daarvoor goed geschikt). Daarna hebben we ook een deel van de applicaties die in PHP zijn geschreven daarin geplaatst; en 'Nexus' voldeed daar niet meer aan, dus hebben we jFrog Artifactory gekozen, dat vrijwel alles kan artefacten. We zijn zelfs zover gegaan dat we in deze artefactopslag onze eigen binaire pakketten opslaan die we voor servers bouwen.
Explosieve groei in belasting
We hebben gesproken over het veranderen van softwareversies. Het volgende waar we mee te maken hebben is explosieve groei in belasting. Hier begrijp ik waarschijnlijk onder explosieve groei in belasting iets dat niet helemaal correct is...
We hebben een nieuw systeem ontworpen – het is servicegericht, modern en mooi, met overal workers, overal queues en overal asynchroniciteit. In zulke systemen kunnen data door verschillende flows stromen. Voor de eerste transactie kunnen worker 1, 3 en 10 worden ingeschakeld, voor de tweede transactie worker 2, 4 en 5. En vandaag, stel je voor, in de ochtend loopt er een datastroom die de eerste drie workers gebruikt, maar 's avonds verandert dat abrupt, en dan worden er drie andere workers ingeschakeld.
Dus het lijkt erop dat je op de een of andere manier de workers moet schalen, je moet je services schalen, maar zonder dat de resources te veel opgeblazen worden.
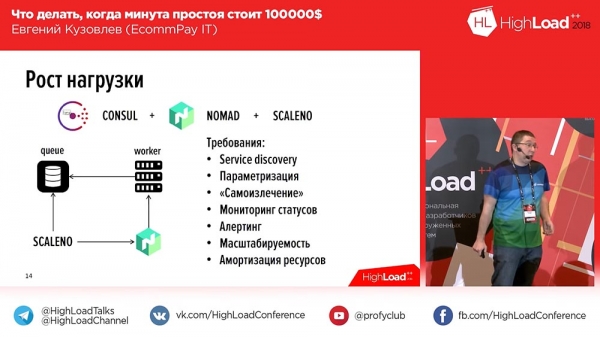
We hebben onze eisen bepaald. Deze eisen zijn vrij eenvoudig: er moet Service discovery zijn, parameterisatie – alles is standaard voor het bouwen van zulke schaalbare systemen, behalve één punt – dat is resource amortisatie. We hebben gezegd dat we niet bereid zijn om resources te amortiseren zodat servers de lucht verwarmen. We hebben 'Consul' genomen en 'Nomad' dat onze workers beheert.Waarom is dit een probleem voor ons? Laat me even teruggaan. We hebben momenteel ongeveer 70 betaalmethoden achter ons. In de ochtend gaat het verkeer via 'Sberbank', dan valt 'Sberbank' bijvoorbeeld uit en schakelen we over naar een andere betaalmethode. We hadden 100 workers die werkten tot 'Sberbank', en daarna moeten we plotseling 100 workers voor de andere betaalmethode opstarten. Dit alles moet bij voorkeur zonder menselijke tussenkomst gebeuren. Want als er menselijke tussenkomst is, moet er 24/7 een ingenieur zijn die alleen hiermee bezig is, want zulke storingen met 70 systemen achter je komen regelmatig voor.
Daarom hebben we 'Nomad' bekeken, dat een open IP heeft, en hebben we onze oplossing Scale-Nomad – ScaleNo – geschreven, die ongeveer het volgende doet: het houdt het aantal queues in de gaten en vermindert of vergroot het aantal workers afhankelijk van de dynamiek van de queue. Toen we het maakten, dachten we: 'Zou het niet leuk zijn om het open source te maken?' Daarna keken we ernaar – het is zo eenvoudig als twee cent.
Tot nu toe hebben we het nog niet open source gemaakt, maar als je na de presentatie, na het besef dat je zoiets nodig hebt, behoefte hebt aan deze oplossing, mijn contacten staan op de laatste dia – neem alsjeblieft contact met me op. Als er ten minste 3-5 mensen zijn die geïnteresseerd zijn, dan zullen we het open source maken.
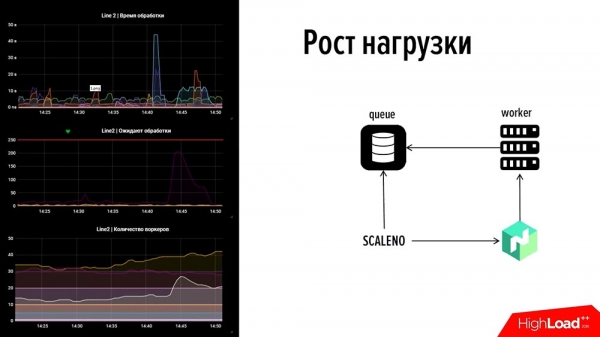
Hoe werkt het? Laten we kijken! Om een tipje van de sluier op te lichten: aan de linkerkant zien we een deel van onze monitoring: dat is één lijn, bovenaan – de verwerkingsduur van gebeurtenissen, in het midden – het aantal transacties, onderaan – het aantal workers.Als we kijken, zien we dat er een storing is op deze afbeelding. Op de bovenste grafiek is één van de grafieken uitgevallen na 45 seconden – één van de betalingssystemen is neergestort. Direct daarop zagen we de traffic in 2 minuten en de toename van de wachttijd bij een ander betalingsysteem, waar geen workers beschikbaar waren (we hebben de middelen niet benut – integendeel, we hebben de middelen op een correcte manier benut). We wilden niet opwarmen – er waren minimaal ongeveer 5-10 workers, maar ze konden het niet aan.
Op de laatste grafiek zien we een ‘bult’, die precies aangeeft dat ‘Skaleno’ dit aantal verdubbeld heeft. En daarna, toen de grafiek iets daalde, heeft hij het lichtjes verminderd – het aantal workers werd automatisch aangepast. Zo werkt dit systeem. We hebben het gehad over punt nummer 2 – ‘Hoe snel de oorzaken verhelpen’.
Monitoring. Hoe identificeer je snel een probleem?
Nu het eerste punt – ‘Hoe identificeer je snel een probleem?’ Monitoring! We moeten snel bepaalde zaken begrijpen. Welke zaken moeten we snel begrijpen?
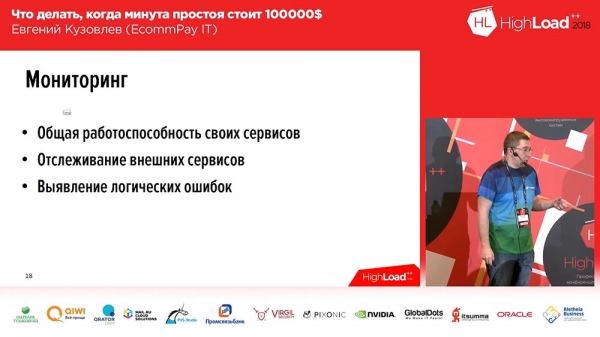
Drie dingen!- We moeten snel begrijpen en snel de functionaliteit van onze eigen middelen bevatten.
- We moeten snel in staat zijn te erkennen wanneer er iets uitvalt, de prestaties van systemen die extern voor ons zijn te monitoren.
- Derde punt – identificatie van logische fouten. Dit is wanneer het systeem voor jou werkt, en qua prestaties alles normaal is, maar er gebeurt iets ongewoons.
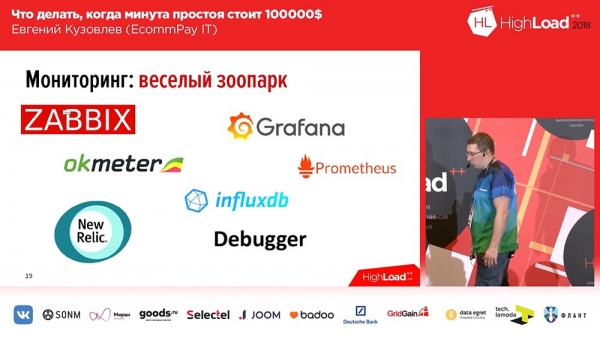
Hierover zal ik, denk ik, niet veel vernieuwends vertellen. Ik ben de kapitein van de Overduidelijkheid. We hebben gekeken naar wat er op de markt is. We hebben een ‘gezellig dierenpark’ gevormd. Dit is het dierenpark dat we nu hebben:
We gebruiken ‘Zabbix’ voor het monitoren van ‘hardware’, voor het monitoren van de belangrijkste serverparameters. ‘Okmeter’ gebruiken we voor databases. ‘Grafana’ en ‘Prometheus’ gebruiken we voor alle andere parameters die niet onder de eerste twee vallen, waarbij een deel – met ‘Grafana’ en ‘Prometheus’, en een deel – ‘Grafana’ met ‘Influx’ en Telegraf.Een jaar geleden wilden we New Relic gebruiken. Het is een geweldig ding, het kan alles. Maar hoe goed het ook is, het is ook duur. Toen we uitgroeiden tot 1.500 servers, kwam er een verkoper naar ons toe en zei: 'Laten we een contract voor het volgende jaar afsluiten.' We keken naar de prijs en zeiden: nee, dat gaan we niet doen. Op dit moment zeggen we vaarwel tegen New Relic; we hebben nog ongeveer 15 servers onder monitoring van New Relic.
Er is één tool die we zelf hebben geïmplementeerd – de Debugger. In het begin noemden we het 'Bagger', maar toen kwam onze Engelse leraar langs, lachte luid en we hernoemden het naar 'Debugger'. Wat is het? Het is een tool die in feite binnen 15-30 seconden op elk component, als een 'zwarte doos' van het systeem, tests uitvoert voor de algemene functionaliteit van het component.
Bijvoorbeeld, als het een externe pagina (betaalpagina) is, opent het deze gewoon en kijkt hoe deze eruit moet zien. Als het een verwerking betreft, voert het een testtransactie uit – zodat we kunnen zien of deze transactie doorgaat. Als het gaat om de verbinding met betaalsystemen, sturen we respectievelijk een testverzoek waar mogelijk en controleren we of alles goed gaat.
Welke indicatoren zijn belangrijk voor monitoring?
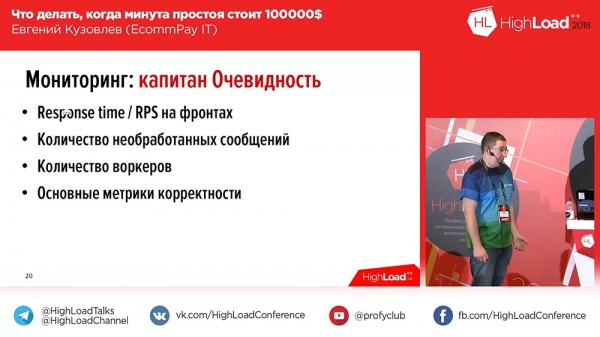
Wat monitoren we voornamelijk? Welke indicatoren zijn voor ons belangrijk?
- Response time / RPS aan de voorkanten – een zeer belangrijke indicator. Dit geeft onmiddellijk aan dat er iets niet goed is.
- Aantal verwerkte berichten in alle wachtrijen.
- Aantal workers.
- Hoofdmetriek van correctheid.
Het laatste punt – een 'business' metriek. Als je hetzelfde wilt monitoren, moet je één of twee metrics bepalen die voor jou de belangrijkste indicatoren zijn. Onze zo'n metriek is de doorvoer (de verhouding van het aantal succesvolle transacties tot de totale stroom van transacties). Als er iets verandert in de periode van 5-10-15 minuten – dan hebben we problemen (als het drastisch verandert).
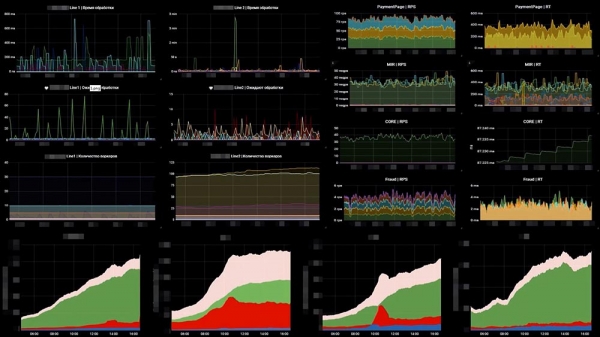
Hoe dit eruit ziet – een voorbeeld van een van onze dashboards:
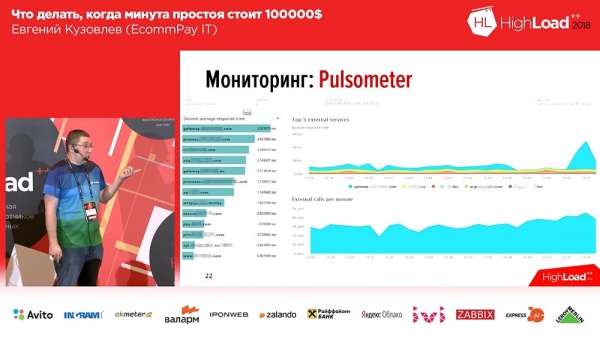
Aan de linkerkant staan 6 grafieken, die respectievelijk het aantal medewerkers en het aantal berichten in de wachtrijen weergeven. Aan de rechterkant bevinden zich RPS en RTS. Aan de onderkant staat de zakelijke metriek. En op de zakelijke metriek is direct zichtbaar dat er iets mis is gegaan met de twee middelste grafieken... Dit is precies het moment waarop weer een systeem dat achter ons staat, is uitgevallen.Het tweede dat we moesten doen, was letten op het uitvallen van externe betalingssystemen. Hier hebben we OpenTracing genomen - een mechanisme, een standaard, een paradigma dat het mogelijk maakt om gedistribueerde systemen te traceren; en dat hebben we een beetje aangepast. De standaard OpenTracing-paradigma zegt dat we de tracing van elke individuele aanvraag opbouwen. Dat hadden we niet nodig, en dus hebben we dit omgevormd naar een totale, aggregatieve tracing. We hebben een instrument gemaakt dat ons in staat stelt om de snelheid van de systemen achter ons te volgen.
De grafiek laat ons zien dat een van de betalingssystemen na 3 seconden begon te reageren - we ondervonden problemen. Tegelijkertijd reageert dit systeem wanneer er problemen ontstaan, binnen een interval van 20-30 seconden.En de derde klasse van monitoringfouten die er zijn, betreft logische monitoring.
Eerlijk gezegd wist ik niet wat ik op deze dia moest tekenen, omdat we lang op de markt hebben gezocht naar iets dat geschikt voor ons zou zijn. We hebben niets gevonden, dus moesten we het zelf doen.
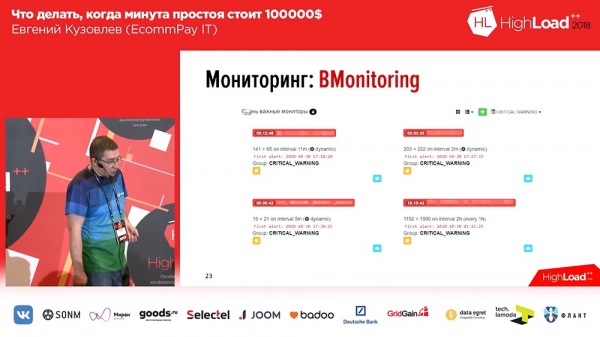
Wat bedoel ik met logische monitoring? Stel je voor: je maakt een systeem voor jezelf (bijvoorbeeld een klon van Tinder); je hebt het gemaakt, gelanceerd. Succesvolle manager Vasja Poepkin heeft het op zijn telefoon gezet, ziet daar een meisje, liket haar... maar de like gaat niet naar het meisje - de like gaat naar de beveiliger Michalych van hetzelfde kantoorpand. De manager gaat naar beneden, en dan vraagt hij zich af: 'Waarom glimlacht die beveiliger Michalych zo vriendelijk naar hem?'In dergelijke situaties... Voor ons klinkt deze situatie een beetje anders, omdat (ik heb geschreven) het een reputatieverlies is dat indirect leidt tot financiële verliezen. Onze situatie is omgekeerd: wij kunnen directe financiële verliezen lijden – bijvoorbeeld als we een transactie als succesvol hebben uitgevoerd, terwijl deze niet succesvol was (of omgekeerd). We moesten een eigen instrument schrijven dat het aantal succesvolle transacties in de tijd bijhoudt aan de hand van bedrijfsprestaties. We hebben niks op de markt gevonden! Dit was de boodschap die ik wilde overbrengen. Voor dit soort taken is er niets op de markt.
Dit was een antwoord op de vraag hoe we snel een probleem kunnen identificeren.
Hoe de oorzaken van een deployment te bepalen
De derde groep taken die we oplossen – is, nadat we het probleem hebben geïdentificeerd en verholpen, goed te begrijpen wat de oorzaak is voor ontwikkeling, voor testen en daar iets mee te doen. Daarom moeten we onderzoeken, moeten we de logs ophalen.
Als we het over logs hebben (de belangrijkste oorzaak – logs), dan ligt het merendeel van onze logs in de ELK Stack – praktisch iedereen heeft dat. Bij sommigen misschien niet in ELK, maar als je logs in gigabytes schrijft, kom je vroeg of laat bij ELK. Wij schrijven ze in terabytes.
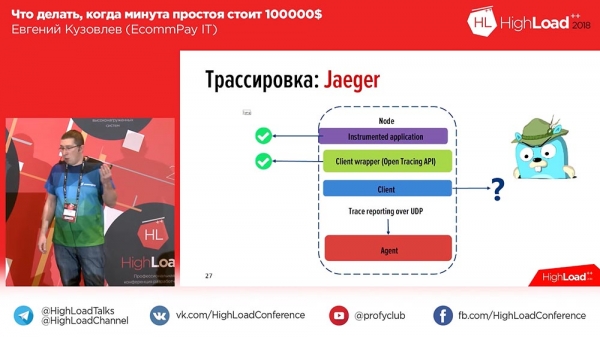
Hier is een probleem. We hebben de fout voor de gebruiker hersteld, zijn gaan graven wat er aan de hand was, zijn 'Kibana' ingegaan, hebben daar het id van de transactie ingevoerd en kregen zo'n lange lijst (toont veel). En in deze lijst is helemaal niets duidelijk. Waarom? Omdat het onduidelijk is welke delen bij welke worker horen, welke delen bij welk component horen. En op dat moment begrepen we dat we tracing nodig hadden – de OpenTracing waar ik het eerder over had.We dachten hier een jaar geleden aan, keken naar de markt, en daar bleken twee tools te zijn – Zipkin en Jaeger. Jaeger is eigenlijk de ideologische opvolger van Zipkin. Bij Zipkin is alles goed, behalve dat het niet kan aggregeren, niet kan opnemen in de tracing logs, alleen de tijdtracering. Maar Jaeger ondersteunt dat.
We looked at 'Eger': it's possible to instrument applications, and you can write to the API (the API standard for PHP at that time, however, wasn't approved – that was a year ago, and it has now been approved), but there was absolutely no client. 'Okay,' we thought, and we wrote our own client. What did we end up with? This is roughly how it looks:
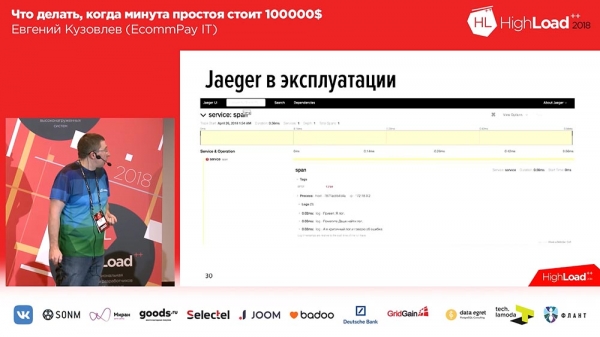
In 'Eger,' span elements are created for each message. This means that when a user opens the system, they see one or two blocks for each incoming request (1-2-3 – as many incoming requests from the user there were, that many blocks). To make it easier for users, we added tags to the logs and the time trace. Accordingly, in case of an error, our application will label the log with the corresponding Error tag. You can filter by the Error tag, and only the spans containing that error block will be displayed. This is what it looks like when we expand the span:
Inside the span, there's a set of traces. In this case, there are three test traces, and the third trace informs us that an error occurred. At the same time, we also see the time trace: at the top, there's a timeline, and we can see the time interval during which this log was recorded.Thus, we had a great experience. We wrote our own extension, and we open-sourced it. If you want to work with tracing, if you want to work with 'Eger' in PHP - our extension is available, welcome to use it, as they say:
Our extension is a client for working with the OpenTracing API, created as a PHP extension, meaning you will need to compile it and integrate it into the system. A year ago, there was nothing else. Now there are other clients available as components. It's up to you: either you can pull components via Composer, or you can use the extension.Corporate Standards
We talked about three commandments. The fourth commandment is to standardize approaches. What does this mean? It's about this:
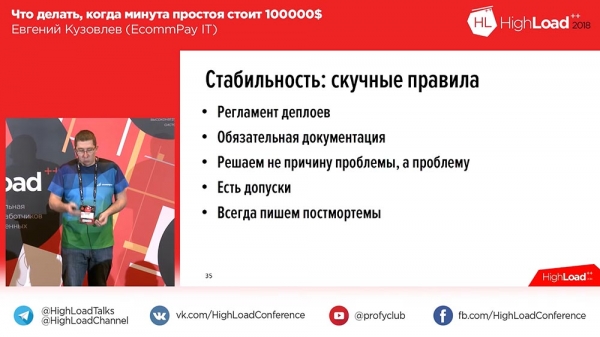
Why the word 'corporate' here? Not because we are a large or bureaucratic company, no! I wanted to use the word 'corporate' in the context that each company, each product should have its own standards, and you should have yours too. What standards do we have?- Wij hebben een uitrolreglement. Zonder dat kunnen we niet verder, we kunnen niet. We rollen ongeveer 60 keer per week uit, wat betekent dat we praktisch voortdurend uitrollen. In dit reglement hebben we bijvoorbeeld een verbod op uitrol op vrijdag – in principe rollen we niet uit.
- Wij vereisen documentatie. Geen enkele nieuwe component komt in productie zonder documentatie, zelfs als het door onze RnD-teams is ontwikkeld. We eisen van hen een uitrolinstructie, een monitoringkaart en een beschrijving (ja, zoals programmeurs dat kunnen schrijven) van hoe deze component werkt en hoe je deze moet troubleshooten.
- Wij lossen niet de oorzaak van een probleem op, maar het probleem zelf – waar ik het al eerder over had. Voor ons is het belangrijk om de gebruiker te beschermen tegen problemen.
- Wij hebben toleranties. Bijvoorbeeld, we beschouwen het niet als downtime als we gedurende twee minuten 2% van het verkeer verliezen. Dit valt in principe niet in onze statistieken. Als het percentage of de tijd langer is, dan beschouwen we het wel.
- En we schrijven altijd post-mortems. Wat er ook gebeurt, elke situatie waarbij er iets ongewoons gebeurt in de productie zal worden vastgelegd in de post-mortem. Een post-mortem is een document waarin je beschrijft wat er is gebeurd, een gedetailleerde timing, wat je hebt gedaan om het op te lossen en (dit is een verplichte sectie!) wat je gaat doen om dit in de toekomst te voorkomen. Dit is verplicht, noodzakelijk voor latere analyse.
Wat beschouwen we als downtime?
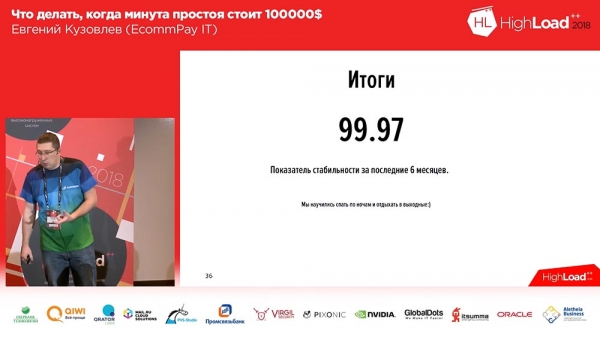
Waar leidde dit allemaal toe?Dit leidde ertoe dat (we hadden bepaalde problemen met stabiliteit, wat zowel onze klanten als ons niet beviel) onze stabiliteitsratio de afgelopen 6 maanden 99,97 was. Je kunt zeggen dat dit niet heel veel is. Ja, we hebben nog veel te verbeteren. Ongeveer de helft van deze graad is stabiliteit die eigenlijk niet van ons is, maar van onze web application firewall die voor ons staat en als dienst wordt gebruikt, maar dat maakt onze klanten niet uit.
We hebben geleerd om 's nachts te slapen. Eindelijk! Zes maanden geleden konden we dat niet. En over deze resultaten wil ik een opmerking maken. Gisteravond was er een geweldige presentatie over een systeem voor het beheer van een kernreactor. Als er mensen zijn die dat systeem hebben geschreven – vergeet alsjeblieft wat ik zei over "2% – dat is geen downtime". Voor jullie is 2% downtime, zelfs als het maar voor twee minuten is!
Dat is alles! Jullie vragen.
Over load balancers en database migratie
Vraag uit het publiek (hierna - V): – Goede avond. Hartelijk dank voor deze administratieve presentatie! Een korte vraag over jullie load balancers. Jullie vermeldden dat jullie een WAF hebben, dus, als ik het goed begrijp, gebruiken jullie een externe…
EK: – Nee, als load balancer gebruiken we onze eigen diensten. In dit geval is de WAF voor ons uitsluitend een middel ter bescherming tegen DDoS.
V: – Mag ik een paar woorden over load balancers?
EK: – Zoals ik al zei, dit is een groep servers in openresty. We hebben momenteel 5 groepen gereserveerd die uitsluitend… dat wil zeggen, de server die uitsluitend openresty heeft, die proxy't alleen het verkeer. Dus, ter verduidelijking, hoeveel we aankunnen: we hebben momenteel een reguliere verkeersstroom van enkele honderden megabits. Ze doen dat goed, zonder enige moeite.
V: – Ook een simpele vraag. Er is Blue/Green deployment. Maar wat doen jullie bijvoorbeeld met database migraties?
EK: – Goede vraag! Kijk, we hebben in Blue/Green deployment aparte wachtrijen voor elke lijn. Dus als we het hebben over gebeurteniswachtrijen die van de ene worker naar de andere worden verzonden, zijn er aparte wachtrijen voor de blauwe lijn en de groene lijn. Wat betreft de database zelf, hebben we die opzettelijk beperkt, zoveel mogelijk alles in wachtrijen gelegd; in de database houden we alleen de transactie stack. En de transactie stack is uniek voor alle lijnen. Wat betreft de database in deze context: we splitsen die niet in blue en green, omdat beide versie van de code moeten weten wat er met de transactie gebeurt.
Vrienden, ik heb nog een kleine prijs om jullie aan te moedigen – een boek. En ik moet het geven voor de beste vraag.
V: – Hallo. Dank voor de presentatie. De vraag is als volgt. Jullie monitoren betalingen, jullie monitoren diensten waarmee jullie communiceren... Maar hoe monitoren jullie dat iemand op de een of andere manier op jullie betaalpagina is gekomen, de betaling heeft gedaan, en het project hem het geld heeft bijgeschreven? Dus hoe monitoren jullie dat de merchant beschikbaar is en jullie callback heeft geaccepteerd?
EK: – De ‘merchant’ is voor ons in dit geval precies zo'n externe dienst als het betalingssysteem. We monitoren de reactietijd van de ‘merchant’.
Over de encryptie van de database
V: – Hallo. Ik heb een kleine vraag. Hebben jullie gevoelige gegevens volgens PCI DSS? Ik wilde weten hoe jullie PAN's in de wachtrijen opslaan, die jullie moeten doorgeven? Gebruik je enige vorm van encryptie? En hierbij komt de tweede vraag: volgens PCI DSS is het nodig om de database periodiek opnieuw te versleutelen in geval van wijzigingen (bijvoorbeeld bij het ontslag van beheerders) – hoe gaat dit dan met de beschikbaarheid?
EK: – Geweldige vraag! Ten eerste, we slaan geen PAN's op in wachtrijen. We hebben in principe geen recht om PAN's ergens in platte tekst op te slaan, daarom gebruiken we een speciale service (we noemen het ‘KeyDemon’) – dit is een service die slechts één ding doet: het neemt een bericht als invoer en geeft een versleuteld bericht terug. En we slaan alles op als dat versleutelde bericht. De sleutelgrootte is ongeveer een kilobyte, zodat het serieus en betrouwbaar is.V: – Hebben we nu al 2 kilobytes nodig?
EK: – Het leek nog gisteren 256 te zijn... Hoe meer kan het worden?!
Dit is dus het eerste. Ten tweede, de oplossing die we hebben ondersteunt de procedure voor opnieuw versleutelen – het heeft twee paren van 'KEK's' (sleutels), die de 'DEK's' genereren die versleutelen (key is de sleutel, dek zijn de afgeleiden sleutelvarianten die versleutelen). En bij het initiëren van de procedure (dit gebeurt regelmatig, om de 3 maanden of zo) laden we een nieuw paar 'KEK's' en vindt er een herversleuteling van de gegevens plaats. We hebben aparte services die alle gegevens ophalen en opnieuw versleutelen; bij die gegevens wordt een sleutelidentificator opgeslagen waarmee ze zijn versleuteld. Zodra we de gegevens met nieuwe sleutels hebben versleuteld, verwijderen we de oude sleutels.
Soms moeten betalingen handmatig worden uitgevoerd...
V: – Dus als er een terugbetaling is voor een bepaalde transactie, worden die dan nog met de oude sleutel ontsleuteld?
EK: – Ja.
V: – Dan nog een kleine vraag. Wanneer er een storing, uitval, of incident optreedt, moet de transactie handmatig worden doorgestuurd. Soms gebeurt dit.
EK: – Ja, dat gebeurt.
V: – Waar halen jullie die gegevens vandaan? Of ga je zelf handmatig naar die opslagruimte?
EK: – Nee, dat is duidelijk – we hebben een soort backoffice-systeem dat een interface voor onze support biedt. Als we niet zeker weten in welke status de transactie zich bevindt (bijvoorbeeld totdat het betalingssysteem niet meer reageert), weten we dat vooraf niet, dat wil zeggen dat we de definitieve status pas toekennen bij volledige zekerheid. In dit geval plaatsen we de transactie in een speciale status voor handmatige verwerking. De volgende ochtend, zodra de support informatie krijgt dat er dergelijke transacties in het betalingssysteem zijn, verwerken ze deze handmatig in deze interface.
V: – Ik heb een paar vragen. Een daarvan is de voortzetting van de PCI DSS-zone: hoe exporteren jullie de logs ervan? Deze vraag komt omdat de ontwikkelaar allerlei gegevens in de logs kan hebben geplaatst! De tweede vraag is: hoe voeren jullie hotfixes uit? Handmatig in de database is één optie, maar er kunnen ook gratis hotfixes zijn – wat is de procedure daarvoor? En de derde vraag is waarschijnlijk gerelateerd aan RTO en RPO. Jullie hadden een beschikbaarheid van 99,97, bijna vier negens, maar ik begrijp dat jullie ook een tweede datacenter, een derde datacenter en een vijfde datacenter hebben... Hoe synchroniseren en repliceren jullie die?EK: – Laten we beginnen met de eerste. De eerste vraag was over de logs? Wanneer wij logs schrijven, is er een laag die alle gevoelige gegevens maskeert. Deze laag kijkt naar de maskering en aanvullende velden. Dienovereenkomstig zijn onze logs al gemaskeerd en voldoen ze aan de PCI DSS-contouren. Dit is een van de reguliere taken die aan de testafdeling zijn toegewezen. Ze zijn verplicht om elke taak, inclusief de logs die ze schrijven, te controleren, en dit is een van de reguliere taken tijdens code-reviews, om te controleren of de ontwikkelaar niets ongepast heeft geregistreerd. De vervolgcontrole daarop wordt regelmatig door de afdeling informatiebeveiliging uitgevoerd, ongeveer eens per week: er worden willekeurig logs van de laatste dag geselecteerd en deze worden door een speciale scanner-analyzer op testservers geleid om dit alles te controleren.
Over hot-fixes. This is included in our deployment regulations. We have a separate point about hot-fixes. We believe that we deploy hot-fixes around the clock whenever we need to. As soon as the version is built, as soon as it is tested, as soon as we have the artifact – a duty system administrator is called up from support, and he deploys it at the moment it is necessary.About the 'four nines'. The number we have now has truly been achieved, and we aimed for it in another data center. Now we have a second data center, and we are starting to route between them, and the issue of cross-data center replication is indeed a non-trivial matter. We tried to solve it in various ways: we attempted to use 'Taranto' – it didn't work out, I’ll be honest. Therefore, we decided to manually order 'Sensa'. Each application in fact operates in an 'asynchronous mode' needed for synchronization 'change – done' between data centers.
V: – If you have a second one, then why isn’t there a third? Because Split-brain hasn’t been addressed by anyone yet…
EK: – We don’t have a 'Split-brain'. Since each application uses multi-master, we don’t care which center the request came to. We are prepared for the scenario where, if one data center fails (we account for this), and in the middle of the user's request we switch to the second data center, we are ready to lose that user, indeed; but it will be just a few, absolute few.
V: – Good evening. Thank you for the presentation. You mentioned your debugger that runs some test transactions in production. Now tell us about the test transactions! How deep does it go?
EK: – It goes through the full cycle of the entire component. For the component, there is no difference between a test transaction and a real one. From a logical standpoint, it is just a separate project in the system where only test transactions are run.
V: – And where do you cut it off? Core has sent it...
EK: – We are behind 'Core' in this case for test transactions… We have a concept called routing: 'Core' knows which payment system to send it to – we send it to a fake payment system, which simply gives an http response and that’s all.
V: – Kunt u me alstublieft vertellen of uw applicatie als één grote monolith is geschreven, of heeft u het opgesplitst in verschillende services of zelfs microservices?
EK: – Wij hebben geen monolith, natuurlijk, we hebben een service-georiënteerde applicatie. We hebben een grap dat wij een service uit monolithen hebben – ze zijn eigenlijk behoorlijk groot. Je kunt dit echt niet microservices noemen, maar het zijn wel degelijk services, waarin workers van verspreide machines werken.
Als de service op de server gecompromitteerd is...
V: – Dan heb ik de volgende vraag. Zelfs als het een monolith zou zijn, heeft u toch gezegd dat u veel van deze instant-servers heeft, die allemaal in principe gegevens verwerken, en mijn vraag is: ‘In het geval van compromittering van één van de instant-servers of de applicatie, van een apart onderdeel, hebben zij enige toegangscontrole? Wie kan wat doen? Bij wie kan men terecht voor welke gegevens?’
EK: – Ja, absoluut. De beveiligseisen zijn behoorlijk streng. Ten eerste hebben we open datastromen, en alleen de poorten waarvan we van tevoren verwachten dat er verkeer doorheen gaat. Als een component communiceert met de database (laten we zeggen met 'MySQL') via 5-4-3-2, dan worden alleen die poorten 5-4-3-2 geopend, en andere poorten, andere verkeersstromen zijn niet beschikbaar. Daarnaast moet men begrijpen dat we in productie ongeveer 10 verschillende beveiligingscontouren hebben. En zelfs als de applicatie op de een of andere manier gecompromitteerd zou zijn, god verhoede, dan kan de aanvaller geen toegang krijgen tot de serverbeheersconsole, omdat dit een andere netwerkzone van veiligheid is.V: – Wat mij in deze context meer interesseert, is het punt dat u enkele contracten heeft met services – wat ze kunnen doen, via welke ‘acties’ ze elkaar kunnen benaderen... En in een normale flow vragen bepaalde services een reeks ‘acties’ aan de andere. Zij benaderen de anderen doorgaans niet in normale situaties, en zij hebben andere verantwoordelijkheidszones. Als een van hen echter gecompromitteerd wordt, kan deze dan de ‘acties’ van die service aanroepen?
EK: – Ik begrijp het. Als de communicatie met een andere server normaal gesproken is toegestaan, dan – ja. Volgens het SLA-contract monitoren we niet dat je alleen de eerste 3 "acties" zijn toegestaan, terwijl de 4e "actie" niet is toegestaan. Dat is voor ons waarschijnlijk overbodig, omdat we al een 4-laags beveiligingssysteem hebben voor de netwerken. We geven de voorkeur aan bescherming op netwerkniveau in plaats van op het interne niveau.
Hoe Visa, MasterCard en 'Sberbank' werken
V: – Ik wil een punt verduidelijken over de wijziging van de gebruiker van het ene datacentrum naar het andere. Voor zover ik weet, werken "Visa" en "MasterCard" met het binaire synchrone protocol 8583, waar mixen staan. En ik wilde vragen, betekent de schakeling nu – is dit direct tussen "Visa" en "MasterCard" of tot aan de betaalsystemen, tot aan de verwerking?
EK: – Dat is tot de mixen. De mixen zijn in één datacentrum geplaatst.
V: – Grof gezegd, hebben jullie één aansluitpunt?
EK: – Voor "Visa" en "MasterCard" – ja. Gewoon omdat "Visa" en "MasterCard" aanzienlijke investeringen in infrastructuur vereisen om aparte contracten aan te gaan voor het verkrijgen van een tweede set mixen, bijvoorbeeld. Ze zijn gereserveerd binnen één datacentrum, maar als ons datacentrum, God verhoede, kapot gaat, waar de mixen voor de verbinding met "Visa" en "MasterCard" staan, dan zullen we het contact met "Visa" en "MasterCard" verliezen …
V: – Hoe kunnen ze gereserveerd zijn? Ik weet dat "Visa" in principe maar één verbinding toestaat!
EK: – Ze leveren zelf de apparatuur. In ieder geval hebben we apparatuur ontvangen die intern dubbel is gereserveerd.
V: – Dus de rekken van hun Connects Orange?..
EK: – Ja.
V: – Hoe zit het in dit geval: als jullie datacentrum uitvalt, hoe gebruik je dan verder? Of stopt het verkeer simpelweg?
EK: – Nee. In dat geval zullen we het verkeer gewoon omleiden naar een ander kanaal, dat uiteraard duurder voor ons zal zijn, en duurder voor klanten. Maar het verkeer zal niet lopen via onze directe verbinding met "Visa", "MasterCard", maar via de zogenaamde "Sberbank" (heel overdreven gezegd).
Ik bied mijn oprechte excuses aan als ik personeel van "Sberbank" heb gekwetst. Maar volgens onze statistieken valt "Sberbank" het vaakst uit van de Russische banken. Er gaat geen maand voorbij zonder dat er iets bij "Sberbank" hapert.

Een beetje reclame 🙂
Bedankt dat je bij ons blijft. Houd je van onze artikelen? Wil je meer interessante inhoud zien? Ondersteun ons door een bestelling te plaatsen of ons aan vrienden aan te bevelen, , een unieke variant van entry-level servers, die we voor jou hebben bedacht: (opties beschikbaar met RAID1 en RAID10, tot 24 cores en tot 40GB DDR4).
Dell R730xd is 2 keer goedkoper in datacenter Equinix Tier IV in Amsterdam? Alleen bij ons in Nederland! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — vanaf $99! Lees over hoe
Bron: habr.com
