

De volgende HighLoad++ conferentie vindt plaats op 6 en 7 april 2020 in Sint-Petersburg. Details en Tickets . HighLoad++ Moskou 2018. Zaal 'Moskou'. 9 november, 15:00. Samenvattingen en .
* Monitoring - online en analytics.
* Belangrijkste beperkingen van het ZABBIX-platform.
* Oplossing voor het schalen van analytics opslag.
* Optimalisatie van de ZABBIX-server.
* Optimalisatie van de UI.
* Ervaring met het gebruik van het systeem bij belastingen van meer dan 40k NVPS.
* Kort de conclusies.
Mikhail Makurov (hierna - MM): - Hallo allemaal!
Maxim Chernetcov (hierna - MC): - Goedendag!
MM: - Laat me Maxim voorstellen. Max is een getalenteerde ingenieur, de beste netwerkspecialist die ik ken. Maxim houdt zich bezig met netwerken en diensten, hun ontwikkeling en exploitatie.
MC: - En ik wil graag over Mikhail vertellen. Mikhail is een C-ontwikkelaar. Hij heeft verschillende krachtige oplossingen voor verkeerverwerking voor ons bedrijf geschreven. Wij wonen en werken in de Oeral, in de stad van de stevige mannen, Tsjeljabinsk, in het bedrijf 'Intersvyaz'. Ons bedrijf is een internet- en kabeltelevisieaanbieder voor een miljoen mensen in 16 steden.
MM: - En het moet gezegd worden dat 'Intersvyaz' veel meer is dan alleen een provider. Dit is een IT-bedrijf. De meeste van onze oplossingen zijn gemaakt door onze IT-afdeling.
A: van servers die verkeer verwerken, tot het callcenter en de mobiele applicatie. De IT-afdeling heeft momenteel ongeveer 80 mensen met zeer diverse competenties.
Over Zabbix en zijn architectuur
MC: - En nu zal ik proberen mijn persoonlijke record te vestigen en in één minuut uit te leggen wat Zabbix (hierna - 'Zabbix') is.
'Zabbix' positioneert zichzelf als een enterprise-montitoringsysteem 'out of the box'. Het heeft veel functies die het leven vereenvoudigen: geavanceerde escalatieregels, API voor integratie, groepering en autodetectie van hosts en metrische waarden. In 'Zabbix' zijn er zogenaamde schaalmiddelen - proxy's. 'Zabbix' is een open-source systeem.
Kort over de architectuur. Je kunt zeggen dat het bestaat uit drie componenten:
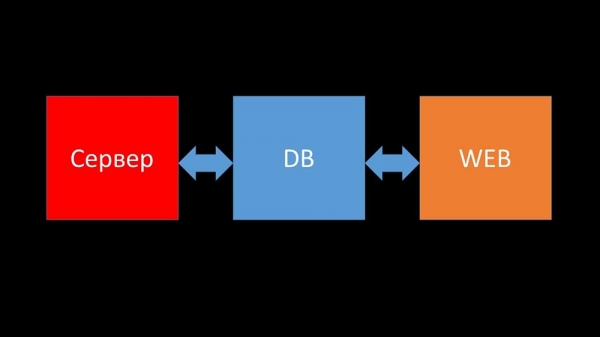
- Server. Geschreven in C. Met een vrij complexe verwerking en overdracht van informatie tussen threads. Alle verwerking gebeurt daarin: van ontvangst tot opslag in de database.
- Alle gegevens worden in de database opgeslagen. 'Zabbix' ondersteunt MySQL, PostgreSQL en Oracle.
- De webinterface is geschreven in PHP. In de meeste systemen wordt het geleverd met de Apache-server, maar het werkt effectiever in combinatie met nginx + php.
Vandaag willen we een verhaal uit het leven van ons bedrijf delen dat verband houdt met 'Zabbix'...
Een verhaal uit het leven van het bedrijf 'Intersvyaz'. Wat hebben we en wat hebben we nodig?
Vijf of zes maanden geleden. Op een dag na het werk...
MC: – Misha, hallo! Fijn dat ik je te pakken krijg – ik heb iets te bespreken. We hadden opnieuw problemen met de monitoring. Tijdens een grote storing vertraagde alles en er was geen informatie over de staat van het netwerk. Helaas gebeurt dit al voor de tweede keer. Ik heb je hulp nodig. Laten we ervoor zorgen dat onze monitoring onder alle omstandigheden werkt!
MM: – Maar laten we eerst synchroniseren. Ik heb er al een paar jaar niet naar gekeken. Voor zover ik me herinner, hebben we Nagios afgewezen en zijn we ongeveer 8 jaar geleden overgestapt naar 'Zabbix'. En nu hebben we, denk ik, 6 krachtige servers en een tiental proxy's. Klopt dat?
MC: – Bijna. We hebben 15 servers, waarvan een deel virtuele machines zijn. Het belangrijkste is dat dit ons niet helpt op het moment dat we het het meest nodig hebben. Zodra er een storing is, vertragen de servers en is er niks zichtbaar. We hebben geprobeerd de configuratie te optimaliseren, maar dat levert niet de gewenste prestatieverbetering op.
MM: – Begrijpelijk. Hebben jullie al iets onderzocht, wat hebben jullie al gevonden tijdens de diagnose?
MC: – Het eerste waar we mee te maken hebben, is de database. MySQL is al constant belast door het opslaan van nieuwe metrics, en wanneer 'Zabbix' begint met het genereren van veel gebeurtenissen, gaat de database letterlijk op slot voor een paar uur. Ik heb je al verteld over de optimalisatie van de configuratie, en dit jaar hebben we ook de hardware vernieuwd: de servers hebben meer dan honderd gigabyte geheugen en schijfsystemen op SSD RAID's – het heeft geen zin om het verder lineair uit te breiden. Wat gaan we doen?
MM: – Begrijpelijk. Over het algemeen is MySQL een LTP-database. Blijkbaar is deze niet meer geschikt voor het opslaan van archieven van metrics van onze omvang. Laten we het uitzoeken.
MC: – Laten we dat doen!
Integratie van Zabbix en Clickhouse als resultaat van de hackathon
Na een tijdje hebben we interessante gegevens ontvangen:
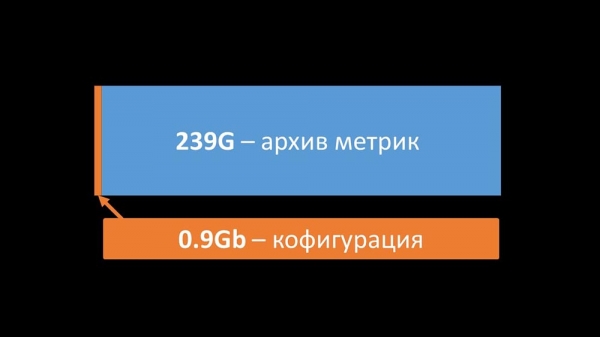
Het grootste deel van de ruimte in onze database was in gebruik door de archieven van metrics en minder dan 1% werd gebruikt voor configuraties, sjablonen en instellingen. Op dat moment hadden we al meer dan een jaar een Big Data-oplossing gebaseerd op Clickhouse in gebruik. De richting die we op moesten, was voor ons duidelijk. Tijdens onze lent Hackathon heb ik een integratie van Zabbix met Clickhouse geschreven voor de server en de frontend. Op dat moment ondersteunde Zabbix al ElasticSearch, en we besloten om ze te vergelijken.
Vergelijking van Clickhouse en Elasticsearch
MM: – Voor de vergelijking genereerden we een belasting die gelijk was aan die van de Zabbix-server en keken we hoe de systemen zich zouden gedragen. We schreven gegevens in batches van 1000 regels, gebruikten CURL. We verwachtten vooraf dat Clickhouse effectiever zou zijn voor het belastingprofiel dat Zabbix genereert. De resultaten overtroffen zelfs onze verwachtingen:
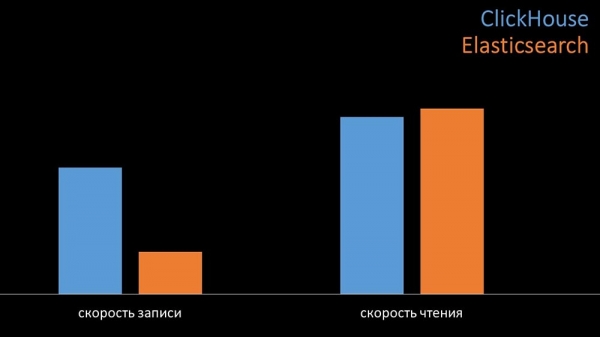
Onder gelijke voorwaarden schreef Clickhouse drie keer zoveel gegevens tijdens de tests. Beide systemen verbruikten echter zeer efficiënt (weinig bronnen) bij het lezen van gegevens. Maar ElasticSearch had een groot aantal CPU-cycli nodig bij het schrijven:
In totaal overtrof Clickhouse ElasticSearch aanzienlijk in CPU-verbruik en snelheid. Dankzij de gegevenscompressie gebruikt Clickhouse 11 keer minder schijfruimte en onderneemt ongeveer 30 keer minder schijfoperaties:
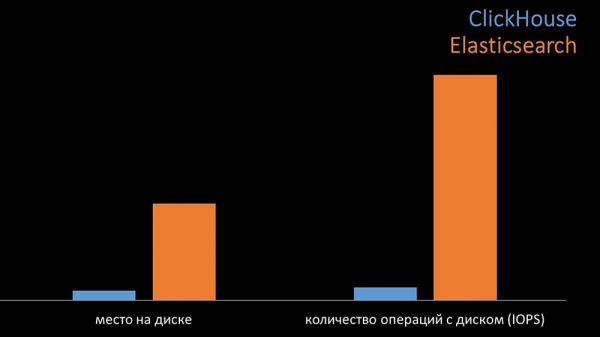
MC: – Ja, de schijfsysteemwerking van Clickhouse is zeer efficiënt gerealiseerd. Voor databases kunnen enorme SATA-schijven worden gebruikt, waardoor schrijfsnelheden van honderdduizenden regels per seconde mogelijk zijn. Het systeem ondersteunt 'out of the box' sharding en replicatie en is zeer eenvoudig in te stellen. We zijn meer dan tevreden over de exploitatie gedurende een jaar.
Om resources te optimaliseren kan Clickhouse naast de bestaande hoofd database worden geïnstalleerd, waardoor een enorme hoeveelheid CPU-tijd en schijfoperaties kan worden bespaard. We hebben het archief van metrics naar de reeds bestaande Clickhouse-clusters verplaatst:
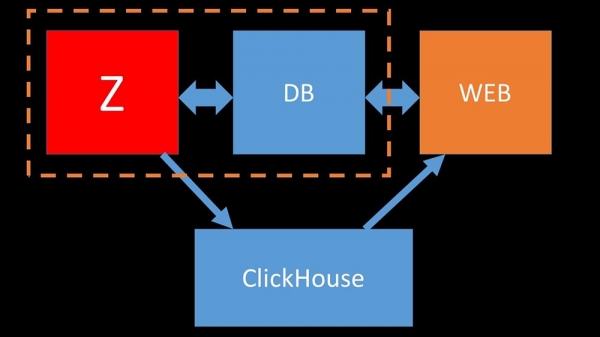
We hebben de hoofd MySQL-database zo ontlast dat we deze konden combineren op één machine met de Zabbix-server en konden afzien van een aparte server voor MySQL.
Hoe werkt polling in Zabbix?
4 maanden geleden
MM: – Nou, kunnen we de problemen met de database vergeten?
MC: – Dat klopt! Een andere taak die we moeten aanpakken, is de trage gegevensverzameling. Nu zijn al onze 15 proxyservers overbelast met SNMP- en pollingprocessen. En er is niets anders dan steeds meer servers aan te schaffen.
MM: – Geweldig. Maar vertel eerst, hoe is de polling in 'Zabbix' georganiseerd?
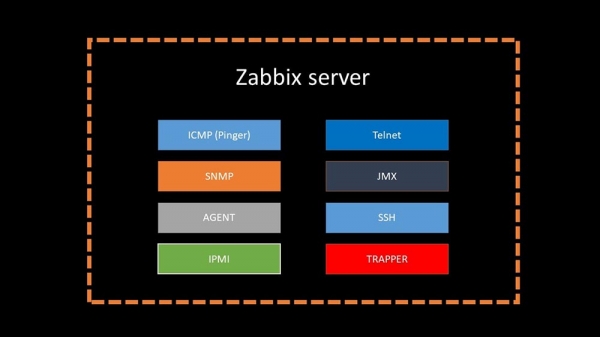
MC: – In het kort, er zijn 20 soorten metrics en een tiental manieren om deze te verkrijgen. 'Zabbix' kan gegevens verzamelen in de modus 'verzoek - antwoord', of wacht op nieuwe gegevens via de 'Trapper Interface'.
Het is het vermelden waard dat deze manier (Trapper) in het originele 'Zabbix' de snelste is.
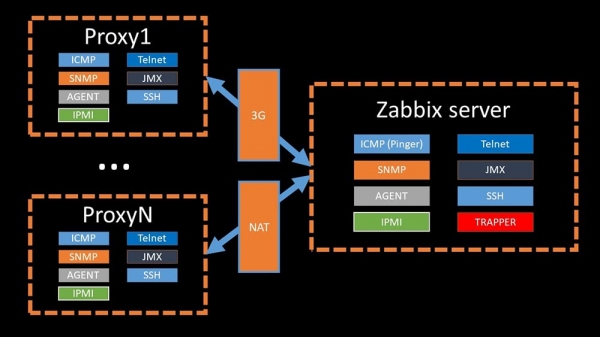
Er zijn proxyservers voor belastingverdeling:
Proxies kunnen dezelfde verzamelfunctionaliteiten uitvoeren als de 'Zabbix'-server, door taken van hem te ontvangen en de verzamelde metrics via de Trapper-interface te verzenden. Dit is de officieel aanbevolen manier van belastingverdeling. Ook zijn proxies nuttig voor het monitoren van externe infrastructuur die via NAT of een trage verbinding werkt:
MM: – De architectuur is duidelijk. We moeten naar de broncode kijken...
Een paar dagen later
Het verhaal van hoe nmap fping overwon
MM: – Het lijkt erop dat ik iets heb ontdekt.
MC: – Vertel het!
MM: – Ik ontdekte dat 'Zabbix' bij beschikbaarheidschecks tot maximaal 128 hosts gelijktijdig controleert. Ik heb geprobeerd dit aantal te verhogen tot 500 en de interpacket vertraging in hun ping te verwijderen – dit verdubbelde de prestaties. Maar ik zou graag hogere cijfers willen zien.
MC: – In mijn praktijk moet ik soms de beschikbaarheid van duizenden hosts controleren, en ik heb niets sneller dan nmap gevonden. Ik ben er zeker van dat dit de snelste manier is. Laten we het proberen! We moeten het aantal hosts per iteratie aanzienlijk verhogen.
MM: – Meer dan vijfhonderd controleren? 600?
MC: – Minimaal een paar duizend.
MM: – Oké. Het belangrijkste dat ik wilde zeggen: ik heb ontdekt dat de meeste polling in 'Zabbix' synchroon is gemaakt. We moeten het absoluut omzetten naar een asynchroon systeem. Dan kunnen we het aantal metrics dat door de pollers wordt verzameld, radicaal verhogen, vooral als we het aantal metrics per iteratie verhogen.
MC: – Geweldig! En wanneer?
MM: – Zoals gebruikelijk, gisteren.
MC: – We hebben beide versies van fping en nmap vergeleken:
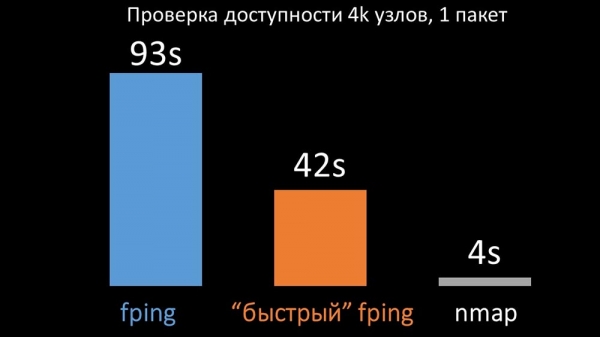
Op een groot aantal hosts was nmap naar verwachting tot vijf keer efficiënter. Aangezien nmap alleen de beschikbaarheid en responstijd controleert, hebben we het verlies in triggers verplaatst en de controle-intervallen voor beschikbaarheid aanzienlijk verkort. We hebben het optimale aantal hosts voor nmap gevonden rond de 4000 per iteratie. Nmap heeft ons in staat gesteld om de CPU-kosten voor beschikbaarheid controles met drie keer te verlagen en het interval van 120 seconden tot 10 seconden te verkorten.
Optimalisatie van polling
MM: – Vervolgens hebben we ons beziggehouden met pollers. We waren voornamelijk geïnteresseerd in het ophalen van SNMP en agents. In 'Zabbix' wordt polling synchronisch uitgevoerd en zijn er speciale maatregelen genomen om de efficiëntie van het systeem te verhogen. In de synchronische modus leidt onbeschikbaarheid van hosts tot aanzienlijke degradatie van polling. Er is een geheel systeem van toestanden en er zijn speciale processen – de zogenaamde unreachable-pollers, die alleen met onbeschikbare hosts werken:

Dit is een opmerking die de matrix van toestanden toont, de complexiteit van het systeem van overgangen die vereist zijn om het systeem efficiënt te houden. Bovendien is de synchronische polling zelf behoorlijk traag:
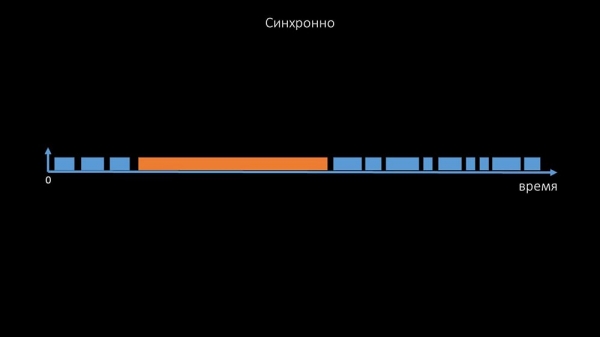
Dat is precies waarom duizenden poller-draden op een tiental proxies niet de benodigde hoeveelheid gegevens voor ons konden verzamelen. De asynchrone implementatie loste niet alleen de problemen met het aantal threads op, maar vereenvoudigde ook het systeem van onbeschikbare hosts-toestanden aanzienlijk, omdat de maximale wachttijd bij elke iteratie van polling 1 timeout was:
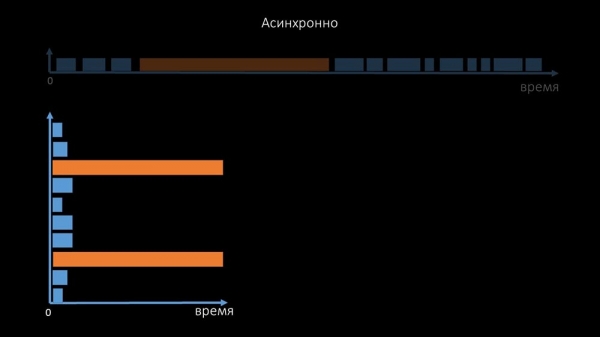
Daarnaast hebben we het polling-systeem voor SNMP-aanvragen aangepast en verbeterd. Het probleem is dat de meeste hosts niet meerdere SNMP-aanvragen tegelijkertijd kunnen beantwoorden. Daarom hebben we een hybride modus gemaakt, waarbij SNMP-polling van dezelfde host asynchroon gebeurt:
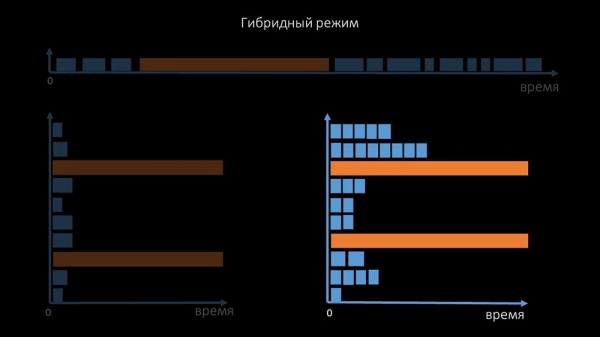
Dit wordt gedaan voor een hele batch hosts. Deze modus is uiteindelijk niet langzamer dan volledig asynchroon, aangezien het ophalen van anderhalve honderd SNMP-waarden nog steeds veel sneller is dan 1 timeout.
Onze experimenten hebben aangetoond dat het optimale aantal aanvragen in één iteratie ongeveer 8000 is bij SNMP-polling. Totaal heeft de overstap naar de asynchrone modus de polling-prestaties met 200 keer versneld, met enkele honderden keren.
MC: De ontvangen pollingoptimalisaties hebben aangetoond dat we niet alleen alle proxy's kunnen afschaffen, maar ook de intervallen voor veel controles kunnen verkorten, terwijl proxy's niet meer nodig zijn als een manier om de belasting te verdelen.
Ongeveer drie maanden geleden
Verander de architectuur – verhoog de belasting!
MM: Nou Max, is het tijd om naar productie te gaan? Ik heb een krachtige server en een goede engineer nodig.
MC: Dat klopt, laten we het plannen. Het is hoog tijd om vooruit te komen uit de stagnatie van 5000 metrische waarden per seconde.
De ochtend na de upgrade
MC: Misha, we hebben een update uitgevoerd, maar tegen de ochtend zijn we teruggevallen… Raad eens welke snelheid we hebben bereikt?
MM: Maximaal ongeveer 20.000.
MC: Aha, 25! Helaas zitten we nog steeds op hetzelfde punt als waar we begonnen.
MM: Waarom is dat? Heb je enige diagnostiek verzameld?
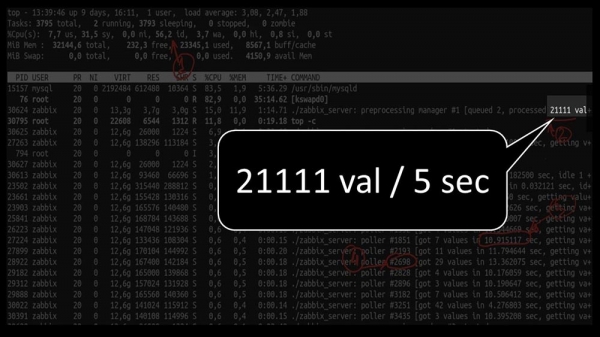
MC: Ja, natuurlijk! Hier, bijvoorbeeld, een interessante top:
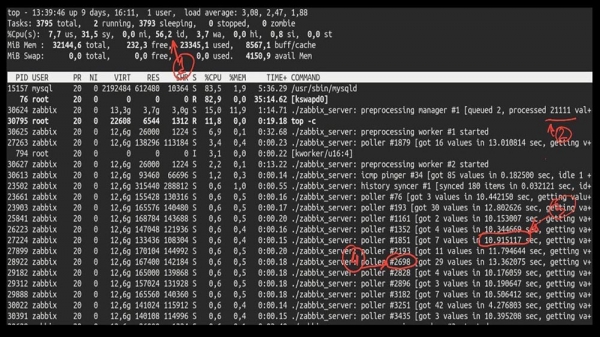
MM: Laten we eens kijken. Ik zie dat we een enorme hoeveelheid pollingthreads hebben geprobeerd:
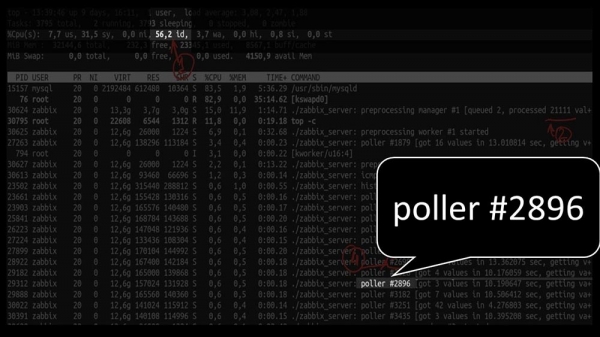
Maar we hebben het systeem zelfs niet voor de helft kunnen benutten:
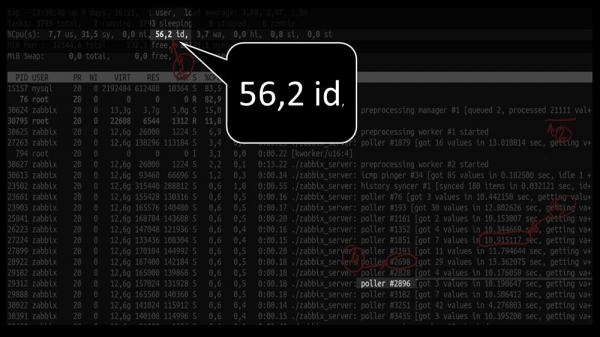
De totale prestaties zijn vrij laag, ongeveer 4000 metrische waarden per seconde:
Is er nog iets?
MC: Ja, een strace van een van de pollers:
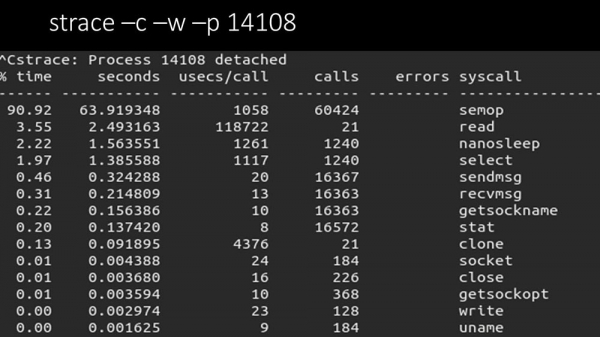
MM: Hier is duidelijk te zien dat het pollingproces wacht op 'semaforen'. Dit zijn blokkades:
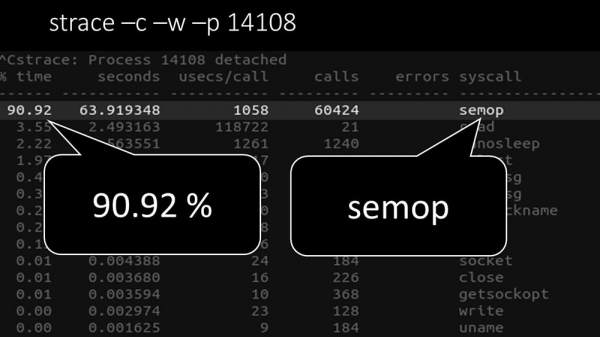
MC: Dat is niet duidelijk.
MM: Kijk, dit lijkt op een situatie waarin een heleboel threads proberen te werken met een bron, waar maar één tegelijk mee kan werken. Dan kunnen ze alleen deze bron in de tijd delen:
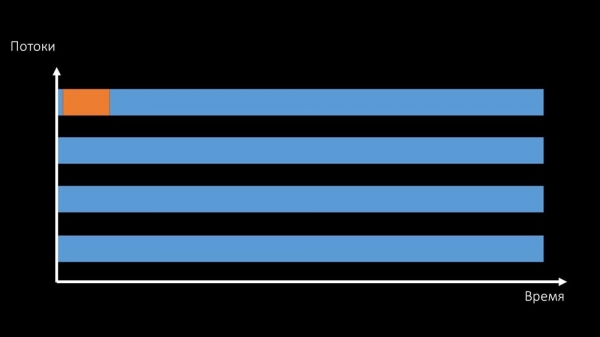
En de totale prestatie bij het werken met zo'n bron is beperkt door de snelheid van één kern:
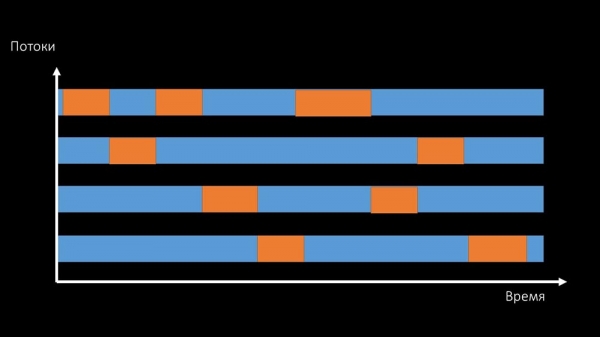
Dit probleem kan op twee manieren worden opgelost.
De hardware van de machine upgraden, overschakelen naar snellere kernen:
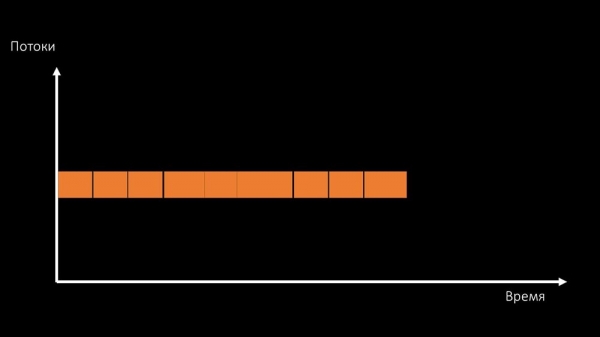
Of de architectuur veranderen en tegelijkertijd de belasting:
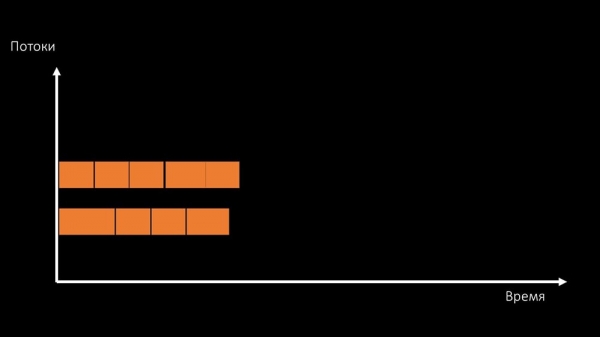
MC: Trouwens, op de testmachine gebruiken we minder kernen dan op de productieomgeving, maar ze zijn 1,5 keer sneller qua kloksnelheid per kern!
MM: Duidelijk? We moeten naar de servercode kijken.
Dataflow in de Zabbix-server
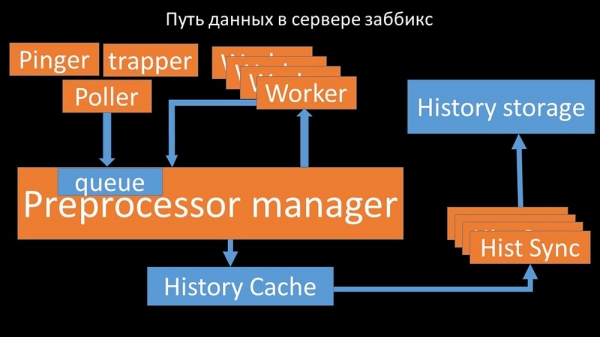
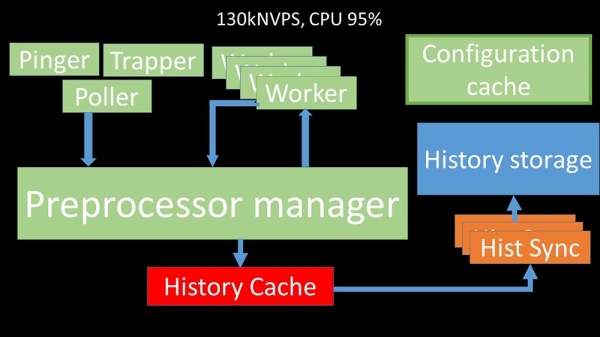
MC: Om erachter te komen, zijn we gaan analyseren hoe de gegevens binnen de 'Zabbix'-server worden verzonden:
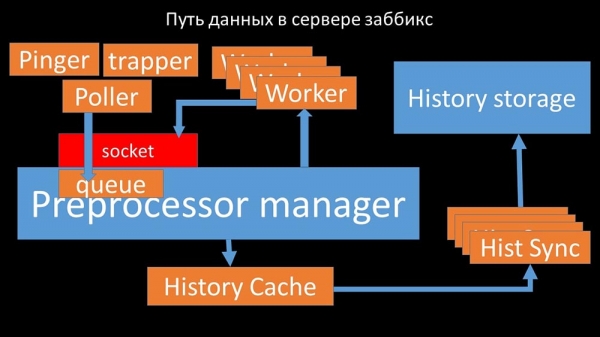
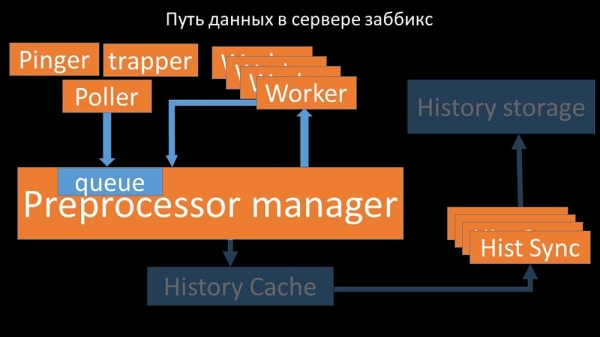
Leuke afbeelding, toch? Laten we stap voor stap doorlopen om het een beetje op te helderen. Er zijn threads en services verantwoordelijk voor het verzamelen van gegevens:
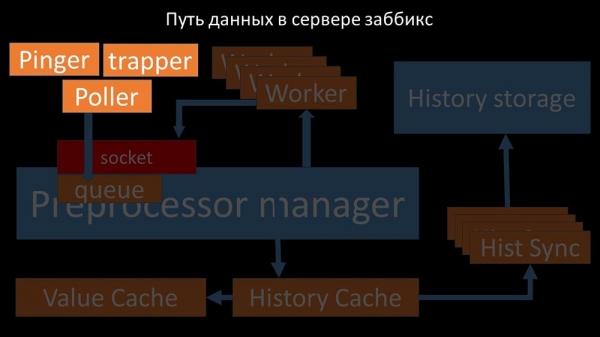
De verzamelde metrics worden via een socket doorgegeven aan de Preprocessor manager, waar ze in een wachtrij worden opgeslagen:
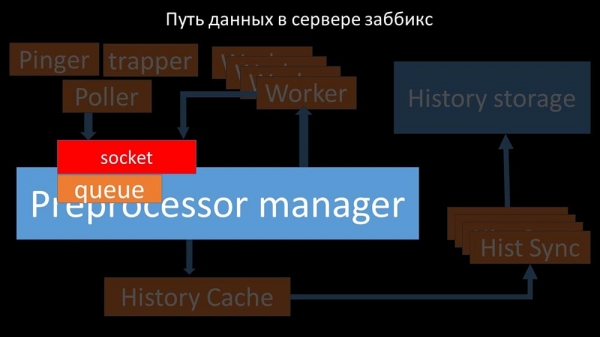
De Preprocessor manager geeft de gegevens door aan zijn workers, die de instructies voor preprocessing uitvoeren en ze via dezelfde socket terugsturen:
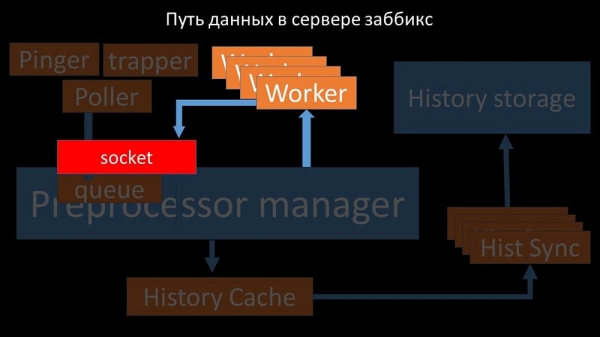
Daarna slaat de preprocessor-manager ze op in de geschiedeniscache:
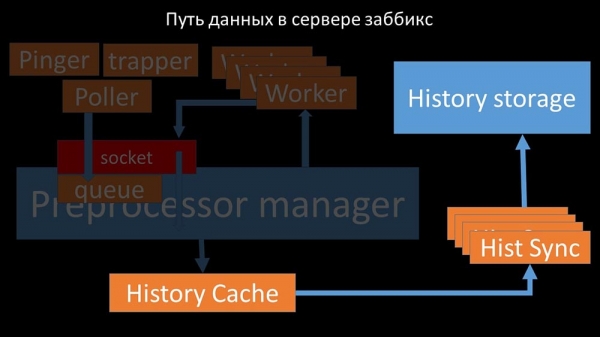
Van daaruit worden ze opgehaald door geschiedenis-synchronizers, die verschillende functies vervullen: bijvoorbeeld, het berekenen van triggers, het vullen van de waarde-cache en, bovenal, het opslaan van metrics in de geschiedenisopslag. Over het algemeen is het proces complex en behoorlijk verwarrend.
MM: – Het eerste wat we zagen, was dat de meeste threads concurreerden om de zogenaamde 'configuratie-cache' (geheugenruimte waarin alle serverconfiguraties worden opgeslagen). Vooral veel blokkades worden veroorzaakt door threads die verantwoordelijk zijn voor het ophalen van gegevens:
…aangezien in de configuratie niet alleen metrics met hun parameters worden opgeslagen, maar ook de wachtrijen waaruit de pollers informatie halen over wat ze vervolgens moeten doen. Wanneer er veel pollers zijn en één blokkeert de configuratie, wachten de anderen op verzoeken:
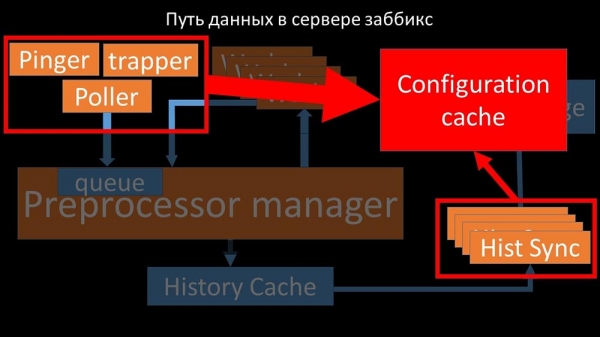
Pollers mogen niet conflicteren
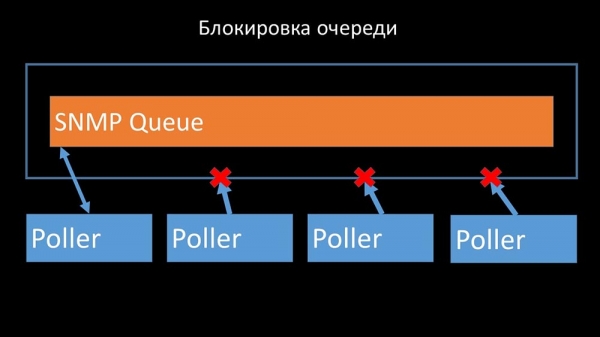
Daarom is het eerste wat we deden, de wachtrij in 4 delen te splitsen en pollers onder veilige voorwaarden toe te staan om deze delen tegelijkertijd te blokkeren:
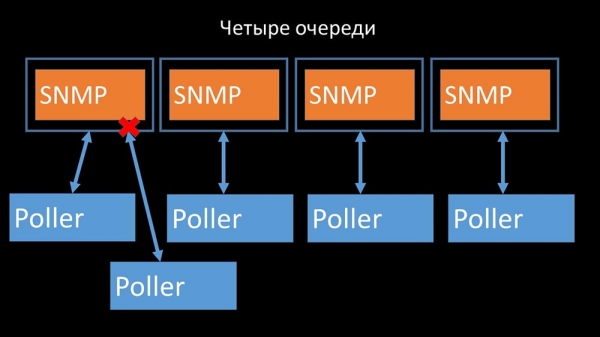
Dit haalde de concurrentie om de configuratiecache weg en de snelheid van de pollers nam aanzienlijk toe. Maar toen stuiten we op het probleem dat de preprocessor-manager begon met het stapelen van taken in de wachtrij:
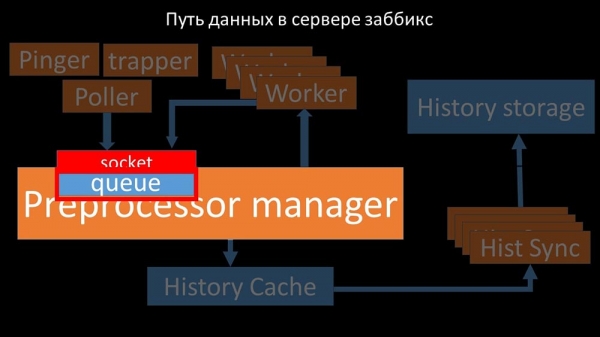
De preprocessor-manager moet prioriteiten kunnen stellen
Dit gebeurde wanneer hij niet genoeg prestaties had. Toen kon hij alleen maar verzoeken van de gegevensverzamelprocessen stapelen en ze in een buffer plaatsen totdat hij al het geheugen opmaakte en crashte:
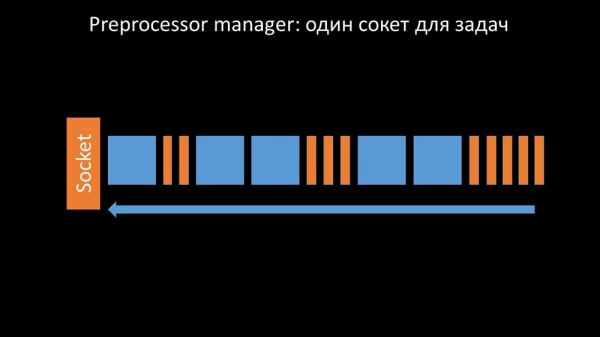
Om dit probleem op te lossen, hebben we een tweede socket toegevoegd die speciaal voor de workers was toegewezen:
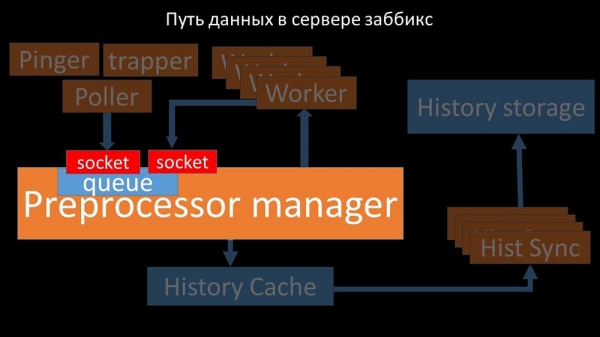
Op deze manier kreeg de preprocessor-manager de mogelijkheid om zijn werk te prioriteren en in geval van bufferuitbreiding de taak te pauzeren, waardoor de workers de kans kregen om deze buffer op te halen:
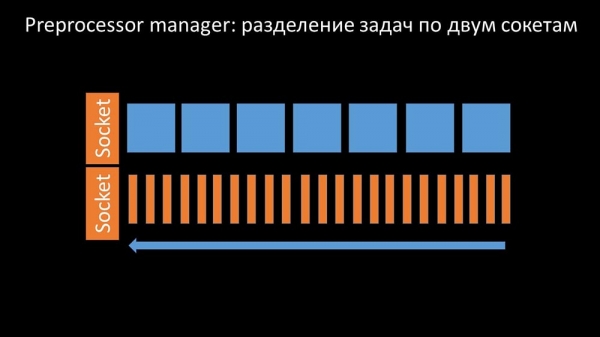
Vervolgens ontdekten we dat een van de redenen voor de vertraging de workers zelf waren, omdat ze concurreerden om een volledig onbelangrijke hulpbron voor hun werk. Dit probleem hebben we opgelost met een bug-fix, en in de nieuwe versies van 'Zabbix' is dit al verholpen:
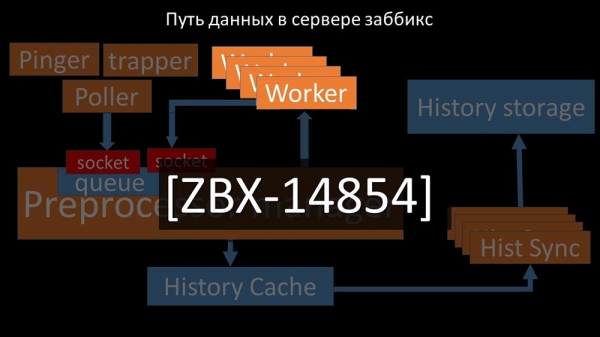
Het aantal sockets verhogen – we krijgen resultaat
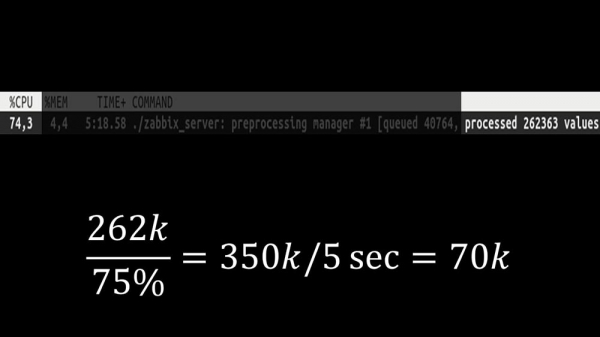
Daarna werd de preprocessor-manager de bottleneck, omdat dit één thread is. Hij stuitte op de snelheid van de core, wat een maximale snelheid gaf van ongeveer 70 duizend metrics per seconde:
Daarom hebben we er vier gemaakt, met vier sets van sockets en workers:
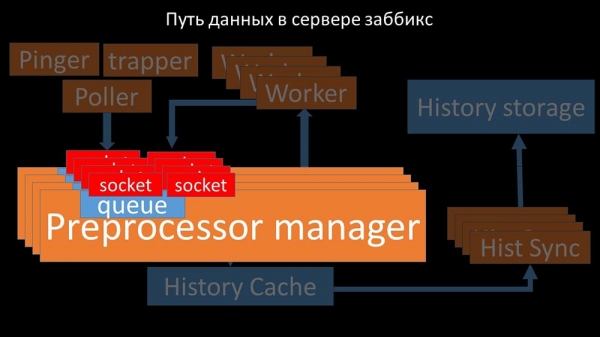
En dit heeft de snelheid verhoogd tot ongeveer 130.000 metrics:
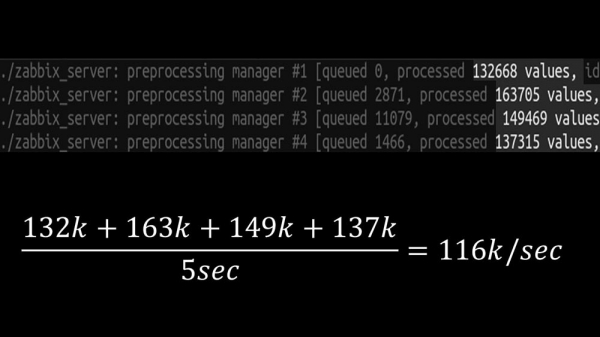
De niet-lineariteit van de groei wordt verklaard doordat er concurrentie ontstond voor de cache van de geschiedenis. Vier preprocessor-managers en history-syncers vochten om dit. Op dat moment haalden we ongeveer 130.000 metrics per seconde op de testmachine, waarbij we deze ongeveer voor 95% gebruikten qua CPU:
Ongeveer 2,5 maanden geleden
Het afzien van de snmp-community heeft het aantal NVP's met 1,5 keer verhoogd
MM: – Max, ik heb een nieuwe testmachine nodig! We passen niet meer in de huidige.
MC: – Wat hebben we nu?
MM: – Op dit moment – 130k NVP's en de processor 'in de kast'.
MC: – Wow! Geweldig! Wacht even, ik heb twee vragen. Volgens mijn berekeningen hebben we ongeveer 15-20.000 metrics per seconde nodig. Waarom hebben we meer nodig?
MM: – Ik wil het werk graag afmaken. Ik wil zien hoeveel we uit dit systeem kunnen halen.
MC: – Maar…
MM: – Maar voor het bedrijf is het nutteloos.
MC: – Begrijpelijk. En de tweede vraag: kunnen we wat we nu hebben zelf ondersteunen, zonder hulp van een ontwikkelaar?
MM: – Ik denk het niet. De wijziging van het werken met de configuratiecache is een probleem. Dit betreft wijzigingen in de meeste threads en is vrij complex om te onderhouden. Waarschijnlijk zal het heel moeilijk zijn om dit te ondersteunen.
MC: – Dan moeten we een alternatief hebben.
MM: – Er is zo'n optie. We kunnen overstappen op snelle cores, terwijl we de nieuwe locksysteem afschaffen. We halen nog steeds een prestaties van 60-80 duizend metrics. Hierbij kunnen we al de andere code behouden. 'ClickHouse', asynchrone polling zullen blijven werken. En dit zal gemakkelijk te onderhouden zijn.
MC: – Geweldig! Laten we hier stoppen.
Na de optimalisatie van de serverkant zijn we eindelijk in staat geweest om de nieuwe code in productie te zetten. We hebben sommige wijzigingen laten vallen ten gunste van de overstap naar een machine met snelle cores en het minimaliseren van de hoeveelheid wijzigingen in de code. We hebben ook de configuratie vereenvoudigd en waar mogelijk afzien van macro’s in data-elementen, omdat deze extra locks veroorzaken.
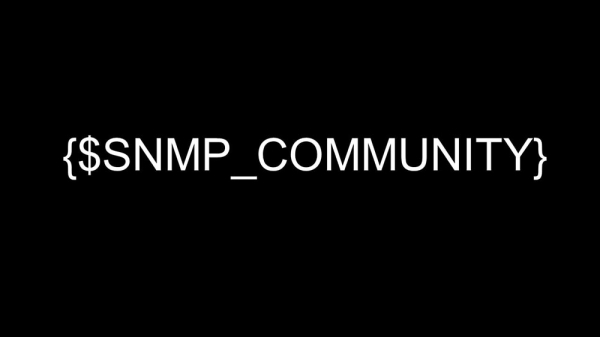
Bijvoorbeeld, het afzien van de vaak voorkomende macro snmp-community in onze documentatie en voorbeelden heeft ons in staat gesteld om NVP's met ongeveer 1,5 keer te versnellen.
Na twee dagen in productie
We verwijderen de pop-upvensters van incidentgeschiedenis
MC: Misha, we have been using the system for two days, and everything works. But only when everything is functioning! We had scheduled maintenance involving the transfer of a fairly large segment of the network, and we manually checked again what was up and what was not.
MM: It can't be! We checked everything 10 times. The server handles even complete network outages instantly.
MC: I get it: the server, database, top, austat, logs – everything is fast… But we look at the web interface, and there it is – the CPU 'in the rack' on the server and this:
MM: Got it. Let's check the web. We found that in situations with a large number of active incidents, most operational widgets started to work very slowly.
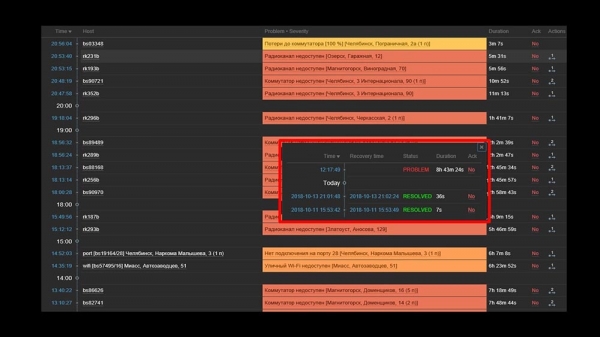
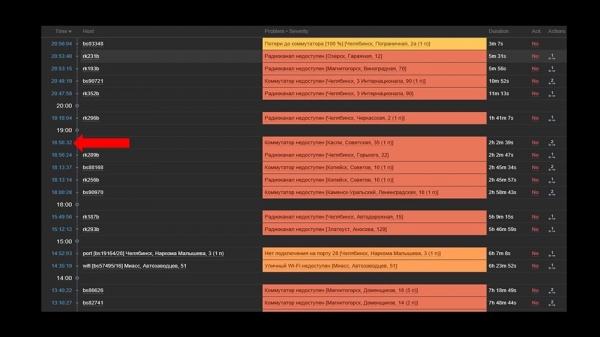
The reason for this was the generation of pop-up windows with incident history, which are generated for each item in the list. Therefore, we gave up on generating these windows (commented out 5 lines of code), and that solved our problems.
The loading time of the widgets, even during a complete outage, decreased from several minutes to an acceptable 10-15 seconds for us, and the history can still be viewed by clicking on the time:
After work. 2 months ago.
MC: Misha, are you leaving? We need to talk.
MM: I wasn't planning to. Is there again something with 'Zabbix'?
MC: No, relax! I just wanted to say: everything works, thank you! I'll buy you a beer.
Zabbix is effective.
'Zabbix' is a fairly versatile and rich system and functionality. It can be used for small installations 'out of the box', but as needs grow, it needs optimization. For storing a large archive of metrics, use appropriate storage:
- you can use the built-in tools in the form of integration with 'Elasticsearch' or export history to text files (available from the fourth version);
- you can use our experience and integration with 'ClickHouse'.
To drastically increase the speed of metric collection, collect them using asynchronous methods and pass them through the trapper interface to the 'Zabbix' server; or you can use a patch for the asynchronous polling of 'Zabbix' itself.
Zabbix is written in C and is quite efficient. The solution's narrow architectural points allow us to further increase its performance and, based on our experience, to gather over 100,000 metrics on a single-processor machine.
The very same Zabbix patch
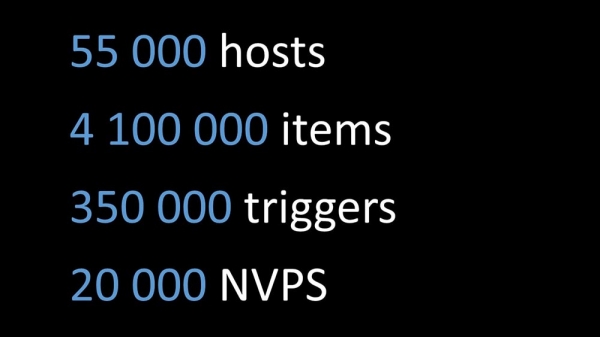
MM: – I want to add a couple of points. The current report, all tests, and figures are given for the configuration we are using. We are currently collecting about 20,000 metrics per second from it. If you are trying to understand whether this will work for you, you can compare. What has been discussed today is available on GitHub as a patch:
The patch includes:
- full integration with ClickHouse (both for Zabbix servers and frontends);
- solution of issues with the preprocessor manager;
- asynchronous polling.
The patch is compatible with the entire version 4, including lts. Most likely, with minimal changes, it will work on version 3.4.
Bedankt voor uw aandacht.
Vragen
Question from the audience (hereinafter – A): – Good afternoon! Please tell me, do you have plans for intensive interaction with the Zabbix team or them with you, so that it is not a patch, but a normal behavior of Zabbix?
MM: – Yes, we will definitely commit some of the changes. Some things will stay in the patch.
A: – Thank you very much for the great report! Please tell me, after applying the patch, will the support from Zabbix remain and how can one further upgrade to higher versions? Will it be possible to upgrade Zabbix after your patch to 4.2, 5.0?
MM: – I cannot say anything about support. If I were Zabbix support, I would probably say no, because this is someone else's code. As for the code base 4.2, our position is this: "We will keep up with the times and will upgrade ourselves to the next version." Therefore, for some time, we will be releasing patches for updated versions. I already mentioned in the report: the number of changes with versions is still quite small. I think the transition from 3.4 to 4 took us about 15 minutes. Something changed, but not very significantly.
A: – So you plan to support your patch and it can be safely deployed in production while receiving updates in some way?
MM: – We categorically recommend it. It solves a lot of problems for us.
MC: – Nogmaals wil ik benadrukken dat de wijzigingen die niet betrekking hebben op de architectuur en die niet gaan over blokkades of wachtrijen modulair zijn; ze bevinden zich in afzonderlijke modules. Zelfs zelfstandig bij kleine wijzigingen kunnen deze vrij gemakkelijk worden onderhouden.
MM: – Als u geïnteresseerd bent in de details, dan gebruikt ‘Clickhouse’ de zogenaamde geschiedenisbibliotheek. Deze is losgekoppeld; het is een kopie van de ondersteuning voor ‘Elasticsearch’, wat betekent dat deze configureerbaar is. Polling verandert alleen de pollers. Wij denken dat dit lang zal blijven werken.
A: – Hartelijk bedankt. Kunt u me vertellen of er documentatie is over de aangebrachte veranderingen?
MM: – De documentatie is de patch. Voor de duidelijkheid, met de introductie van ‘Clickhouse’ en de nieuwe soorten pollers ontstaan nieuwe configuratie-opties. Via de link in de laatste dia is er een korte beschrijving hoe hiermee om te gaan.
Over de vervanging van fping door nmap
A: – Hoe heeft u dat uiteindelijk gerealiseerd? Kunt u met concrete voorbeelden komen: heeft u strappers en een extern script? Wat controleert uiteindelijk zo snel zo’n groot aantal hosts? Hoe haalt u deze hosts binnen? Moet nmap ze op een of andere manier krijgen, ergens vandaan halen, opslaan, iets starten…?
MM: – Cool. Erg goede vraag! De essentie is als volgt. We hebben de bibliotheek (ICMP-ping, een onderdeel van ‘Zabbix’) gemodificeerd voor ICMP-controles, waarin het aantal pakketten is opgegeven – één (1), en de code probeert nmap te gebruiken. Dit betekent dat het een interne functie van ‘Zabbix’ is, en dat is nu de interne functie van de pinger geworden. Dienovereenkomstig zijn er geen synchronisatie of gebruik van traps vereist. Dit was bewust gedaan om het systeem heel te houden en niet te hoeven synchroniseren tussen de twee databases: wat te controleren, te laden via de poller, en of onze upload niet is stuk gegaan... Dit is veel eenvoudiger.
A: – Werkt het ook voor proxy?
MM: – Ja, maar we hebben het niet getest. De pollingcode is zowel in ‘Zabbix’ als op de server identiek. Het zou moeten werken. Nogmaals, ik benadruk: de systeemprestaties zijn zo dat we geen proxy nodig hebben.
MC: – Het juiste antwoord op de vraag zou zijn: ‘Waarom heeft u een proxy nodig bij zo’n systeem?’ Alleen vanwege NAT of omdat u door een langzame verbinding wilt monitoren of zo…
A: – En u gebruikt ‘Zabbix’ als alerting-tool, als ik het goed heb begrepen. Of zijn de grafieken (waar de archieflaag is) verhuisd naar een ander systeem, zoals Grafana? Of gebruikt u deze functionaliteit niet?
MM: – Ik benadruk het nogmaals: we hebben een volledige integratie gemaakt. We zetten de geschiedenis naar 'ClickHouse', maar tegelijkertijd hebben we de PHP-frontend aangepast. De PHP-frontend maakt verbinding met 'ClickHouse' en genereert alle grafieken daarvandaan. Eerlijk gezegd hebben we ook een deel dat gegevens uit dezelfde 'ClickHouse', vanuit dezelfde 'Zabbix'-data, in andere grafische weergavesystemen bouwt.
MC: – Ook in 'Grafana'.
Hoe is de beslissing genomen over de toewijzing van middelen?
A: – Deel wat interne details. Hoe is de beslissing genomen om middelen toe te wijzen voor een serieuze herziening van het product? Dat brengt immers bepaalde risico's met zich mee. En vertel, alstublieft, in de context van uw intenties om nieuwe versies te ondersteunen: hoe rechtvaardigt u deze beslissing vanuit het managementperspectief?
MM: – Blijkbaar hebben we het dramaverhaal niet zo goed verteld. We bevonden ons in een situatie waarin we iets moesten doen en zijn in feite met twee parallelle teams gegaan:
- Het ene team was bezig met het opzetten van monitoring systemen met nieuwe methoden: monitoring als service, een standaardset van open-source oplossingen die we combineren en vervolgens proberen de bedrijfsprocessen aan te passen om met het nieuwe monitorsysteem te werken.
- Tegelijkertijd hadden we een enthousiaste programmeur die hiermee bezig was (over zichzelf). Het toeval wilde dat hij het uiteindelijk won.
A: – En wat is de grootte van het team?
MC: – Het team staat voor je.
A: – Dus zoals altijd is er een passioneer nodig?
MM: – Ik weet niet wat een passioneer is.
A: – In dit geval, blijkbaar, bent u dat. Heel erg bedankt, jullie zijn geweldig.
MM: – Dank je wel.
Over patches voor Zabbix
A: – Voor een systeem dat proxy's gebruikt (bijvoorbeeld in gedistribueerde systemen), is het mogelijk om jullie oplossing aan te passen en patches te maken voor de pollers, proxies en gedeeltelijk de preprocessor van 'Zabbix'; en hun interactie? Is het mogelijk om bestaande ontwikkelingen te optimaliseren voor een systeem met meerdere proxy's?
MM: – Ik weet dat de 'Zabbix'-server wordt opgebouwd met behulp van proxy's (gecompileerd en er komt code uit). We hebben dit niet in productie getest. Ik ben daar niet zeker van, maar volgens mij wordt de preprocessor-manager niet gebruikt in de proxy. De taak van de proxy is om een set metrics van 'Zabbix' te nemen, deze op te halen (hij slaat ook de configuratie, lokale database op) en deze terug te geven aan de 'Zabbix'-server. De preprocessing zal later door de server zelf worden gedaan, wanneer hij deze ontvangt.
De interesse in proxies is begrijpelijk. We zullen dit onderzoeken. Het is een interessant onderwerp.
A: – Het idee was als volgt: als je pollers kunt patchen, kun je ze patchen voor proxies en de interactie met de server patchen, en de preprocessor alleen voor deze doeleinden op de server aanpassen.
MM: – Ik denk dat het zelfs eenvoudiger is. Je neemt de code, past de patch toe, configureert het zoals je wilt – verzamelt proxyservers (bijvoorbeeld met ODBC) en verspreidt de gepatchte code over de systemen. Waar nodig verzamel je proxies, waar nodig servers.
A: – Het zal hoogstwaarschijnlijk niet nodig zijn om de overdracht van proxies naar de server extra te patchen?
MC: – Nee, dat is standaard.
MM: – Eigenlijk is een van de ideeën nooit genoemd. We hebben altijd geprobeerd een balans te vinden tussen een overdaad aan ideeën en het aantal wijzigingen, en de eenvoud van onderhoud.
Een beetje reclame 🙂
Bedankt dat je bij ons blijft. Houd je van onze artikelen? Wil je meer interessante inhoud zien? Ondersteun ons door een bestelling te plaatsen of ons aan vrienden aan te bevelen, , een unieke variant van entry-level servers, die we voor jou hebben bedacht: (opties beschikbaar met RAID1 en RAID10, tot 24 cores en tot 40GB DDR4).
Dell R730xd is 2 keer goedkoper in datacenter Equinix Tier IV in Amsterdam? Alleen bij ons in Nederland! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — vanaf $99! Lees over hoe
Bron: habr.com
