

De volgende HighLoad++ conferentie vindt plaats op 6 en 7 april 2020 in Sint-Petersburg.
Details en tickets . HighLoad++ Siberia 2019. Zaal "Krasnojarsk". 25 juni, 12:00. Samenvattingen en .
Soms lopen praktische vereisten vooruit op de theorie, waarin belangrijke aspecten voor een commercieel product niet zijn meegenomen. In deze presentatie wordt het proces gepresenteerd van het kiezen en combineren van verschillende benaderingen voor het creëren van componenten voor Causal consistency, gebaseerd op academisch onderzoek en de vereisten van commerciële producten. De luisteraars zullen leren over bestaande theoretische benaderingen van logical clocks, dependency tracking, system security, clock synchronization, en waarom MongoDB bepaalde oplossingen heeft gekozen.
Mikhail Tyulenev (hierna - MT): - Ik ga vertellen over Causal consistency – een functie waar we bij MongoDB aan hebben gewerkt. Ik werk in de groep voor gedistribueerde systemen, we hebben dit ongeveer twee jaar geleden gerealiseerd.
In het proces moest ik veel academisch onderzoek bestuderen, omdat deze functie goed is bestudeerd. Het bleek dat geen enkele paper volledig voldoet aan wat er nodig is in productie, in een database, gezien de zeer specifieke vereisten die er waarschijnlijk zijn in elke productieapplicatie.
Ik ga vertellen hoe we, als gebruikers van academisch onderzoek, daar iets van bereiden dat we vervolgens aan onze gebruikers kunnen presenteren als een kant-en-klaar gerecht, dat handig en veilig te gebruiken is.
Causale consistentie (Causal consistency). Laten we de begrippen definiëren.
Om te beginnen wil ik in het algemeen zeggen wat Causal consistency is. Er zijn twee personages – Leonard en Penny (serie 'The Big Bang Theory'):
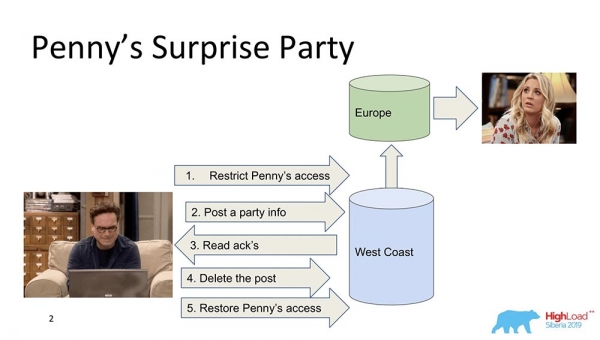
Stel je voor dat Penny in Europa is, en Leonard een verrassing voor haar wil organiseren. En hij komt niet met iets beters dan haar uit zijn vriendenlijst te gooien, en alle vrienden een update op hun feed te sturen: "Laten we Penny blij maken!" (ze is in Europa, terwijl ze slaapt, kan dit allemaal niet zien en kan het niet zien omdat ze er niet is). Op een gegeven moment verwijdert hij deze post, wist het uit de "feed" en herstelt de toegang, zodat ze er niets van merkt en er geen rel ontstaat.
Dit is allemaal geweldig, maar laten we aannemen dat het systeem gedistribueerd is en de gebeurtenissen niet helemaal zoals verwacht verlopen. Het kan bijvoorbeeld gebeuren dat de access beperking van Penny plaatsvond nadat deze post verschenen is, als de gebeurtenissen niet causaal met elkaar verbonden zijn. Dit is in feite een voorbeeld van wanneer Causal consistency nodig is om een zakelijke functie uit te voeren (in dit geval).
Eigenlijk zijn dit best complexe eigenschappen van databases - heel weinig functies ondersteunen ze. Laten we verder gaan met de modellen.
Consistentiemodellen
Wat is een consistentiemodel in databases eigenlijk? Dit zijn bepaalde garanties die een gedistribueerd systeem biedt over welke gegevens en in welke volgorde een cliënt kan ontvangen.
In principe komen alle consistentiemodellen neer op de vraag in hoeverre een gedistribueerd systeem lijkt op een systeem dat bijvoorbeeld op één node op een laptop draait. En in hoeverre lijkt een systeem dat draait op duizenden geografisch verspreide 'nodes' op een laptop, waarin al deze eigenschappen in principe automatisch worden uitgevoerd.
Daarom zijn consistentiemodellen alleen van toepassing op gedistribueerde systemen. Alle systemen die eerder bestonden en werkten met verticale schaalvergroting hebben dergelijke problemen niet ervaren. Daar was er één Buffer Cache, en daaruit werd altijd alles gelezen.
Sterk model
Eigenlijk is het eerste model - het Sterke model (of zoals het vaak wordt genoemd, de rise ability lijn). Dit is een consistentiemodel dat garandeert dat elke wijziging, zodra de bevestiging dat deze heeft plaatsgevonden is ontvangen, voor alle gebruikers van het systeem zichtbaar wordt.
Dit creëert een wereldwijde volgorde van alle gebeurtenissen in de database. Dit is een zeer sterke eigenschap van consistentie, en het is ook zeer kostbaar. Desondanks wordt het goed ondersteund. Het is gewoon heel duur en langzaam - men maakt er gewoon zelden gebruik van. Dit wordt rise ability genoemd.
Er is nog een andere, sterkere eigenschap die wordt ondersteund in 'Spanner' - dit wordt externe consistentie genoemd. We zullen dit later bespreken.
Causaal
Het volgende is Causal, precies waar ik het over had. Tussen Strong en Causal zijn er nog een aantal subniveaus waar ik niet over zal spreken, maar deze komen allemaal neer op Causal. Dit is een belangrijk model, omdat het het sterkste is van alle modellen, met de sterkste consistentie in het geval van een netwerk of partities.
Causals zijn eigenlijk de situatie waarin gebeurtenissen causaal met elkaar verbonden zijn. Vaak worden ze gezien als Read your on rights vanuit het perspectief van de klant. Als een klant bepaalde waarden heeft waargenomen, kan hij de waarden van het verleden niet meer zien. Hij begint al prefix readings te zien. Dit komt allemaal op hetzelfde neer.
Causals als model van consistentie – een gedeeltelijke ordening van gebeurtenissen op de server, waarbij gebeurtenissen van alle klanten in dezelfde volgorde worden waargenomen. In dit geval – Leonard en Penny.
Eventual
Het derde model is Eventual Consistency. Dit is wat absoluut alle gedistribueerde systemen ondersteunen, het minimale model dat überhaupt zinvol is. Het betekent het volgende: wanneer we bepaalde wijzigingen in de gegevens aanbrengen, worden deze op een gegeven moment consistent.
Op dat moment zegt het niets, anders zou het in External Consistency veranderen – dat zou een heel ander verhaal zijn. Toch is dit een zeer populair model, het meest voorkomende. Standaard gebruiken alle gebruikers van gedistribueerde systemen inderdaad Eventual Consistency.
Ik wil een paar vergelijkende voorbeelden geven:
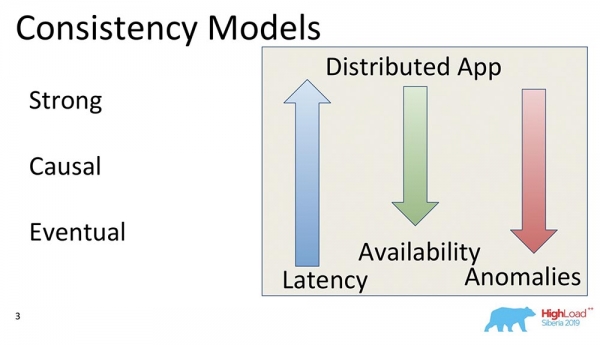
Wat betekenen deze pijlen?
- Latency. Bij het vergroten van de kracht van consistentie wordt deze groter om duidelijke redenen: het is nodig om meer bewerkingen uit te voeren, bevestiging te krijgen van alle hosts en nodes die deelnemen aan de cluster, dat de gegevens daar al zijn. Daarom is de snelste respons bij Eventual Consistency, omdat je daar doorgaans zelfs in het geheugen kunt committeren en dat in principe voldoende zal zijn.
- Availability. Als we dit begrijpen als de mogelijkheid van het systeem om te reageren bij netwerkonderbrekingen, partities of bepaalde storingen – neemt de fault tolerance toe bij vermindering van het model van consistentie, omdat we genoeg hebben dat één host actief blijft en enkele gegevens biedt. Eventual Consistency garandeert helemaal niets over de gegevens – het kan van alles zijn.
- Anomalieën. Natuurlijk neemt het aantal anomalieën toe. Bij Strong Consistency zouden ze er eigenlijk bijna niet moeten zijn, terwijl ze bij Eventual Consistency van alles kunnen zijn. De vraag rijst: waarom kiezen mensen voor Eventual Consistency, als het anomalieën bevat? Het antwoord is dat de modellen voor Eventual Consistency toepasbaar zijn en dat anomalieën bijvoorbeeld maar voor een korte tijd bestaan; er is de mogelijkheid om een master te gebruiken voor het lezen en meer of minder consistente gegevens te lezen; er is vaak ook de mogelijkheid om sterke consistentiemodellen te gebruiken. In de praktijk werkt dit en vaak is het aantal anomalieën tijdgebonden.
CAP-theorema
Wanneer je de woorden consistentie en beschikbaarheid ziet, wat komt dan in je op? Juist - het CAP-theorema! Ik wil nu een mythe ontkrachten… Het is niet ik – het is Martin Kleppmann die een prachtig artikel en een prachtig boek heeft geschreven.
Het CAP-theorema is een principe dat in de jaren 2000 is geformuleerd, dat stelt dat Consistentie, Beschikbaarheid, Partities: neem er twee, en je kunt er geen drie kiezen. Dit was een bepaald principe. Het is enkele jaren later bewezen als een theorema, dat deden Gilbert en Lynch. Vervolgens begon het als een mantra gebruikt te worden - systemen werden onderverdeeld in CA, CP, AP, enzovoort.
Dit theorema is eigenlijk bewezen voor bepaalde gevallen... Ten eerste werd Beschikbaarheid niet bekeken als een continue waarde van nul tot honderd (0 – systeem is 'dood', 100 – reageert snel; dat zijn we gewend te bekijken), maar als een eigenschap van een algoritme dat garandeert dat het bij al zijn uitvoeringen gegevens retourneert.
Er staat helemaal niets over de responstijd! Er is een algoritme dat gegevens na 100 jaar retourneert – een volkomen prachtig beschikbaar algoritme, dat een onderdeel is van het CAP-theorema.
Ten tweede werd het theorema bewezen voor wijzigingen in de waarden van dezelfde sleutel, terwijl deze wijzigingen – een resizebare lijn zijn. Dit betekent dat ze in werkelijkheid nauwelijks worden gebruikt, omdat andere modellen zoals Eventual Consistency, Strong Consistency (misschien) bestaan.
Waar gaat dit allemaal over? Het CAP-theorema in de vorm waarin het is bewezen, is in de praktijk bijna niet toepasbaar en wordt zelden gebruikt. In theoretische vorm beperkt het op een bepaalde manier alles. Er ontstaat een bepaalde principe dat intuïtief waar is, maar in feite niet echt bewezen.
Causale consistentie – het sterkste model
Wat er nu gebeurt, is dat je alle drie dingen kunt krijgen: Consistentie, Beschikbaarheid kunt krijgen met behulp van Partities. In het bijzonder is Causale consistentie het sterkste model van consistentie, dat zelfs bij Partities (onderbrekingen in netwerken) blijft functioneren. Daarom is het zo interessant en daarom zijn we ermee begonnen.
Ten eerste, het vereenvoudigt het werk van applicatieontwikkelaars. In het bijzonder is er grote serverondersteuning: als alle gegevens die binnen één klant plaatsvinden, gegarandeerd in dezelfde volgorde bij een andere klant aankomen. Ten tweede, het weerstaat partities.
De interne werking van MongoDB
Bedenkend dat het lunchtijd is, verplaatsen we ons naar de keuken. Ik zal het hebben over het systeemmodel en wat MongoDB is voor degenen die voor het eerst over deze database horen.
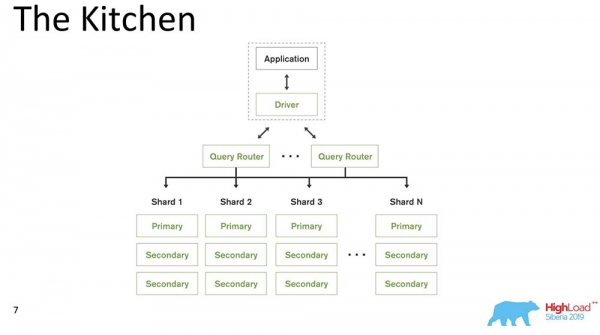
MongoDB (hierna 'MongoDB') is een gedistribueerd systeem dat horizontale schaalbaarheid ondersteunt, dat wil zeggen sharding; en binnen elke shard ondersteunt het ook gegevensredundantie, dat wil zeggen replicatie.
Sharding in 'MongoDB' (geen relationele DB) voert automatische belastingredistributie uit, dat wil zeggen dat elke documentcollectie (of 'tabel' in relationele termen) in stukjes wordt verdeeld, en de server verplaatst ze automatisch tussen shards.
De Query Router, die de verzoeken distribueert, is voor de cliënt een soort klant waar hij mee werkt. Hij weet al waar en welke gegevens zich bevinden en stuurt alle verzoeken naar de juiste shard.
Een ander belangrijk punt: MongoDB is een single master. Er is één Primary – hij kan records bijhouden die de sleutels ondersteunen die hij in zich heeft. Multi-master schrijven is niet mogelijk.
We hebben release 4.2 gedaan – daar zijn nieuwe interessante dingen gekomen. In het bijzonder hebben we Lucene toegevoegd –zoeken – namelijk uitvoerbare java direct in 'Mongo', en het is nu mogelijk om te zoeken via Lucene, net als in 'Elasticsearch'.
En we hebben een nieuw product gemaakt – Charts, dat ook beschikbaar is op 'Atlas' (de eigen Cloud van 'Mongo'). Ze hebben een Free Tier – je kunt hier mee experimenteren. Charts vond ik heel leuk – gegevensvisualisatie, heel intuïtief.
Ingredienten van Causale consistentie
Ik heb ongeveer 230 artikelen geteld die over dit onderwerp zijn gepubliceerd – van Leslie Lampert. Nu zal ik enkele delen van deze materialen naar je overbrengen vanuit mijn geheugen.
Alles begon met een artikel van Leslie Lampert, geschreven in de jaren zeventig. Zoals je ziet, zijn er tot op heden nog steeds onderzoeken naar dit onderwerp gaande. Momenteel is er interesse in Causal consistency, vooral door de ontwikkeling van gedistribueerde systemen.
Beperkingen
Wat zijn de beperkingen? Dit is eigenlijk een van de belangrijkste punten, want de beperkingen die productieomgevingen met zich meebrengen, verschillen sterk van de beperkingen die in academische artikelen worden gepresenteerd. Vaak zijn ze behoorlijk kunstmatig.
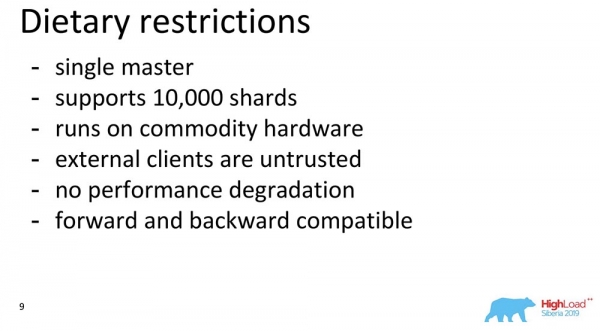
- Ten eerste, 'MongoDB' is single master, zoals ik al zei (dat vereenvoudigt het enorm).
- Wij geloven dat het systeem ongeveer 10.000 shards moet ondersteunen. We kunnen geen architectonische beslissingen nemen die deze waarde expliciet zouden beperken.
- We hebben wel een cloud, maar we veronderstellen dat een persoon de mogelijkheid moet hebben om, wanneer hij de binary downloadt en deze op zijn laptop uitvoert, alles perfect moet werken.
- We veronderstellen dat in onderzoek zelden het geval is: externe klanten kunnen doen wat ze maar willen. 'MongoDB' is open-source. Dienovereenkomstig kunnen de klanten slim en kwaadwillig zijn – ze kunnen alles willen verpesten. We veronderstellen dat Byzantijnse failures kunnen optreden.
- Voor externe klanten die zich buiten de perimeter bevinden, is er een belangrijke beperking: als deze functie is uitgeschakeld, mag er geen prestatieverlies waarneembaar zijn.
- Een ander punt – eigenlijk anti-academisch: compatibiliteit van eerdere versies met toekomstige. Oude drivers moeten nieuwe updates ondersteunen, en de database moet oude drivers ondersteunen.
Over het algemeen legt dit allemaal beperkingen op.
Componenten van Causal consistency
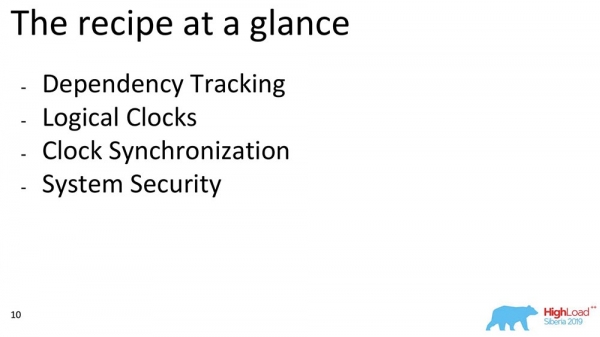
Ik ga nu vertellen over enkele componenten. Als we Causal consistency in het algemeen beschouwen, kunnen we blokken onderscheiden. We hebben geselecteerd uit werken die tot een bepaald blok behoren: Dependency Tracking, de keuze van klokken, hoe deze klokken met elkaar kunnen worden gesynchroniseerd, en hoe we veiligheid waarborgen – dat is een globaal overzicht van waarover ik ga praten:
Volledige afhankelijkheidsoTracking (Full Dependency Tracking)
Waarom is het nodig? Wanneer gegevens worden gerepliceerd, bevat elke record, elke wijziging informatie over welke wijzigingen eraan ten grondslag liggen. De eerste en meest eenvoudige wijziging is dat elke boodschap die een record bevat, informatie bevat over de vorige berichten:
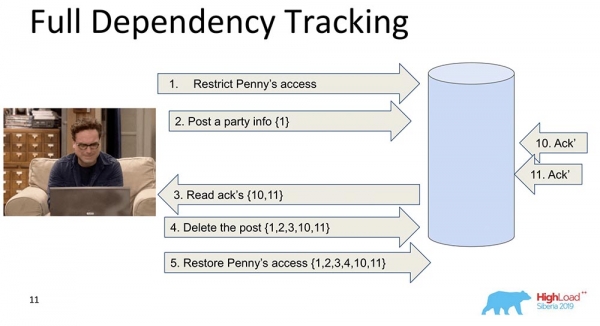
In dit voorbeeld is het nummer tussen accolades het recordnummer. Soms worden deze records met waarden zelfs volledig doorgegeven, soms worden bepaalde versies doorgegeven. De essentie is dat elke wijziging informatie bevat over de voorgaande (dit wordt duidelijk ingebouwd).
Waarom hebben we besloten om deze aanpak (volledige tracking) niet te gebruiken? Het is duidelijk dat deze aanpak onpraktisch is: elke wijziging in een sociaal netwerk hangt af van alle voorgaande wijzigingen in dat sociale netwerk, en zou bijvoorbeeld 'Facebook' of 'VKontakte' in elke update moeten doorgeven. Toch zijn er veel onderzoeken naar Full Dependency Tracking – dit zijn pre-sociale netwerken, en voor bepaalde situaties werkt dit echt.
Expliciete afhankelijkheids tracking (Explicit Dependency Tracking)
De volgende is beperkter. Hier wordt ook gekeken naar het doorgeven van informatie, maar alleen die informatie die expliciet afhankelijk is. Wat van wat afhankelijk is, wordt meestal bepaald door de applicatie. Wanneer gegevens worden gerepliceerd, worden alleen de antwoorden gegeven wanneer aan de vorige afhankelijkheden is voldaan, dat wil zeggen, deze zijn weergegeven. Dit is de essentie van hoe Causal consistency werkt.
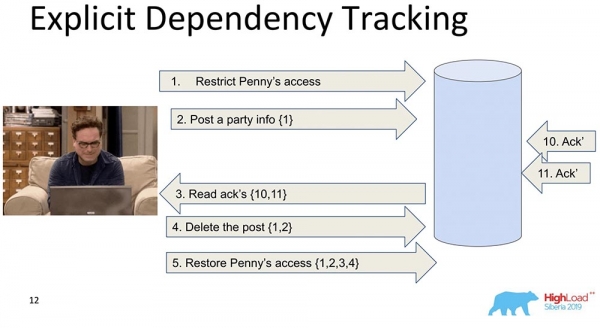
Het ziet dat record 5 afhankelijk is van records 1, 2, 3 en 4 – daarom wacht het voordat de klant toegang krijgt tot de wijzigingen die zijn aangebracht op verzoek van Penny, wanneer alle voorgaande wijzigingen al in de database zijn doorgevoerd.
Dit is ook niet acceptabel voor ons, want er is nog steeds te veel informatie, en dit zou vertraging veroorzaken. Er is een andere aanpak...
Lamport Klok (Lamport Clock)
Ze zijn erg oud. De Lamport Klok houdt in dat deze afhankelijkheden worden samengevoegd in een scalair functie, die de Lamport Klok wordt genoemd.
Een scalair functie is een abstract getal. Het wordt vaak logische tijd genoemd. Bij elke gebeurtenis wordt deze counter verhoogd. De counter die momenteel bekend is bij het proces, verzendt elk bericht. Het is duidelijk dat processen niet gesynchroniseerd kunnen zijn; ze kunnen volkomen verschillende tijden hebben. Toch balanceert het systeem de klokken op een bepaalde manier door dit berichtenverkeer. Wat gebeurt er in dit geval?
Ik heb die grote shard in tweeën verdeeld, zodat het duidelijk is: Friends kunnen in dezelfde node leven die een deel van de collectie bevat, terwijl Feed geheel in een andere node kan staan, waar ook een deel van die collectie zich bevindt. Is het duidelijk hoe ze niet in de wachtrij kunnen komen? Eerst zal Feed zeggen: "Gerepliceerd", en daarna – Friends. Als het systeem geen garanties biedt dat Feed niet getoond wordt totdat de afhankelijkheden van Friends in de collectie van Friends ook geleverd zijn, ontstaat precies de situatie die ik noemde.
Je ziet hoe de logische tijd van de counter op de Feed toeneemt:
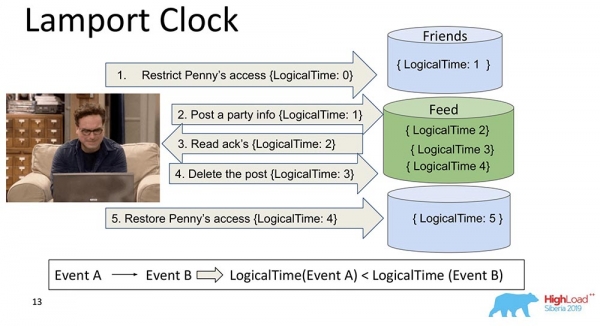
Dientengevolge is de belangrijkste eigenschap van deze Lamport-klok en causale consistentie (verklaard door middel van de Lamport-klok) als volgt: als we gebeurtenissen A en B hebben, en gebeurtenis B afhankelijk is van gebeurtenis A *, dan volgt hieruit dat de LogicalTime van Event A kleiner is dan de LogicalTime van Event B.
* Soms zegt men ook dat A gebeurde voor B, wat betekent dat A eerder plaatsvond dan B – dit is een bepaalde relatie die een gedeeltelijke ordening aanbrengt in de verzameling gebeurtenissen die ooit hebben plaatsgevonden.
Omgekeerd is het niet waar. Dit is in feite een van de belangrijkste nadelen van de Lamport-klok – gedeeltelijke volgorde. Er is het begrip van gelijktijdige gebeurtenissen, dat wil zeggen gebeurtenissen, waarbij noch (A happened before B), noch (A happened before B) het geval is. Een voorbeeld zou parallelle bijvoeging van Leonard aan iemand anders zijn (zelfs niet Leonard, maar Sheldon, bijvoorbeeld).
Dit is de eigenschap die vaak wordt gebruikt bij het werken met Lamport-klokken: men kijkt naar de functie en daaruit komt de conclusie voort – misschien zijn deze gebeurtenissen afhankelijk. Want in één richting is het waar: als LogicalTime A kleiner is dan LogicalTime B, kan B niet eerder zijn gebeurd dan A; maar als het groter is, kan dat wel.
Vector klokken (Vector Clock)
De logische ontwikkeling van Lamport-klokken is de Vector klok. Ze verschillen doordat elke node die hier aanwezig is, zijn eigen, aparte klokken bevat, die als een vector worden doorgegeven.
In dit geval zie je dat de nulindex van de vector staat voor Feed, en de eerste index van de vector staat voor Friends (elk van deze nodes). En nu zullen ze in grootte toenemen: de nulindex "Feed" neemt toe met de waarden – 1, 2, 3:
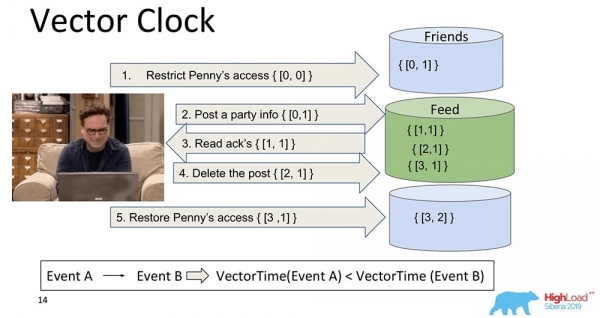
Waarom zijn Vector Clocks beter? Omdat ze helpen te begrijpen welke gebeurtenissen gelijktijdig zijn en wanneer ze plaatsvinden op verschillende nodes. Dit is erg belangrijk voor het sharding systeem, zoals "MongoDB". We hebben het echter niet gekozen, hoewel het een geweldig systeem is dat prima werkt en waarschijnlijk ook voor ons zou werken...
Als we 10.000 shards hebben, kunnen we geen 10.000 componenten doorgeven, zelfs niet als we compressie toepassen of andere ideeën bedenken – de nuttige lading zal nog steeds veel kleiner zijn dan het volume van deze vector. Daarom hebben we, met tegenzin, deze benadering verlaten en zijn we overgestapt naar een andere.
Spanner TrueTime. Atomuurlijke klokken.
Ik zei dat er een verhaal zou zijn over "Spanner". Het is een geweldig systeem, echt een product van de 21e eeuw: atomische klokken, GPS-synchronisatie.
Wat is het idee? "Spanner" is een systeem van Google dat recentelijk toegankelijk is geworden voor mensen (ze hebben er SQL aan toegevoegd). Elke transactie heeft een bepaalde tijdstempel. Omdat de tijd gesynchroniseerd is*, kan aan elk evenement een specifieke tijd worden toegewezen – atomische klokken hebben een wachttijd waarna gegarandeerd "een ander tijdstip" plaatsvindt.
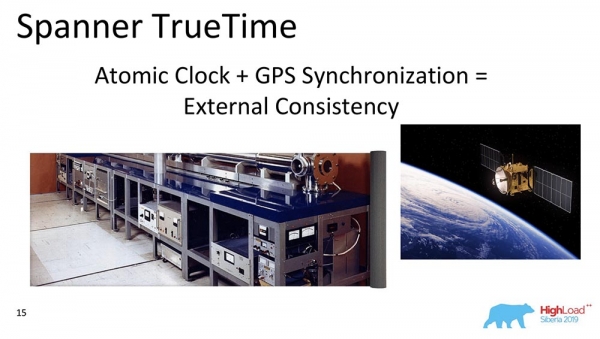
Op deze manier, door gewoon in de database te schrijven en een bepaalde tijd te wachten, wordt automatisch de serialiseerbaarheid van het evenement gegarandeerd. Ze hebben het sterkste consistentiemodel dat je je kunt voorstellen – het is externe consistentie.
* Dit is het belangrijkste probleem van Lamport's klokken – ze zijn nooit gesynchroniseerd in gedistribueerde systemen. Ze kunnen uit elkaar lopen, zelfs met NTP werken ze nog steeds niet zo goed. "Spanner" heeft atomische klokken en synchronisatie die op microseconden lijkt.
Waarom hebben we het niet gekozen? We gaan ervan uit dat onze gebruikers geen ingebouwde atomische klokken hebben. Wanneer ze ingebouwd in elke laptop verschijnen, zal er een supergoede GPS-synchronisatie zijn – dan ja... Maar op dit moment is het beste wat mogelijk is, "Amazon", basisstations – voor de fanaten... Daarom hebben we andere klokken gebruikt.
Hybride klokken (Hybrid Clock)
Dit is feitelijk wat tikt in "MongoDB" bij het waarborgen van causale consistentie. Hybridisch, waar zijn ze hybride in? Een hybride is een scalaar waarde, maar het bestaat uit twee componenten:
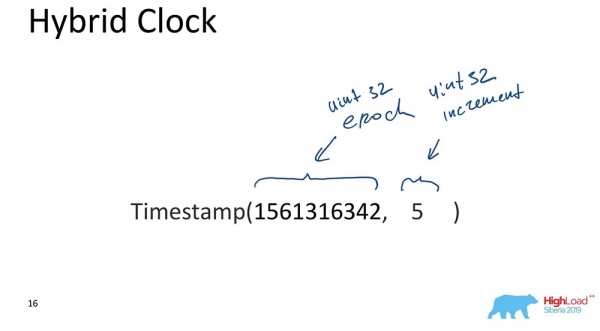
- De eerste is de Unix-epoch (hoeveel seconden zijn verstreken sinds "het begin van de computerwereld").
- De tweede is een bepaalde increment, ook een 32-bits unsigned int.
Dat is het eigenlijk. Er is een benadering: het deel dat verantwoordelijk is voor de tijd, synchroniseert continu met de klok; elke keer wanneer er een update plaatsvindt, wordt dit deel gesynchroniseerd met de klok, waardoor de tijd altijd meer of minder correct is, terwijl de increment het mogelijk maakt om gebeurtenissen te onderscheiden die op hetzelfde moment zijn gebeurd.
Waarom is dit belangrijk voor "MongoDB"? Omdat het mogelijk maakt om bepaalde back-up hersteloperaties op een specifiek tijdstip uit te voeren, wat betekent dat een gebeurtenis wordt geïndexeerd op tijd. Dit is belangrijk wanneer specifieke gebeurtenissen nodig zijn; voor databases zijn gebeurtenissen de wijzigingen in de database die zich op specifieke tijdstippen hebben voorgedaan.
De belangrijkste reden vertel ik alleen aan jou (alsjeblieft, vertel het aan niemand)! We hebben het zo gedaan omdat dit is hoe geordende, geïndexeerde gegevens in de MongoDB OpLog eruitzien. OpLog is een datastructuur die alle wijzigingen in de database bevat: ze komen eerst in de OpLog terecht en worden daarna daadwerkelijk toegepast op de opslag, wanneer het gaat om gerepliceerde gegevens of shards.
Dit was de belangrijkste reden. Er zijn ook praktische vereisten voor de ontwikkeling van de database, wat betekent dat het eenvoudig moet zijn – weinig code, zo min mogelijk gebroken dingen die herschreven en getest moeten worden. Het feit dat onze oplogs geïndexeerd zijn met hybride klokken, heeft enorm geholpen en maakte de juiste keuze mogelijk. Het heeft zich echt bewezen en werkte eigenlijk als magie, bij de eerste prototype. Het was echt geweldig!
Synchronisatie van klokken
Er zijn verschillende methoden voor synchronisatie beschreven in de wetenschappelijke literatuur. Ik heb het over synchronisatie wanneer we twee verschillende shards hebben. Als er een replica-set is, is er geen synchronisatie nodig: dit is een 'single-master'; we hebben een OpLog waarin alle wijzigingen worden opgeslagen - in dit geval zijn alle wijzigingen al sequentially ordered in de 'OpLog'. Maar als we twee verschillende shards hebben, is tijdsynchronisatie belangrijk. Hier hebben vector clocks meer geholpen! Maar we hebben ze niet.
De tweede optie is de 'Heartbeats'. Je kunt signalen uitwisselen die elke tijdseenheid plaatsvinden. Maar 'Heartbeats' zijn te traag; we kunnen de latency niet waarborgen voor onze klant.
True time is natuurlijk een prachtig iets. Maar, wederom, dat is waarschijnlijk de toekomst… Hoewel in 'Atlas' het al mogelijk is, zijn er al snelle 'Amazon' tijdssynchronisatoren. Maar dit zal niet voor iedereen beschikbaar zijn.
Gossiping is wanneer alle berichten tijd bevatten. Dit is ongeveer wat wij gebruiken. Elk bericht tussen nodes, drivers, router data-nodes, absoluut alles voor 'MongoDB' – dit zijn elementen, componenten van de database die tijd bevatten. Overal hebben ze een hybride tijdwaarde die wordt doorgegeven. 64 bits? Dat kan.
Hoe werkt dit allemaal samen?
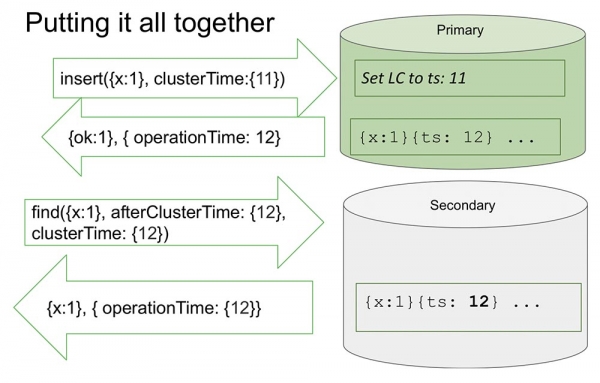
Hier bekijk ik één replica-set om het iets eenvoudiger te maken. Er is een Primary en een Secondary. De Secondary voert replicatie uit en is niet altijd volledig gesynchroniseerd met de Primary.
Er vindt een insert plaats in de 'Primary' met een bepaalde tijdwaarde. Deze insert verhoogt de interne teller met 11, als dit maximaal is. Of het controleert de tijdwaarden en synchroniseert op basis van de tijd, als de tijdwaarden hoger zijn. Dit stelt ons in staat om chronologisch te ordenen.
Nadat hij de schrijfactie uitvoert, vindt er een belangrijk moment plaats. De klokken in 'MongoDB' worden alleen verhoogd bij een schrijfactie in de 'OpLog'. Dit is het evenement dat de status van het systeem verandert. In al de klassieke artikelen wordt een gebeurtenis beschouwd als het bericht dat de node bereikt: als het bericht is ontvangen, betekent dit dat het systeem zijn status heeft veranderd.
Dit heeft te maken met het feit dat het moeilijk te begrijpen is hoe dit bericht zal worden geïnterpreteerd tijdens het onderzoek. We weten precies dat als het niet in de 'oplog' wordt weergegeven, het helemaal niet zal worden geïnterpreteerd, en de enige systeemstatuswijziging is een vermelding in de 'oplog'. Dit vereenvoudigt ons alles: het vereenvoudigt het model en stelt ons in staat om ordening te houden binnen één replica-set, en nog veel meer nuttigs.
De waarde die al in de 'oplog' is opgeslagen, wordt teruggegeven – we weten dat deze waarde in de 'oplog' ligt, en de tijd is 12. Laten we zeggen dat er nu wordt gelezen vanaf een andere node (Secondary), en deze geeft al de afterClusterTime in het bericht door. Hij zegt: 'Ik heb alles nodig wat er minimaal na 12 of op het moment van twaalf is gebeurd' (zie bovenstaande afbeelding).
Dit wordt Causal a consistent (CAT) genoemd. Er is een concept in de theorie dat dit een soort tijdslice is die consistent op zichzelf is. In dit geval kan je zeggen dat dit de systeemstatus is die was waargenomen op het tijdstip 12.
Op dit moment is hier nog niets, omdat dit een situatie simuleert waarin de Secondary gegevens van de Primary moet repliceren. Hij wacht... En hier zijn de gegevens – deze waarden worden teruggestuurd.
Zo werkt het ongeveer. Bijna.
Wat betekent 'bijna'? Laten we aannemen dat er een persoon is die heeft gelezen en begrepen hoe dit allemaal werkt. Hij begreep dat elke keer ClusterTime gebeurt, de interne logische klokken worden bijgewerkt, en dan verhoogt de volgende vermelding met één. Deze functie neemt 20 regels in beslag. Stel dat deze persoon het grootste mogelijke 64-bits getal, min één, doorgeeft.
Waarom 'min één'? Omdat de interne klokken in deze waarde worden geplaatst (dit is blijkbaar het grootste mogelijke getal en groter dan de huidige tijd), dan zal er een vermelding in de 'oplog' plaatsvinden, en de klokken worden nog eens met één verhoogd – en dan zal er eigenlijk de maximale waarde zijn (daar zijn gewoon allemaal enen, verder is er niets meer, unsaint int's).
Het is duidelijk dat het systeem daarna absoluut niet meer toegankelijk is voor iets. Je kunt het alleen maar ontladen, schoonmaken – veel handwerk. Volledige beschikbaarheid:
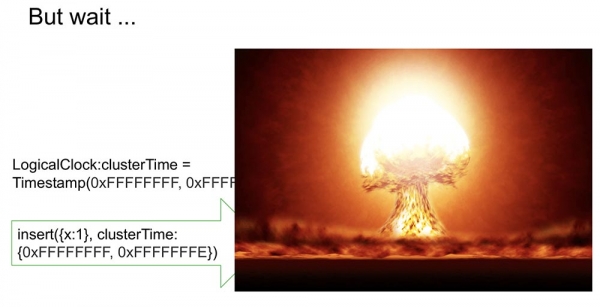
Als dit ergens anders wordt gerepliceerd, valt de hele cluster gewoon uit. Een absoluut onaanvaardbare situatie, die iedereen heel snel en eenvoudig kan veroorzaken! Daarom beschouwden we dit aspect als een van de belangrijkste. Hoe kunnen we dit voorkomen?
Onze aanpak is om clusterTime te ondertekenen.
Zo wordt het doorgegeven in het bericht (tot de blauwe tekst). Maar we zijn ook handtekeningen gaan genereren (blauwe tekst):
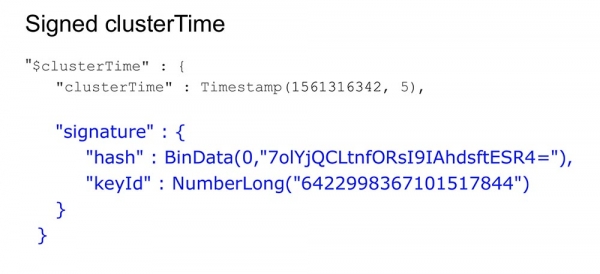
De handtekening wordt gegenereerd met een sleutel die zich binnen de database bevindt, binnen een beveiligd perimeter; deze wordt automatisch gegenereerd en bijgewerkt (gebruikers zien hier niets van). Een hash wordt gegenereerd en elk bericht wordt bij creatie ondertekend en bij ontvangst gevalideerd.
Mensen vragen zich misschien af: "Hoeveel vertraagt dit alles?" Ik heb gezegd dat het snel moet werken, vooral in de afwezigheid van deze functie.
Wat betekent het om Causal consistency in dit geval te gebruiken? Dit toont de afterClusterTime-parameter. Zonder dit wordt waarde gewoon in elk geval doorgestuurd. Gossiping werkt altijd sinds versie 3.6.
Als we constante generatie van handtekeningen toestaan, zal dit de systemen vertragen, zelfs zonder de functie, wat niet overeenkomt met onze principes en vereisten. Wat hebben we gedaan?
Doe het snel!
Een vrij eenvoudige zaak, maar een interessante truc – ik deel het, misschien is het interessant voor iemand.
We hebben een hash waarin ondertekende gegevens zijn opgeslagen. Alle gegevens gaan door een cache. De cache ondertekent niet specifiek de tijd, maar een Range. Wanneer een bepaalde waarde binnenkomt, genereren we een Range, maskeren de laatste 16 bits, en deze waarde ondertekenen we:
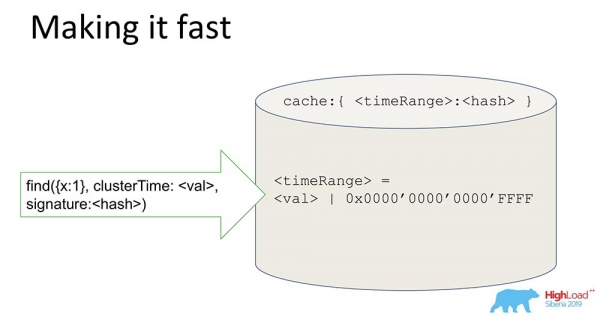
Met zo'n handtekening versnellen we het systeem (in feite) met 65 duizend keer. Het werkt geweldig: toen we experimenten uitvoerden, werd de tijd voor een opeenvolgende update echt met 10.000 keer verminderd. Het is duidelijk dat dit niet mogelijk is wanneer ze in wanorde zijn. Maar in de meeste praktische gevallen werkt het. De combinatie van de Range-handtekening met de handtekening hielp het veiligheidsprobleem op te lossen.
Wat hebben we geleerd?
Lessen die we hieruit hebben getrokken:
- Je moet materialen, verhalen en artikelen lezen, omdat we veel interessante dingen te delen hebben. Wanneer we aan een functie werken (vooral nu, toen we transacties hebben gedaan, enz.), is het nodig om te lezen en te begrijpen. Dit kost tijd, maar het is eigenlijk erg nuttig, omdat het duidelijk maakt waar we staan. We hebben niet echt iets nieuws uitgevonden - we hebben gewoon de ingrediënten genomen.
Er is een zekere verschillen in denken wanneer er een academische conferentie plaatsvindt (zoals 'Sigmon', bijvoorbeeld) - daar focussen mensen zich op nieuwe ideeën. Wat is de innovatie van ons algoritme? Hier is er eigenlijk niet veel nieuws. De nieuwigheid ligt eerder in hoe we bestaande benaderingen samen hebben gemengd. Daarom is het eerste wat moet worden gedaan, het lezen van de klassiekers, beginnend met Lamport.
- In productie zijn de eisen helemaal anders. Ik ben er zeker van dat velen van jullie niet te maken hebben met 'sferische' databases in een abstracte vacuum, maar met normale, realistische zaken, die problemen hebben met beschikbaarheid, latentie en fouttolerantie.
- Het laatste is dat we verschillende ideeën hebben moeten overwegen en verschillende artikelen hebben gecombineerd tot één benadering. Het idee van ondertekenen, bijvoorbeeld, kwam eigenlijk uit een artikel dat het Paxos-protocol behandelde, wat voor niet-bizantijnse falers binnen het autorisatieprotocol is, en voor bizantijnse - buiten het autorisatieprotocol... Over het algemeen, dat is precies wat we uiteindelijk hebben gedaan.
Er is absoluut niets nieuws aan! Maar zodra we alles samen hebben gemengd... Het is alsof je zegt dat het recept voor Olivier-salade onzin is, omdat eieren, mayo en komkommers al bestaan... Dit is ongeveer hetzelfde verhaal.
Ik zal hierbij afsluiten. Bedankt!
Vragen
Vraag uit de zaal (verder – V): – Dank je, Michail, voor de presentatie! Het onderwerp over tijd is interessant. Je gebruikt Gossiping. Je zei dat iedereen zijn eigen tijd heeft, iedereen kent zijn lokale tijd. Ik begreep dat we een driver hebben - er kunnen veel klanten met drivers zijn, er zijn ook veel query-planners, er zijn ook veel shards... Wat gebeurt er met het systeem als er plotseling een discrepantie optreedt: iemand denkt dat hij een minuut voorloopt, iemand denkt dat hij een minuut achterloopt? Waar komen we dan uit?
MT: – Dat is eigenlijk een uitstekende vraag! Ik wilde net iets zeggen over shards. Als ik de vraag goed begrijp, hebben we de situatie: er is shard 1 en shard 2, en de leesoperaties vinden plaats vanaf deze twee shards – ze divergeren, ze communiceren niet met elkaar, omdat de tijd die ze kennen – verschillend is, vooral de tijd die ze hebben in de oplogs.
Stel dat shard 1 een miljoen records heeft gemaakt, terwijl shard 2 – helemaal niets, en er komt een verzoek naar de twee shards. En de eerste heeft afterClusterTime van meer dan een miljoen. In zo'n situatie, zoals ik heb uitgelegd, zal shard 2 nooit reageren.
V: – Ik wilde weten hoe ze synchroniseren en één logische tijd selecteren?
MT: – Ze synchroniseren heel eenvoudig. Shard, wanneer het afterClusterTime ontvangt en geen tijd vindt in de ‘Oplog’ – initieert no approved. Dat betekent dat hij zelf zijn tijd verhoogt tot deze waarde. Dit betekent dat er geen gebeurtenissen zijn die aan dit verzoek voldoen. Hij creëert deze gebeurtenis kunstmatig en wordt zo Causal Consistent.
V: – En als er daarna nog evenementen komen die ergens in het netwerk zijn verloren?
MT: – Shards zijn zo ontworpen dat deze evenementen niet meer zullen komen, omdat het een single master is. Zodra hij heeft geschreven, komen ze niet meer aan, maar zullen ze later komen. Het kan niet zo zijn dat ergens iets vastzit, dan doet hij no write, en vervolgens komen deze gebeurtenissen aan – en wordt de Causal consistency verstoord. Wanneer hij no write doet, moeten ze allemaal daarna arriveren (hij zal op hen wachten).
V: – Ik heb een paar vragen over queues. Causal consistency gaat ervan uit dat er een bepaalde wachtrij van acties is die moeten worden uitgevoerd. Wat gebeurt er als een pakket verloren gaat? Dus de 10e, 11e… de 12e is verloren, terwijl alle andere wachten tot deze is uitgevoerd. En ineens gaat de machine kapot, we kunnen niets doen. Is er een maximale lengte van de wachtrij die zich ophoopt voordat deze wordt uitgevoerd? Wat voor fatale fout treedt er op bij het verlies van een bepaalde toestand? Bovendien, als we opschrijven dat er een bepaalde vorige toestand is, dan moeten we daar toch vanuit gaan? Maar dat deden we niet!
MT: – Ook dat is een prachtige vraag! Wat doen we? In MongoDB is er het concept van quorum records, quorum reading. In welke gevallen kan een bericht verloren gaan? Wanneer de opname niet quorum is of wanneer de leesoperatie niet quorum is (ook kan er wat garbage binnenkomen).
Met betrekking tot Causal consistency hebben we uitgebreide experimenten uitgevoerd, waarvan het resultaat was dat, wanneer de schrijf- en leesoperaties niet quorum zijn, er schendingen van Causal consistency optreden. Precies wat u zegt!
Ons advies: gebruik ten minste quorum-lezen bij het gebruik van Causal consistency. In dit geval zal er niets verloren gaan, zelfs niet als de quorum-schrijven verloren gaat... Dit is een orthogonale situatie: als de gebruiker niet wil dat gegevens verloren gaan, moet hij quorum-schrijven gebruiken. Causal consistency biedt geen garantie voor duurzaamheid. De garantie voor duurzaamheid biedt replicatie en de bijbehorende infrastructuur.
V: – Wanneer we een instance aanmaken die is geconfigureerd voor sharding (niet master, maar slave), steunt deze dan op de unix-tijd van zijn eigen machine of op de tijd van de 'master'; wordt dit één keer gesynchroniseerd of periodiek?
MT: – Laat het me verduidelijken. Een shard (dat wil zeggen, een horizontale partitie) heeft altijd een Primary. En binnen een shard kan er een 'master' zijn en kunnen er replicas zijn. Maar een shard ondersteunt altijd schrijven, omdat het een bepaald domein moet ondersteunen (er is een Primary in de shard).
V: – Dus alles hangt volledig af van de 'master'? Wordt er altijd 'master'-tijd gebruikt?
MT: – Ja. Je kunt het zo zeggen: de klokken tikken wanneer er een schrijfoperatie plaatsvindt in de 'master', in de 'Oplog'.
V: – We hebben een klant die zich verbindt, en hij hoeft niets te weten over tijd?
MT: – Helemaal niets! Als we het hebben over hoe dit werkt aan de klantzijde: de klant, wanneer hij gebruik wil maken van Causal consistency, moet een sessie openen. In deze sessie staan alle transacties en de rechten… Een sessie is een ordening van logische gebeurtenissen die plaatsvinden met de klant.
Als hij deze sessie opent en daarin aangeeft dat hij Causal consistency wil (als de sessie standaard Causal consistency ondersteunt), werkt alles automatisch. De driver onthoudt deze tijd en verhoogt deze wanneer er een nieuw bericht binnenkomt. Hij onthoudt welk antwoord de vorige keer van de server is teruggestuurd die de gegevens heeft geleverd. De volgende aanvraag bevat afterCluster ('tijd groter dan deze').
De klant hoeft echt helemaal niets te weten! Dit is totaal ondoorzichtig voor hem. Wat kunnen mensen met deze functies doen? Ten eerste, je kunt veilig lezen van secundaire databasetypes: je kunt schrijven naar de primaire database en lezen van geografisch gerepliceerde secundaires, en er zeker van zijn dat het werkt. Bovendien kunnen de sessies die op de primaire database zijn geschreven, zelfs naar de secundaire database worden overgedragen, dat wil zeggen dat je niet één sessie, maar meerdere kunt gebruiken.
V: – Het concept van Eventual consistency is nauw verbonden met een nieuw niveau van computerwetenschappen – de datatypes CRDT (Conflict-free Replicated Data Types). Hebben jullie de integratie van deze datatypes in de database overwogen en wat kunnen jullie daarover zeggen?
MT: – Goede vraag! CRDT is zinvol bij conflicten tijdens schrijven: in MongoDB – single master.
V: – Ik heb een vraag van de DevOps. In de huidige wereld komen er weleens van die jezuïetachtige situaties voor waarbij een Byzantijnse failure zich voordoet, en kwaadaardige mensen binnen de beveiligde perimeter beginnen muggen te steken in het protocol, door speciaal gemaakte pakketten te sturen?
MT: – Kwaadaardige mensen binnen de perimeter zijn net als een Trojan horse! Ze kunnen veel slechte dingen doen.
V: – Het is vanzelfsprekend dat je geen gaten in de server moet laten waardoor je een olifantenkudde kunt laten passeren en de hele cluster voor altijd kunt laten instorten… Herstel zal tijd kosten... Dit is zacht uitgedrukt, onjuist. Aan de andere kant is het interessant om te vragen: komen er in de echte wereld situaties voor waarin soortgelijke interne aanvallen plaatsvinden?
MT: – Aangezien ik niet vaak geconfronteerd word met beveiligingslekken in het echte leven, kan ik het niet zeggen – misschien komen ze wel voor. Maar als we het hebben over ontwikkelingsfilosofie, dan beschouwen we het zo: we hebben een perimeter die de jongens die security doen beschermt – dat is het slot, de muur; en binnen de perimeter kun je doen wat je wilt. Het is duidelijk dat er gebruikers zijn die alleen kunnen kijken, en er zijn gebruikers die de catalogus kunnen wissen.
Afhankelijk van de rechten kan de schade die gebruikers kunnen aanrichten variëren van een muis tot een olifant. Uiteraard kan een gebruiker met volledige rechten alles doen wat hij wil. Een gebruiker met beperkte rechten kan aanzienlijk minder schade aanrichten. Hij kan in het bijzonder het systeem niet breken.
V: – Binnen de beveiligde perimeter zijn er mensen die onverwachte protocollen voor de server proberen te creëren, om de server vast te zetten, en als je geluk hebt, misschien zelfs de hele cluster... Is dat echt zo "goed"?
MT: – Ik heb nog nooit van zulke dingen gehoord. Het is geen geheim dat je op deze manier een server kunt uitvallen. Het is niet mogelijk om dit intern te doen, terwijl je geverifieerd bent als gebruiker die iets in een bericht kan schrijven... In werkelijkheid kan dat niet, want het moet nog steeds worden geverifieerd. Er is een mogelijkheid om deze authenticatie uit te schakelen voor gebruikers die dat niet willen - dat is dan hun probleem; ze hebben, grof gezegd, zelf de muren verwoest en je kunt er een olifant in proppen die alles verplettert... Maar in feite kun je je als monteur verkleden, komen en het eruit trekken!
V: – Bedankt voor de presentatie. Sergey ("Yandex"). In "Mongo" is er een constante die het aantal stemgerechtigde leden in de Replica Set limiteert, en deze constante is gelijk aan 7 (zeven). Waarom is dit een constante? Waarom is dit geen parameter of zoiets?
MT: – In een Replica Set kunnen we ook wel niet-stemgerechtigde leden draaien, maar stemgerechtigden – maximaal 7. Hoe ga je in dit geval om met een uitval, als onze Replica Set verspreid is over 3 datacentra? Eén datacentrum kan makkelijk uitvallen, en nog een andere machine kan eruit vallen.
V: – Dit valt al een beetje buiten de presentatie. Dit is een algemene vraag. Misschien kan ik het later uitleggen.
MT: De volgende HighLoad++ conferentie vindt plaats op 6 en 7 april 2020 in St. Petersburg. Details en tickets via de link.
Een beetje reclame 🙂
Bedankt dat je bij ons blijft. Houd je van onze artikelen? Wil je meer interessante inhoud zien? Ondersteun ons door een bestelling te plaatsen of ons aan vrienden aan te bevelen, , een unieke variant van entry-level servers, die we voor jou hebben bedacht: (opties beschikbaar met RAID1 en RAID10, tot 24 cores en tot 40GB DDR4).
Dell R730xd is 2 keer goedkoper in datacenter Equinix Tier IV in Amsterdam? Alleen bij ons in Nederland! Dell R420 — 2x E5-2430 2.2Ghz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — vanaf $99! Lees over hoe
Bron: habr.com
