

Zoals in , er was een probleem met de gedistribueerde dienst, laten we deze dienst Alvin noemen. Dit keer heb ik het probleem niet zelf ontdekt, de jongens van de klantzijde hebben me ingelicht.
Op een dag werd ik wakker van een ontevreden brief over grote vertragingen bij Alvin, die we van plan waren binnenkort te lanceren. In het bijzonder had de klant te maken met een vertraging van het 99e-percentiel rond de 50 ms, wat veel hoger was dan onze vertragingbudget. Het was verbazingwekkend, aangezien ik de dienst zorgvuldig had getest, vooral op vertragingen, want dat is een veelgehoorde klacht.
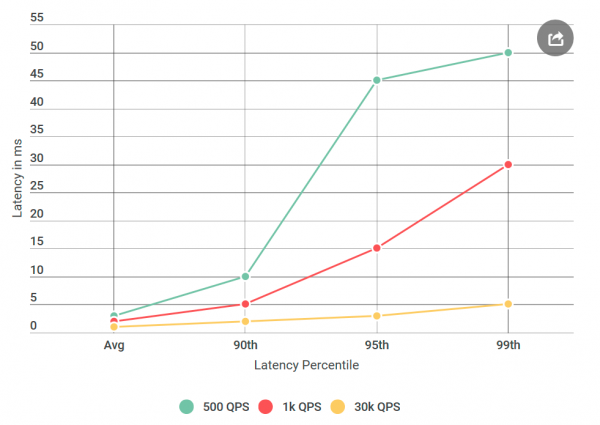
Voordat ik Alvin voor testen gaf, heb ik veel tests uitgevoerd met 40.000 verzoeken per seconde (QPS), en al deze toonden een vertraging van minder dan 10 ms. Ik was bereid te beweren dat ik het niet eens was met hun resultaten. Maar een seconde keer naar de brief kijkend, viel me iets op: ik had de omstandigheden die zij noemden, niet precies getest, hun QPS was veel lager dan de mijne. Ik testte op 40k QPS, terwijl zij alleen op 1k. Ik voerde nog een experiment uit, dit keer met een lagere QPS, gewoon om hen te plezieren.
Aangezien ik hieraan schrijf in de blog - waarschijnlijk hebben jullie het al door: hun cijfers bleken juist te zijn. Ik controleerde mijn virtuele klant opnieuw en opnieuw, met steeds hetzelfde resultaat: een laag aantal verzoeken verhoogt niet alleen de vertraging, maar verhoogt ook het aantal verzoeken met een vertraging van meer dan 10 ms. Met andere woorden, als bij 40k QPS ongeveer 50 verzoeken per seconde meer dan 50 ms overschreden, dan waren dat bij 1k QPS elke seconde 100 verzoeken hoger dan 50 ms. Paradox!
De zoekopdracht verfijnen
Bij het tegenkomen van een vertragingprobleem in een gedistribueerd systeem met veel componenten, is het eerste wat je moet doen een korte lijst van verdachten opstellen. Laten we wat dieper ingaan op de architectuur van Alvin:
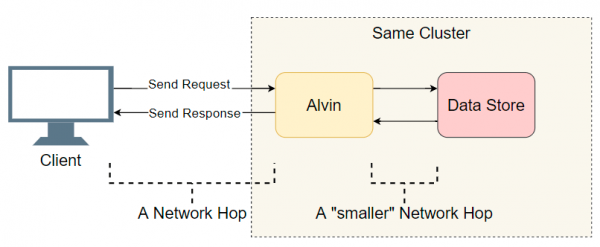
Een goede start is de lijst van uitgevoerde input-output-overgangen (netwerkoproepen/schijfzoekopdrachten, enz.). Laten we proberen uit te zoeken waar de vertraging ligt. Naast het voor de hand liggende input-output met de klant, maakt Alvin een extra stap: hij draait naar de data-opslag. Echter, deze opslag werkt in hetzelfde cluster als Alvin, dus daar zou de vertraging lager moeten zijn dan met de klant. Dus, de lijst van verdachten:
- Netwerkoproep van de klant naar Alvin.
- Netwerkoproep van Alvin naar de data-opslag.
- Zoeken op schijf in de data-opslag.
- Netwerkoproep vanuit de gegevensopslag naar Elvin.
- Netwerkoproep van Elvin naar de klant.
Laten we proberen enkele punten te schrappen.
De gegevensopslag is niet relevant.
Als eerste heb ik Elvin omgevormd tot een ping-ping server die geen verzoeken verwerkt. Wanneer het een verzoek ontvangt, retourneert het een leeg antwoord. Als de vertraging afneemt, dan wijst dat op een fout in de implementatie van Elvin of de gegevensopslag – niets ongehoords. In het eerste experiment krijgen we de volgende grafiek:
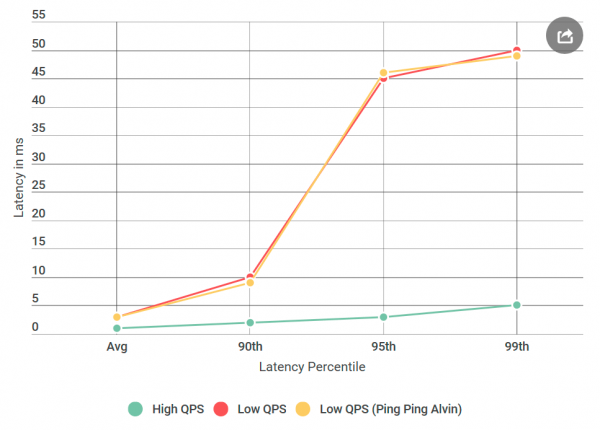
Zoals we zien, zijn er geen verbeteringen bij het gebruik van de ping-ping server. Dit betekent dat de gegevensopslag de vertraging niet verhoogt, en de lijst met verdachten wordt gehalveerd:
- Netwerkoproep van de klant naar Alvin.
- Netwerkoproep van Elvin naar de klant.
Geweldig! De lijst krimpt snel. Ik dacht dat ik de oorzaak bijna had ontdekt.
gRPC
Het is nu tijd om jullie een nieuwe speler voor te stellen: . Dit is een open-source bibliotheek van Google voor inter-process communicatie. . Hoewel gRPC goed is geoptimaliseerd en veel wordt gebruikt, heb ik het voor het eerst gebruikt in een systeem van deze omvang, en ik verwachtte dat mijn implementatie – om het zachtjes uit te drukken – suboptimaal zou zijn.
Aanwezigheid gRPC in de stack heeft een nieuwe vraag opgeworpen: zou dit mijn implementatie of de bibliotheek zelf gRPC de vertraging veroorzaken? We voegen een nieuwe verdachte toe aan de lijst:
- De client roept de bibliotheek
gRPC - Bibliotheek
gRPCaan de client voert een netwerkoproep uit naar de bibliotheekgRPCop de server - Bibliotheek
gRPCroept Elvin aan (er is geen operatie in het geval van de ping-pong server).
Om je een idee te geven van hoe de code eruitziet, verschilt mijn implementatie van de client/Elvin niet veel van client-server .
Opmerking: de bovenstaande lijst is enigszins vereenvoudigd, aangezien
gRPCde mogelijkheid biedt om een eigen (sjabloon?) threadmodel te gebruiken, waarin de uitvoeringsstackgRPCen de gebruikersimplementatie met elkaar verweven zijn. Voor de eenvoud houden we ons aan dit model.
Profilering lost alles op.
Door de gegevensopslag te schrappen, dacht ik dat ik bijna klaar was: ‘Nu is het gemakkelijk! We passen een profiel toe en ontdekken waar de vertraging ontstaat.’ Ik omdat CPU's zeer snel zijn en vaak geen knelpunt vormen. De meeste vertragingen treden op wanneer de processor moet stoppen met verwerken om iets anders te doen. Nauwkeurige profiling van de CPU is precies hiervoor bedoeld: het legt nauwkeurig alle en geeft aan waar de vertragingen ontstaan.
Ik nam vier profielen: voor hoge QPS (lage latentie) en met een ping-pongserver op lage QPS (hoge latentie), zowel aan de klant- als serverkant. En voor de zekerheid nam ik ook een monster van het procesprofiel. Bij het vergelijken van profielen zoek ik meestal naar afwijkende call stacks. Bijvoorbeeld, aan de slechte kant met hoge latentie zijn er veel meer contextswitches (met 10 keer of meer). Maar in mijn geval was het aantal contextswitches praktisch gelijk. Tot mijn grote ontzetting bleek er niets wezenlijks te zijn.
Aanvullende foutopsporing
Ik was wanhopig. Ik wist niet welke andere tools ik kon gebruiken en mijn volgende plan bestond eigenlijk uit het herhalen van experimenten met verschillende variaties, in plaats van het probleem nauwkeurig te diagnosticeren.
Wat als
Vanaf het begin maakte een specifieke latentie van 50 ms me zorgen. Dat is een erg lange tijd. Ik besloot stukken uit de code te knippen totdat ik precies kon uitzoeken welk deel deze fout veroorzaakte. Daarna volgde een experiment dat werkte.
Achteraf lijkt het altijd vanzelfsprekend. Ik plaatste de klant op één machine met Elvin – en stuurde een verzoek naar localhost. En de toegenomen latentie verdween!
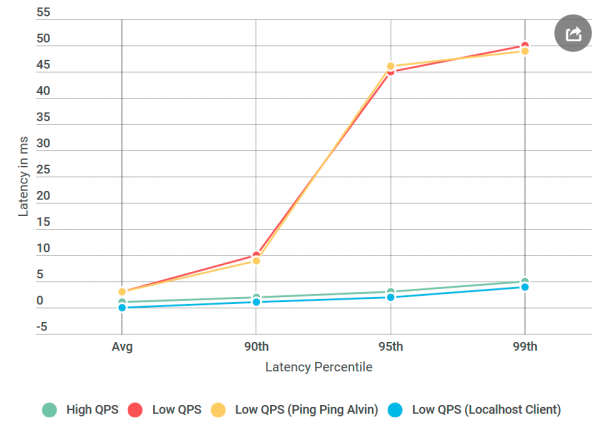
Er was iets mis met het netwerk.
Vaardigheden van een netwerk engineer ontwikkelen
Ik moet bekennen: mijn kennis van netwerktechnologieën is verschrikkelijk, vooral gezien het feit dat ik er dagelijks mee werk. Maar het netwerk was de belangrijkste verdachte en ik moest leren hoe ik het kon debuggen.
Gelukkig houdt het internet van degenen die willen leren. Een combinatie van ping en tracert leek een goed begin voor het debuggen van netwerktransportproblemen.
Ten eerste startte ik op de TCP-poort van Elvin. Ik gebruikte de standaardinstellingen – niets bijzonders. Van meer dan duizend pings overschreed er geen enkele 10 ms, behalve de eerste voor opwarming. Dit staat in contrast met de waargenomen latentie van 50 ms in het 99ste percentiel: daar zouden we voor elke 100 verzoeken ongeveer één verzoek met een latentie van 50 ms moeten zien.
Vervolgens probeerde ik : misschien ligt het probleem bij een van de knooppunten op de route tussen Elvin en de klant. Maar ook tracert kwam met lege handen terug.
Dus was de oorzaak van de latentie niet mijn code, niet de implementatie van gRPC en niet het netwerk. Ik begon me al zorgen te maken dat ik het nooit zou begrijpen.
En op welk besturingssysteem bevinden we ons nu?
gRPC Het wordt veel gebruikt in Linux, maar voor Windows is het exotisch. Ik besloot een experiment uit te voeren dat lukte: ik creëerde een virtuele Linux-machine, compileerde Elvin voor Linux en implementeerde deze.
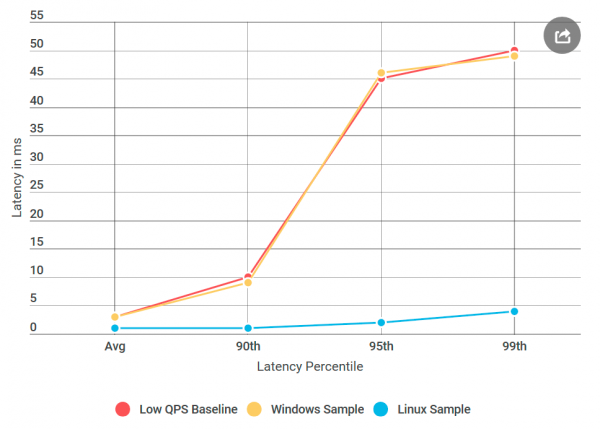
En dit is wat er gebeurde: op de ping-pongserver in Linux waren er geen vertragingen zoals op een vergelijkbare Windows-node, hoewel de gegevensbron niet verschilden. Het probleem bleek te liggen in de implementatie van gRPC voor Windows.
Het Nagle-algoritme
Gedurende al die tijd dacht ik dat ik de vlag miste. gRPCNu begrijp ik dat het eigenlijk in gRPC de Windows-vlag ontbreekt. Ik vond een interne RPC-bibliotheek waarvan ik zeker was dat deze goed werkte voor alle gevestigde vlaggen. Vervolgens heb ik al deze vlaggen aan gRPC toegevoegd en Elvin op Windows geïmplementeerd, op de gecorrigeerde ping-pongserver onder Windows!
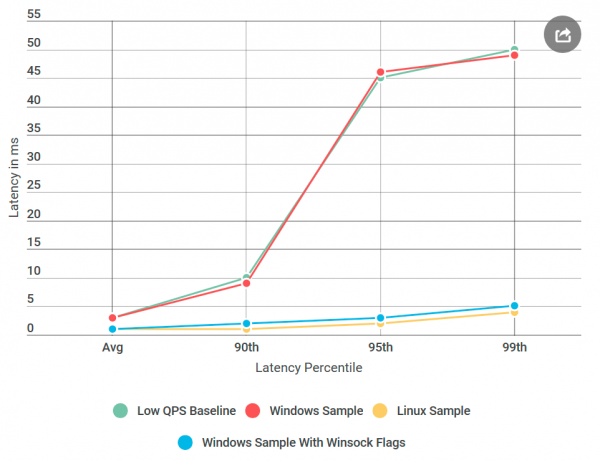
Bijna klaar: ik begon de toegevoegde vlaggen één voor één te verwijderen totdat de regressie terugkwam, zodat ik de oorzaak precies kon bepalen. Het was de beruchte , schakelaar van het Nagle-algoritme.
probeert het aantal verzonden pakketten over het netwerk te verminderen door de overdracht van berichten uit te stellen totdat de pakketsgrootte een bepaald aantal bytes overschrijdt. Hoewel dit prettig kan zijn voor de gemiddelde gebruiker, kan het destructief zijn voor real-time servers, aangezien het besturingssysteem bepaalde berichten zal vertragen, wat vertragingen op lage QPS veroorzaakt. Bij gRPC was deze vlag ingesteld in de Linux-implementatie voor TCP-sockets, maar niet voor Windows. Dit heb ik .
Conclusie
Een grote vertraging op lage QPS werd veroorzaakt door optimalisatie van het besturingssysteem. Achteraf gezien werd de vertraging niet ontdekt tijdens het profileren, omdat dit in de kernelmodus plaatsvond en niet in de Ik weet niet of je het Nagle-algoritme kunt waarnemen via ETW-captures, maar dat zou interessant zijn.
Wat het localhost-experiment betreft, deze betrof waarschijnlijk de feitelijke netwerkkode niet en het Nagle-algoritme werd niet geactiveerd, dus de problemen met vertraging verdwenen toen de client Elvin via localhost aanriep.
De volgende keer dat je een toename van de vertraging bij een afname van het aantal verzoeken per seconde ziet, zou het Nagle-algoritme op je lijst van verdachten moeten staan!
Bron: habr.com
