

Hallo, Habr!
Hou je van vliegen met vliegtuigen? Ik ben er dol op, maar tijdens de zelfisolatie ben ik ook gaan houden van het analyseren van gegevens over vliegtickets van een bekende bron — Aviasales.
Vandaag gaan we de werking van Amazon Kinesis bespreken, zullen we een streaming systeem opzetten met real-time analytics, een NoSQL database Amazon DynamoDB instellen als de belangrijkste gegevensopslag en meldingen via SMS configureren voor interessante tickets.
Alle details vind je hieronder! Laten we gaan!
Inleiding
Voor ons voorbeeld hebben we toegang nodig tot . Toegang is gratis en zonder beperkingen, je moet je alleen registreren in het gedeelte ‘Ontwikkelaars’ om je API-token voor gegevensaccess te verkrijgen.
Het belangrijkste doel van dit artikel is om een algemeen begrip te geven van het gebruik van informatie streaming in AWS. We sluiten daarbij uit dat de gegevens die door de gebruikte API worden geretourneerd strikt actueel zijn en worden verzonden vanuit een cache die is opgebouwd op basis van zoekopdrachten van gebruikers van de websites Aviasales.nl en Jetradar.com van de afgelopen 48 uur.
Gegevens over vliegtickets die via de API zijn verkregen, zullen door Kinesis-agent, dat is geïnstalleerd op de producer-machine, automatisch worden geparsed en naar de juiste stroom worden verzonden via Kinesis Data Analytics. De ruwe versie van deze stroom wordt rechtstreeks in de opslag geschreven. De in DynamoDB opgezet opslag van 'ruwe' gegevens zal een diepere analyse van tickets mogelijk maken via BI-tools, zoals AWS QuickSight.
We bekijken twee varianten voor het uitrollen van de hele infrastructuur:
- Handmatig — via de AWS Management Console;
- Infrastructuur vanuit Terraform-code — voor luie automatiseringsliefhebbers;
Architectuur van het ontwikkelde systeem
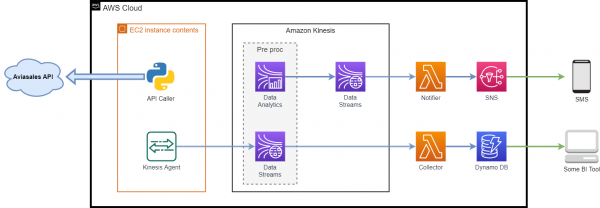
Gebruikte componenten:
- — de gegevens die door deze API worden geretourneerd, zullen worden gebruikt voor al het verdere werk;
- — een gewone virtuele machine in de cloud, waarop de inkomende gegevensstroom zal worden gegenereerd:
- — dit is een Java-applicatie die lokaal op de machine wordt geïnstalleerd en die een eenvoudige manier biedt om gegevens te verzamelen en naar Kinesis te verzenden (Kinesis Data Streams of Kinesis Firehose). De agent houdt voortdurend toezicht op een set bestanden in de opgegeven mappen en verzendt nieuwe gegevens naar Kinesis;
- — een Python-script dat verzoeken naar de API doet en het antwoord in een map plaatst die door Kinesis Agent wordt gemonitord;
- — een real-time datastreamingdienst met uitgebreide schaalmogelijkheden;
- — een serverloze service die de analyse van streaminggegevens in realtime vereenvoudigt. Amazon Kinesis Data Analytics configureert de middelen voor applicatie- werking en schaalt automatisch op voor de verwerking van elke hoeveelheid inkomende gegevens;
- — een service waarmee je code kunt uitvoeren zonder servers te reserveren of in te stellen. Alle rekencapaciteiten schalen automatisch onder elke oproep;
- — een database van paren "sleutel-waarde" en documenten die minder dan 10 milliseconden latentie biedt bij gebruik op elke schaal. Bij het gebruik van DynamoDB is het niet nodig om servers te distribueren, patches te installeren of ze te beheren. DynamoDB schaalt automatisch de tabellen door de hoeveelheid beschikbare middelen aan te passen en een hoge prestaties te behouden. Geen systeembeheeracties zijn vereist;
- — een volledig beheerde berichtenservice op basis van het ‘publish-subscribe’ (Pub/Sub) model, waarmee microservices, gedistribueerde systemen en serverloze applicaties geïsoleerd kunnen worden. SNS kan worden gebruikt om informatie naar eindgebruikers te verzenden via mobiele pushmeldingen, sms-berichten en e-mails.
Initiële voorbereiding
Voor het emuleren van de gegevensstroom besloot ik informatie over vliegtickets te gebruiken, die door de API van Aviasales wordt teruggegeven. In een vrij uitgebreide lijst van verschillende methoden, zullen we er een nemen — ‘Prijs kalendaris voor de maand’, die prijzen voor elke dag van de maand retourneert, gegroepeerd op het aantal overstappen. Als er geen zoekmaand in de aanvraag wordt doorgegeven, wordt informatie voor de volgende maand na de huidige weergegeven.
Dus, we registreren ons en ontvangen onze token.
Hieronder een voorbeeld van de aanvraag:
http://api.travelpayouts.com/v2/prices/month-matrix?currency=rub&origin=LED&destination=HKT&show_to_affiliates=true&token=TOKEN_APIDe hierboven beschreven manier om gegevens van de API te verkrijgen met de aangegeven token in de aanvraag zal werken, maar ik geef de voorkeur aan het doorgeven van de toegangstoken via de header, dus in het script api_caller.py zullen we deze methode gebruiken.
Voorbeeld van een antwoord:
{{
   "success":true,
   "data":[{
      "show_to_affiliates":true,
      "trip_class":0,
      "origin":"LED",
      "destination":"HKT",
      "depart_date":"2015-10-01",
      "return_date":"",
      "number_of_changes":1,
      "value":29127,
      "found_at":"2015-09-24T00:06:12+04:00",
      "distance":8015,
      "actual":true
   }]
}
In het hierboven weergegeven API-responsvoorbeeld wordt een ticket van Sint-Petersburg naar Phuket getoond… Och, wat dromen...
Aangezien ik uit Kazan kom en Phuket op dit moment ‘een verre droom’ is, laten we tickets zoeken van Sint-Petersburg naar Kazan.
Er wordt vanuit gegaan dat je al een account hebt bij AWS. Ik wil benadrukken dat Kinesis en het versturen van meldingen via SMS niet zijn inbegrepen bij het jaarlijkse . Maar zelfs hiermee in gedachten, is het heel goed mogelijk om het voorgestelde systeem op te zetten en er mee te experimenteren. En vergeet vooral niet om alle bronnen te verwijderen wanneer ze niet meer nodig zijn.
Gelukkig zullen DynamoDB en lambda-functies voor ons voorwaardelijk gratis zijn, mits we ons aan de maandelijkse gratis limieten houden. Voor DynamoDB bijvoorbeeld: 25 GB opslag, 25 WCU/RCU en 100 miljoen aanvragen. En een miljoen aanroepen van lambda-functies per maand.
Handmatige implementatie van het systeem
Configuratie van Kinesis Data Streams
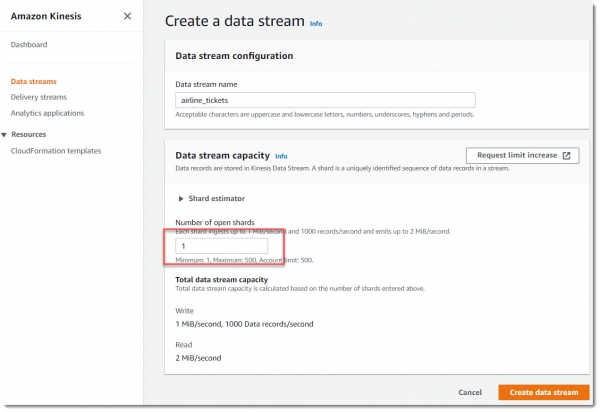
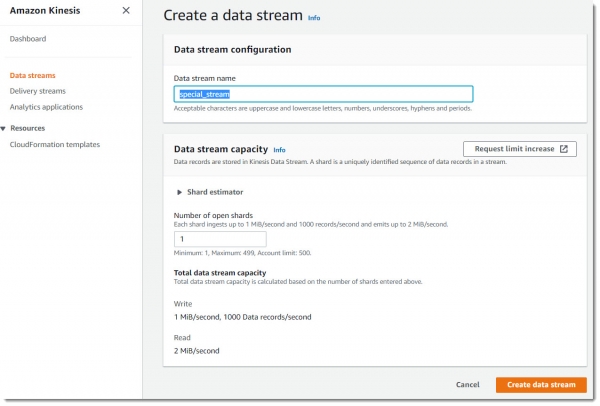
Laten we naar de Kinesis Data Streams-service gaan en twee nieuwe streams aanmaken met elk één shard.
Wat is een shard?
Een shard is de belangrijkste eenheid voor gegevensoverdracht in de Amazon Kinesis-stroom. Eén segment zorgt voor de overdracht van inkomende gegevens met een snelheid van 1 MB/s en de overdracht van uitgangsgegevens met een snelheid van 2 MB/s. Eén segment ondersteunt tot 1000 PUT-records per seconde. Bij het maken van een gegevensstroom moet je het gewenste aantal segmenten opgeven. Je kunt bijvoorbeeld een gegevensstroom aanmaken met twee segmenten. Deze gegevensstroom zorgt voor de overdracht van inkomende gegevens met een snelheid van 2 MB/s en de overdracht van uitgangsgegevens met een snelheid van 4 MB/s, met support voor tot 2000 PUT-records per seconde.
Hoe meer shards er in jouw stroom zijn, hoe groter de throughput. In principe schalen stromen op deze manier - door het toevoegen van shards. Maar hoe meer shards je hebt, hoe hoger de prijs. Elke shard kost 1,5 cent per uur en bovendien 1,4 cent voor elke miljoen toevoegingen aan de stroom (PUT payload units).
Laten we een nieuwe stroom aanmaken met de naam airline_tickets, één shard is daarin voldoende:
Laten we nu een andere stroom aanmaken met de naam special_stream:
Configuratie van de producer
Als data producer voor het ontleden van de taak volstaat een gewone EC2-instantie. Het hoeft geen krachtige dure virtuele machine te zijn; een spottender t2.micro is meer dan voldoende.
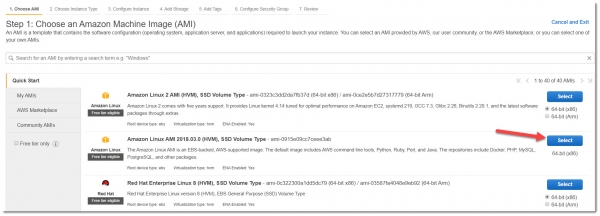
Belangrijke opmerking: voor het voorbeeld moet je image - Amazon Linux AMI 2018.03.0 gebruiken, dit heeft minder configuraties nodig voor een snelle uitvoering van Kinesis Agent.
Laten we naar de EC2-service gaan, een nieuwe virtuele machine aanmaken en de gewenste AMI kiezen met het type t2.micro, dat onder de Free Tier valt:
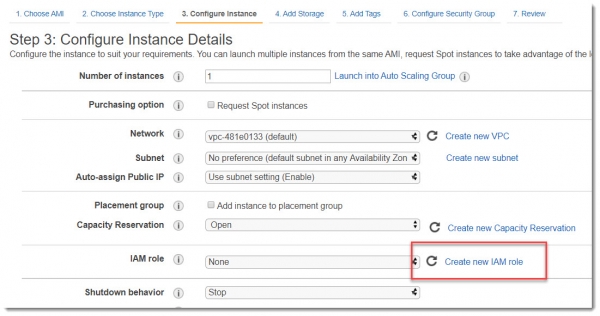
Om ervoor te zorgen dat de nieuw aangemaakte virtuele machine kan communiceren met de Kinesis-service, moeten we haar hiervoor rechten geven. De beste manier om dit te doen is door een IAM Role toe te wijzen. Dus, op het scherm Stap 3: Configureer Instantie Details, selecteer Maak nieuwe IAM Role aan:
IAM rol aanmaken voor EC2
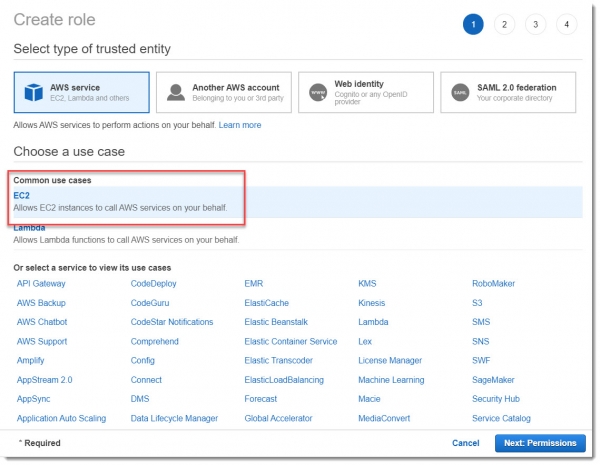
In het geopende venster kiezen we dat we een nieuwe rol voor EC2 aanmaken en gaan we naar het gedeelte Machtigingen:
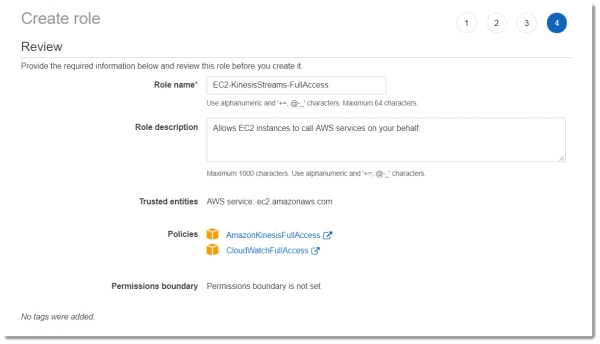
In dit lesvoorbeeld hoeven we niet in detail in te gaan op de granulaire instelopties voor resource-rechten, dus kiezen we voor de vooraf geconfigureerde beleidsregels van Amazon: AmazonKinesisFullAccess en CloudWatchFullAccess.
Laten we de rol een betekenisvolle naam geven, bijvoorbeeld: EC2-KinesisStreams-FullAccess. Het resultaat zou hetzelfde moeten zijn als dat op de afbeelding hieronder:
Vergeet na het aanmaken van deze nieuwe rol niet om deze aan de aan te maken instantie van de virtuele machine toe te voegen:
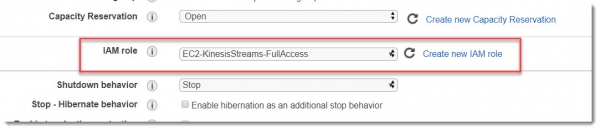
We veranderen niets meer op dit scherm en gaan verder naar de volgende vensters.
De schijfopties kunnen standaard blijven, en tags ook (hoewel het goede praktijk is om tags te gebruiken, bijvoorbeeld door de instantie een naam te geven en de omgeving aan te geven).
Nu zijn we op het tabblad Stap 6: Configureer Beveiligingsgroep, waar we een nieuwe moeten aanmaken of een bestaande Security group moeten aanwijzen die verbinding via ssh (poort 22) met de instantie toestaat. Kies daar Source -> Mijn IP en je kunt de instantie starten.
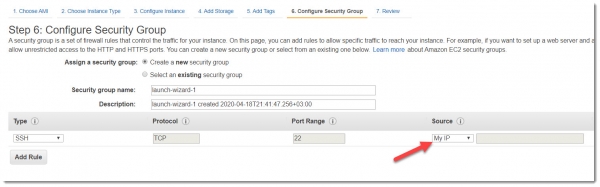
Zodra hij de status running bereikt, kun je proberen verbinding te maken via ssh.
Om met de Kinesis Agent te kunnen werken, moet je na een succesvolle verbinding met de machine de volgende commando's in de terminal invoeren:
sudo yum -y update
sudo yum install -y python36 python36-pip
sudo /usr/bin/pip-3.6 install --upgrade pip
sudo yum install -y aws-kinesis-agent
Laten we een map aanmaken om de API-responsen op te slaan:
sudo mkdir /var/log/airline_ticketsVoordat we de agent starten, moeten we de configuratie instellen:
sudo vim /etc/aws-kinesis/agent.jsonDe inhoud van het bestand agent.json moet er als volgt uitzien:
{
  "cloudwatch.emitMetrics": true,
  "kinesis.endpoint": "",
  "firehose.endpoint": "",

  "flows": [
    {
      "filePattern": "/var/log/airline_tickets/*log",
      "kinesisStream": "airline_tickets",
      "partitionKeyOption": "RANDOM",
      "dataProcessingOptions": [
         {
            "optionName": "CSVTOJSON",
            "customFieldNames": ["cost","trip_class","show_to_affiliates",
                "return_date","origin","number_of_changes","gate","found_at",
                "duration","distance","destination","depart_date","actual","record_id"]
         }
      ]
    }
  ]
}
Zoals te zien is in het configuratiebestand, zal de agent in de directory /var/log/airline_tickets/ bestanden met de extensie .log monitoren, deze parseren en doorgeven aan de stroom airline_tickets.
Laten we de service opnieuw starten en controleren of deze is opgestart en werkt:
sudo service aws-kinesis-agent restartLaten we nu het Python-script downloaden dat gegevens opvraagt bij de API:
REPO_PATH=https://raw.githubusercontent.com/igorgorbenko/aviasales_kinesis/master/producer

wget $REPO_PATH/api_caller.py -P /home/ec2-user/
wget $REPO_PATH/requirements.txt -P /home/ec2-user/
sudo chmod a+x /home/ec2-user/api_caller.py
sudo /usr/local/bin/pip3 install -r /home/ec2-user/requirements.txt
Het script api_caller.py vraagt gegevens aan bij Aviasales en slaat het ontvangen antwoord op in de directory die de Kinesis-agent scant. De implementatie van dit script is redelijk standaard, er is een klasse TicketsApi, die het mogelijk maakt om de API asynchroon te raadplegen. We geven deze klasse een koptekst met de token en de parameters van de aanvraag door:
class TicketsApi:
    """Api caller class."""

    def __init__(self, headers):
        """Init method."""
        self.base_url = BASE_URL
        self.headers = headers

    async def get_data(self, data):
        """Get the data from API query."""
        response_json = {}
        async with ClientSession(headers=self.headers) as session:
            try:
                response = await session.get(self.base_url, data=data)
                response.raise_for_status()
                LOGGER.info('Response status %s: %s',
                            self.base_url, response.status)
                response_json = await response.json()
            except HTTPError as http_err:
                LOGGER.error('Oops! HTTP error occurred: %s', str(http_err))
            except Exception as err:
                LOGGER.error('Oops! An error occurred: %s', str(err))
            return response_json


def prepare_request(api_token):
    """Return the headers and query for the API request."""
    headers = {'X-Access-Token': api_token,
               'Accept-Encoding': 'gzip'}

    data = FormData()
    data.add_field('currency', CURRENCY)
    data.add_field('origin', ORIGIN)
    data.add_field('destination', DESTINATION)
    data.add_field('show_to_affiliates', SHOW_TO_AFFILIATES)
    data.add_field('trip_duration', TRIP_DURATION)
    return headers, data


async def main():
    """Get run the code."""
    if len(sys.argv) != 2:
        print('Usage: api_caller.py ')
        sys.exit(1)
        return
    api_token = sys.argv[1]
    headers, data = prepare_request(api_token)

    api = TicketsApi(headers)
    response = await api.get_data(data)
    if response.get('success', None):
        LOGGER.info('API has returned %s items', len(response['data']))
        try:
            count_rows = log_maker(response)
            LOGGER.info('%s rows have been saved into %s',
                        count_rows,
                        TARGET_FILE)
        except Exception as e:
            LOGGER.error('Oops! Request result was not saved to file. %s',
                         str(e))
    else:
        LOGGER.error('Oops! API request was unsuccessful %s!', response)
Voor het testen van de juistheid van de instellingen en de werking van de agent, zullen we een teststart van het script api_caller.py uitvoeren:
sudo ./api_caller.py TOKEN 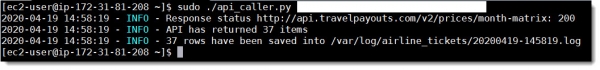
En we bekijken het resultaat van de werking in de logs van de Agent en op het tabblad Monitoring in de datastroom airline_tickets:
tail -f /var/log/aws-kinesis-agent/aws-kinesis-agent.log 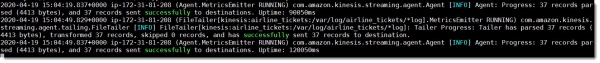
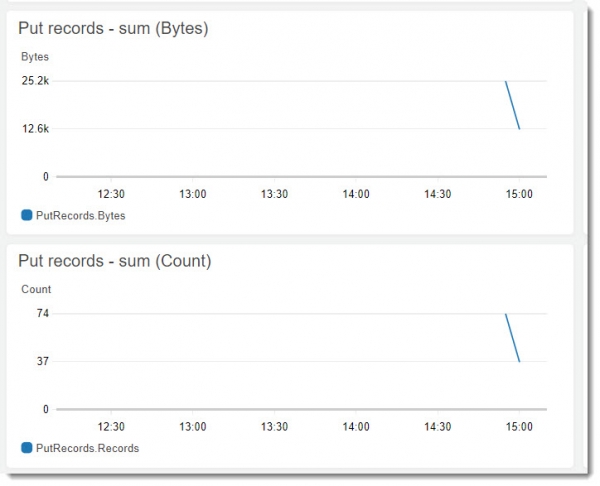
Zoals te zien is, werkt alles en verstuurt de Kinesis Agent succesvol gegevens naar de stream. Laten we de consumer instellen.
Configuratie van Kinesis Data Analytics
Laten we naar de centrale component van het hele systeem gaan — we gaan een nieuwe applicatie aanmaken in Kinesis Data Analytics met de naam kinesis_analytics_airlines_app:
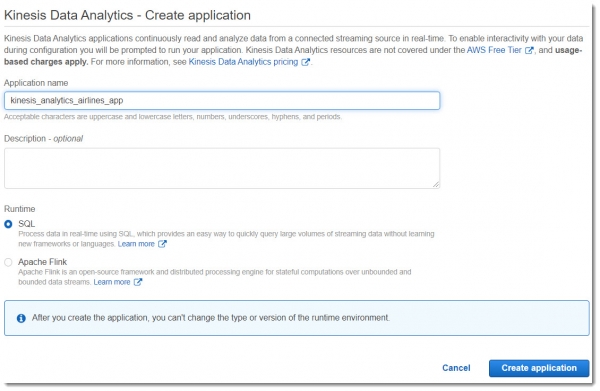
Kinesis Data Analytics stelt u in staat om realtime gegevensanalyse uit Kinesis Streams uit te voeren met behulp van SQL. Het is een volledig autoschaalbare service (in tegenstelling tot Kinesis Streams), die:
- het mogelijk maakt om nieuwe streams (Output Stream) te creëren op basis van aanvragen naar de brondatasets;
- een foutstream biedt, waarin fouten die tijdens de werking van de applicaties zijn opgetreden worden weergegeven (Error Stream);
- automatisch de indeling van inkomende gegevens kan bepalen (deze kan indien nodig handmatig worden overschreven).
Het is geen goedkope service — 0,11 USD per uur, dus gebruik het zorgvuldig en verwijder het na afloop.
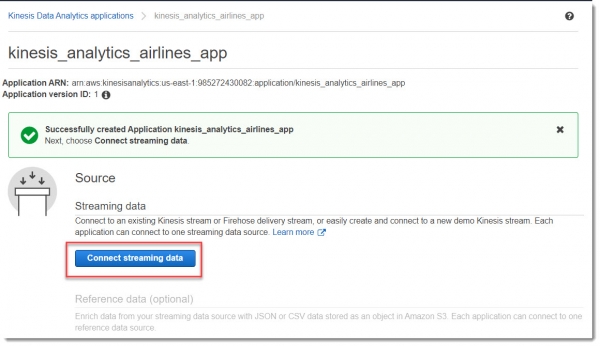
Laten we de applicatie verbinden met de gegevensbron:
We kiezen de stream waarmee we willen verbinden (airline_tickets):
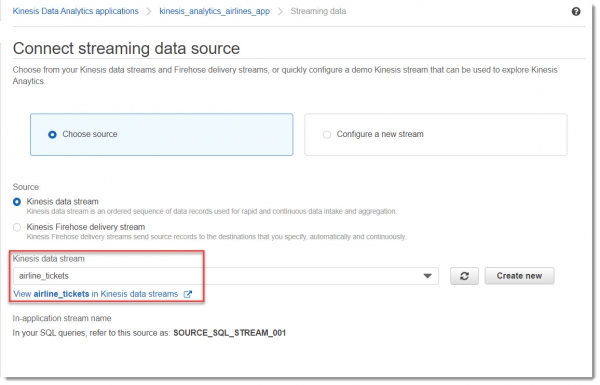
Daarna moet een nieuwe IAM-rol worden gehecht, zodat de applicatie uit de stream kan lezen en in de stream kan schrijven. Hiervoor hoeft er niets te worden gewijzigd in het blok Access permissions:
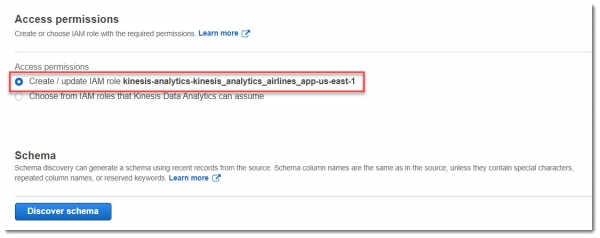
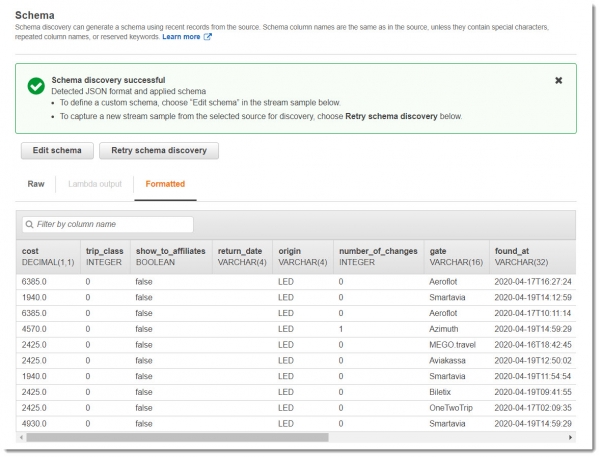
Nu vragen we om het ontdekken van de gegevensindeling in de stream, hiervoor klikken we op de knop ‘Discover schema’. Hierdoor wordt de IAM-rol bijgewerkt (of een nieuwe rol aangemaakt) en start het ontdekken van de indeling op basis van de gegevens die al in de stream zijn binnengekomen:
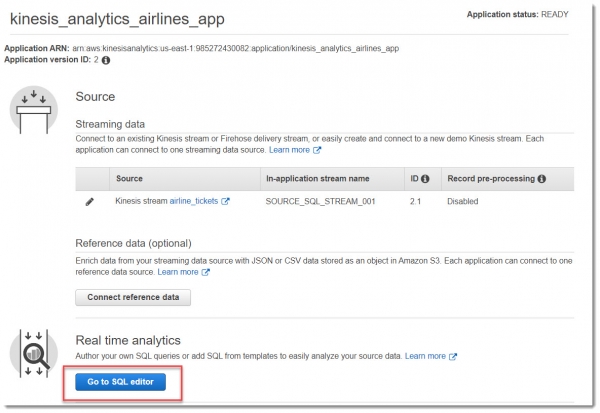
Nu moeten we naar de SQL-editor gaan. Wanneer we op deze knop klikken, verschijnt er een venster met de vraag of we de applicatie willen starten — kiezen we wat we willen starten:
In het venster van de SQL-editor plakken we deze eenvoudige query en klikken we op Save and Run SQL:
CREATE OR REPLACE STREAM "DESTINATION_SQL_STREAM" ("cost" DOUBLE, "gate" VARCHAR(16));

CREATE OR REPLACE PUMP "STREAM_PUMP" AS INSERT INTO "DESTINATION_SQL_STREAM"
SELECT STREAM "cost", "gate"
FROM "SOURCE_SQL_STREAM_001"
WHERE "cost" < 5000
    and "gate" = 'Aeroflot';
In relationele databases werkt u met tabellen, waarbij u de operators INSERT gebruikt om records toe te voegen en de operator SELECT om gegevens op te vragen. In Amazon Kinesis Data Analytics werkt u met streams (STREAM) en ‘pompen’ (PUMP) — doorlopende insert-opdrachten die gegevens van de ene stream in de applicatie naar een andere stream invoegen.
In de bovenstaande SQL-query wordt gezocht naar Aeroflot-tickets met een prijs van minder dan vijfduizend roebel. Alle records die aan deze voorwaarden voldoen, worden in de stream DESTINATION_SQL_STREAM geplaatst.
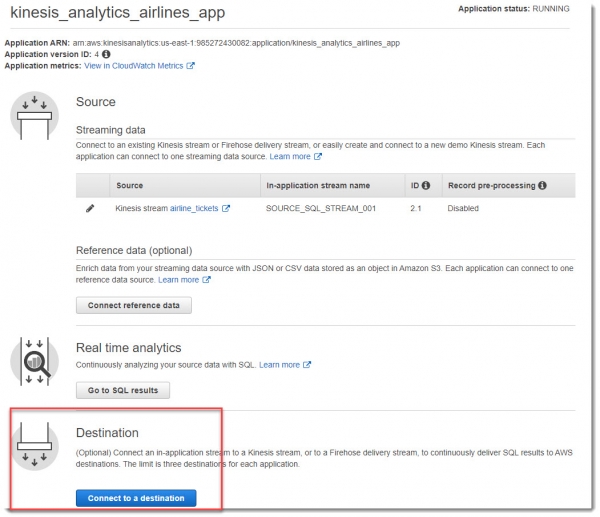
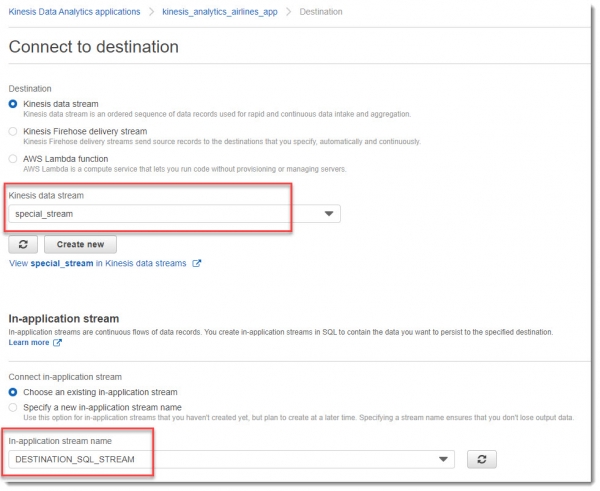
In het blok Bestemming kiezen we de stroom special_stream, en in de keuzelijst In-app stroomnaam DESTINATION_SQL_STREAM:
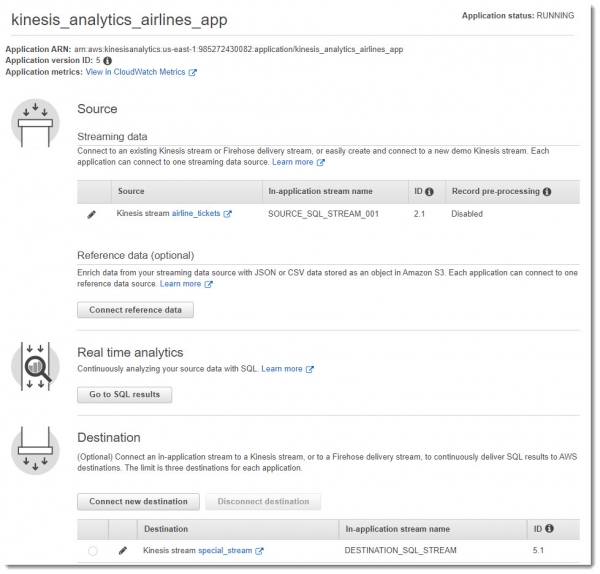
Na al deze handelingen zou er iets vergelijkbaars moeten ontstaan als de afbeelding hieronder:
Een topic SNS maken en eraan abonneren
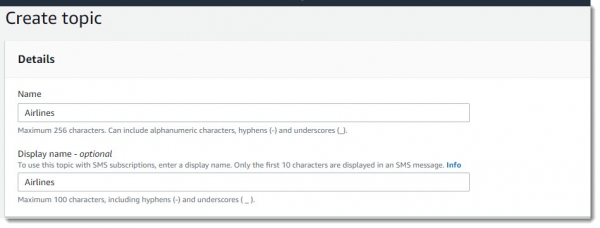
Laten we naar de Simple Notification Service gaan en daar een nieuw topic aanmaken met de naam Airlines:
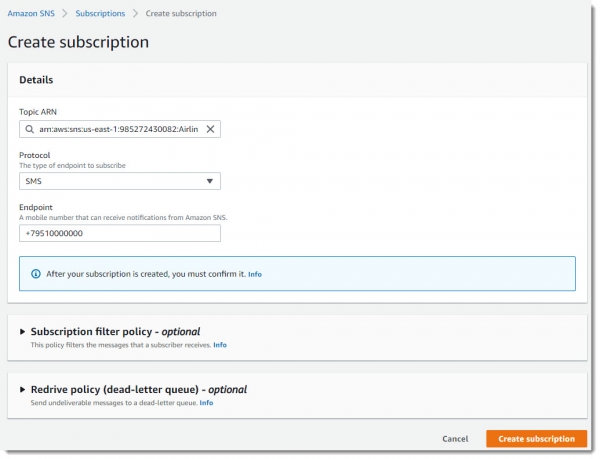
We abonneren ons op dit topic, waarbij we het mobiele telefoonnummer opgeven waarop de sms-meldingen zullen binnenkomen:
Een tabel maken in DynamoDB
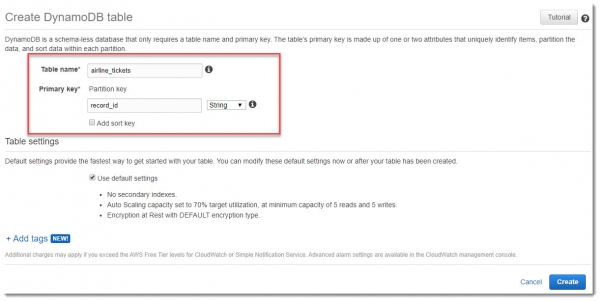
Voor het opslaan van de onbewerkte gegevens van de stroom airline_tickets, maken we een tabel in DynamoDB met dezelfde naam. We zullen record_id als primaire sleutel gebruiken:
Een lambda-functie collector maken
We creëren een lambda-functie genaamd Collector, die als taak heeft om de stroom airline_tickets te controleren en, als er nieuwe records worden gevonden, deze records in de DynamoDB-tabel in te voegen. Uiteraard moet deze lambda, naast de standaardrechten, toegang hebben tot lezen van de Kinesis-stroom en schrijven naar DynamoDB.
Een IAM-rol maken voor de lambda-functie collector
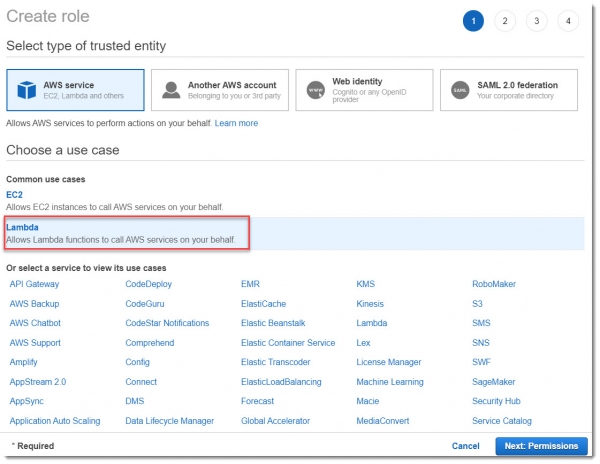
Laten we beginnen met het creëren van een nieuwe IAM-rol voor de lambda met de naam Lambda-TicketsProcessingRole:
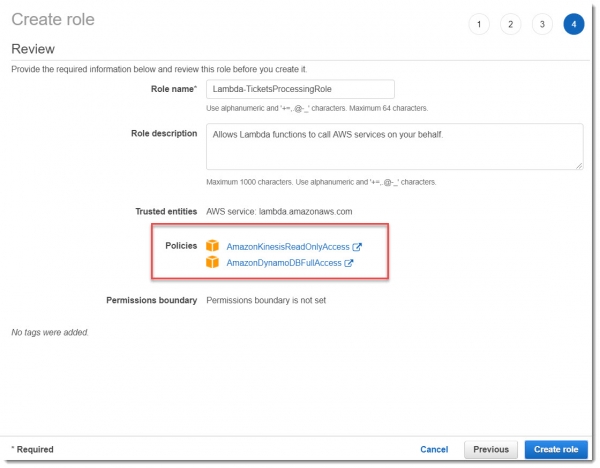
Voor een testvoorbeeld zijn de vooraf ingestelde beleidsmaatregelen AmazonKinesisReadOnlyAccess en AmazonDynamoDBFullAccess prima, zoals afgebeeld in de afbeelding hieronder:
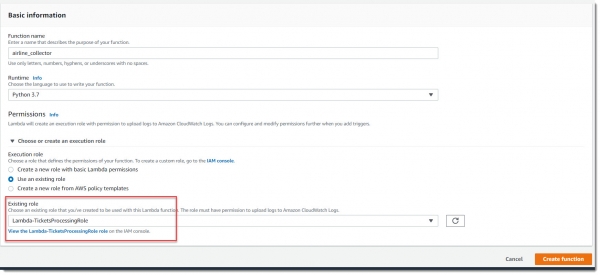
Deze lambda moet worden geactiveerd door een trigger van Kinesis wanneer er nieuwe records in de stroom airline_stream komen, dus we moeten een nieuwe trigger toevoegen:
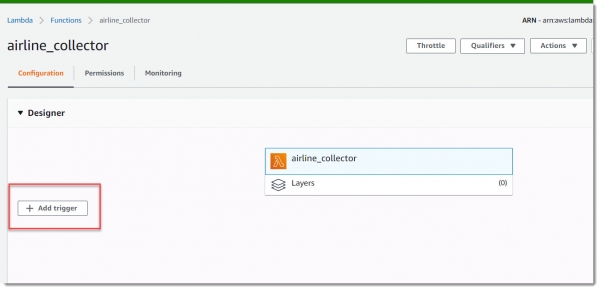
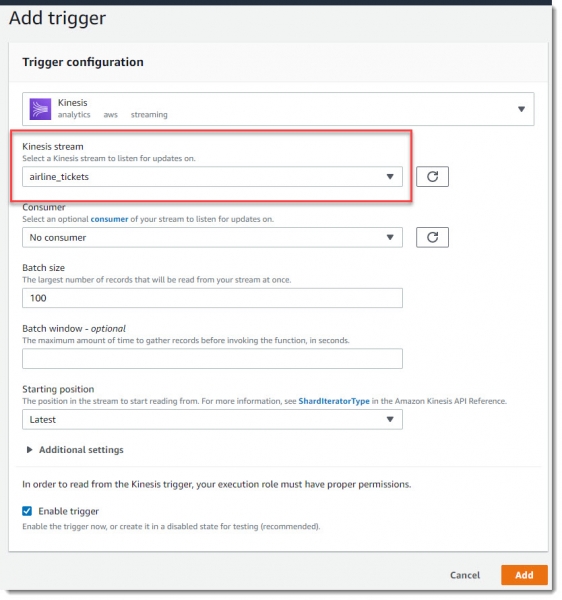
Het enige wat je hoeft te doen is de code in te voegen en de lambda op te slaan.
"""Stromen parseren en invoegen in de DynamoDB-tabel."""
import base64
import json
import boto3
from decimal import Decimal

DYNAMO_DB = boto3.resource('dynamodb')
TABLE_NAME = 'airline_tickets'

class TicketsParser:
    """Informatie uit de Stream parseren."""

    def __init__(self, table_name, records):
        """Init-methode."""
        self.table = DYNAMO_DB.Table(table_name)
        self.json_data = TicketsParser.get_json_data(records)

    @staticmethod
    def get_json_data(records):
        """Gegevens deserialiseren van de stream."""
        decoded_record_data = ([base64.b64decode(record['kinesis']['data'])
                                for record in records])
        json_data = ([json.loads(decoded_record)
                      for decoded_record in decoded_record_data])
        return json_data

    @staticmethod
    def get_item_from_json(json_item):
        """De json-gegevens voorbewerken."""
        new_item = {
            'record_id': json_item.get('record_id'),
            'cost': Decimal(json_item.get('cost')),
            'trip_class': json_item.get('trip_class'),
            'show_to_affiliates': json_item.get('show_to_affiliates'),
            'origin': json_item.get('origin'),
            'number_of_changes': int(json_item.get('number_of_changes')),
            'gate': json_item.get('gate'),
            'found_at': json_item.get('found_at'),
            'duration': int(json_item.get('duration')),
            'distance': int(json_item.get('distance')),
            'destination': json_item.get('destination'),
            'depart_date': json_item.get('depart_date'),
            'actual': json_item.get('actual')
        }
        return new_item

    def run(self):
        """Batch-insert in de tabel."""
        with self.table.batch_writer() as batch_writer:
            for item in self.json_data:
                dynamodb_item = TicketsParser.get_item_from_json(item)
                batch_writer.put_item(dynamodb_item)

        print('Er zijn ', len(self.json_data), 'items toegevoegd')

def lambda_handler(event, context):
    """Stream parseren en invoegen in de DynamoDB-tabel."""
    print('Ontvangen gebeurtenis:', event)
    parser = TicketsParser(TABLE_NAME, event['Records'])
    parser.run()
Lambdafunctie notifier maken
De tweede lambdafunctie, die de tweede stream (special_stream) zal monitoren en een melding naar SNS zal sturen, wordt op dezelfde manier gemaakt. Deze lambda moet dus leesrechten hebben vanuit Kinesis en berichten naar het opgegeven SNS-topic versturen, dat vervolgens door de SNS-service naar alle abonnees van dit topic (e-mail, sms, etc.) wordt verzonden.
Een IAM-rol aanmaken
Eerst maken we een IAM-rol Lambda-KinesisAlarm voor deze lambda, en daarna wijzen we deze rol toe aan de te maken lambda alarm_notifier:
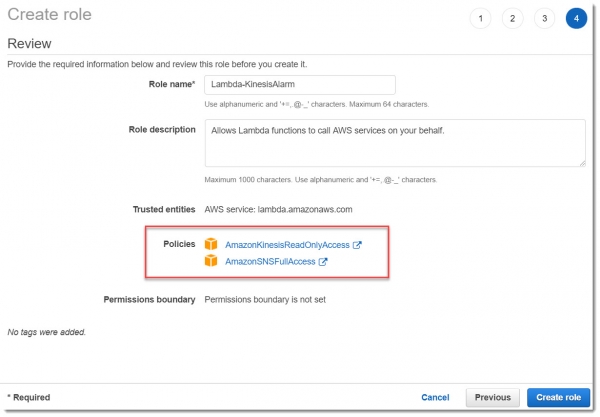
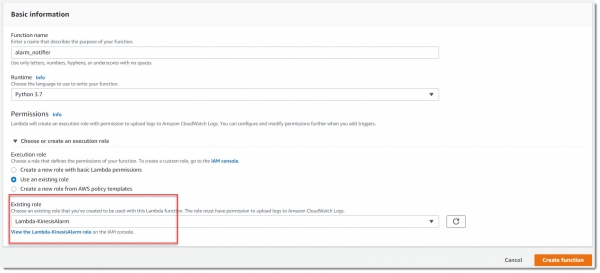
Deze lambda moet werken op basis van een trigger bij nieuwe records in de stream special_stream, dus we moeten de trigger instellen zoals we dat deden voor de lambda Collector.
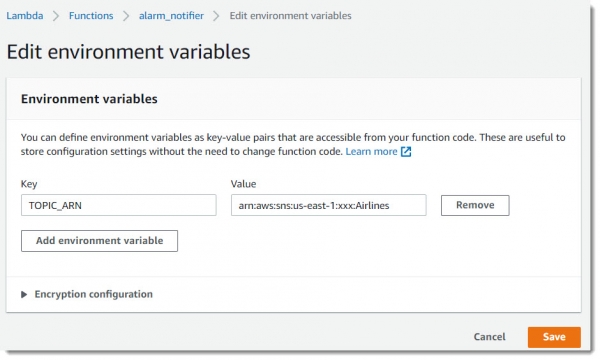
Voor het gemak van het instellen van deze lambda, voegen we een nieuwe omgevingsvariabele toe — TOPIC_ARN, waarin we de ARN (Amazon Resource Names) van het topic Airlines opslaan:
En we voegen de code van de lambda in, deze is helemaal niet ingewikkeld:
import boto3
import base64
import os

SNS_CLIENT = boto3.client('sns')
TOPIC_ARN = os.environ['TOPIC_ARN']


def lambda_handler(event, context):
    try:
        SNS_CLIENT.publish(TopicArn=TOPIC_ARN,
                           Message='Hallo! Ik heb iets interessants gevonden!',
                           Subject='Alarm voor vliegtickets')
        print('Alarmbericht is succesvol bezorgd')
    except Exception as err:
        print('Afleveringsfout', str(err))
Het lijkt erop dat de handmatige systeemconfiguratie hier is voltooid. We hoeven alleen nog maar te testen en ervoor te zorgen dat alles correct is ingesteld.
Deployment vanuit Terraform-code
Benodigde voorbereiding
— een zeer handige open-source tool voor het implementeren van infrastructuur vanuit code. Het heeft zijn eigen syntaxis die gemakkelijk te leren is, en talloze voorbeelden van wat en hoe te implementeren. In de editors Atom of Visual Studio Code zijn er veel handige plugins om het werken met Terraform te vergemakkelijken.
De distributie kan worden gedownload . Een gedetailleerde bespreking van alle mogelijkheden van Terraform valt buiten de reikwijdte van dit artikel, dus beperken we ons tot de belangrijkste punten.
Hoe te starten
De volledige code van het project bevindt zich . Kloneren we de repository naar ons toe. Voor het uitvoeren moet u ervoor zorgen dat AWS CLI is geïnstalleerd en ingesteld, omdat Terraform op zoek zal gaan naar inloggegevens in het bestand ~/ .aws /credentials.
Een goede praktijk is om voor het implementeren van de hele infrastructuur de plan-opdracht uit te voeren, om te zien wat Terraform ons momenteel in de cloud gaat aanmaken:
terraform.exe planEr zal om een telefoonnummer worden gevraagd om notificaties naartoe te sturen. Het invoeren van een nummer is op dit punt niet verplicht.
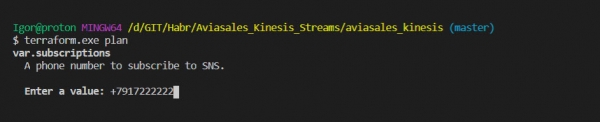
Na het analyseren van het werkplan van het programma kunnen we beginnen met het aanmaken van middelen:
terraform.exe applyNa het verzenden van deze opdracht verschijnt er opnieuw een verzoek om het telefoonnummer in te voeren. Typ 'yes' wanneer de vraag over de daadwerkelijke uitvoering van de acties verschijnt. Dit zal de hele infrastructuur opzetten, alle noodzakelijke instellingen van EC2 uitvoeren, lambda-functies implementeren, enz.
Nadat alle middelen succesvol zijn aangemaakt via de Terraform-code, moet u de details van de Kinesis Analytics-applicatie bekijken (helaas heb ik niet gevonden hoe dit direct vanuit de code kan).
We starten de applicatie:
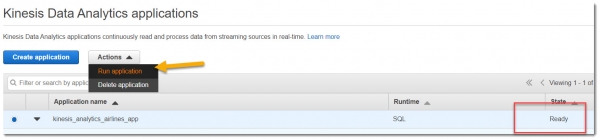
Daarna moet u expliciet de in-app streamnaam opgeven, door deze te kiezen uit de dropdownlijst:
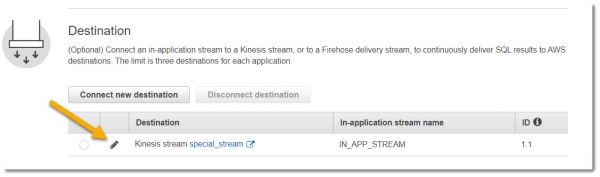
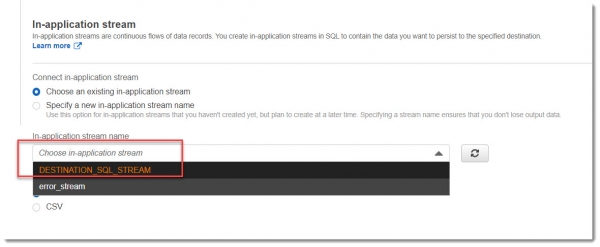
Nu is alles klaar voor gebruik.
Testen van de werking van de applicatie
Ongeacht hoe u het systeem hebt geïmplementeerd, handmatig of via Terraform-code, zal het hetzelfde functioneren.
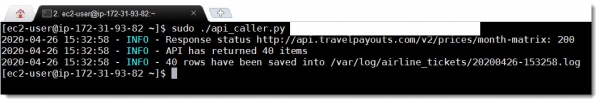
We access the EC2 virtual machine where the Kinesis Agent is installed via SSH and run the script api_caller.py
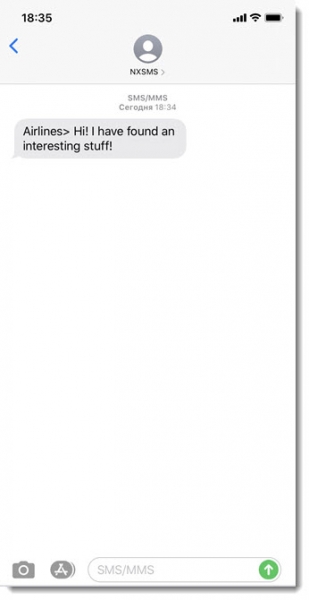
sudo ./api_caller.py TOKENJust wait for the SMS on your number:
SMS – the message arrives on the phone in almost 1 minute:
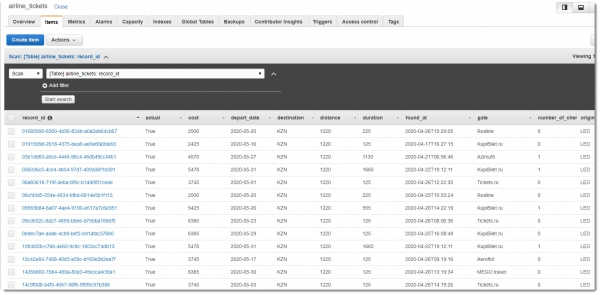
Now we need to check if the entries are saved in the DynamoDB database for further, more detailed analysis. The airline_tickets table contains approximately the following data:
Conclusie
As a result of the work done, an online data processing system was built based on Amazon Kinesis. Options for using Kinesis Agent in conjunction with Kinesis Data Streams and real-time analytics with Kinesis Analytics using SQL commands were explored, as well as how Amazon Kinesis interacts with other AWS services.
The described system was deployed in two ways: a relatively long manual method and a quick one using Terraform code.
The entire source code of the project is available , I suggest you check it out.
I am happy to discuss the article and look forward to your comments. I hope for constructive criticism.
Veel succes!
Bron: habr.com
