

Auteur: Sergey Lukyanchikov, ingenieur-consultant bij InterSystems
Uitdagingen van AI/ML-realtime berekeningen
Laten we beginnen met voorbeelden uit de Data Science-praktijk van InterSystems:
- Een ‘overbelast’ klantportaal is aangesloten op een online aanbevelingssysteem. Er staat een herstructurering van promotionele acties op het programma voor de retailketen (bijvoorbeeld, in plaats van een ‘platte’ reeks promoties, wordt nu een matrix van ‘segment-tactiek’ toegepast). Wat gebeurt er met de aanbevelingsmechanismen? Wat gebeurt er met de aanlevering en actualisatie van gegevens in het aanbevelingsmechanisme (is het volume van de invoergegevens met 25000 keer toegenomen)? Wat gebeurt er met de generatie van aanbevelingen (de noodzaak om de filterdrempel voor aanbevelingsregels duizenden keren te verlagen als gevolg van de duizendvoudige toename van hun aantal en ‘assortiment’)?
- Er is een systeem voor het monitoren van de waarschijnlijkheid van defecten in apparatuurknopen. Dit monitoring systeem is verbonden met een SCADA-systeem, dat elke seconde duizenden parameters van het technische proces doorgeeft. Wat gebeurt er met het monitoring systeem, dat voorheen werkte met ‘handmatige steekproeven’ (kan het zorgen voor een seconde-tot-seconde monitoring van de waarschijnlijkheid)? Wat zal er gebeuren als er een nieuwe blok van enkele honderden kolommen met sensorwaarnemingen, recent toegevoegd aan de SCADA, in de invoergegevens verschijnt (moet het monitoring systeem stilgelegd worden, en zo ja, hoe lang, om de analyse van gegevens van de nieuwe sensoren mogelijk te maken)?
- Er is een complex AI/ML-mechanismen (aanbevelende, monitorende, voorspellende) ontwikkeld, dat de resultaten van elkaars werking gebruikt. Hoeveel mensuren zijn maandelijks nodig om dit complex aan te passen aan veranderingen in de invoergegevens? Wat is de algemene ‘vertraagde’ effectiviteit van het complex bij het ondersteunen van besluitvorming (de frequentie van nieuw ondersteunende informatie in verhouding tot de frequentie van nieuwe invoergegevens)?
Samenvattend deze en vele andere voorbeelden, zijn we tot formuleringen gekomen van de uitdagingen die optreden bij de overgang naar het gebruik van machine learning en kunstmatige intelligentie mechanismen in realtime:
- Zijn we tevreden met de snelheid van ontwikkeling en aanpassing (aan de veranderende situatie) van AI/ML-ontwikkelingen in ons bedrijf?
- Hoe ondersteunen onze AI/ML-oplossingen het realtime beheer van bedrijven?
- Zijn onze AI/ML-oplossingen in staat om zich zelfstandig aan te passen aan veranderingen in gegevens en het managementpraktijk zonder de hulp van ontwikkelaars?
Ons artikel biedt een uitgebreide review van de mogelijkheden van het InterSystems IRIS-platform met betrekking tot de universele ondersteuning van de implementatie van AI/ML-mechanismen, de samenstelling (integratie) van AI/ML-oplossingen en de training (test) van AI/ML-oplossingen op intensieve gegevensstromen. We zullen ingaan op marktonderzoeken, praktische voorbeelden van AI/ML-oplossingen en de conceptuele aspecten van wat we in dit artikel een realtime AI/ML-platform noemen.
Wat blijkt uit enquêtes: realtime applicaties
Resultaten , uitgevoerd onder ongeveer 800 IT-professionals in 2019 door Lightbend, spreekt voor zich:
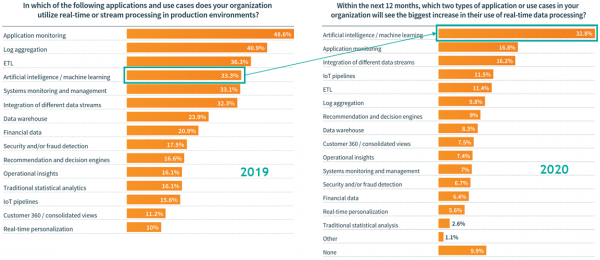
Figuur 1 Leidinggevende gebruikers van realtime gegevens
Laten we belangrijke fragmenten uit het rapport over de resultaten van deze enquête citeren in onze vertaling:
‘… De opkomst van de populariteit van middelen voor de integratie van gegevensstromen en tegelijkertijd de ondersteuning van berekeningen in containers geeft een synergetische respons op de vraag van de markt naar snellere, rationele en dynamische aanbiedingen van effectieve oplossingen. Gegevensstromen maken het mogelijk om informatie sneller te verzenden dan traditionele batchgegevens. Bovendien is er de mogelijkheid voor het snelle toepassen van computationele methoden, zoals bijvoorbeeld, AI/ML-gebaseerde aanbevelingen, wat concurrentievoordelen creëert door de klanttevredenheid te vergroten. De race naar snelheid beïnvloedt ook alle rollen in het DevOps-paradigma - wat de efficiëntie van applicatieontwikkeling en -implementatie verhoogt. … Acht honderd vier IT-specialisten hebben informatie verstrekt over het gebruik van gegevensstromen in hun organisaties. De respondenten bevonden zich voornamelijk in westerse landen (41% in Europa en 37% in Noord-Amerika) en waren vrijwel gelijkmatig verdeeld tussen kleine, middelgrote en grote bedrijven. …
Kunstmatige intelligentie is geen hype. Achtenvijftig procent van degenen die al gegevensstromen toepassen in productieve AI/ML-toepassingen, bevestigt dat hun toepassing in AI/ML het grootste voordeel zal opleveren in het volgende jaar (in vergelijking met andere toepassingen).
- Volgens de meeste ondervraagden zal de toepassing van gegevensstromen in AI/ML-scenario's het grootste voordeel opleveren in het volgende jaar.
- De toepassing in AI/ML zal niet alleen toenemen door relatief nieuwe soorten scenario's, maar ook door traditionele scenario's waarin real-time gegevens steeds intensiever worden toegepast.
- Naast AI/ML is het niveau van enthousiasme onder gebruikers van IoT-gegevenspipelines indrukwekkend — 48% van degenen die al IoT-gegevens hebben geïntegreerd, stellen dat de implementatie van scenario's op deze gegevens een aanzienlijke stijging zal ervaren in de nabije toekomst.
Uit deze interessante enquête blijkt dat de perceptie van machine learning- en kunstmatige intelligentiescenario's als leiders in het gebruik van gegevensstromen al 'op komst' is. Een niet minder belangrijke observatie is echter de perceptie van real-time AI/ML door de lens van DevOps: hier kunnen we al beginnen te spreken van de transformatie van de nog steeds heersende cultuur van 'wegwerpartificiële intelligentie met een volledig toegankelijk gegevensset'.
Het concept van een real-time AI/ML-platform
Een van de typische toepassingsgebieden van real-time AI/ML is het beheer van technologische processen in de productie. Aan de hand van dit voorbeeld en met inachtneming van de vorige overwegingen, formuleren we het concept van een real-time AI/ML-platform.
Het gebruik van kunstmatige intelligentie en machine learning in het beheer van technologische processen heeft een aantal kenmerken:
- Gegevens over de status van het technologische proces komen intensief binnen: met hoge frequentie en over een breed scala aan parameters (tot tientallen duizenden waarden die per seconde uit SCADA-systemen worden verzonden).
- Gegevens over defectdetectie, laat staan gegevens over hun ontwikkeling, zijn daarentegen schaars en onregelmatig, gekenmerkt door een gebrek aan typificatie van defecten en hun tijdslokalisatie (vaak gepresenteerd via handmatige notities).
- Praktisch gezien is er voor het trainen en toepassen van modellen alleen een ‘relevant venster’ van de oorspronkelijke gegevens beschikbaar, dat de dynamiek van het technologische proces weerspiegelt over een redelijke sluittijd, eindigend met de laatste gelezen waarden van de procesparameters.
Deze kenmerken dwingen ons, naast de ontvangst en basisverwerking in real-time van de intensieve ‘breedband binnenkomende signalen’ van het technologische proces, ook (gelijktijdig) de toepassing, training en kwaliteitscontrole van de resultaten van AI/ML-modellen uit te voeren – ook in real-time. Het ‘beeld’ dat onze modellen ‘zien’ in het relevante venster verandert voortdurend – en daarmee verandert ook de kwaliteit van de resultaten van de AI/ML-modellen, die zijn getraind op een van de ‘beelden’ in het verleden. Wanneer de kwaliteit van de resultaten van de AI/ML-modellen verslechtert (bijvoorbeeld: de classificatiefoutwaarde van ‘alarm-norm’ is buiten de door ons vastgestelde grenzen gekomen), moet er automatisch hertraining van de modellen worden gestart op een meer relevant ‘beeld’ – en het moment voor het starten van de hertraining moet zowel de duur van de training zelf als de dynamiek van de verslechtering van de prestaties van de huidige versie van de modellen in aanmerking nemen (aangezien de huidige versies van de modellen blijven worden toegepast terwijl de modellen worden getraind, tot hun ‘hergetrainde’ versies zijn gevormd).
InterSystems IRIS beschikt over essentiële platformmogelijkheden voor het ondersteunen van AI/ML-oplossingen bij het beheren van technologieprocessen in real-time. Deze mogelijkheden kunnen worden onderverdeeld in drie hoofdcategorieën:
- Continue implementatie (Continuous Deployment/Delivery, CD) van nieuwe of aangepaste bestaande AI/ML-mechanismen in een productie-oplossing die real-time functioneert op het InterSystems IRIS-platform.
- Continue integratie (Continuous Integration, CI) in een enkele productie-oplossing van binnenkomende gegevensstromen van het technologische proces, gegevensqueues voor toepassing/training/kwaliteitscontrole van AI/ML-mechanismen en gegevens/code/beheersystemen uitwisselingen met omgevingen voor wiskundige modellering, waarvan de orkestratie in real-time wordt uitgevoerd door het InterSystems IRIS-platform.
- Continue (zelf-)leren (Continuous Training, CT) van AI/ML-mechanismen, uitgevoerd in omgevingen voor wiskundige modellering met behulp van gegevens, code en besturende invloeden ("genomen beslissingen"), doorgegeven via het InterSystems IRIS-platform.
De classificatie van platformmogelijkheden met betrekking tot machine learning en kunstmatige intelligentie is niet toevallig op basis van deze groepen. Laten we de methodologie citeren. van het bedrijf Google, waarin de conceptuele basis voor deze classificatie wordt gelegd, in onze vertaling:
„… De populaire huidige DevOps-concept omvat de ontwikkeling en exploitatie van grootschalige informatiesystemen. De voordelen van de implementatie van dit concept zijn de verkorting van de ontwikkelingscycli, de versnelde implementatie van ontwikkelingen en de flexibiliteit van de releaseplanning. Om deze voordelen te behalen, vereist DevOps de implementatie van ten minste twee praktijken:
- Continue Integratie (CI)
- Continue Levering (CD)
Deze praktijken zijn ook toepasbaar op AI/ML-platformen – met het doel betrouwbare en productieve samenstellingen van AI/ML-oplossingen te waarborgen.
AI/ML-platformen onderscheiden zich van andere informatiesystemen in de volgende aspecten:
- Competenties van het team: bij de ontwikkeling van een AI/ML-oplossing omvat het team meestal data scientists of academische experts in dataverkenning, die gegevensanalyse, modelontwikkeling en -testing uitvoeren. Deze teamleden zijn mogelijk geen professionele ontwikkelaars van productieve programmatuur.
- Ontwikkeling: AI/ML-mechanismen zijn van nature experimenteel. Om een probleem op de meest efficiënte manier op te lossen, is het nodig om verschillende combinaties van invoervariabelen, algoritmen, modelleringstechnieken en modelparameters te doorlopen. De complexiteit van deze doorloop ligt in het traceren van 'wat werkte/niet werkte', het waarborgen van de reproduceerbaarheid van episoden en het generaliseren van ontwikkelingen voor herhaaldelijke implementaties.
- Testen: het testen van AI/ML-mechanismen vereist een groter scala aan tests dan de meeste andere ontwikkelingen. Naast standaard unit- en integratietests worden de geldigheid van gegevens, de kwaliteit van de resultaten van de toepassing van het model op trainings- en testsets getest.
- Implementatie: het implementeren van AI/ML-oplossingen gaat niet alleen om voorspellende services die gebruikmaken van een eenmaal getrainde model. AI/ML-oplossingen zijn opgebouwd rond meertraps pipelines die automatisch leren en modellen toepassen. Het implementeren van dergelijke pipelines omvat de automatisering van niet-triviale taken die traditioneel handmatig door datawetenschappers worden uitgevoerd om de mogelijkheden van het trainen en testen van modellen te kunnen benutten.
- Productiviteit: AI/ML-mechanismen kunnen niet alleen vanwege inefficiënte programmering aan prestaties tekortschieten, maar ook door de voortdurend veranderende aard van de invoergegevens. Met andere woorden, de prestaties van AI/ML-mechanismen kunnen om een breder scala aan redenen verslechteren dan die van reguliere oplossingen. Dit leidt tot de noodzaak voor continue monitoring van de prestaties van onze AI/ML-mechanismen, evenals het versturen van waarschuwingen of het filteren van resultaten als de prestaties niet aan de verwachtingen voldoen.
AI/ML-platforms zijn vergelijkbaar met andere informatiesystemen in die zin dat voor beide een continues integratieproces met versiebeheer, modulair testen, integratietesten en continue implementatie van ontwikkelingen nodig is. Er zijn echter enkele belangrijke verschillen bij AI/ML:
- CI (Continuous Integration, continue integratie) is niet langer beperkt tot testen en valideren van de code van de geïmplementeerde componenten – het omvat ook het testen en valideren van gegevens en AI/ML-modellen.
- CD (Continuous Delivery/Deployment, continue uitrol) is niet slechts het schrijven en uitgeven van pakketten of services, maar houdt een platform in voor het samenstellen, trainen en toepassen van AI/ML-oplossingen.
- CT (Continuous Training, continue training) – een nieuw element [opmerking van de auteur: een nieuw element ten opzichte van het traditionele DevOps-concept, waarbij CT doorgaans Continuous Testing betekent], dat eigen is aan AI/ML-platforms en verantwoordelijk is voor het autonome beheer van de mechanismen voor het trainen en toepassen van AI/ML-modellen. …
We can state that machine learning and artificial intelligence, operating on real-time data, require a broader set of tools and competencies (from code development to orchestration of mathematical modeling environments), closer integration among all functional and subject areas, and more effective organization of human and machine resources.
Real-time scenario: recognizing defect developments in nutrient pumps
Continuing with the example of process control, let's consider a specific task (which we mentioned at the very beginning): it is necessary to ensure real-time monitoring of defect developments in pumps based on the stream of values of process parameters and reports from maintenance personnel about identified defects.
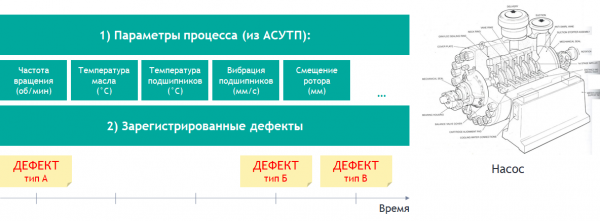
Figure 2 Problem statement for monitoring defect developments
The peculiarity of most tasks set in this way in practice is that the regularity and timeliness of data coming from the automated process control system (APCS) must be viewed against the backdrop of the episodic and irregular occurrence (and registration) of various types of defects. In other words: data from the APCS comes in once a second, correct and precise, while defect records are made in a common notebook in the workshop using a chemical pencil with the date noted (for example: "12.01 – leak in the cover on the side of the 3rd bearing").
Thus, we can supplement the formulation of the task with this important constraint: there is only one "label" for a specific type of defect (i.e., an example of a defect of a specific type is represented by data from the APCS on a specific date – and we have no more examples of this type of defect). This constraint immediately takes us beyond the scope of classical machine learning (supervised learning), for which many "labels" should exist.
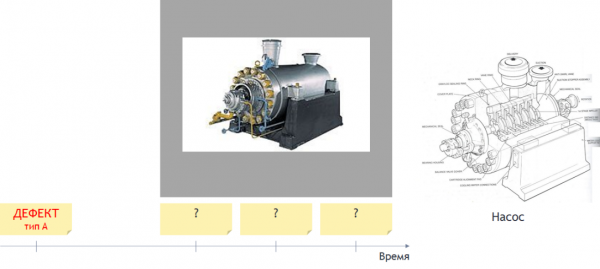
Figure 3 Clarification of the task for monitoring defect developments
Kunnen we op de een of andere manier de enige 'tag' die we hebben, dupliceren? Ja, dat kan. De huidige toestand van de pomp wordt gekarakteriseerd door de mate van overeenkomst met geregistreerde defecten. Zelfs zonder kwantitatieve methoden, alleen al door visueel te observeren naar de dynamiek van de gegevens die uit de SCADA komen, kunnen we al veel afleiden:
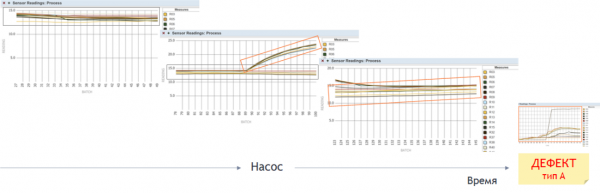
Figuur 4 Dynamiek van de toestand van de pomp tegen de achtergrond van de defecttag van het gegeven type
Maar visuele waarneming (tenzij we iets anders vinden) is niet de meest geschikte generator van 'tags' in ons snel veranderende scenario. We zullen de overeenkomst van de huidige toestand van de pomp met geregistreerde defecten evalueren met behulp van een statistische test.
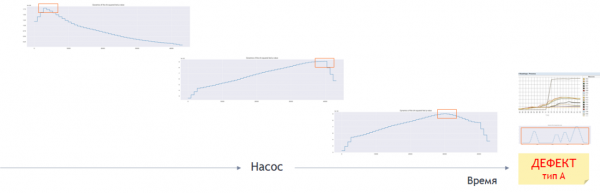
Figuur 5 Toepassing van de statistische test op de binnenkomende gegevens tegen de achtergrond van de defecttag
De statistische test bepaalt de kans dat de waarden van de procesparameters in de ontvangen 'stroompakket' vergelijkbaar zijn met de waarden van de defecttag van een bepaald type. De waarde van de waarschijnlijkheid (de statistische gelijkenisindex) die als resultaat van de statistische test wordt berekend, wordt omgezet in een waarde van 0 of 1, en wordt een 'tag' voor machinelearning in elk specifiek record in het onderzochte pakket. Dat wil zeggen, na het verwerken van het nieuw binnengekomen pakket van pompgegevens door de statistische test, hebben we de mogelijkheid om (a) dit pakket toe te voegen aan de trainingsset voor het trainen van het AI/ML-model en (b) de kwaliteitscontrole van de huidige versie van het model te uitvoeren bij de toepassing op dit pakket.
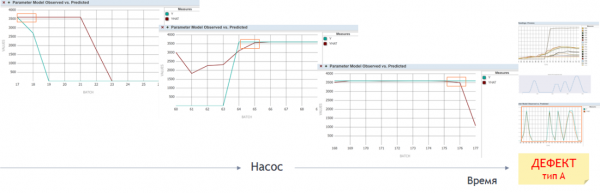
Figuur 6 Toepassing van het machine learning model op de binnenkomende gegevens tegen de achtergrond van de defecttag
In een van onze eerdere Wij laten zien en leggen uit hoe het InterSystems IRIS-platform elke AI/ML-mechanisme kan realiseren in de vorm van continu uitvoerbare bedrijfsprocessen, die de betrouwbaarheid van de modelleerresultaten controleren en de parameters van de modellen aanpassen. Bij de implementatie van een prototype van ons scenario met pompen gebruiken we alle functionaliteit van InterSystems IRIS die tijdens het webinar is gepresenteerd – waarbij we in de proces-analyzer in ons oplossing niet de klassieke supervised learning toepassen, maar eerder reinforcement learning, dat automatisch de steekproef voor het trainen van de modellen beheert. In de steekproef voor training worden records geplaatst waarop een 'detectieconsensus' ontstaat na het toepassen van zowel de statistische test als de huidige versie van het model – dat wil zeggen, zowel de statistische test (na transformatie van de gelijkenisindex naar 0 of 1), als het model hebben op deze records het resultaat 1 gegeven. Bij het opnieuw trainen van het model tijdens de validatie (de opnieuw getrainde model wordt toegepast op zijn eigen trainingsset, met een voorafgaande toepassing van de statistische test) worden records die na behandeling door de statistische test geen resultaat 1 hebben 'behaald' (vanwege de constante aanwezigheid van records van het oorspronkelijke 'label' van het defect in de trainingsset) uit de trainingsset verwijderd, en de nieuwe versie van het model wordt getraind op het 'label' van het defect plus de 'behouden' records uit de stroom.
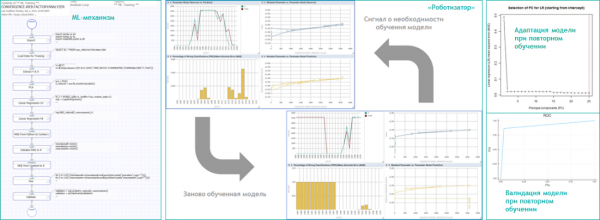
Figuur 7 Robotisering van AI/ML-berekeningen in InterSystems IRIS
Indien er behoefte is aan een soort 'tweede mening' over de kwaliteit van de detectie die wordt verkregen bij lokale berekeningen in InterSystems IRIS, wordt er een proces-adviseur gecreëerd voor het uitvoeren van het trainen-toepassen van modellen op een controledataset met behulp van cloudservices (bijvoorbeeld Microsoft Azure, Amazon Web Services, Google Cloud Platform, enz.):
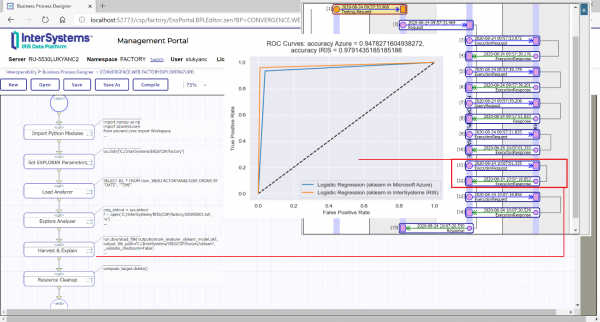
Figuur 8 'Tweede mening' van Microsoft Azure onder orchestration van InterSystems IRIS
Het prototype van ons scenario in InterSystems IRIS is uitgevoerd in de vorm van een agentensysteem van analytische processen die interacties hebben met het apparatuurobject (de pomp), wiskundige modellering omgevingen (Python, R en Julia), en die zelflerend zijn voor alle betrokken AI/ML-mechanismen – op real-time gegevensstromen.
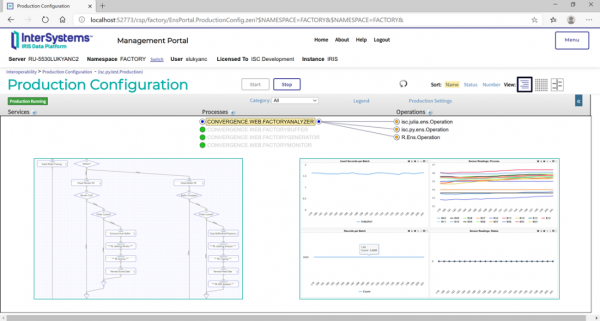
Figuur 9 Basisfunctionaliteit van de real-time AI/ML-oplossing in InterSystems IRIS
Praktisch resultaat van ons prototype:
- Herkenbaar defectmodel (12 januari):
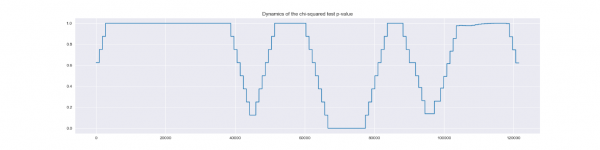
- Herkenbaar model van een zich ontwikkelend defect, niet opgenomen in het monster (11 september, het defect werd pas twee dagen later door het onderhoudsteam vastgesteld – 13 september):
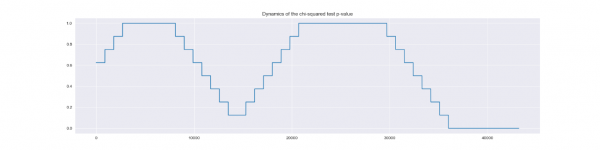
Simulatie met echte gegevens, bestaande uit meerdere episodes van hetzelfde defect, heeft aangetoond dat onze oplossing, geïmplementeerd op het InterSystems IRIS-platform, in staat is om de ontwikkeling van dergelijke defecten enkele dagen voor hun ontdekking door het onderhoudsteam te detecteren.
InterSystems IRIS – veelzijdig platform voor AI\/ML-realtime berekeningen
Het InterSystems IRIS-platform vereenvoudigt de ontwikkeling, implementatie en werking van oplossingen voor realtime gegevens. InterSystems IRIS kan gelijktijdig transactionele en analytische gegevensverwerking uitvoeren; gesynchroniseerde gegevensweergaven ondersteunen volgens verschillende modellen (inclusief relationele, hiërarchische, object- en documentmodellen); fungeren als integratieplatform voor een breed scala aan gegevensbronnen en afzonderlijke applicaties; en geavanceerde realtime analyses aanbieden op gestructureerde en ongestructureerde gegevens. InterSystems IRIS biedt ook mechanismen voor het toepassen van externe analytische tools en stelt een flexibele combinatie van cloud- en lokale serverimplementaties mogelijk.
Applicaties die zijn gebouwd op het InterSystems IRIS-platform zijn geïmplementeerd in verschillende sectoren, waarbij bedrijven worden geholpen om substantiële economische voordelen te behalen in strategische en operationele perspectieven, de besluitvorming te verbeteren en de ‘gaten’ tussen gebeurtenis, analyse en actie te dichten.
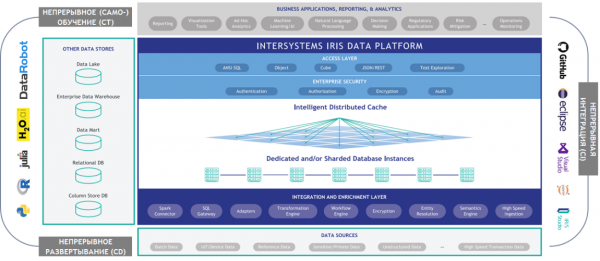
Figuur 10 Architectuur van InterSystems IRIS in de context van realtime AI\/ML
Net als de vorige diagram combineert de onderstaande diagram een nieuw ‘coördinatensysteem’ (CD\/CI\/CT) met het informatiestroomschema tussen de werkcomponenten van het platform. De visualisatie begint met het macromechanisme CD en gaat verder met de macromechanismen CI en CT.
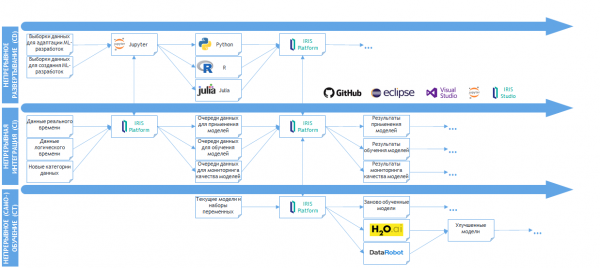
Figuur 11 Schema van de informatiestromen tussen de AI\/ML-elementen van het InterSystems IRIS-platform
De essentie van het CD-mechanisme in InterSystems IRIS: gebruikers van het platform (ontwikkelaars van AI/ML-oplossingen) passen bestaande AI/ML-ontwikkelingen aan en/of creëren nieuwe AI/ML-projecten met behulp van een gespecialiseerde code-editor voor AI/ML-mechanismen: Jupyter (volledige naam: Jupyter Notebook; soms worden ook de documenten die in deze editor zijn gemaakt, kortweg zo genoemd). In Jupyter heeft de ontwikkelaar de mogelijkheid om specifieke AI/ML-ontwikkelingen te schrijven, te debuggen en te verifiëren (ook met behulp van grafieken) voordat deze worden geïmplementeerd ("deployment") in InterSystems IRIS. Het is duidelijk dat de nieuw ontwikkelde oplossing op deze manier alleen basisdebugging zal ontvangen (aangezien Jupyter bijvoorbeeld niet werkt met realtime gegevensstromen) – dat is normaal, want het voornaamste resultaat van ontwikkeling in Jupyter is de bevestiging van de fundamentele werking van een afzonderlijk AI/ML-mechanisme ("op een dataset geeft het de verwachte output"). Op een vergelijkbare manier kan een al op het platform geïmplementeerd mechanisme (zie de volgende macro-mechanismen) voor debugging in Jupyter een "rollback" naar de "pre-platform"-versie vereisen (gegevens lezen uit bestanden, werken met gegevens via xDBC in plaats van tabellen, directe interactie met globalen – multidimensionale datam arrays van InterSystems IRIS – enzovoort).
Een belangrijk aspect van de implementatie van CD in InterSystems IRIS: er is een bidirectionele integratie gerealiseerd tussen het platform en Jupyter, waardoor inhoud geschreven in de programmeertalen Python, R en Julia (alle drie zijn programmeertalen in de toonaangevende open-source omgevingen voor wiskundige modellering) naar het platform kan worden overgedragen (en vervolgens in het platform kan worden verwerkt). Dit stelt ontwikkelaars van AI/ML-inhoud in staat om "continue deployment" van deze inhoud op het platform te realiseren, terwijl ze werken in hun vertrouwde Jupyter-editor, met de gebruikelijke bibliotheken die beschikbaar zijn in Python, R, Julia, en basisdebugging (indien nodig) buiten het platform uitvoeren.
We gaan over naar het macro-mechanisme CI in InterSystems IRIS. In het diagram is het macroproces van de werking van de 'real-time robot' afgebeeld (een complex van datastructuren, bedrijfsprocessen en de door hen georkestreerde codefragmenten in de programmeertalen Matsred en ObjectScript - de native programmeertaal van InterSystems IRIS). De taak van dit macroproces is het ondersteunen van de benodigde datastromen voor de werking van AI/ML-mechanismen (op basis van de datastromen die in real-time naar het platform worden verzonden), het nemen van beslissingen over de volgorde van toepassing en het 'assortiment' van AI/ML-mechanismen (ook wel 'wiskundige algoritmes', 'modellen', enz. genoemd - de terminologie kan variëren afhankelijk van de implementatie en terminologische voorkeuren), en het actueel houden van de datastructuren voor het analyseren van de resultaten van de AI/ML-mechanismen (cubes, tabellen, multidimensionale gegevensarrays, enz. - voor rapporten, dashboards, enz.).
Een belangrijk aspect van de implementatie van CI speciaal in InterSystems IRIS: er is een bidirectionele integratie gerealiseerd tussen het platform en de omgevingen voor wiskundige modellering, die het mogelijk maakt om de in het platform ondergebrachte inhoud in de talen Python, R en Julia in hun respectieve omgevingen uit te voeren, met terugontvangst van de uitvoerresultaten. Deze integratie is gerealiseerd in zowel de 'terminalmodus' (d.w.z. AI/ML-inhoud wordt geformuleerd als code in ObjectScript die aanroepen van de wiskundige omgeving doet), als in de 'business procesmodus' (d.w.z. AI/ML-inhoud wordt geformuleerd als een bedrijfsproces met behulp van een grafische editor, of soms met behulp van Jupyter, of IDE's zoals IRIS Studio, Eclipse, Visual Studio Code). De beschikbaarheid van bedrijfsprocessen voor bewerking in Jupyter wordt weergegeven door middel van de koppeling tussen IRIS op CI-niveau en Jupyter op CD-niveau. Een meer gedetailleerd overzicht van de integratie met de omgevingen voor wiskundige modellering wordt verderop gegeven. In dit stadium zijn er naar onze mening alle redenen om vast te stellen dat het platform over alle benodigde tools beschikt voor de implementatie van 'continu integratie' van AI/ML-ontwikkelingen (komend vanuit 'continue implementatie') in real-time AI/ML-oplossingen.
En de belangrijkste macro-mechanisme: CT. Zonder dit is er geen AI/ML-platform (hoewel 'real-time' geïmplementeerd zal worden via CD/CI). De essentie van CT is het werken van het platform met 'artefacten' van machine learning en kunstmatige intelligentie direct in werk sessies van wiskundige modellering: modellen, distributietabellen, vectoren-matrices, lagen van neurale netwerken, enz. Dit 'werk' bestaat in de meeste gevallen uit het creëren van de bovengenoemde artefacten in omgevingen (in het geval van modellen bestaat 'creatie' bijvoorbeeld uit het opstellen van de specificatie van het model en het vervolgens afstemmen van de waarden van de parameters – de zogenaamde 'training' van het model), hun toepassing (voor modellen: berekening van 'model' waarden van doelvariabelen – voorspellingen, categorietoewijzing, waarschijnlijkheid van gebeurtenis enz.) en het verbeteren van reeds gemaakte en toegepaste artefacten (bijvoorbeeld, het herdefiniëren van de set invoervariabelen van het model op basis van de resultaten van de toepassing – met het doel de nauwkeurigheid van voorspellingen te verhogen, als variant). Een cruciaal punt in het begrijpen van de rol van CT is zijn 'abstractie' van de realiteiten van CD en CI: CT zal alle artefacten implementeren, met de focus op de computationele en wiskundige specificiteit van de AI/ML-oplossing binnen de mogelijkheden die door specifieke omgevingen worden geboden. De verantwoordelijkheid voor 'data-invoer' en 'resultaatlevering' zal liggen bij CD en CI.
Een belangrijk aspect van de implementatie van CT in InterSystems IRIS: door gebruik te maken van de eerder genoemde integratie met wiskundige modellering omgevingen, kan het platform artefacten extraheren uit werk sessies die onder zijn beheer plaatsvinden in deze omgevingen en (het belangrijkste) deze omzetten in databasobjecten van het platform. Bijvoorbeeld, een distributietabel die net is aangemaakt in een werk sessie Python kan (zonder de sessie in Python te stoppen) worden overgebracht naar het platform in de vorm van bijvoorbeeld een globale (multidimensionale gegevensarray in InterSystems IRIS) – en gebruikt worden voor berekeningen in een ander AI/ML-mechanisme (dat al is gerealiseerd in een andere omgeving – bijvoorbeeld in R) – of een virtuele tabel. Een ander voorbeeld: parallel aan de "normale modus" van het model (in de werk sessie Python), wordt er aan de invoergegevens "auto-ML" toegepast: automatische selectie van optimale invoervariabelen en parameterwaarden. En samen met de "normale" training, ontvangt het productieve model in realtime ook een "optimalisatievoorstel" voor zijn specificatie – waarin de set invoervariabelen verandert, de waarden van de parameters veranderen (nu niet als gevolg van training in Python, maar als gevolg van het trainen van een "alternatieve" versie van zichzelf, bijvoorbeeld in de H2O-stack), waardoor de algemene AI/ML-oplossing autonoom kan omgaan met onvoorzienbare veranderingen in het karakter van de invoergegevens en de gemodelleerde fenomenen.
Laten we wat dieper ingaan op de AI/ML-functionaliteit van het platform InterSystems IRIS, aan de hand van een echt bestaand prototype.
In de onderstaande diagram bevindt zich aan de linkerkant van de dia een deel van het bedrijfsproces dat de uitvoering van scripts in Python en R implementeert. In het midden staan de visuele logboeken van de uitvoering van enkele van deze scripts, respectievelijk in Python en R. Direct erachter bevinden zich voorbeelden van inhoud in beide talen, doorgegeven ter uitvoering aan de respectieve omgevingen. Aan de rechterkant zijn de visualisaties te zien, gebaseerd op de resultaten van de scriptuitvoeringen. De visualisaties bovenaan zijn gemaakt in IRIS Analytics (gegevens zijn uit Python naar het data-platform InterSystems IRIS gehaald en weergegeven op het dashboard met de middelen van het platform), terwijl de onderkant rechtstreeks is gemaakt in de R-werkruimte en daaruit naar grafische bestanden is geëxporteerd. Een belangrijk aspect: het gepresenteerde fragment in het prototype is verantwoordelijk voor het opleiden van het model (classificatie van de toestanden van de apparatuur) op gegevens die in real-time van het proces-simulator van de apparatuur komen, op commando van het kwaliteitsmonitoringsproces van de classificatie, dat wordt waargenomen tijdens de toepassing van het model. We zullen later spreken over de implementatie van de AI/ML-oplossing in de vorm van een set van interactierende processen ('agenten').
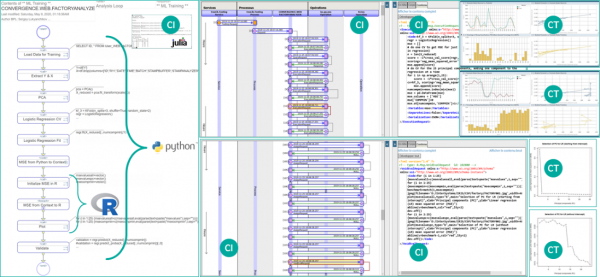
Afbeelding 12 Interactie met Python, R en Julia in InterSystems IRIS
Platformprocessen (ook wel 'bedrijfsprocessen', 'analytische processen', 'pipelines', enz. - afhankelijk van de context) zijn in de eerste plaats bewerkbaar in de grafische editor voor bedrijfsprocessen in het platform, waarbij tegelijkertijd zowel de blokdiagram als het bijbehorende AI/ML-mechanisme (computer code) worden aangemaakt. Wanneer we zeggen dat 'er een AI/ML-mechanisme ontstaat', bedoelen we in eerste instantie hybriditeit (binnen één proces): inhoud in de talen van wiskundige modellering gaat samen met inhoud in SQL (waaronder extensies van ), in InterSystems ObjectScript, met andere ondersteunde talen. Bovendien biedt het platformproces zeer brede mogelijkheden voor het 'tekenen' in de vorm van hiërarchisch geneste fragmenten (zoals te zien is in het voorbeeld op de onderstaande diagram), wat het mogelijk maakt om zelfs zeer complexe inhoud effectief te organiseren, zonder 'uit de grafische indeling te vallen' (in 'niet-grafische' methoden/classen/procedures, enz.). Dit betekent dat, waar nodig (en dit wordt verwacht in de meeste projecten), de volledige AI/ML-oplossing kan worden geïmplementeerd in een grafisch zelf-documenterend formaat. We wijzen erop dat in het centrale deel van de onderstaande diagram, waarop een hoger 'niveau van nesting' wordt gepresenteerd, zichtbaar is dat, naast het feitelijke werk aan het trainen van het model (met behulp van Python en R), ook de analyse van de zogenaamde ROC-curve van het getrainde model wordt toegevoegd, die visueel (en ook computationeel) de kwaliteit van de training kan beoordelen – en deze analyse is gerealiseerd in de taal Julia (wordt uitgevoerd in de Julia-omgeving).
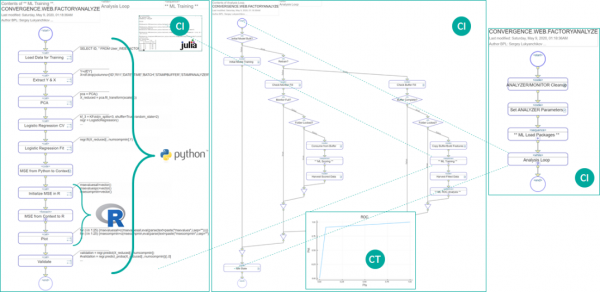
Figuur 13 Visuele omgeving voor de compositie van AI/ML-oplossingen in InterSystems IRIS
Zoals eerder vermeld, zal de initiële ontwikkeling en (in sommige gevallen) aanpassing van reeds in het platform geïmplementeerde AI/ML-mechanismen buiten het platform plaatsvinden in de Jupyter-editor. In de onderstaande diagram zien we een voorbeeld van de aanpassing van het bestaande platformproces (hetzelfde als in de bovenstaande diagram) – zo ziet het eruit in Jupyter voor dat fragment, dat verantwoordelijk is voor het trainen van het model. De inhoud in Python is beschikbaar voor bewerking, debugging en grafische uitvoer rechtstreeks in Jupyter. Wijzigingen (indien nodig) kunnen met onmiddellijke synchronisatie in het platformproces worden aangebracht, inclusief in de productieversie. Op een vergelijkbare manier kan ook nieuwe inhoud aan het platform worden overgedragen (automatisch wordt een nieuw platformproces aangemaakt).
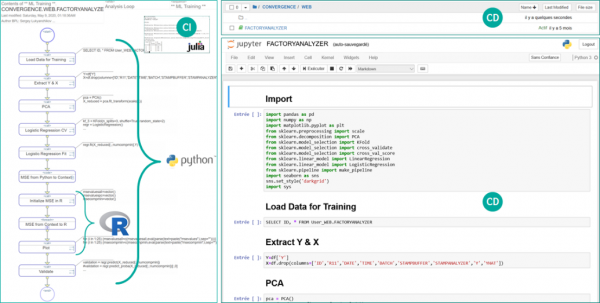
Figuur 14 Toepassing van Jupyter Notebook voor de bewerking van het AI/ML-mechanisme in het InterSystems IRIS-platform
De aanpassing van het platformproces kan niet alleen in grafische of laptopvorm worden uitgevoerd, maar ook in een "totaal" IDE-formaat (Integrated Development Environment). Dergelijke IDE's zijn IRIS Studio (de native studio van IRIS), Visual Studio Code (de InterSystems IRIS-extensie voor VSCode) en Eclipse (de Atelier-plug-in). In sommige gevallen is het mogelijk dat een team van ontwikkelaars gelijktijdig gebruikmaakt van alle drie de IDE's. De onderstaande diagram toont een voorbeeld van het bewerken van hetzelfde proces in de IRIS-studio, Visual Studio Code en Eclipse. Voor het bewerken is alle inhoud beschikbaar: zowel Python/R/Julia/SQL, als ObjectScript en het bedrijfsproces.
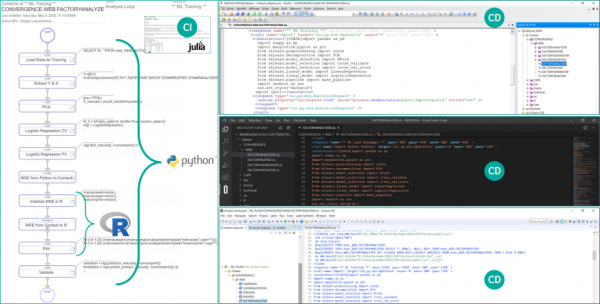
Figuur 15 Ontwikkeling van het bedrijfsproces InterSystems IRIS in verschillende IDE's
De tools voor het beschrijven en uitvoeren van bedrijfsprocessen in InterSystems IRIS met de Business Process Language (BPL) verdienen bijzondere vermelding. BPL maakt het mogelijk om in bedrijfsprocessen "kant-en-klare integratiecomponenten" (activiteiten) te gebruiken - wat in feite de volledige grondslag biedt voor de bewering dat in InterSystems IRIS "continue integratie" is gerealiseerd. De kant-en-klare componenten van het bedrijfsproces (activiteiten en hun relaties) zijn een krachtige versneller voor de ontwikkeling van AI/ML-oplossingen. En niet alleen voor de ontwikkeling: dankzij de activiteiten en de relaties tussen hen ontstaat er een "autonome bestuurlijke laag" bovenop de verspreide AI/ML-ontwikkelingen en mechanismen, die in real-time beslissingen kan nemen op basis van de situatie.
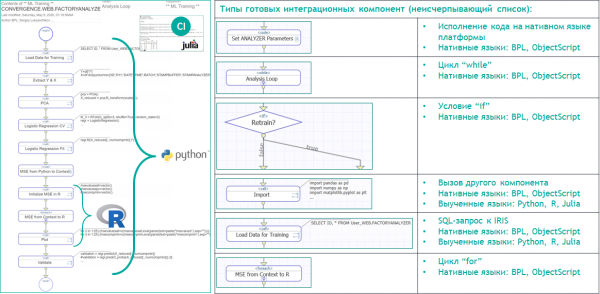
Figuur 16 Kant-en-klare componenten van bedrijfsprocessen voor continue integratie (CI) op het InterSystems IRIS-platform
Het concept van agentensystemen (ook wel "multi-agent systemen" genoemd) heeft sterke posities in robotica, en het InterSystems IRIS-platform ondersteunt dit organisch via het construct "productie-proces". Naast de onbegrensde mogelijkheden om elke proces uit te rusten met de noodzakelijke functionaliteit voor de algehele oplossing, stelt het toekennen van agentschapskenmerken aan het platformproces systeem in staat om effectieve oplossingen te creëren voor extreem onstabiele gemodelleerde verschijnselen (gedrag van sociale/biosystemen, gedeeltelijk waarneembare technologische processen, enz.).
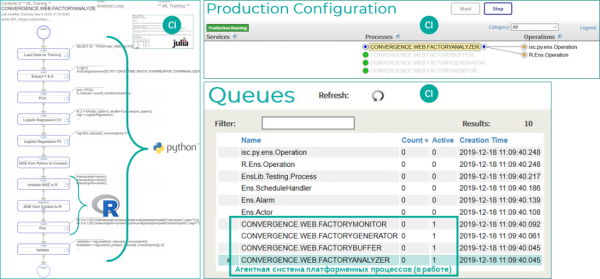
Figuur 16 De werking van de AI/ML-oplossing als een agentensysteem van bedrijfsprocessen in InterSystems IRIS
We continue our review of InterSystems IRIS with an account of the practical application of the platform for solving entire classes of real-time tasks (a detailed introduction to some of the best practices for platform AI/ML on InterSystems IRIS can be found in one of our previous articles. ).
Following closely on from the previous diagram, below is a more detailed diagram of the agent system. The diagram shows the same prototype, illustrating all four agent processes and the relationships between them: GENERATOR – handles the creation of data from equipment sensors, BUFFER – manages data queues, ANALYZER – performs machine learning itself, MONITOR – controls the quality of the machine learning and signals the need for model retraining.
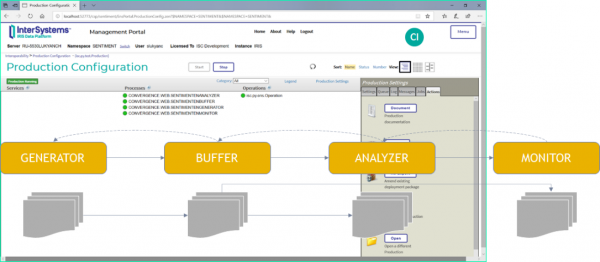
Figure 17 Composition of the AI/ML solution as an agent system of business processes in InterSystems IRIS
The diagram below illustrates the autonomous functioning of another robotic prototype (recognition of emotional tone in texts) over a period of time. At the top – the evolution of the model training quality indicator (quality is increasing), at the bottom – the dynamics of the quality application indicator and instances of retraining (red stripes). As can be seen, the solution has effectively and autonomously learned, and operates at a specified level of quality (the quality indicator values do not fall below 80%).
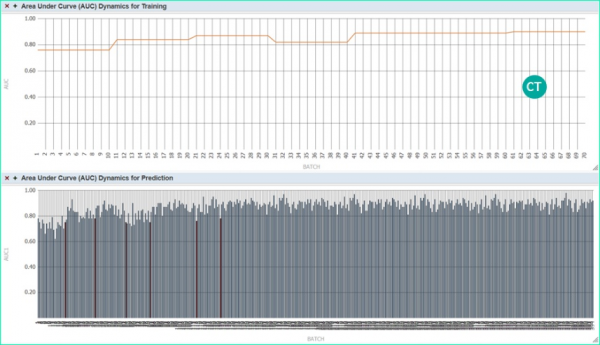
Figure 18 Continuous (self-)learning (CT) on the InterSystems IRIS platform
Over 'auto-ML' hebben we ook eerder gesproken, maar in de onderstaande diagram wordt het gebruik van deze functionaliteit in detail weergegeven aan de hand van een ander prototype. In de grafische schematische weergave van het bedrijfsproces is de activiteit getoond die de modellering in de H2O-stack start; de resultaten van deze modellering zijn gepresenteerd (waarbij het duidelijke overwicht van het verkregen model boven 'handgemaakte' modellen wordt aangetoond volgens de vergelijkingsdiagram van ROC-curves, evenals de geautomatiseerde identificatie van de 'meest invloedrijke variabelen' uit de beschikbare dataset). Een belangrijk punt hier is de tijds- en expertiseresourcebesparing die wordt bereikt door 'auto-ML': wat ons platformproces in dertig seconden doet (het vinden en trainen van het optimale model), kan een expert van een week tot een maand kosten.
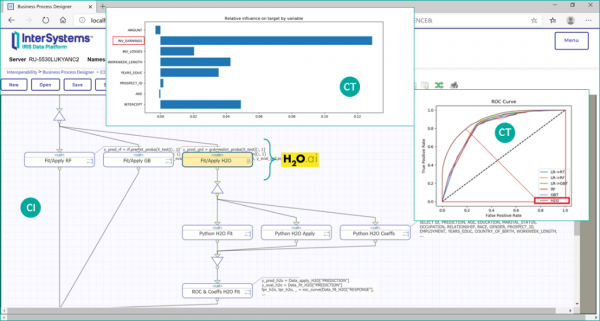
Figuur 19 Integratie van 'auto-ML' in een AI/ML-oplossing op het InterSystems IRIS-platform
Het onderstaande diagram haalt de spanning er een beetje uit, maar het is een goede afsluiting van het verhaal over de klassen van op te lossen real-time problemen: we herinneren eraan dat, ondanks alle mogelijkheden van het InterSystems IRIS-platform, het trainen van modellen onder zijn beheer niet verplicht is. Het platform kan een zogenaamde PMML-specificatie van een model van buitenaf ontvangen, getraind in een tool die niet onder het beheer van het platform valt – en dit model in real-time toepassen vanaf het moment van import. . Het is daarbij belangrijk te beseffen dat niet alle AI/ML-artifacten kunnen worden teruggebracht tot PMML-specificaties, zelfs als de meeste van de algemeenste artifacten dat wel toelaten. Dus heeft het InterSystems IRIS-platform een 'open contour' en betekent het niet 'platformslavernij' voor gebruikers.
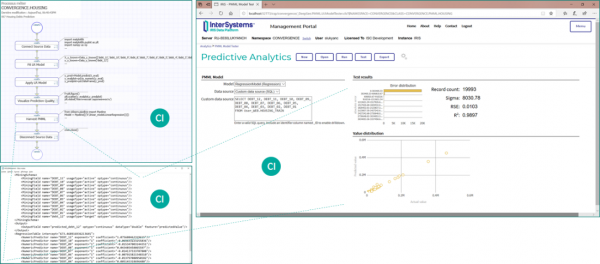
Figuur 20 Integratie van 'auto-ML' in een AI/ML-oplossing op het InterSystems IRIS-platform
Laten we de aanvullende platformvoordelen van InterSystems IRIS opsommen (ter illustratie, met betrekking tot het beheer van technologische processen), die van groot belang zijn bij de automatisering van kunstmatige intelligentie en machine learning in real-time:
- Geavanceerde integratiemiddelen met elke gegevensbron en -ontvanger (DCS/SCADA, apparatuur, onderhoud, ERP, enz.)
- Ingebouwd voor hoogwaardige transactionele en analytische verwerking (Hybrid Transaction/Analytical Processing, HTAP) van gegevensvolumes in technologische processen
- Ontwikkelingsmiddelen voor continue implementatie van AI/ML-mechanismen voor realtime oplossingen op basis van Python, R, Julia
- Adaptieve bedrijfsprocessen voor continue integratie en (zelf)leren van AI/ML-oplossingen in realtime
- Ingebouwde Business Intelligence-tools voor datavisualisatie van technologische processen en de resultaten van AI/ML-oplossingen
- voor het leveren van resultaten van AI/ML-oplossingen aan SCADA/PCS, informatie-analysesystemen, waarschuwingdistributie, enz.
AI/ML-oplossingen op het InterSystems IRIS-platform integreren eenvoudig in de bestaande IT-infrastructuur. Het InterSystems IRIS-platform biedt hoge betrouwbaarheid van AI/ML-oplossingen dankzij ondersteuning voor fouttolerante en rampbestendige configuraties en flexibele implementatie in virtuele omgevingen, op fysieke servers, in private en publieke cloudomgevingen, en Docker-containers.
Daarom is InterSystems IRIS een veelzijdig platform voor realtime AI/ML-berekeningen. De veelzijdigheid van ons platform wordt in de praktijk bevestigd door het ontbreken van de facto beperkingen op de complexiteit van te implementeren berekeningen, de mogelijkheid van InterSystems IRIS om (in realtime) scenario's uit de meest diverse sectoren te combineren, en de uitzonderlijke aanpasbaarheid van alle functies en mechanismen van het platform aan de specifieke behoeften van gebruikers.
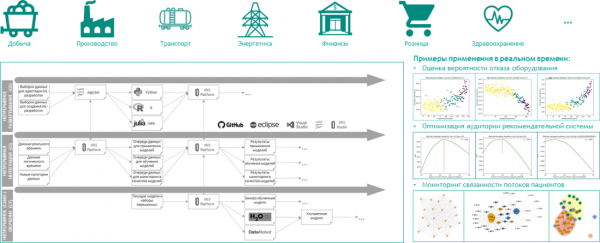
Afbeelding 21 InterSystems IRIS - een veelzijdig platform voor realtime AI/ML-berekeningen
Voor een meer inhoudelijke interactie met degenen onder onze lezers die geïnteresseerd zijn in het hier gepresenteerde materiaal, bevelen we aan om niet alleen het lezen ervan te beperken maar ook de dialoog 'in het echt' voort te zetten. We staan klaar om ondersteuning te bieden in het formuleren van realtime AI/ML-scenario's die specifiek zijn voor uw bedrijf, gezamenlijk prototyping op het InterSystems IRIS-platform uit te voeren, en een praktische roadmap te ontwikkelen en te implementeren voor de invoering van kunstmatige intelligentie en machine learning in uw productie- en managementprocessen. Het contactadres van onze AI/ML-expertgroep is .
Bron: habr.com
