

Tegenwoordig zijn er kant-en-klare (eigen) oplossingen voor het monitoren van IP(TS)-stromen, zoals en , ze beschikken over een vrij uitgebreide set functies en dergelijke oplossingen zijn doorgaans beschikbaar bij grote aanbieders die zich bezighouden met tv-diensten. Dit artikel beschrijft een oplossing gebaseerd op het open source project , dat is ontworpen voor minimale controle van IP(TS)-stromen op basis van de CC (continuity counter) en bitrate. Een mogelijke toepassing is het controleren van verloren pakketten of de stroom als geheel via een gehuurde L2-kanaal (waarbij het niet mogelijk is om dit goed te monitoren, bijvoorbeeld door het lezen van verliesstatistieken in wachtrijen).
Kort over TSDuck
TSDuck is een open source (licentie 2-Clause BSD) softwarepakket (een verzameling consolehulpmiddelen en een bibliotheek voor het ontwikkelen van eigen hulpmiddelen of plugins) voor manipulatie van TS-stromen. Als invoer kan het werken met IP (multicast/unicast), http, hls, dvb-tuners, dektec dvb-asi demodulatoren; het heeft een interne generator voor TS-stromen en kan bestanden lezen. Als uitvoer kan het gegevens wegschrijven naar een bestand, IP (multicast/unicast), hls, dektec dvb-asi en HiDes modulators, spelers (mplayer, vlc, xine) en drop. Tussen invoer en uitvoer kunnen verschillende traffica processors worden ingeschakeld, zoals PID-mapping, scrambling/descrambling, analyse van CC- tellers, bitrate berekening en andere typische bewerkingen voor TS-stromen.
In dit artikel zullen IP-stromen (multicast) als invoer worden gebruikt, samen met de processors bitrate_monitor (waaruit duidelijk blijkt waar het om gaat) en continuity (analyse van CC-tellers). Het vervangen van IP multicast door een ander type invoer dat door TSDuck wordt ondersteund, is zonder problemen mogelijk.
Er zijn TSDuck voor de meeste actuele besturingssystemen. Voor Debian zijn deze er niet, maar ik heb het zonder problemen kunnen bouwen voor Debian 8 en Debian 10.
Hierna wordt versie TSDuck 3.19-1520 gebruikt, als besturingssysteem wordt Linux gebruikt (voor de voorbereiding van de oplossing werd Debian 10 gebruikt, voor het daadwerkelijke gebruik — CentOS 7)
Voorbereiding TSDuck en besturingssysteem
Voordat u echte stromen gaat monitoren, moet u ervoor zorgen dat TSDuck correct werkt en dat er geen drops zijn op het niveau van de netwerkkaart of het besturingssysteem (socket). Dit is nodig om later niet te hoeven raden waar de drops zijn opgetreden - in het netwerk of "intern in de server". Drops op het niveau van de netwerkkaart kunnen worden gecontroleerd met het commando ethtool -S ethX, tuning gebeurt met dezelfde ethtool (meestal moet u de RX-buffer (-G) vergroten en soms enkele offloads (-K) uitschakelen). Als algemene aanbeveling kan worden geadviseerd om een aparte poort te gebruiken voor het ontvangen van het geanalyseerde verkeer, als dat mogelijk is; dit minimaliseert valse positieven die verband houden met het feit dat de drop plaatsvond op de poort van de analyzer vanwege ander verkeer. Als deze mogelijkheid er niet is (bij gebruik van een mini-computer/NUC met één poort), is het zeer wenselijk om prioriteit te geven aan het geanalyseerde verkeer ten opzichte van het overige verkeer op het apparaat waarmee de analyzer is verbonden. Wat betreft virtuele omgevingen, hier moet voorzichtigheid worden betracht en moet u in staat zijn om drops vanaf de fysieke poort tot aan de applicatie binnen de virtuele machine te lokaliseren.
Generatie en ontvangst van stroom binnen de host
Als eerste stap in de voorbereiding gaan we binnen dezelfde host verkeer genereren en ontvangen met behulp van netns.
Voorbereiding van de omgeving:
ip netns add P #we creëren netns P, hierin zal de verkeersanalyse plaatsvinden
ip link add type veth #we creëren een veth-paar - veth0 blijft in de standaard netns (dit is de interface waar verkeer zal worden gegenereerd)
ip link set dev veth1 netns P #veth1 plaatsen we in netns P (op deze interface zal verkeer worden ontvangen)
ip netns exec P ifconfig veth1 192.0.2.1/30 up #we activeren IP op veth1, het maakt niet uit welk precies
ip netns exec P ip ro add default via 192.0.2.2 #de standaardroute binnen netns P instellen
sysctl net.ipv6.conf.veth0.disable_ipv6=1 #we schakelen IPv6 uit op veth0 - dit gebeurt zodat er geen ongewenste rommel in de TX-teller komt
ifconfig veth0 up #we activeren de interface veth0
ip route add 239.0.0.1 dev veth0 #we creëren een route zodat het OS verkeer naar 239.0.0.1 via veth0 leidt
De omgeving is gereed. We starten de verkeersanalysator:
ip netns exec P tsp --realtime -t
 -I ip 239.0.0.1:1234
 -P continuity
 -P bitrate_monitor -p 1 -t 1
 -O drop
waarbij "-p 1 -t 1" betekent dat er elke seconde een bitrate moet worden berekend en informatie over de bitrate elke seconde moet worden weergegeven
We starten de verkeersgenerator met een snelheid van 10 Mbit/s:
tsp -I craft
 -P regulate -b 10000000
 -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
waarbij "-p 7 -e" betekent dat je 7 TS-pakketten in 1 IP-pakket moet verpakken en dit strikt moet doen (-e), dat wil zeggen dat je altijd moet wachten op 7 TS-pakketten van de laatste processor voordat je het IP-pakket verzendt.
De analyzer begint de verwachte berichten weer te geven:
* 2020/01/03 14:55:44 - bitrate_monitor: 2020/01/03 14:55:44, TS bitrates: 9.970.016 bits/s
* 2020/01/03 14:55:45 - bitrate_monitor: 2020/01/03 14:55:45, TS bitrates: 10.022.656 bits/s
* 2020/01/03 14:55:46 - bitrate_monitor: 2020/01/03 14:55:46, TS bitrates: 9.980.544 bits/s
Nu voegen we wat drops toe:
ip netns exec P iptables -I INPUT -d 239.0.0.1 -m statistic --mode random --probability 0.001 -j DROPen er verschijnen berichten als deze:
* 2020/01/03 14:57:11 - continuity: pakketindex: 80.745, PID: 0x0000, 7 pakketten missen
* 2020/01/03 14:57:11 - continuity: pakketindex: 83.342, PID: 0x0000, 7 pakketten missen
wat verwacht is. We schakelen het pakketverlies uit (ip netns exec P iptables -F) en proberen de bitrates van de generator te verhogen tot 100 Mbit/s. De analyzer meldt veel CC-fouten en rond de 75 Mbit/s in plaats van 100. We proberen uit te zoeken wie de schuldige is — of de generator het niet bijhoudt of dat de oorzaak niet bij hem ligt, daarvoor starten we de generatie van een vast aantal pakketten (700000 TS-pakketten = 100000 IP-pakketten):
# ifconfig veth0 | grep TX
       TX packets 151825460  bytes 205725459268 (191.5 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
# tsp -I craft -c 700000 -P regulate -b 100000000 -P count -O ip -p 7 -e --local-port 6000 239.0.0.1:1234
* count: PID    0 (0x0000):    700,000 packets
# ifconfig veth0 | grep TX
        TX packets 151925460  bytes 205861259268 (191.7 GiB)
        TX errors 0  dropped 0 overruns 0  carrier 0  collisions 0
Zoals te zien is, zijn er precies 100000 IP-pakketten gegenereerd (151925460-151825460). Dit betekent dat we onderzoeken wat er met de analyzer aan de hand is, hiervoor vergelijken we het RX-teller op veth1; deze is precies gelijk aan de TX-teller op veth0; hierna kijken we wat er op het socketniveau gebeurt:
# ip netns exec P cat /proc/net/udp
  sl  local_address rem_address   st tx_queue rx_queue tr tm->when retrnsmt   uid  timeout inode ref pointer drops
  133: 010000EF:04D2 00000000:0000 07 00000000:00000000 00:00000000 00000000     0        0 72338 2 00000000e0a441df 24355
Hier is het aantal drops te zien = 24355. In TS-pakketten is dit 170485 of 24,36% van de 700000, dus zien we dat die 25% verloren bitrate drops in de udp-socket zijn. Drops in de UDP-socket ontstaan gewoonlijk door een gebrek aan buffer; laten we kijken wat de standaard buffer-grootte van de socket is en de maximale buffer-grootte van de socket:
# sysctl net.core.rmem_default
net.core.rmem_default = 212992
# sysctl net.core.rmem_max
net.core.rmem_max = 212992
Dus, als applicaties de buffer-grootte niet expliciet aanvragen, worden sockets aangemaakt met een buffer van 208 kB, maar als ze om meer vragen, krijgen ze toch niet het gevraagde. Aangezien je bij tsp voor IP-invoer de buffer-grootte (-—buffer-size) kunt opgeven, zullen we de standaard socket-grootte niet aanpassen, maar alleen de maximale socket-grootte instellen en de buffer-grootte expliciet opgeven via de tsp-argumenten:
sysctl net.core.rmem_max=8388608
ip netns exec P tsp --realtime -t -I ip 239.0.0.1:1234 -b 8388608 -P continuity -P bitrate_monitor -p 1 -t 1 -O drop
Met deze buffer-tweaks is de rapportage bitrate nu ongeveer 100 Mbit/s, en er zijn geen CC-fouten.
Bij het CPU-verbruik door de applicatie zelf, is voor een enkele core van de i5-4260U CPU @ 1.40GHz voor het analyseren van een stroom van 10 Mbit/s ongeveer 3-4% CPU vereist, 100 Mbit/s — 25%, en 200 Mbit/s — 46%. Bij het instellen van het % pakketverlies neemt de CPU-belasting vrijwel niet toe (maar kan afnemen).
Op krachtigere hardware was het mogelijk om probleemloos stromen van meer dan 1 Gbit/s te genereren en te analyseren.
Testen op echte netwerkkaarten
Na het testen op een veth-paar moeten twee hosts of twee poorten van één host worden genomen, de poorten met elkaar verbinden, op de ene een generator starten en op de andere een analyser. Hier waren er geen verrassingen, maar het hangt eigenlijk allemaal van de hardware af: hoe zwakker, hoe interessanter het hier zal zijn.
Gebruik van de verkregen gegevens door het monitoring-systeem (Zabbix)
Tsp heeft geen machine-readable API zoals SNMP of iets dergelijks. CC-berichten moeten minimaal per seconde worden geaggregeerd (bij een hoog percentage pakketverlies kunnen er honderden/thousands/tientallen duizenden per seconde zijn, afhankelijk van de bitrate).
Daarom, om zowel informatie op te slaan als grafieken te maken van CC-fouten en bitrate en om verder eventuele storingen vast te leggen, kunnen de volgende opties worden overwogen:
- De uitvoer van tsp parseren en aggregeren (op CC), dat wil zeggen om het in de vereiste vorm te brengen.
- De tsp zelf en/of de processorplugins bitrate_monitor en continuity verbeteren, zodat het resultaat in een machine-readable vorm wordt gegeven die geschikt is voor het monitoring-systeem.
- Een eigen applicatie bovenop de tsduck-bibliotheek schrijven.
Het is duidelijk dat qua werkbelasting optie 1 de eenvoudigste is, vooral gezien het feit dat tsduck zelf is geschreven in een laag-niveau (volgens moderne normen) taal (C++).
Een eenvoudig prototype van een parser+aggregator op bash toonde aan dat bij een stroom van 10 Mbit/s en 50% pakketverlies (de slechtste optie), het bash-proces 3-4 keer meer CPU verbruikte dan het tsp-proces zelf. Zo'n scenario is onacceptabel. Een stuk van dit prototype vindt u hieronder.
Noodles op bash
#!/usr/bin/env bash

missingPackets=0
ccErrorSeconds=0
regexMissPackets='^* (.+) - continuity:.*missing ([0-9]+) packets$'
missingPacketsTime=""

ip netns exec P tsp --realtime -t -I ip -b 8388608 "239.0.0.1:1234" -O drop -P bitrate_monitor -p 1 -t 1  -P continuity 2>&1 |
while read i
do
    #line example:* 2019/12/28 23:41:14 - continuity: packet index: 6,078, PID: 0x0100, missing 5 packets
    #line example 2: * 2019/12/28 23:55:11 - bitrate_monitor: 2019/12/28 23:55:11, TS bitrate: 4,272,864 bits/s
    if [[ "$i" == *continuity:* ]]
    then
        if [[ "$i" =~ $regexMissPackets ]]
        then
            missingPacketsTimeNew="${BASH_REMATCH[1]}" #timestamp (seconds)
            if [[ "$missingPacketsTime" != "$missingPacketsTimeNew" ]] #new second with CC error
            then
                ((ccErrorSeconds += 1))
            fi
            missingPacketsTime=$missingPacketsTimeNew
            packets=${BASH_REMATCH[2]} #TS missing packets
            ((missingPackets += packets))
        fi
    elif [[ "$i" == *bitrate_monitor:* ]]
    then
        : #...
    fi
done
Naast het feit dat het onaanvaardbaar traag werkt, ontbreken er normale threads in bash, zijn bash jobs zelfstandige processen en moest er elke seconde een waarde van missingPackets worden geregistreerd als bijeffect (wanneer een bericht over de bitrate wordt ontvangen, dat elke seconde binnenkomt). Uiteindelijk werd bash met rust gelaten en werd besloten een wrapper (parser + aggregator) in Golang te schrijven. Het CPU-verbruik van gelijkwaardige code in Golang is 4-5 keer lager dan dat van het tsp-proces. De versnelling van de wrapper door bash door Golang te vervangen was ongeveer 16 keer en het overall resultaat is acceptabel (CPU-overhead van 25% in het slechtste geval). Het bronbestand in Golang bevindt zich .
Wrapper starten
Voor het starten van de wrapper is een eenvoudig serviesjabloon voor systemd gemaakt (). Er wordt aangenomen dat de wrapper zelf is gecompileerd tot een binaire bestand (go build tsduck-stat.go), geplaatst in /opt/tsduck-stat/. Er wordt aangenomen dat Golang met ondersteuning voor monotonic clock (>=1.9) wordt gebruikt.
Om een service-exemplaar te maken, moet je de opdracht systemctl enable tsduck-stat@239.0.0.1:1234 uitvoeren, en vervolgens starten met systemctl start tsduck-stat@239.0.0.1:1234.
Discovery vanuit Zabbix
Om ervoor te zorgen dat Zabbix de draaiende services kan ontdekken, is er een (discovery.sh), in het formaat dat nodig is voor Zabbix discovery, aangenomen dat deze zich daar bevindt — in /opt/tsduck-stat. Om discovery via de zabbix-agent uit te voeren, moet je toevoegen aan de map met de configuraties van de zabbix-agent voor het toevoegen van user-parameters.
Zabbix-sjabloon
(tsduck_stat_template.xml) bevat een autodetectieregel, prototypes van datapunten, grafieken en triggers.
Korte checklist (voor het geval dat iemand het wil gebruiken)
- Zorg ervoor dat tsp geen pakketten verliest onder 'perfecte' omstandigheden (waarbij generator en analyzer rechtstreeks zijn aangesloten), als er verlies is, zie punt 2 of de tekst van dit artikel hierover.
- Maximale socketbuffer tuning uitvoeren (net.core.rmem_max=8388608).
- Compileer tsduck-stat.go (go build tsduck-stat.go).
- Plaats het serviesjabloon in /lib/systemd/system.
- Start de services met systemctl, controleer of ze beginnen te verschijnen in de tellers (grep '' /dev/shm/tsduck-stat/*). Het aantal services komt overeen met het aantal multicast-stromen. Het kan nodig zijn om een route naar de multicast-groep te maken, mogelijk rp_filter uit te schakelen of een route naar het source IP te maken.
- Voer discovery.sh uit, zorg ervoor dat het json genereert.
- Plaats de configuratie van de zabbix-agent en herstart de zabbix-agent.
- Upload the template in Zabbix, apply it to the host being monitored with the Zabbix agent installed, wait about 5 minutes, and check that new data items, graphs, and triggers have appeared.
Resultaat
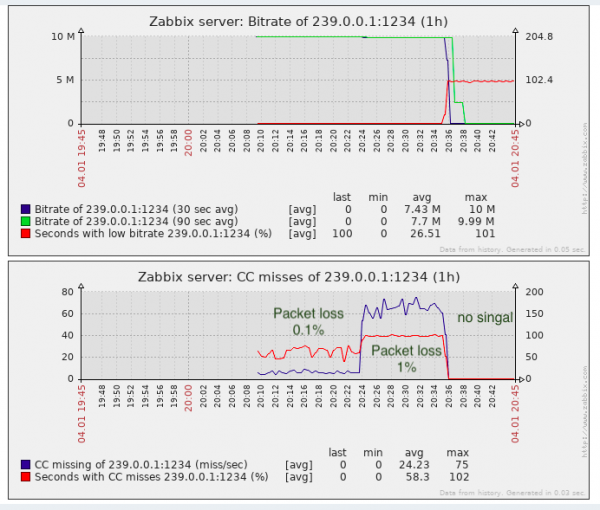
For the task of detecting packet loss, this is almost sufficient; in any case, it's better than having no monitoring.
Indeed, CC 'losses' can occur when video segments are stitched together (as far as I know, this is how inserts are made in local TV centers in the RF, i.e., without recalculating the CC counter), this needs to be remembered. In proprietary solutions, this problem is partially bypassed by detecting SCTE-35 markers (if they are added by the stream generator).
From the perspective of transport quality monitoring, jitter monitoring (IAT) is lacking, since TV equipment (whether modulators or end devices) has requirements for this parameter and the jitbuffer cannot always be inflated indefinitely. Jitter may be affected when transit equipment with large buffers is used and QoS for transmitting such real-time traffic is not configured or not sufficiently well configured.
Bron: habr.com
