

Van de blogredacteur van Google: Heb je je ooit afgevraagd hoe de ingenieurs van Google Cloud Technical Solutions (TSE) omgaan met je technische ondersteuningsverzoeken? Het werkgebied van TSE-ondersteuningsingenieurs omvat het identificeren en oplossen van door gebruikers aangegeven probleembronnen. Sommige van deze problemen zijn vrij eenvoudig, maar soms komt er een verzoek binnen dat de aandacht vereist van meerdere ingenieurs. In dit artikel zal een van de TSE-medewerkers ons vertellen over een zeer ingewikkeld probleem uit zijn recente ervaring — . Tijdens dit verhaal zullen we zien hoe de ingenieurs erin zijn geslaagd de situatie op te lossen en wat ze nieuw hebben geleerd tijdens het oplossen van de fout. We hopen dat dit verhaal je niet alleen vertelt over een diepgewortelde bug, maar ook inzicht geeft in de processen die plaatsvinden bij het indienen van een verzoek bij Google Cloud-ondersteuning.
Probleemoplossing is zowel wetenschap als kunst. Alles begint met het formuleren van een hypothese over de oorzaak van het ongewone gedrag van het systeem, waarna deze op de proef wordt gesteld. Maar voordat we een hypothese formuleren, moeten we het probleem duidelijk definiëren en precies verwoorden. Als de vraag te vaag klinkt, moet je alles goed analyseren; dat is de 'kunst' van probleemoplossing.
In de context van Google Cloud worden dergelijke processen aanzienlijk gecompliceerd, omdat Google Cloud er alles aan doet om de privacy van zijn gebruikers te waarborgen. Hierdoor hebben TSE-ingenieurs geen toegang om je systemen aan te passen, noch kunnen ze de configuraties zo uitgebreid bekijken zoals gebruikers dat doen. Daarom kunnen we (ingenieurs) onze systemen niet snel aanpassen om een van onze hypotheses te testen.
Sommige gebruikers denken dat we alles zullen oplossen als auto-onderhoudsmonteurs, en sturen ons gewoon het id van de virtuele machine, terwijl het proces in werkelijkheid een gesprek is: informatie verzamelen, hypothesen formuleren en bevestigen (of ontkrachten), en uiteindelijk wordt de oplossing van het probleem gebouwd op communicatie met de klant.
Het probleem in kwestie
Vandaag hebben we een verhaal met een goed einde. Een van de redenen voor de succesvolle oplossing van de voorgestelde case ligt in de zeer gedetailleerde en nauwkeurige beschrijving van het probleem. Hieronder kunt u een kopie zien van het eerste ticket (bewerkte versie om vertrouwelijke informatie te verbergen):
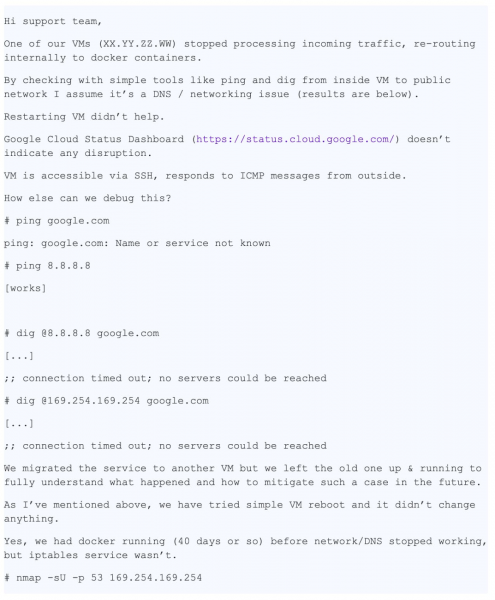
Dit bericht bevat veel waardevolle informatie voor ons:
- Een specifieke VM is genoemd
- Het probleem zelf is genoemd - DNS werkt niet
- Waar het probleem zich manifesteert - VM en container
- De stappen die de gebruiker heeft ondernomen om het probleem vast te stellen, zijn vermeld
De aanvraag werd geregistreerd als "P1: Critische Impact - Service Onbruikbaar in productie", wat betekent dat de situatie 24/7 in de gaten wordt gehouden volgens het "Follow the Sun"-schema (hier kunt u meer lezen over ), met overdracht van team naar team telkens wanneer er een tijdzone verschuiving is. In feite had het probleem, tegen de tijd dat het bij ons team in Zürich aankwam, de wereldbol al rond gereisd. Tegen die tijd had de gebruiker maatregelen genomen om de gevolgen te verminderen, maar was bezorgd over herhaling van de situatie in productie, aangezien de oorzaak nog niet was ontdekt.
Op het moment dat het ticket in Zürich aankwam, hadden we al de volgende informatie:
- Inhoud
/etc/hosts - Inhoud
/etc/resolv.conf - Uitslag
iptables-save - Verzameld door het team
ngreppcap-bestand
Met deze gegevens waren we klaar om de fase van "onderzoek" en probleemoplossing te starten.
Onze eerste stappen
Allereerst hebben we de logs en de status van de metadata-server gecontroleerd en bevestigd dat deze goed werkte. De metadata-server antwoordt op het IP-adres 169.254.169.254 en is onder andere verantwoordelijk voor het beheer van domeinnamen. We hebben ook gecontroleerd of de firewall correct werkt met de VM en geen pakketten blokkeert.
Het was een vreemde situatie: een nmap-controle weerlegde onze belangrijkste hypothese van verloren UDP-pakketten, dus bedachten we nog een paar andere opties en manieren om deze te controleren:
- Verschijnen er selectief pakketten? => Controleer de iptables-regels
- Is het niet te weinig ? => Проверить вывод
ip a show - Raakt het probleem alleen UDP-pakketten of ook TCP? => Voer uit
dig +tcp - Worden de gegenereerde dig-pakketten teruggestuurd? => Voer uit
tcpdump - Werkt libdns correct? => Voer uit
straceom de pakketoverdracht in beide richtingen te controleren
Hier besluiten we om telefonisch contact op te nemen met de gebruiker om het probleem live op te lossen.
Tijdens het gesprek kunnen we verschillende zaken controleren:
- Na verschillende controles sluiten we de iptables-regels uit als oorzaak
- We controleren de netwerkinterfaces en de routeringstabellen en verifiëren de juistheid van de MTU
- We ontdekken dat
dig +tcp google.com(TCP) werkt zoals het hoort, maardig google.com(UDP) werkt niet - Na een test
tcpdumpwerkt het voorlopigniet in dit artikel te gebruiken., ontdekken we dat UDP-pakketten worden teruggestuurd - We draaien
strace dig google.comen zien hoe dig correctsendmsg()enrecvms(), maar de tweede wordt onderbroken door een timeout
Helaas eindigt de dienst en moeten we het probleem doorgeven aan de volgende tijdzone. Het verzoek heeft echter interesse gewekt in ons team, en een collega stelt voor om een bron-DNS-pakket te creëren met de Python-module scrapy.
from scapy.all import *

answer = sr1(IP(dst="169.254.169.254")/UDP(dport=53)/DNS(rd=1,qd=DNSQR(qname="google.com")),verbose=0)
print ("169.254.169.254", answer[DNS].summary())
Dit fragment creëert een DNS-pakket en stuurt de aanvraag naar de metadata-server.
De gebruiker voert de code uit, het DNS-antwoord wordt teruggestuurd en de applicatie ontvangt het, wat bevestigt dat er geen probleem op netwerkniveau is.
Na een nieuwe 'wereldreis' komt het verzoek terug naar ons team en neem ik het volledig over, omdat ik denk dat het voor de gebruiker handiger is als het verzoek niet meer rondcirculiert.
Ondertussen stemt de gebruiker vriendelijk in om een systeemkopie te verstrekken. Dit zijn geweldig nieuws: de mogelijkheid om zelf het systeem te testen versnelt het oplossen van problemen aanzienlijk, omdat ik niet langer de gebruiker hoef te vragen om commando's uit te voeren, mij resultaten te sturen en deze te analyseren; ik kan alles zelf doen!
Collega's beginnen me een beetje jaloers te worden. Tijdens de lunch bespreken we het verzoek, maar niemand heeft idee wat er aan de hand is. Gelukkig heeft de gebruiker zelf stappen ondernomen om de gevolgen te verzachten en heeft hij geen haast, dus we hebben tijd om het probleem te dissecteren. En omdat we een image hebben, kunnen we al onze interessante tests uitvoeren. Geweldig!
Terug komend op een stap
Een van de meest populaire vragen in een sollicitatiegesprek voor een systeemingenieur is: 'Wat gebeurt er wanneer je pingt' ?» Вопрос шикарный, так как кандидату необходимо описать пусть от оболочки до пользовательского пространства, до ядра системы и далее к сети. Я улыбаюсь: иногда вопросы с интервью оказываются полезны и в реальной жизни…
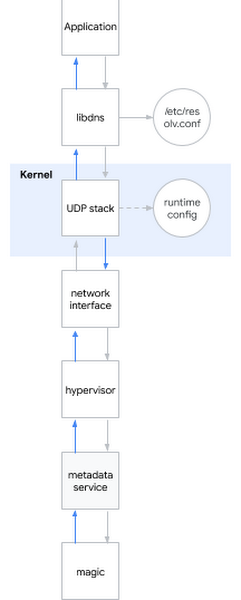
Ik besluit deze HR-vraag toe te passen op het huidige probleem. Grofweg, wanneer je probeert een DNS-naam te bepalen, gebeurt het volgende:
- De applicatie roept een systeembibliotheek aan, bijvoorbeeld libdns
- libdns controleert de systeemconfiguratie om naar welke DNS-server het moet verwijzen (in het diagram is dit 169.254.169.254, de metadata-server)
- libdns gebruikt systeemaanroepen om een UDP-socket (SOCK_DGRAM) te creëren en verzendt UDP-pakketten met DNS-verzoeken in beide richtingen
- Via de sysctl-interface kan de UDP-stack op kernniveau worden ingesteld
- De kernel communiceert met de hardware om pakketten over het netwerk via de netwerkaansluiting te verzenden
- De hypervisor vangt het pakket op en verzendt het naar de metadata-server bij contact
- De metadata-server bepaalt met zijn trucs de DNS-naam en retourneert het antwoord op dezelfde manier
Laten we herinneren welke hypotheses we al hebben overwogen:
Hypothese: Bibliotheken zijn beschadigd
- Test 1: voer strace op het systeem uit en controleer of dig de juiste systeemaanroepen doet
- Resultaat: de juiste systeemaanroepen worden gedaan
- Test 2: controleer met srapy of we namen kunnen bepalen om de systeembibliotheken heen
- Resultaat: dat kunnen we
- Test 3: voer rpm -V uit op het libdns-pakket en md5sum op de bibliotheekbestanden
- Resultaat: de bibliotheekcode komt volledig overeen met de code in het werkende besturingssysteem
- Test 4: koppel de root-systeem afbeelding van de gebruiker aan een VM zonder dergelijk gedrag, voer chroot uit en kijk of DNS werkt
- Resultaat: DNS werkt correct
Conclusie op basis van de tests: het probleem zit niet in de bibliotheken
Hypothese: Er is een fout in de DNS-instellingen
- Test 1: controleer tcpdump en observeer of de DNS-pakketten correct worden verzonden en teruggestuurd na het starten van dig
- Resultaat: de pakketten worden correct verstuurd
- Test 2: opnieuw controleren op de server
/etc/nsswitch.confen/etc/resolv.conf - Resultaat: alles klopt
Conclusie op basis van de tests: het probleem zit niet in de DNS-configuratie
Hypothese: de kernel is beschadigd
- Test: installeer een nieuwe kernel, controleer de handtekening, herstart
- Resultaat: vergelijkbaar gedrag
Conclusie op basis van de tests: de kernel is niet beschadigd
Hypothese: onjuiste werking van het gebruikersnetwerk (of de netwerkinstantie van de hypervisor)
- Test 1: controleer de firewall-instellingen
- Resultaat: de firewall laat DNS-pakketten door zowel op de host als op GCP
- Test 2: onderschep het verkeer en volg de correcte overdracht en retour van DNS-verzoeken
- Resultaat: tcpdump bevestigt de ontvangst van retourpakketten door de host
Conclusie op basis van de tests: het probleem zit niet in het netwerk
Hypothese: de metadata-server werkt niet
- Test 1: controleer de logs van de metadata-server op anomalieën
- Resultaat: er zijn geen anomalieën in de logs
- Test 2: omze de metadata-server via
dig @8.8.8.8 - Resultaat: resolutie is verstoord, zelfs zonder de metadata-server te gebruiken
Conclusie op basis van de tests: het probleem ligt niet bij de metadata-server
Conclusie: we hebben alle subsystemen getest, behalve runtime-instellingen!
Diep in de instellingen van de kernel-runtime
Voor het configureren van de kernel-runtime kunt u de commandoregelopties (grub) of de sysctl-interface gebruiken. Ik keek in /etc/sysctl.conf en wat bleek, ik ontdekte enkele aangepaste instellingen. Voel ik iets te pakken te krijgen, schrapte ik alle niet-netwerk- of niet-tcp-instellingen, en bleef met een handvol instellingen over: net.core. Toen ging ik naar waar de VM de hostrechten heeft en begon een voor een de instellingen van de defecte VM toe te passen, totdat ik de dader vond:
net.core.rmem_default = 2147483647Daar is het, de DNS-configuratie die het breekt! Ik heb het wapen van de misdaad gevonden. Maar waarom gebeurt dit? Ik had nog steeds een motief nodig.
De basisbufferinstelling voor DNS-pakketten wordt uitgevoerd via net.core.rmem_default. De typische waarde ligt ergens tussen de 200 KiB, maar als uw server veel DNS-pakketten ontvangt, kunt u de buffer vergroten. Als op het moment dat een nieuw pakket binnenkomt de buffer vol is, bijvoorbeeld omdat de applicatie het niet snel genoeg verwerkt, begint u pakketten te verliezen. Onze klant heeft de buffer-omvang correct vergroot omdat hij zich zorgen maakte over dataverlies, aangezien hij een applicatie voor het verzamelen van statistieken via DNS-pakketten gebruikte. De waarde die hij instelde, was maximaal: 231-1 (als je 231 instelt, retourneert de kernel "INVALID ARGUMENT").
Plotseling besefte ik waarom nmap en scapy correct werkten: ze gebruikten rauwe sockets! Rauwe sockets verschillen van gewone: zij omzeilen iptables en zijn niet gebufferd!
Maar waarom veroorzaakt een "te grote buffer" problemen? Het werkt duidelijk niet zoals bedoeld.
Op dit moment kon ik het probleem reproduceren op verschillende kernels en vele distributies. Het probleem deed zich al voor op kernel 3.x en vertoonde nu ook op kernel 5.x.
Inderdaad, bij het uitvoeren
sysctl -w net.core.rmem_default=$((2**31-1))werkte de DNS niet meer.
Ik begon bruikbare waarden te zoeken via een eenvoudig binaire zoekalgoritme en ontdekte dat het systeem werkte met 2147481343, maar dit getal was voor mij gewoon een betekenisloze reeks cijfers. Ik stelde de klant voor om dit nummer te proberen, en hij antwoordde dat het systeem werkte met google.com, maar nog steeds een fout gaf met andere domeinen, dus ik zette mijn onderzoek voort.
Ik heb ingesteld , een tool die ik eerder had moeten gebruiken: het toont precies waar het pakket in de kernel terechtkomt. De boosdoener bleek de functie te zijn udp_queue_rcv_skb. Ik heb de kernelbronnen gedownload en enkele codelijnen toegevoegd om te volgen waar het pakket precies terechtkomt. Ik ontdekte snel de relevante voorwaarde als, en een tijdje staarde ik er gewoon naar, want op dat moment viel alles eindelijk op zijn plaats: 231-1, een betekenisloos getal, een niet-werkend domein… Het was een stukje code in __udp_enqueue_schedule_skb:
if (rmem > (size + sk->sk_rcvbuf))
		goto uncharge_drop;
Let op:
rmemis van het type intsizeis van het type u16 (ongeschreven 16-bits int) en houdt de grootte van het pakket vastsk->sk_rcvbufis van het type int en houdt de grootte van de buffer vast, die per definitie gelijk is aan de waarde innet.core.rmem_default
Wanneer sk_rcvbuf benadert 231, waardoor het optellen van de pakketgrootte kan leiden tot . En omdat dit int is, wordt de waarde negatief, zodat de voorwaarde waar wordt wanneer deze vals zou moeten zijn (meer hierover kun je lezen in ).
De fout wordt triviaal verholpen door het om te zetten naar unsigned int. Ik paste de oplossing toe en herstartte het systeem, waarna DNS weer werkte.
De smaak van overwinning
Ik stuurde mijn bevindingen naar de klant en verzond de kernelpatch. Ik ben tevreden: elk stukje van de puzzel viel op zijn plaats, ik kan precies uitleggen waarom we zagen wat we zagen, en het belangrijkste is dat we dankzij samenwerking een oplossing voor het probleem konden vinden!
Het moet worden erkend dat de situatie zeldzaam was, en gelukkig ontvangen we zelden zulke complexe verzoeken van gebruikers.
Bron: habr.com
