

Hallo iedereen, mijn naam is Sergey Emelyanchik. Ik ben de leidinggevende van het bedrijf Audit-Telecom, de hoofdontwikkelaar en de auteur van het Veliam-systeem. Ik besloot een artikel te schrijven over hoe mijn vriend en ik een outsourcingbedrijf oprichtten, software voor onszelf ontwikkelden en uiteindelijk begonnen met het verspreiden ervan aan iedereen die geïnteresseerd was via het SaaS-systeem. Over hoe ik absoluut niet geloofde dat dit mogelijk was. In het artikel zal ik niet alleen het verhaal vertellen, maar ook technische details delen over hoe het Veliam-product werd ontwikkeld, inclusief enkele stukjes broncode. Ik zal vertellen welke fouten we maakten en hoe we deze later corrigeerden. Er waren twijfels over het publiceren van een dergelijk artikel. Maar ik dacht dat het beter was om het te doen, feedback te krijgen en te verbeteren, dan om het artikel niet te publiceren en je af te vragen wat er zou zijn gebeurd als...
Achtergrond
Ik werkte bij een bedrijf als IT-medewerker. Het bedrijf was vrij groot met een uitgebreid netwerk. Ik zal niet ingaan op mijn taken, ik zeg alleen dat ontwikkeling daar zeker niet bij hoorde.
We hadden monitoring, maar uit puur academisch belang wilden we proberen onze eigen eenvoudige versie te schrijven. Het idee was als volgt: het moest web-based zijn, zodat je gemakkelijk zonder installatie van clients kon inloggen en kon zien wat er met het netwerk gebeurde vanaf elk apparaat, inclusief mobiele apparaten via Wi-Fi. Ook wilden we snel begrijpen in welke ruimte de apparatuur zich bevond die 'problemen vertoonde', omdat er strenge eisen waren aan de reactietijd voor dergelijke problemen. Uiteindelijk ontstond in mijn hoofd het plan om een eenvoudige webpagina te schrijven, met een JPEG-achtergrond van het netwerkdiagram, de apparaten met hun IP-adressen uit dat plaatje te knippen en vervolgens bovenop het plaatje dynamische inhoud weer te geven in de vorm van groene of knipperende rode IP-adressen op de juiste coördinaten. De taak was gesteld, we beginnen.
Eerder heb ik geprogrammeerd met Delphi, PHP, JS en heb ik oppervlakkige kennis van C++. Ik begrijp netwerken vrij goed. VLAN, Routing (OSPF, EIGRP, BGP), NAT. Dit was voldoende om een prototype van primitieve monitoring zelfstandig te schrijven.
Ik schreef wat ik in gedachten had op PHP. De server draaide op Apache en PHP was op Windows, omdat Linux voor mij op dat moment iets onbegrijpelijks en erg ingewikkeld was. Achteraf gezien heb ik me daar flink in vergist, want op veel plekken is Linux veel gemakkelijker dan Windows. Maar dat is een apart onderwerp, en we weten allemaal hoeveel discussies hierover zijn. De Windows Taakplanner riep met een korte interval (ik weet het niet zeker, maar iets als één keer per drie seconden) een PHP-script aan dat alle objecten simpelweg pingde en de status in een bestand opsloeg.
system("ping -n 3 -w 100 {$ip_address}");
Ja, ja, werken met de database was op dat moment ook niet mijn sterkste punt. Ik wist niet dat je processen kon paralleliseren, en het doorlopen van alle knooppunten in het netwerk kostte veel tijd, omdat dit in één enkele thread gebeurde. Vooral problemen deden zich voor wanneer meerdere knooppunten niet beschikbaar waren, omdat elk knooppunt het script 300 ms vertraagde. Aan de clientzijde was er een eenvoudige lusfunctie die om de paar seconden de bijgewerkte informatie van de server ophaalde met een Ajax-aanroep en de interface bijwerkte. Na drie mislukte pings achter elkaar, als er een webpagina met monitoring op de computer was geopend, speelde er een vrolijk deuntje.
Toen alles gelukt was, was ik zeer geïnspireerd door het resultaat en dacht ik dat het mogelijk was om er nog meer aan toe te voegen (gezien mijn kennis en mogelijkheden). Maar ik hield nooit van systemen met een miljoen grafieken, die, zoals ik toen dacht en nog steeds geloof, in de meeste gevallen overbodig zijn. Ik wilde alleen datgene integreren wat me daadwerkelijk zou helpen in mijn werk. Dit principe is tot op de dag van vandaag de basis gebleven bij de ontwikkeling van Veliam. Verder realiseerde ik me dat het geweldig zou zijn als ik geen monitoringsysteem hoefde open te houden en op de hoogte was van problemen, maar dat ik, wanneer een probleem zich voordeed, de pagina kon openen en kon zien waar het probleem in het netwerk zich bevond en wat ik daar verder mee moest doen. Ik las mijn e-mail toen niet, gebruikte het simpelweg niet. Ik kwam op internet tegen dat er SMS-gateways zijn, waar je een GET- of POST-verzoek naartoe kunt sturen, en die zullen me een SMS met de tekst die ik schrijf naar mijn mobiele telefoon sturen. Ik begreep meteen dat ik dit heel graag wilde. En ik begon de documentatie te bestuderen. Na enige tijd lukte het me, en nu ontving ik SMS-berichten over problemen in het netwerk op mijn mobiel met de naam van het 'gevallen object'. Hoewel het systeem primitieff was, was het door mijzelf geschreven, en het belangrijkste dat me toen motiveerde voor de ontwikkeling ervan, was dat het een praktische toepassing was die me daadwerkelijk hielp in mijn werk.
En zo kwam de dag waarop een van de internetverbindingen op het werk uitviel, en mijn monitoring gaf me daar op geen enkele manier een signaal over. De DNS-servers van Google pingden nog steeds uitstekend. Het was tijd om na te denken over hoe ik kon monitoren of de verbinding actief was. Er waren verschillende ideeën over hoe dit te doen. Ik had niet tot al het apparatuur toegang. Ik moest bedenken hoe ik kon begrijpen welke van de verbindingen actief was, zonder de mogelijkheid te hebben om dit op de netwerkapparatuur te bekijken. Toen stelde een collega het idee voor dat de traceroute naar publieke servers afhankelijk zou kunnen zijn van welke verbinding momenteel voor internet wordt gebruikt. Ik controleerde het en zo bleek het te zijn. De traceroutes waren verschillend.
system(“tracert -d -w 500 8.8.8.8”);
Zo ontstond er alweer een script, en beter gezegd, werd de tracering om de een of andere reden aan het einde van hetzelfde script toegevoegd, dat alle apparaten in het netwerk pinde. Want dit is weer een langdurig proces dat in dezelfde thread werd uitgevoerd en de werking van het hele script vertraagde. Maar toen was dit niet zo vanzelfsprekend. Hoe dan ook, het deed zijn werk; in de code was hard gecodeerd hoe de tracering voor elk van de kanalen moest zijn. Zo begon het systeem te werken, dat al (toegegeven, dat is een groot woord, aangezien er geen metrics werden verzameld, maar gewoon ping) netwerkapparaten (routers, switches, wi-fi, enz.) en communicatielijnen met de buitenwereld monitoren. SMS-berichten kwamen betrouwbaar binnen en op het schema was het altijd goed te zien waar het probleem lag.
Vervolgens moest ik in het dagelijkse werk me bezighouden met cross-linking. Iedere keer weer op de Cisco-switches inloggen om te kijken welke interface ik moest gebruiken, begon me te vervelen. Het zou geweldig zijn om op de monitoring te klikken op een object en een lijst met interfaces en beschrijvingen te zien. Dit zou me tijd besparen. Bovendien hoefde ik in dit schema geen Putty of SecureCRT op te starten, inloggegevens en commando's in te voeren. Gewoon op de monitoring klikken, zien wat nodig is en verder met mijn werk gaan. Ik begon te zoeken naar manieren om met de switches te communiceren. Er kwamen meteen twee opties naar voren: SNMP of inloggen op de switch via SSH, de benodigde commando's invoeren en de resultaten parseren. Ik verwierp SNMP vanwege de complexiteit van implementatie; ik wilde snel resultaat. Met SNMP zou ik lang in de MIB moeten graven, op basis van die gegevens informatie over de interfaces te vormen. Er is een geweldige commando in CISCO.
show interface statusHet laat precies zien wat ik nodig heb voor crossovers. Waarom moeilijk doen met SNMP, als ik gewoon de uitvoer van dit commando wil zien, dacht ik. Na enige tijd heb ik die mogelijkheid gerealiseerd. Ik klikte op het object op de webpagina. Een gebeurtenis werd geactiveerd waardoor de cliënt via AJAX de server benaderde, en de server op zijn beurt via SSH verbinding maakte met de switch die ik nodig had (de inloggegevens waren in de code ingebakken, ik had geen zin om het te verfraaien of aparte menu's te maken waar ik de inloggegevens vanuit de interface kon wijzigen; ik wilde resultaat en wel snel) voerde het bovengenoemde commando in en gaf het terug in de browser. Zo begon ik met één muisklik informatie over de interfaces te zien. Dit was uiterst handig, vooral wanneer ik deze informatie op meerdere switches tegelijkertijd moest bekijken.
Monitoring van kanalen op basis van tracering bleek uiteindelijk geen zo'n goed idee te zijn, omdat er soms werkzaamheden aan het netwerk werden uitgevoerd, en de tracering kon veranderen, waardoor de monitoring me begon te waarschuwen dat er problemen waren met het kanaal. Maar na veel tijd besteed aan analyse, begreep ik dat alle kanalen werkten, terwijl mijn monitoring me bedrog. Uiteindelijk vroeg ik collega's die de kanaalvormende switches beheerden om me gewoon syslog te sturen wanneer de zichtbaarheid van buren (neighbor) veranderde. Dit was veel eenvoudiger, sneller en betrouwbaarder dan tracering. Wanneer er een gebeurtenis van het type neighbor lost kwam, deed ik meteen een melding van de kanaaluitval.
Vervolgens kwamen er uitvoer op klikken op objecten, nog enkele commando's en werd SNMP toegevoegd voor het verzamelen van bepaalde metrics, en dat was het eigenlijk. Het systeem ontwikkelde verder niet. Het deed alles wat ik nodig had, het was een goed hulpmiddel. Veel lezers zullen me waarschijnlijk vertellen dat er al veel software op internet is voor deze taken. Maar in werkelijkheid kon ik toen geen gratis producten vinden en ik wilde mijn programmeervaardigheden echt ontwikkelen, en wat kan daar beter toe aanzetten dan een echte pragmatische uitdaging. Zo was de eerste versie van de monitoring voltooid en werd deze niet verder aangepast.
Oprichting van het bedrijf Audit-Telecom
Na verloop van tijd begon ik ook werk te doen voor andere bedrijven, gelukkig stond mijn werkschema dat toe. Wanneer je bij verschillende bedrijven werkt, groei je snel in verschillende gebieden en ontwikkel je je perspectief goed. Er zijn bedrijven waarin, zoals men zegt, je zowel een schoenmaker, een graanmaaier als een muzikant bent. Enerzijds is dat moeilijk, anderzijds, als je niet lui bent, word je een specialist met een breed profiel en dat stelt je in staat om problemen sneller en effectiever op te lossen, omdat je weet hoe gerelateerde gebieden werken.
Mijn vriend Pavel (ook een IT-er) probeerde me constant te bewegen naar zijn eigen onderneming. Er waren ontelbare ideeën met verschillende varianten van een eigen bedrijf. Dit werd niet een jaar lang besproken. En uiteindelijk leidde het tot niets, omdat ik een skepticus ben en Pavel een dromer. Elke keer als hij een idee voorstelde, geloofde ik er niet in en weigerde deel te nemen. Maar we wilden zo graag ons eigen bedrijf starten.
Uiteindelijk konden we een optie vinden die ons beide beviel en ons bezighouden met wat we kunnen. In 2016 besloten we een IT-bedrijf op te richten dat bedrijven helpt bij het oplossen van IT-vraagstukken. Dit omvat de implementatie van IT-systemen (1C, terminalservers, mailserver, etc.), onderhoud, klassieke HelpDesk voor gebruikers en netwerkbeheer.
Eerlijk gezegd geloofde ik 99,9% niet in het bedrijf op het moment dat het werd opgericht. Maar op de een of andere manier kon Pavel me overtuigen om het een kans te geven, en vooruitkijkend, hij had gelijk. Pavel en ik hebben elk 300.000 roebel ingelegd, we registreerden een nieuw OOO "Audit-Telecom", huurden een klein kantoor, maakten coole visitekaartjes - zoals veel onervaren, startende ondernemers, en begonnen klanten te zoeken. Het zoeken naar klanten is op zich al een apart verhaal. Misschien schrijven we er een apart artikel over in onze bedrijfsblog als er belangstelling voor is. Koude belletjes, flyers, enzovoort. Dit leverde geen resultaten op. Zoals ik nu uit veel verhalen over bedrijven lees, hangt veel af van geluk. Wij hebben geluk gehad. En letterlijk een paar weken na de oprichting van het bedrijf, benaderde mijn broer Vladimir ons en bracht hij onze eerste klant binnen. Ik zal je niet vermoeien met de details van het werken met klanten, dat is niet waar dit artikel over gaat; ik zeg alleen dat we op audit zijn gegaan, kritieke punten hebben geïdentificeerd en deze punten zijn bezweken terwijl er een beslissing werd genomen over het al dan niet samenwerken met ons op een permanente basis als outsourcers. Meteen daarna werd er een positieve beslissing genomen.
Daarna, voornamelijk via mond-tot-mondreclame, begonnen er ook andere bedrijven bij ons ondergebracht te worden. De helpdesk was in één systeem. Verbindingen met netwerkapparatuur en servers in een ander, of liever, bij wie hoe. Sommigen bewaarden snelkoppelingen, anderen gebruikten RDP-adresboeken. Monitoring was weer een apart systeem. Voor het team is het erg ongemakkelijk om in verschillende systemen te werken. Belangrijke informatie gaat verloren. Bijvoorbeeld, als de terminalserver van een klant niet beschikbaar is. Medewerkers van die klant dienen onmiddellijk aanvragen in. Een supportmedewerker registreert de aanvraag (deze kwam binnen via de telefoon). Als incidenten en aanvragen in één systeem zouden worden geregistreerd, zou de supportmedewerker meteen zien wat er aan de hand was bij de gebruiker en het hem kunnen vertellen, terwijl hij tegelijkertijd al verbinding zou maken met het juiste object om de situatie aan te pakken. Iedereen is op de hoogte van de tactische situatie en werkt gecoördineerd. We hebben zo'n systeem niet gevonden waar al dit samengevoegd is. Het is duidelijk geworden dat het tijd was om ons eigen product te maken.
Voortzetting van het werk aan ons eigen monitoringssysteem
Het was duidelijk dat het systeem dat eerder was geschreven helemaal niet geschikt was voor de huidige taken. Niet qua functionaliteit, en ook niet qua kwaliteit. Er werd besloten om het systeem vanaf nul opnieuw te schrijven. Grafisch zou het er heel anders uit moeten zien. Het moest een hiërarchisch systeem zijn, zodat het snel en eenvoudig mogelijk was om het benodigde object van de juiste klant te openen. Het schema, zoals in de eerste versie, was in dit geval absoluut niet gerechtvaardigd, omdat de klanten verschillend waren en het helemaal niet uitmaakte in welke ruimtes de apparatuur zich bevond. Dit was al vastgelegd in de documentatie.
Dus, de taken:
- Hiërarchische structuur;
- Een soort servercomponent die bij de klant kan worden geplaatst in de vorm van een virtuele machine voor het verzamelen van de noodzakelijke metrics en het verzenden naar de centrale server, die dit alles zal samenvoegen en ons zal tonen;
- Waarschuwingen. Al zodanig, dat ze niet kunnen worden gemist, omdat er op dat moment geen mogelijkheid was voor iemand om gewoon naar het scherm te kijken;
- Aanvraag systeem. Klanten begonnen te verschijnen waarvoor we niet alleen de server- en netwerken als apparatuur verzorgden, maar ook werkstations;
- De mogelijkheid om snel verbinding te maken met servers en apparatuur vanuit het systeem;
De taken zijn vastgesteld, we beginnen te schrijven. Ondertussen verwerken we aanvragen van klanten. Op dat moment waren we al met zijn vieren. We begonnen direct met beide delen te schrijven: de centrale server en de server voor installatie bij klanten. Tegen die tijd was Linux ons al niet onbekend en werd besloten dat de virtuele machines die bij klanten zouden staan, op Debian zouden draaien. Er zullen geen installateurs zijn, we maken gewoon een project voor de servercomponent op een specifieke virtuele machine, en daarna zullen we deze gewoon klonen naar de benodigde klant. Dit was een nieuwe fout. Later werd duidelijk dat in zo'n schema het mechanisme voor updates absoluut niet was doordacht. Dat wil zeggen, we voegden een nieuwe functie toe en vervolgens was het een heel probleem om deze naar alle servers van klanten te verspreiden, maar daar komen we later op terug, alles op zijn tijd.
We created the first prototype. It could ping the necessary network devices of our clients and servers and send this data to our central server. The central server, in turn, updated this data in the overall mass on the central server. Here, I will write not only the history of what was achieved, but also what amateur mistakes were made and how we had to pay for them with time. So, all the object tree was stored in a single file as a serialized object. While we connected a few clients to the system, everything was more or less normal, although there were sometimes some artifacts that were completely unclear. But when we connected a dozen servers to the system, wonders began to happen. Sometimes, for unknown reasons, all objects in the system simply disappeared. It is important to note that the servers that were with the clients sent data to the central server every few seconds via a POST request. A careful reader and experienced programmer has already guessed that a problem of concurrent access to the same file, which stored the serialized object, occurred from multiple threads simultaneously. And just when this happened, the wonders of disappearing objects manifested. The file simply became empty. But this was not discovered immediately, only during operation with several servers. During this time, functionality for port scanning was added (the servers sent not only information about the availability of devices to the central server, but also about the open ports on them). This was done by calling the command:
$connection = @fsockopen($ip, $port, $errno, $errstr, 0.5);
The results were often incorrect, and the scanning took a very long time. I completely forgot about the ping, which was executed via fping:
system("fping -r 3 -t 100 {$this->ip}");
This too was not parallelized, so the process was very slow. Later, fping was already given the entire list of IP addresses that needed to be checked at once, and we received a ready list of those who responded back. Unlike us, fping could parallelize processes.
Een andere veelvoorkomende routineklus was het instellen van bepaalde diensten via het WEB. Bijvoorbeeld, ECP van MS Exchange. In feite is het gewoon een link. We besloten dat we de mogelijkheid moesten bieden om zulke links rechtstreeks in het systeem toe te voegen, zodat we niet in de documentatie of ergens anders in onze bladwijzers hoefden te zoeken hoe we op de specifieke ECP van een klant konden inloggen. Zo is het begrip resource links voor het systeem ontstaan, waarvan de functionaliteit tot op de dag van vandaag beschikbaar is gebleven en bijna geen veranderingen heeft ondergaan.
De werking van resource links in Veliam
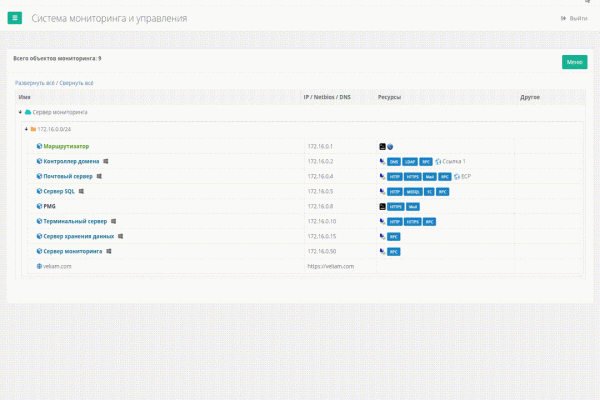
Afstandsverbindingen
Zo ziet het eruit in de huidige versie van Veliam
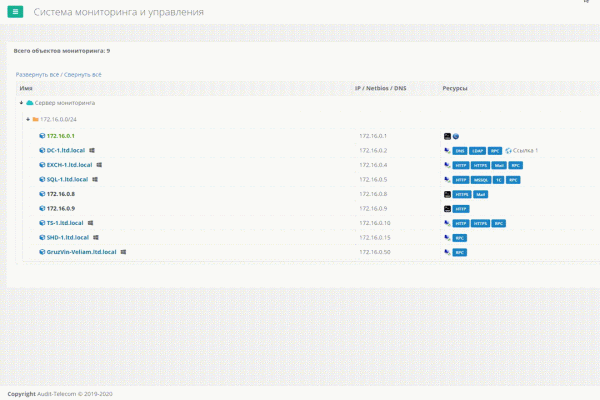
Een van de taken was om snel en gemakkelijk verbinding te maken met servers, waarvan er al veel zijn (meer dan een honderd) en het doorbladeren van miljoenen vooraf opgeslagen RDP-snelkoppelingen was uiterst ongemakkelijk. We hadden een hulpmiddel nodig. Er is internetsoftware die zich gedraagt als een soort adresboek voor zulke RDP-verbindingen, maar ze zijn niet geïntegreerd met het monitoringsysteem en de inloggegevens kunnen niet worden opgeslagen. Elke keer inloggegevens invoeren voor verschillende klanten is een ware hel, wanneer je op een dag tientallen keren met verschillende servers verbinding maakt. Met SSH is het iets beter, er is veel goede software waarin je zulke verbindingen in mappen kunt indelen en de inloggegevens kunt onthouden. Maar er zijn twee problemen. Ten eerste — we hebben geen enkele applicatie gevonden voor RDP- en SSH-verbindingen. Ten tweede — als ik op een bepaald moment niet achter mijn computer ben en snel verbinding moet maken, of als ik gewoon het systeem heb herinstalleren, moet ik in de documentatie duiken om de inloggegevens van die klant te bekijken. Dit is ongemakkelijk en een verspilling van tijd.
De hiërarchische structuur van de servers van onze klanten was al aanwezig in ons interne product. We moesten alleen nog bedenken hoe we daar snelle verbindingen met het benodigde apparatuur aan konden koppelen. Tenminste binnen ons eigen netwerk.
Aangezien de cliënt in ons systeem de browser was, die geen toegang heeft tot lokale computerbronnen om een applicatie met een simpel commando te starten, is er gekozen voor een 'Windows custom url scheme'. Zo ontstond er een soort 'plugin' voor ons systeem, dat simpelweg Putty en Remote Desktop Plus omvatte en bij installatie de URI-schema registratief in Windows. Nu, wanneer we verbinding wilden maken met een object via RDP of SSH, klikten we op deze actie in ons systeem en werd de Custom URI geactiveerd. De standaard mstsc.exe, ingebouwd in Windows, of Putty, dat deel uitmaakte van de 'plugin', werd geopend. Ik gebruik het woord plugin tussen aanhalingstekens, omdat het niet als een klassieke browserplugin wordt beschouwd.
Dit was al iets. Een handige adressenboek. In het geval van Putty werkte alles prima; je kon IP-verbindingen, gebruikersnaam en wachtwoord als invoerparameters opgeven. Dus we konden met een klik verbinding maken met Linux-servers in ons netwerk zonder wachtwoorden in te voeren. Maar met RDP was het niet zo eenvoudig. In de standaard mstsc kan je geen inloggegevens als parameters doorgeven. Daar kwam Remote Desktop Plus om de hoek kijken. Dit maakte het mogelijk. Nu kunnen we zonder hem, maar lange tijd was hij een trouwe assistent in ons systeem. Met HTTP(S) sites was het simpel; dergelijke objecten werden gewoon in de browser geopend, wat handig en praktisch was. Maar dit geluk gold alleen binnen het interne netwerk.
Omdat we het merendeel van de problemen op afstand vanuit kantoor oplosten, was het simpelste om VPN's naar de klanten te maken. En zo konden we vanuit ons systeem verbinding maken met hen. Maar het was nog steeds enigszins ongemakkelijk. Voor elke klant moest op elke computer een hoop opgeslagen verbindingen worden bewaard. VPN verbindingen en voordat je met een van hen verbinding kon maken, moest je de bijbehorende VPN inschakelen. We gebruikten deze oplossing lange tijd. Maar het aantal klanten nam toe, het aantal VPN's ook, en dit begon te vervelend te worden; hier moest iets mee gedaan worden. Vooral na het opnieuw installeren van het systeem kwam de tranen in mijn ogen, als ik tientallen VPN-verbindingen opnieuw in een nieuw Windows-profiel moest invoeren. Genoeg is genoeg, zei ik, en begon na te denken over wat we hieraan konden doen.
Het is gebruikelijk dat al onze klanten routers van het beroemde merk Mikrotik gebruiken. Ze zijn zeer functioneel en handig voor bijna elke taak. Aan de nadelen — ze worden vaak 'gekaapt'. We hebben dit probleem eenvoudig opgelost door alle externe toegang te blokkeren. Maar we moesten op de een of andere manier toegang tot hen hebben zonder naar de locatie van de klant te reizen, omdat dat tijdrovend is. We hebben gewoon tunnels naar elk van deze Mikrotiks gemaakt en ze in een aparte pool geplaatst, zonder enige routering, zodat er geen verbinding gemaakt kon worden tussen ons netwerk en die van de klanten of tussen de netwerken van de klanten onderling.
Het idee kwam op om te zorgen dat wanneer ik op het gewenste object in het systeem klikte, de centrale monitoringserver, met de SSH-inloggegevens van alle klant-Mikrotiks, verbinding maakte met de juiste, een doorstuurregel aanmaakte naar de gewenste host via de juiste poort. Er waren verschillende zaken. De oplossing is niet universeel — het werkt alleen voor Mikrotik, aangezien de syntaxis van commando's voor andere routers verschillend is. Bovendien moesten deze doorstuurregels later ook weer verwijderd worden, maar de serverkant van ons systeem kon op dat moment niet bijhouden of ik mijn RDP-sessie had beëindigd. En zo'n doorstuurregel is een veiligheidsrisico voor de klant. We streefden ook niet naar universaliteit, omdat het product uitsluitend binnen ons bedrijf werd gebruikt en er zelfs niet aan gedacht werd om het openbaar te maken.
Elke van de problemen werd op zijn eigen manier opgelost. Wanneer er een regel werd aangemaakt, was de doorstuur slechts toegankelijk voor één specifiek extern IP-adres (van waaruit de verbinding was initieel gemaakt). Zo zijn we erin geslaagd om beveiligingslekken te vermijden. Maar bij elke dergelijke verbinding werd er een regel aan de Mikrotik op de NAT-pagina toegevoegd die niet werd gewist. En zoals we allemaal weten, hoe meer regels er zijn, hoe meer de processor van de router wordt belast. En in het algemeen kon ik het niet accepteren dat ik ooit op een bepaalde Mikrotik inlog, en er daar honderden dode, onnodige regels staan.
Aangezien onze server de status van de verbinding niet kan bijhouden, laat MikroTik dit zelf doen. Ik heb een script geschreven dat continu alle port forwarding-regels met een bepaalde beschrijving (description) volgde en controleerde of er een TCP-verbinding met de juiste regel was. Als die er al een tijdje niet was, is de verbinding waarschijnlijk beëindigd en kan de forwarding worden verwijderd. Het is allemaal gelukt, het script werkte goed.
Trouwens, hier is het:
global atmonrulecounter {"dontDelete"="dontDelete"}
:foreach i in=[/ip firewall nat find comment~"atmon_script_main"] do={
	local dstport [/ip firewall nat get value-name="dst-port" $i]
	local dstaddress [/ip firewall nat get value-name="dst-address" $i]
	local dstaddrport "$dstaddress:$dstport"
	#log warning message=$dstaddrport
	local thereIsCon [/ip firewall connection find dst-address~"$dstaddrport"]
	if ($thereIsCon = "") do={
		set ($atmonrulecounter->dstport) ($atmonrulecounter->dstport + 1)
		#:log warning message=($atmonrulecounter->dstport)
		if (($atmonrulecounter->dstport) > 5) do={
			#log warning message="Removing nat rules added automatically by atmon_script"
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_main_$dstport"]
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_sub_$dstport"]
			set ($atmonrulecounter->dstport) 0
		}
	} else {
		set ($atmonrulecounter->dstport) 0
	}
}
Zeker, het had mooier, sneller, enzovoort kunnen zijn, maar het werkte, belastte de MikroTiks niet en deed prima zijn werk. We konden eindelijk eenvoudig met één muisklik verbinding maken met de servers en netwerkapparatuur van klanten. Zonder VPN op te starten en zonder wachtwoorden in te voeren. Het werkte echt heel handig. De tijd voor onderhoud nam af, en we besteedden onze tijd aan werk, niet aan het maken van verbinding met de benodigde objecten.
Mikrotik Back-up
We hadden de back-up van alle MikroTiks op FTP ingesteld. En over het algemeen ging alles goed. Maar wanneer we een back-up nodig hadden, moesten we die FTP openen en het daar zoeken. We hebben een systeem waar alle routers zijn opgeslagen, we weten hoe we met de apparaten via SSH moeten communiceren. Waarom zouden we het systeem niet zo kunnen maken dat het dagelijks back-ups van alle MikroTiks ophaalt, dacht ik. En begon het te implementeren. We maakten verbinding, maakten een back-up en haalden deze op in de opslag.
PHP scriptcode voor het maken van een back-up van MikroTik:
<?php

	$IP = '0.0.0.0';
	$LOGIN = 'admin';
	$PASSWORD = '';
	$BACKUP_NAME = 'test';

    $connection = ssh2_connect($IP, 22);

    if (!ssh2_auth_password($connection, $LOGIN, $PASSWORD)) exit;

    ssh2_exec($connection, '\/system backup save name="atmon" password="atmon"');
    stream_get_contents($connection);
    ssh2_exec($connection, '\/export file="atmon.rsc"');
    stream_get_contents($connection);
    sleep(40); \/\/ Waiting bakup makes

    $sftp = ssh2_sftp($connection);

    \/\/ Download backup file
    $size = filesize("ssh2.sftp:\/\/ $sftp\/atmon.backup");
    $stream = fopen("ssh2.sftp:\/\/ $sftp\/atmon.backup", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read < $len && ($buf = fread($stream, $len - $read))) {
        $read += strlen($buf);
        $contents .= $buf;
    }
    file_put_contents ($BACKUP_NAME . '.backup', $contents);
    @fclose($stream);

    sleep(3);
    \/\/ Download RSC file
    $size = filesize("ssh2.sftp:\/\/ $sftp\/atmon.rsc");
    $stream = fopen("ssh2.sftp:\/\/ $sftp\/atmon.rsc", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read
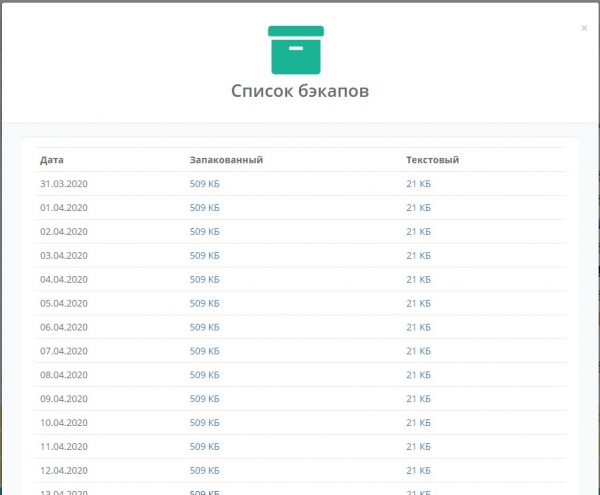
De backup wordt in twee vormen gemaakt: als binair bestand en als tekstconfiguratie. Het binaire bestand helpt om snel de benodigde configuratie te herstellen, terwijl het tekstbestand inzicht biedt in wat er moet gebeuren als er noodgedwongen hardware vervangen moet worden en het binaire bestand niet kan worden geïnstalleerd. Dit heeft geresulteerd in nog een handige functie in het systeem. Bovendien was het bij het toevoegen van nieuwe Mikrotiks niet nodig om iets in te stellen, je voegde gewoon het object aan het systeem toe en gaf het een SSH-account. Vervolgens zorgde het systeem zelf voor het maken van back-ups. In de huidige versie van SaaS Veliam is deze functie nog niet beschikbaar, maar we zullen deze binnenkort implementeren.
Screenshots van hoe dit eruitzag in het interne systeem
Overstappen op normale opslag in de database
Boven heb ik al geschreven dat er artefacten verschenen. Soms verdween gewoon de hele lijst met objecten in het systeem, soms werd de informatie niet opgeslagen bij het bewerken van een object en moest ik het object wel drie keer hernoemen. Dit irriteerde iedereen enorm. Het verdwijnen van objecten kwam zelden voor en kon gemakkelijk hersteld worden door dat specifieke bestand te herstellen, maar de storing bij het bewerken van objecten deed zich regelmatig voor. Waarschijnlijk heb ik het aanvankelijk niet via de database gedaan, omdat ik me niet kon voorstellen hoe je een boom met alle relaties in een platte tabel zou houden. Het is immers plat, terwijl een boom hiërarchisch is. Maar een goede oplossing voor gelijktijdige toegang, en later (bij een complexere systeem) ook transactiebeheer, is een DBMS. Ik ben vast niet de eerste die met dit probleem is geconfronteerd. Ik begon te googelen. Het bleek dat er al veel was uitgevonden voor mij en dat er verschillende algoritmen zijn die een boom uit een platte tabel construeren. Nadat ik elk had bekeken, implementeerde ik er één. Maar dit was al een nieuwe versie van het systeem, omdat ik eigenlijk om deze reden behoorlijk veel opnieuw moest schrijven. Het resultaat was logisch, de problemen van willekeurig gedrag van het systeem waren verdwenen. Iemand kan zeggen dat de fouten zeer amateuristisch zijn (eenzame scripts, het opslaan van informatie waartoe meerdere gelijktijdige toegang uit verschillende threads vanuit een bestand had, enzovoort) binnen softwareontwikkeling. Misschien is dat zo, maar mijn belangrijkste werk was systeembeheer, en programmeren was een zijtak voor de ziel, en ik had simpelweg geen ervaring met werken in een team van programmeurs, waar zulke elementaire dingen me meteen door oudere collega’s zouden worden uitgelegd. Daarom heb ik al deze fouten zelf gemaakt, maar ik heb het materiaal zeer goed geleerd. En bovendien, mijn werk omvat ook klantontmoetingen, pogingen om het bedrijf te promoten, talloze administratieve kwesties binnen het bedrijf, en nog veel meer. Maar hoe dan ook, wat er al was, was gewild. De jongens en ik gebruiken het product in ons dagelijks werk. Er waren ook openlijk mislukte ideeën en oplossingen waarvoor tijd werd besteed, en uiteindelijk werd duidelijk dat het niet werkende instrumenten waren en niemand ze gebruikte en dat ze niet in Veliam verschenen.
Klantenservice — HelpDesk
Het is goed om te vermelden hoe het HelpDesk is ontstaan. Dit is eigenlijk een apart verhaal, want bij Veliam is dit alweer de derde geheel nieuwe versie, die verschilt van alle voorgaande. Momenteel is het een eenvoudig systeem, intuïtief te begrijpen zonder overbodige franjes en options, met de mogelijkheid om te integreren met een domein, en ook met de optie om vanuit elke locatie toegang te krijgen tot dezelfde gebruikersprofiel via een link in een e-mail. En het belangrijkste is dat je vanuit elke locatie (of ik nu thuis of op kantoor ben) verbinding kunt maken met de aanvrager via VNC, rechtstreeks vanuit de aanvraag, zonder VPN of poortforwarding. Ik zal uitleggen hoe we hier zijn gekomen, wat er tot nu toe is gebeurd en welke verschrikkelijke oplossingen we hebben gebruikt.
We connected to users via the well-known TeamViewer. TeamViewer was installed on all computers of the users we serviced. The first mistake we made, which we later eliminated, was tying each client's HWID to the hardware. How did a user log into the HWID system to submit a request? In addition to TeamViewer, a special utility written in Lazarus was also installed on their computers (many will raise their eyebrows at this, and may even Google what it is, but from the compilers I knew best, Delphi was the most familiar, and Lazarus is almost the same, just free). In general, the user executed a special batch file that launched this utility, which in turn read the system's HWID, and then the browser would be launched and authorization would take place. Why was this done? In some companies, the calculation of serviced users is done individually, and the service cost for each month is formed based on the number of people. This is understandable, you might say, but why the tie to the hardware? Very simple: some individuals would come home and submit requests from their home laptops in the style of 'make everything nice for me here.' In addition to reading the system's HWID, the utility extracted the current TeamViewer ID from the registry and sent it to us as well. TeamViewer has an API for integration, and we implemented this integration. But there was one catch. Through this API, one cannot connect to the user's computer unless they explicitly initiate that session, and after attempting to connect to them, they must also click 'confirm.' At that time, it seemed logical to us that no one should connect without the user's consent, and since the person was at the computer, they would initiate the session and confirm the remote connection request. It turned out not to be the case. Applicants forgot to initiate the session, and we had to remind them of this during phone calls. This wasted time and annoyed both sides of the process. Moreover, it wasn't uncommon for someone to submit a request but only allow the connection when they left for lunch. The problem was not critical, and they didn't want their work process interrupted. Accordingly, they wouldn't press any buttons to allow the connection. Thus, an additional functionality was added during authorization in the HelpDesk — reading the TeamViewer ID. We knew the permanent password that was used during the TeamViewer installation. More precisely, only the system knew it, as it was embedded in the installer and in our system. Consequently, there was a connection button in the request, which, when pressed, would immediately open TeamViewer and establish the connection without any waiting. As a result, there were two types of possible connections: through the official TeamViewer API and our homemade version. To my surprise, the former was almost immediately not used anymore, even though there was a directive to use it only in special cases and when the user granted permission. Safety is paramount now. But it turned out that applicants didn't need it. They were absolutely fine with others connecting without the confirmation button. And since that was the case, the functionality for connecting through the API was abolished due to lack of necessity.
Overstappen naar multithreading in Linux
De vraag naar het versnellen van de netwerkscanner die controleert op de openheid van een vooraf gedefinieerde lijst van poorten en het eenvoudig pingen van netwerkobjecten dringt zich al een tijd op. De eerste oplossing die in me opkomt, is multithreading. Aangezien de meeste tijd die aan pingen wordt besteed, het wachten op de retour van een pakket is, en de volgende ping niet kan beginnen totdat het vorige pakket is teruggekeerd, werkte het al behoorlijk traag voor bedrijven met zelfs 20+ servers en netwerkapparatuur. Het punt is dat een pakket kan verdwijnen zonder de systeembeheerder onmiddellijk op de hoogte te stellen. Hij zal deze spam gewoon heel snel niet meer serieus nemen. Dus moet je elke object meerdere keren pingen voordat je een conclusie trekt over onbereikbaarheid. Als je niet in te veel details wilt treden, moet je parallel werken, want als je dat niet doet, zal de systeembeheerder waarschijnlijk van het probleem horen van de klant in plaats van van het monitortoetsysteem.
PHP zelf ondersteunt geen multithreading uit de doos. Het ondersteunt multi-process, je kunt forken. Maar ik had al een mechanisme voor polling geschreven en wilde het zo maken dat ik alle benodigde knooppunten één keer uit de database las, alles tegelijk pingde, op een antwoord van elk wachtte en daarna pas de gegevens schreef. Dit bespaart op het aantal leesverzoeken. Dit idee paste perfect bij multithreading. Voor PHP is er de PThreads-module, die echte multithreading mogelijk maakt, hoewel ik veel moeite moest doen om dit op PHP 7.2 in te stellen, maar het is gelukt. Poortscanning en pingen zijn snel geworden. In plaats van bijvoorbeeld 15 seconden voor een cyclus, kostte dit proces nu 2 seconden. Dat was een goed resultaat.
Snelle audit van nieuwe bedrijven
Hoe is de functionaliteit voor het verzamelen van verschillende metrics en hardwarekenmerken ontstaan? Het is eenvoudig. Soms vragen klanten ons alleen om een audit van de huidige IT-infrastructuur. En hetzelfde is nodig om de audit van een nieuwe klant te versnellen. We hadden iets nodig waarmee we een middelgroot of groot bedrijf konden binnenkomen en snel konden begrijpen wat ze überhaupt hebben. Pingen in het interne netwerk wordt, naar mijn mening, alleen geblokkeerd door degenen die hun leven moeilijker willen maken, en volgens onze ervaring zijn dat er niet veel. Maar dergelijke gevallen komen voor. Dienovereenkomstig kunnen we eenvoudig netwerken scannen op apparaat aanwezigheden met een eenvoudige ping. Vervolgens kunnen we ze toevoegen en scannen op open poorten die ons interesseren. In wezen was deze functionaliteit al beschikbaar, het enige wat nodig was, was om een opdracht van de centrale server naar de ondergeschikte server toe te voegen, zodat deze de opgegeven netwerken kon scannen en alles wat het vond aan de lijst kon toevoegen. Ik vergat te vermelden dat we al een kant-en-klare afbeelding hadden van een geconfigureerd systeem (ondergeschikte monitorserver) die we simpelweg bij de klant konden implementeren tijdens de audit en konden koppelen aan onze cloud.
Maar het resultaat van de audit bevat meestal een hoop verschillende informatie en één daarvan is - welke apparaten er eigenlijk in het netwerk zijn. In de eerste plaats waren we geïnteresseerd in Windows-servers en Windows-werkstations binnen het domein. Aangezien het ontbreken van een domein in middelgrote en grote bedrijven waarschijnlijk een uitzondering is op de regel. Om op één lijn te komen, beschouw ik gemiddeld 100+ mensen als een gemiddelde. We moesten een manier vinden om gegevens van alle Windows-machines en servers te verzamelen, met kennis van hun IP en het account van de domeinbeheerder, maar zonder software op elk van hen te installeren. De WMI-interface komt hierbij van pas. Windows Management Instrumentation (WMI) betekent letterlijk Windows-beheerinstrumentatie. WMI is een van de basis-technologieën voor gecentraliseerd beheer en monitoring van de werking van verschillende delen van de computerinfrastructuur die onder Windows loopt. Dit is afkomstig uit de wiki. Vervolgens moesten we weer aan de slag om wmic (de WMI-client) voor Debian te verzamelen. Nadat alles klaar was, bleef het gewoon om de benodigde knooppunten via wmic te vragen naar de benodigde informatie. Via WMI kun je bijna alle informatie van een Windows-computer halen, en bovendien kun je er ook de computer mee beheren, bijvoorbeeld door deze opnieuw op te starten. Zo ontstond de informatieverzameling over Windows-stations en -servers in ons systeem. Daarbij kregen we ook actuele informatie over de huidige systeembelastingsparameters. Deze vragen we vaker op, terwijl de informatie over de hardware minder frequent wordt opgevraagd. Na dit alles werd het auditoren een beetje aangenamer.
Besluit over de verspreiding van software
We gebruiken de systeem zelf dagelijks en het is altijd open voor elke technische medewerker. En we dachten dat we ook anderen konden laten delen in wat er al is. Het systeem was nog helemaal niet klaar om verspreid te worden. Er moest veel worden herzien om de lokale versie om te vormen naar SaaS. Dit omvatte veranderingen in verschillende technische aspecten van het systeem (remote connecties, klantenservice), en de analyse van modules met betrekking tot licentieverlening, databasessharding voor klanten, het schalen van elke service, en de ontwikkeling van automatische updatesystemen voor alle onderdelen. Maar hierover zal in het tweede deel van het artikel gesproken worden.
Bijwerken
Bron: habr.com
