

Welkom, Habr!
We waren de eersten die dit thema op de Russische markt introduceerden en blijven de ontwikkeling ervan volgen. In het bijzonder vonden we de interactie tussen Kafka en . Een verkennend (en behoorlijk voorzichtige) artikel over dit onderwerp verscheen vorig jaar oktober op de blog van Confluent, geschreven door Gwen Shapiro. Vandaag willen we uw aandacht vestigen op een recentere, in april gepubliceerde, artikel van Johann Gyger, die, hoewel hij niet zonder vraagteken in de titel kwam, het onderwerp op een meer inhoudelijke manier behandelt en het tekst aanvult met interessante links. Neem ons alstublieft niet kwalijk als we 'chaos monkey' een beetje vrij hebben vertaald!
Inleiding
Kubernetes is ontworpen om te werken met workloads die geen staat behouden. Gewoonlijk worden dergelijke workloads gepresenteerd in de vorm van microservices-architectuur, zijn ze lichtgewicht, goed schaalbaar, volgen ze de principes van 12-factor applicaties, en maken ze gebruik van circuit breakers en chaos monkeys.
Kafka fungeert daarentegen als een gedistribueerde database. Bij het werken hiermee moet je omgaat met de staat, die veel zwaarder is dan een microservice. Kubernetes ondersteunt workloads die staat behouden, maar zoals Kelsey Hightower in zijn tweets aangeeft, moet je voorzichtig zijn met deze workloads:
Sommigen denken dat wanneer je Kubernetes toepast op een workload die staat behoudt, het verandert in een volledig beheerde database die kan concurreren met RDS. Dat is niet waar. Misschien als je hard genoeg werkt, en extra componenten toevoegt en een SRE-team inschakelt, lukt het om RDS boven Kubernetes te bouwen.
Ik raad altijd aan om extreem voorzichtig te zijn bij het draaien van staat-behoudende workloads op Kubernetes. De meesten die zich afvragen, ‘Kan ik staat-behoudende workloads draaien op Kubernetes?’ hebben niet genoeg ervaring met Kubernetes en vaak ook niet met de betreffende workload.
Dus, moet je Kafka op Kubernetes draaien? Tegenvraag: zou Kafka beter functioneren zonder Kubernetes? Daarom wil ik in dit artikel benadrukken hoe Kafka en Kubernetes elkaar aanvullen en welke valkuilen kunnen optreden bij hun combinatie.
Tijd van uitvoering.
Laten we het hebben over de basis - de runtime-omgeving als zodanig.
Proces
Kafka-brokers zijn handig bij het werken met CPU. TLS kan wat overhead met zich meebrengen. Klanten van Kafka kunnen echter de CPU zwaarder belasten als ze encryptie gebruiken, maar dat heeft geen invloed op de brokers.
Geheugen
Kafka-brokers verbruiken geheugen. De grootte van de JVM-heap kan vaak beperkt zijn tot 4-5 GB, maar je hebt ook veel systeengeheugen nodig, aangezien Kafka zeer actief gebruikmaakt van de pagina-cache. Stel in Kubernetes de containerlimieten voor middelen en aanvragen dienovereenkomstig in.
Gegevensopslag
Gegevensopslag in containers is tijdelijk - gegevens gaan verloren bij herstart. Voor Kafka-gegevens kan een volume worden gebruikt, en het effect zal vergelijkbaar zijn: de gegevens van jouw broker zullen verloren gaan na afsluiting. Jouw berichten kunnen echter toch behouden blijven op andere brokers als replicaties. Daarom moet de falende broker na herstart in de eerste plaats alle gegevens repliceren, en dit proces kan enige tijd vergen. emptyDirDaarom is het belangrijk om duurzame gegevensopslag te gebruiken. Laat het een niet-lokale duurzame opslag zijn met een bestandssysteem als XFS of, specifieker, ext4. Gebruik geen NFS. Ik heb je gewaarschuwd. NFS-versies v3 of v4 zullen niet werken. Kortom, de Kafka-broker zal falen als deze de gegevensdirectory niet kan verwijderen vanwege een probleem met 'domme hernoemingen', wat actueel is in NFS. Als ik je tot nu toe nog niet heb overtuigd, let dan zeer goed op.
Gegevensopslag moet niet-lokaal zijn, zodat Kubernetes flexibeler een nieuwe node kan kiezen na herstart of relocatie. Gegevensopslag moet niet-lokaal zijn, zodat Kubernetes flexibeler een nieuwe node kan kiezen na herstart of relocatie.
Netwerk
Net als bij de meeste gedistribueerde systemen, is de prestaties van Kafka sterk afhankelijk van minimale netwerkvertraging en maximale bandbreedte. Probeer niet alle brokers op dezelfde node te plaatsen, omdat dit de beschikbaarheid zal verminderen. Als een Kubernetes-node uitvalt, valt ook de gehele Kafka-cluster uit. Verspreid de Kafka-cluster ook niet over hele datacenters. Hetzelfde geldt voor de Kubernetes-cluster. Een goede compromis in dit geval is om verschillende beschikbaarheidszones te kiezen.
Configuratie
Gewone manifesten
Op de Kubernetes-website is er over hoe je ZooKeeper configureert met behulp van manifesten. Aangezien ZooKeeper een onderdeel van Kafka is, is dit een handige manier om kennis te maken met de toepasbare Kubernetes-concepten. Zodra je dit begrijpt, kun je dezelfde concepten ook toepassen op de Kafka-cluster.
- Onder: een pod is de minimale uitrolbare eenheid in Kubernetes. In een pod bevindt zich je werklast, en de pod zelf komt overeen met een proces in je cluster. Een pod bevat één of meer containers. Elke ZooKeeper-server in het ensemble en elke broker in de Kafka-cluster draait in een aparte pod.
- StatefulSet: StatefulSet is een Kubernetes-object dat werkt met meerdere werklasten die toestand behouden, wat coördinatie vereist. StatefulSet biedt garanties met betrekking tot de volgorde van pods en hun uniekheid.
- Headless-services: Services stellen pods in staat om los van clients te worden gekoppeld via een logisch naam. Kubernetes is in dit geval verantwoordelijk voor de belastingverdeling. Echter, bij het werken met werklasten die toestand behouden, zoals met ZooKeeper en Kafka, moeten clients communiceren met een specifiek exemplaar. Hier komen headless-services van pas: in dit geval heeft de client nog steeds een logisch naam, maar je kunt niet rechtstreeks naar de pod verwijzen.
- Volume voor langdurige opslag: dergelijke volumes zijn nodig voor het configureren van niet-lokale block-long-term storage, dat eerder is genoemd.
Op biedt een uitgebreide set manifesten waarmee je gemakkelijk aan de slag kunt met Kafka op Kubernetes.
Helm-diagrammen
Helm is een pakketbeheerder voor Kubernetes, vergelijkbaar met pakketbeheerders voor besturingssystemen zoals yum, apt, Homebrew of Chocolatey. Hiermee is het eenvoudig om vooraf gedefinieerde softwarepakketten te installeren, zoals beschreven in Helm-diagrammen. Een goed samengesteld Helm-diagram vereenvoudigt de complexe taak van het correct configureren van alle parameters voor het gebruik van Kafka op Kubernetes. Er zijn verschillende Kafka-diagrammen: de officiële bevindt zich , er is er een van , en nog een van .
Operators
Omdat Helm bepaalde tekortkomingen heeft, wint een ander hulpmiddel, de Kubernetes-operators, aan populariteit. Een operator verpakt niet alleen software voor Kubernetes, maar stelt je ook in staat om die software uit te rollen en te beheren.
In de lijst worden twee operators voor Kafka genoemd. Een daarvan is . Met Strimzi is het eenvoudig om in enkele minuten een Kafka-cluster op te zetten. Bijna geen configuratie is nodig, bovendien biedt de operator enkele prettige functies, zoals end-to-end TLS-encryptie binnen het cluster. Confluent biedt ook .
Prestaties
Het is erg belangrijk om de prestaties te testen door je Kafka-instantie van controlepunten te voorzien. Dergelijke tests helpen je om potentiële knelpunten te ontdekken voordat er problemen ontstaan. Gelukkig biedt Kafka al twee tools voor prestatie-tests: kafka-producer-perf-test.sh en kafka-consumer-perf-test.sh. Maak er actief gebruik van. Voor referentie kun je de resultaten vergelijken met die in Jay Kreps, of je kunt je baseren op van Amazon MSK door Stéphane Maarek.
Operaties
Monitoring
Transparantie in het systeem is zeer belangrijk – anders begrijp je niet wat er gebeurt. Tegenwoordig zijn er solide tools beschikbaar voor monitoring op basis van metrics in cloud-native stijl. Twee populaire tools voor dit doel zijn Prometheus en Grafana. Prometheus kan metrics verzamelen van alle Java-processen (Kafka, Zookeeper, Kafka Connect) met behulp van de JMX-exporter – op de eenvoudigste manier. Als je de cAdvisor-metrics toevoegt, krijg je een vollediger beeld van hoe resources in Kubernetes worden gebruikt.
Strimzi heeft een zeer gebruiksvriendelijk voorbeeld van een Grafana-dashboard voor Kafka. Het visualiseert belangrijke statistieken, zoals niet-gerepliceerde segmenten of segmenten die offline zijn. Het is allemaal erg duidelijk. Deze statistieken worden aangevuld met informatie over resourcegebruik en prestaties, evenals stabiliteitsindicatoren. Op deze manier krijg je basismonitoring van de Kafka-cluster gratis!
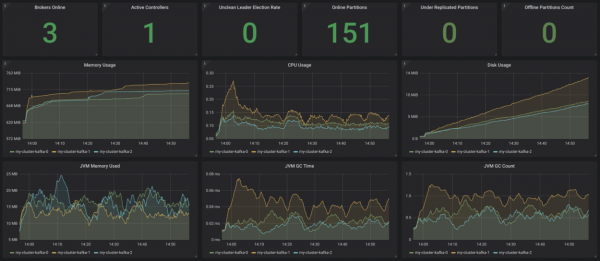
Bron:
Het zou goed zijn om dit aan te vullen met klantenmonitoring (statistieken over consumenten en producenten) en latentie-monitoring (hiervoor is er ) en end-to-end monitoring – hiervoor gebruikt u .
Logging
Logging is een andere belangrijke taak. Zorg ervoor dat alle containers in uw Kafka-installatie worden gelogd in stdout en stderr, en zorg ervoor dat uw Kubernetes-cluster alle logs aggregeert in een centrale loginfrastructuur, bijvoorbeeld in .
Controle van functionaliteit
Kubernetes gebruikt ‘liveness’-en ‘readiness’-checks om te controleren of uw pods correct functioneren. Als de liveness-check faalt, stopt Kubernetes deze container en start hem automatisch opnieuw op, mits het herstartbeleid dienovereenkomstig is ingesteld. Als de readiness-check faalt, is deze pod geïsoleerd van het bedienen van verzoeken. Op deze manier is er in dergelijke gevallen geen handmatige ingreep meer nodig, wat een groot pluspunt is.
Updates uitrollen
StatefulSets ondersteunen automatische updates: bij het kiezen van de RollingUpdate-strategie wordt elke Kafka-pod één voor één bijgewerkt. Op deze manier kan de duur van uitvaltijd tot nul worden teruggebracht.
Schaalbaarheid
Het schalen van de Kafka-cluster is geen gemakkelijke taak. Echter, in Kubernetes is het heel eenvoudig om pods tot een bepaald aantal replica's te schalen, wat betekent dat u declaratief zoveel Kafka-brokers kunt definiëren als u wilt. Het moeilijkste in dit geval is het opnieuw toewijzen van secties na het opschalen of voor het afschalen. Ook hier helpt Kubernetes u met deze taak.
Beheer
Taken die verband houden met het beheer van uw Kafka-cluster, zoals het aanmaken van onderwerpen en het opnieuw toewijzen van partities, kunnen worden uitgevoerd met behulp van de beschikbare shell-scripts, door de opdrachtregelinterface in uw pods te openen. Echter, deze oplossing is niet erg elegant. Strimzi ondersteunt het beheren van onderwerpen via een andere operator. Hier is zeker ruimte voor verbetering.
Back-up en herstel
Nu zal de beschikbaarheid van Kafka ook afhangen van de beschikbaarheid van Kubernetes. Als uw Kubernetes-cluster uitvalt, kan in het slechtste geval ook het Kafka-cluster uitvallen. Volgens de wet van Murphy zal dit ongetwijfeld gebeuren, en verliest u gegevens. Om het risico op dergelijke situaties te verminderen, is het verstandig om een goed doordachte back-upstrategie te ontwikkelen. U kunt MirrorMaker gebruiken, of een andere optie is om S3 hiervoor te benutten, zoals beschreven in dit van Zalando.
Conclusie
Bij het werken met kleine of middelgrote Kafka-clusters is het beslist zinvol om Kubernetes te gebruiken, aangezien het extra flexibiliteit biedt en het werken met operators vereenvoudigt. Als u echter te maken heeft met zeer serieuze niet-functionele eisen met betrekking tot latency en/of doorvoer, kunt u overwegen een andere implementatieoptie te bekijken.
Bron: habr.com
