

Als je met Kubernetes werkt, is kubectl waarschijnlijk een van de meest gebruikte tools. En telkens wanneer je veel tijd besteedt aan het werken met een bepaald hulpmiddel, is het de moeite waard om het goed te leren en effectief te gebruiken.
Opdracht Ik heb het artikel van Daniel Weibels vertaald, waarin je tips en trucs vindt voor een efficiënte werkwijze met kubectl. Het helpt je ook om Kubernetes beter te begrijpen.
Volgens de auteur is het doel van het artikel om je dagelijkse werk met Kubernetes niet alleen efficiënter te maken, maar ook aangenamer!
Inleiding: wat is kubectl
Voordat je leert kubectl effectiever te gebruiken, is het belangrijk om een basisbegrip te krijgen van wat het is en hoe het werkt.
Vanuit gebruikersperspectief is kubectl een dashboard waarmee je Kubernetes-operaties kunt uitvoeren.
Vanuit technisch perspectief is kubectl een client voor de Kubernetes API.
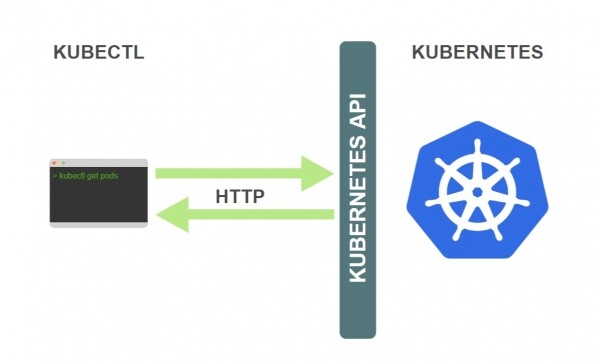
De Kubernetes API is een HTTP REST API. Deze API is de echte gebruikersinterface van Kubernetes, via welke het volledig wordt beheerd. Dit betekent dat elke Kubernetes-operatie wordt gepresenteerd als een API-eindpunt en kan worden uitgevoerd met een HTTP-verzoek naar dat eindpunt.
Vandaar dat de belangrijkste taak van kubectl is om HTTP-verzoeken naar de Kubernetes API uit te voeren:
Kubernetes is een volledig resource-georiënteerd systeem. Dit betekent dat het de interne staat van resources ondersteunt en alle Kubernetes-operaties CRUD-operaties zijn.
Je hebt volledige controle over Kubernetes door deze resources te beheren, en Kubernetes bepaalt wat te doen, gebaseerd op de huidige staat van de resources. Om deze reden is de link naar de Kubernetes API georganiseerd als een lijst van resource types met de bijbehorende operaties.
Laten we een voorbeeld bekijken.
Stel dat je een ReplicaSet-resource wilt maken. Om dit te doen, beschrijf je de ReplicaSet in een bestand genaamd replicaset.yaml, en dan voer je de volgende opdracht uit:
$ kubectl create -f replicaset.yamlAls resultaat wordt er een ReplicaSet-resource aangemaakt. Maar wat gebeurt er achter de schermen?
In Kubernetes is er een operatie om een ReplicaSet aan te maken. Net als elke andere operatie wordt deze aangeboden als een API-eindpunt. Het specifieke API-eindpunt voor deze operatie ziet er als volgt uit:
POST /apis/apps/v1/namespaces/{namespace}/replicasetsAPI-eindpunten van alle Kubernetes-operaties kunnen worden gevonden in (inclusief ). Om een feitelijk verzoek naar het eindpunt te doen, moet je eerst het URL-adres van de API-server toevoegen aan de paden van de eindpunten die in de API-documentatie zijn vermeld.
Daarom, wanneer je de bovenstaande opdracht uitvoert, stuurt kubectl een HTTP POST-verzoek naar het hierboven vermelde API-eindpunt. De ReplicaSet-definitie die je in het bestand hebt opgegeven, replicaset.yaml, wordt in de body van het verzoek verzonden.
Zo werkt kubectl voor alle opdrachten die interageren met het Kubernetes-cluster. In alle deze gevallen stuurt kubectl eenvoudigweg HTTP-verzoeken naar de relevante API-eindpunten van Kubernetes.
Merk op dat je Kubernetes volledig kunt beheren met een tool zoals curl, door handmatig HTTP-verzoeken naar de Kubernetes API te sturen. Kubectl vereenvoudigt simpelweg het gebruik van de Kubernetes API.
Dit zijn de basisprincipes van wat kubectl is en hoe het werkt. Maar er is nog iets over de Kubernetes API dat elke kubectl-gebruiker moet weten. Laten we kort duiken in de interne wereld van Kubernetes.
De interne wereld van Kubernetes
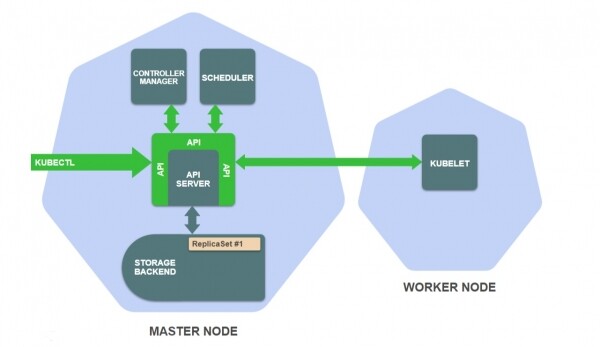
Kubernetes bestaat uit een set onafhankelijke componenten die als afzonderlijke processen op de knooppunten van het cluster draaien. Sommige componenten draaien op de master-knooppunten, andere op de worker-knooppunten, en elke component heeft zijn eigen specifieke taak.
Hier zijn de belangrijkste componenten op de master knooppunten:
- Opslag — slaat resource-definities op ().
- API-server — biedt de API aan en beheert de opslag.
- Controller-manager — zorgt ervoor dat de statussen van resources overeenkomen met de specificaties.
- Scheduler — plant pods op de worker knooppunten.
En hier is een van de belangrijkste componenten op de worker knooppunten:
- Kubelet — beheert de uitvoering van containers op het worker knooppunt.
Om te begrijpen hoe deze componenten samenwerken, beschouwen we een voorbeeld.
Stel dat je net hebt uitgevoerd kubectl create -f replicaset.yaml, waarna kubectl een HTTP POST-verzoek naar de stuurt (terwijl het de resource-definitie van ReplicaSet doorgeeft).
Wat gebeurt er in het cluster?
- Na het uitvoeren van
kubectl create -f replicaset.yamlslaat de API-server de definitie van jouw ReplicaSet-resource op in de opslag:
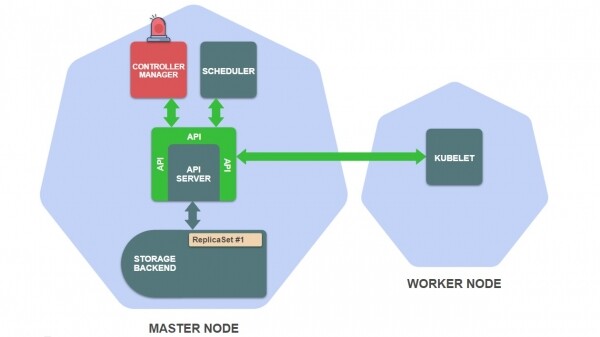
- Vervolgens start de ReplicaSet-controller in de controller-manager, die verantwoordelijk is voor het creëren, wijzigen en verwijderen van ReplicaSet-resources:

- De ReplicaSet-controller maakt een pod-definitie voor elke ReplicaSet-replica (volgens de pod-sjabloon in de ReplicaSet-definitie) en slaat deze op in de opslag:

- Een planner wordt gestart die de pods volgt die nog aan geen enkele werknode zijn toegewezen:

- De planner kiest een geschikte werknode voor elke pod en voegt deze informatie toe aan de poddefinitie in de opslag:
- Op de werknode waaraan een pod is toegewezen, wordt Kubelet gestart, dat de aan deze node toegewezen pods volgt:

- Kubelet leest de poddefinitie uit de opslag en geeft opdrachten aan de container runtime, zoals Docker, om containers op de node te starten:

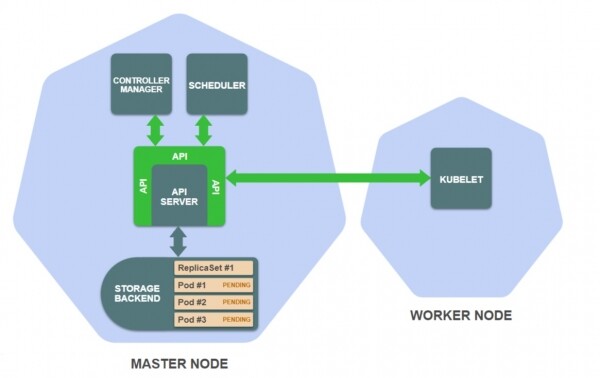
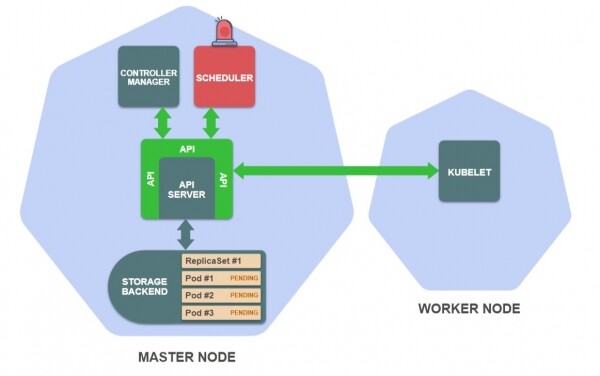
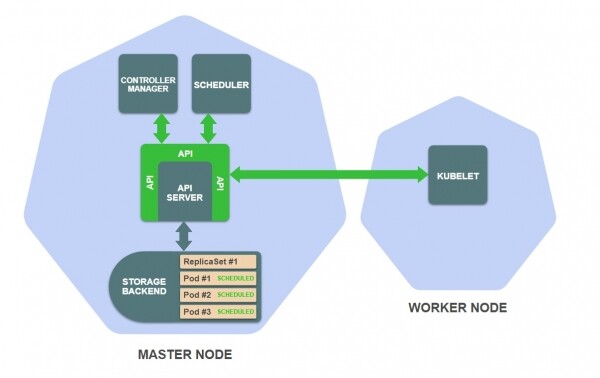
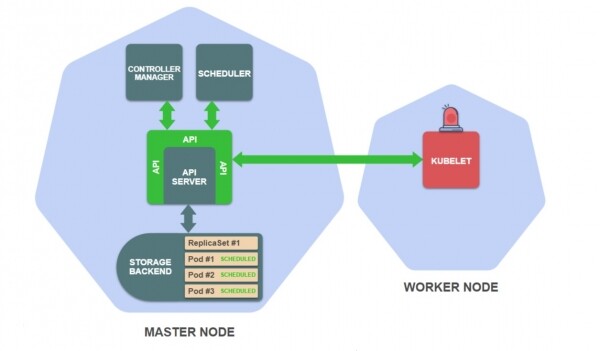
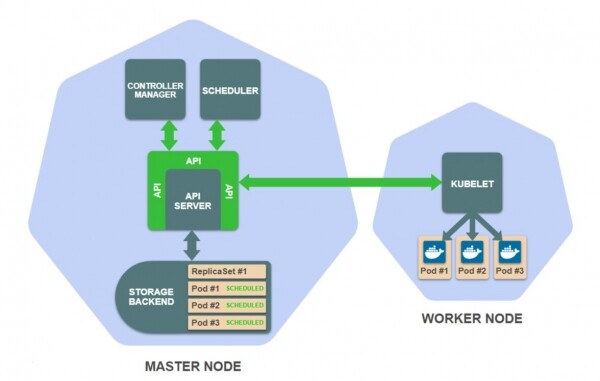
Hieronder volgt de tekstversie van deze beschrijving.
Een API-verzoek naar het eindpunt voor het maken van een ReplicaSet wordt door de API-server verwerkt. De API-server authenticatieert het verzoek en slaat de definitie van de ReplicaSet-resource op in de opslag.
Dit evenement start de ReplicaSet-controller, die een subprocess is van de controller manager. De ReplicaSet-controller houdt toezicht op het maken, bijwerken en verwijderen van ReplicaSet-resources in de opslag en ontvangt een melding van het evenement wanneer dit gebeurt.
De taak van de ReplicaSet-controller is ervoor te zorgen dat het vereiste aantal pods van de ReplicaSet bestaat. In ons voorbeeld bestaan er nog geen pods, dus maakt de ReplicaSet-controller deze poddefinities (volgens de podtemplate in de definitie van de ReplicaSet) aan en slaat deze op in de opslag.
Het creëren van nieuwe pods start de planner, die de poddefinities volgt die nog niet zijn ingepland voor werknodes. De planner kiest een geschikte werknode voor elke pod en werkt de poddefinities in de opslag bij.
Merk op dat totdat dit moment er nergens in de cluster code van de workload is uitgevoerd. Alles wat tot nu toe is gedaan, — is het creëren en bijwerken van resources in de opslag op de hoofdnode.
De laatste gebeurtenis start Kubelet, dat toezicht houdt op de pods die voor hun werknodes zijn ingepland. Kubelet van de werknode waarvoor uw ReplicaSet-pods zijn ingesteld, moet de container runtime, zoals Docker, instrueren om de benodigde containerimages te downloaden en ze te starten.
Op dit moment is uw ReplicaSet-applicatie eindelijk gestart!
De rol van de Kubernetes API
Zoals u in het vorige voorbeeld hebt gezien, kijken de componenten van Kubernetes (met uitzondering van de API-server en opslag) naar wijzigingen in resources in de opslag en wijzigen ze de informatie over de resources in de opslag.
Natuurlijk communiceren deze componenten niet rechtstreeks met de opslag, maar alleen via de Kubernetes API.
Laten we de volgende voorbeelden bekijken.:
- De ReplicaSet-controller gebruikt het API-eindpunt. met de parameter
watchom veranderingen in de ReplicaSet-resources te observeren. - De ReplicaSet-controller gebruikt het API-eindpunt. (pod aanmaken) om pods te creëren.
- De scheduler gebruikt het API-eindpunt. (pod wijzigen) om pods bij te werken met informatie over de geselecteerde werknode.
Zoals je ziet, is dit dezelfde API waarop kubectl werkt. Het gebruik van dezelfde API voor het functioneren van interne componenten en externe gebruikers is een fundamenteel ontwerpaspect van Kubernetes.
Nu kunnen we samenvatten hoe Kubernetes werkt:
- De opslag behoudt de status, dat wil zeggen de Kubernetes-resources.
- De API-server biedt een interface naar de opslag in de vorm van de Kubernetes API.
- Alle andere componenten en gebruikers van Kubernetes lezen, observeren en manipuleren de status (resources) van Kubernetes via de API.
Kennis van deze concepten zal helpen om kubectl beter te begrijpen en het optimaal te gebruiken.
Laten we nu een aantal specifieke tips en trucs bekijken die de efficiëntie van het werken met kubectl kunnen verhogen.
1. Versnellen van invoer met commandocompletering.
Een van de meest nuttige, maar vaak over het hoofd geziene trucs om de efficiëntie van het werken met kubectl te verhogen, is commandocompletering.
Commandocompletering stelt je in staat om delen van kubectl-opdrachten automatisch in te vullen met de Tab-toets. Dit werkt voor subopdrachten, opties en argumenten, inclusief ingewikkelde zoals resource-namen.
Bekijk hoe commandocompletering werkt met kubectl:
Commandocompletering werkt voor de commandoregelomgevingen Bash en Zsh.
bevat gedetailleerde instructies voor het instellen van autocompletering, maar hieronder geven we een korte samenvatting.
Hoe commandocompletering werkt.
Commandocompletering is een functie van de shell die werkt met behulp van een completerscript. Een completerscript is een shell-script dat het gedrag van de completering voor een bepaalde opdracht definieert.
Kubectl genereert automatisch en geeft completerscripts voor Bash en Zsh weer met behulp van de volgende opdrachten:
$ kubectl completion bashOf:
$ kubectl completion zshIn theorie is het voldoende om de uitvoer van deze opdrachten aan de juiste commandoregelomgeving te koppelen, om ervoor te zorgen dat kubectl opdrachten kan aanvullen.
In de praktijk verschilt de verbindingsmethode voor Bash (inclusief de verschillen tussen Linux en MacOS) en Zsh. Hieronder bekijken we al deze opties.
Bash op Linux
Het aanvulling-script voor Bash is afhankelijk van het pakket bash-completion, dus je moet het eerst installeren:
$ sudo apt-get install bash-completionOf:
$ yum install bash-completionJe kunt testen of het pakket succesvol is geïnstalleerd met de volgende opdracht:
$ type _init_completion Als de uitvoer een functiecode van de shell weergeeft, is bash-completion correct geïnstalleerd. Als de opdracht een foutmelding geeft ‘Niet gevonden’, moet je de volgende regel toevoegen aan je bestand ~ /.bashrc:
$ source /usr/share/bash-completion/bash_completion Of je deze regel aan het bestand moet toevoegen ~ /.bashrc hangt af van de pakketbeheerder die je hebt gebruikt om bash-completion te installeren. Voor APT is dit nodig, voor YUM niet.
Na de installatie van bash-completion moet alles zo worden ingesteld dat het aanvulling-script kubectl in alle shellsessies is ingeschakeld.
Een manier om dit te doen, is door de volgende regel toe te voegen aan het bestand ~ /.bashrc:
source <(kubectl completion bash) Een andere manier is om het aanvulling-script kubectl in de map te plaatsen /etc/bash_completion.d (maak deze aan als deze niet bestaat):
$ kubectl completion bash >/etc/bash_completion.d/kubectl Alle aanvulling-scripts in de map /etc/bash_completion.d worden automatisch ingeschakeld in bash-completion.
Beide opties zijn even toepasbaar.
Na het herstarten van de opdracht shell zal de autocompleter voor kubectl werken.
Bash op MacOS
Op MacOS is de configuratie iets gecompliceerder. Het probleem is dat standaard Bash versie 3.2 op MacOS is geïnstalleerd, terwijl het autocompletescript voor kubectl minimaal Bash versie 4.1 vereist en niet werkt in Bash 3.2.
Het gebruik van een verouderde versie van Bash op MacOS is gerelateerd aan licentieproblemen. Bash versie 4 wordt verspreid onder de GPLv3-licentie, die niet door Apple wordt ondersteund.
Om autocompletion van kubectl in MacOS in te stellen, moet je een nieuwere versie van Bash installeren. Je kunt ook de bijgewerkte Bash als standaardopdracht shell instellen, wat je in de toekomst een hoop problemen kan besparen. Dit is niet moeilijk, de details worden gegeven in het artikel ‘».
Voordat je verdergaat, zorg ervoor dat je een recente versie van Bash gebruikt (controleer de uitvoer bash --version).
Het autocompletescript in Bash is afhankelijk van het project , dus je moet het in eerste instantie installeren.
Je kunt bash-completion installeren met :
$ brew install bash-completion@2 Hier @2 betekent bash-completion versie 2. Auto-aanvulling van kubectl vereist bash-completion v2, en bash-completion v2 vereist minimaal versie 4.1 van Bash.
De uitvoer van het commando brew-install bevat een sectie Caveats, waarin staat dat je moet toevoegen aan het bestand ~/.bash_profile:
export BASH_COMPLETION_COMPAT_DIR=/usr/local/etc/bash_completion.d
[[ -r "/usr/local/etc/profile.d/bash_completion.sh" ]] && .
"/usr/local/etc/profile.d/bash_completion.sh"
Echter, ik raad aan deze regels niet toe te voegen in ~/.bash_profile, en in ~/\.bashrc. In dit geval zal de auto-aanvulling beschikbaar zijn in de hoofden maar ook in sub-shells.
Na het herstarten van de shell kun je de installatie controleren met de volgende opdracht:
$ type _init_completionAls je een shell-functie in de uitvoer ziet, is alles correct ingesteld.
Nu moet je ervoor zorgen dat de auto-aanvulling van kubectl is ingeschakeld in alle sessies.
Een manier is om de volgende regel toe te voegen aan je ~/\.bashrc:
source <(kubectl completion bash) De tweede manier is om het auto-aanvullingsscript in de map /usr/local/etc/bash_completion.d:
$ kubectl completion bash
/usr/local/etc/bash_completion.d/kubectl
Deze methode werkt alleen als je bash-completion hebt geïnstalleerd via Homebrew. In dat geval laad bash-completion alle scripts uit deze directory.
Als je , hoeft de vorige stap niet te worden uitgevoerd, aangezien het auto-aanvullingsscript automatisch in de map /usr/local/etc/bash_completion.d wordt geplaatst tijdens de installatie. In dat geval zal de auto-aanvulling van kubectl meteen werken zodra je bash-completion installeert.
Uiteindelijk zijn al deze opties gelijkwaardig.
Zsh
Auto-aanvullingsscripts voor Zsh vereisen geen afhankelijkheden. Alles wat nodig is, is ze in te schakelen bij het opstarten van de shell.
Je kunt dit doen door de regel toe te voegen aan je ~/ .zshrc file:
source <(kubectl completion zsh) Als je de foutmelding not found: compdef ontvangt na het herstarten van je shell, moet je de ingebouwde functie compdefinschakelen. Je kunt deze inschakelen door aan het begin van je bestand toe te voegen ~/ .zshrc het volgende:
autoload -Uz compinit
compinit
2. Snelle weergave van resource specificaties
Wanneer je resource-definities in YAML creëert, moet je de velden en hun waarden voor deze resources kennen. Een van de plaatsen om deze informatie te vinden is in de API-handleiding, die volledige specificaties van alle resources bevat.
Echter, elke keer naar de webbrowser schakelen om iets te zoeken is ongemakkelijk. Daarom biedt kubectl de opdracht kubectl explain, die de specificaties van alle resources direct in je terminal toont.
Het commando-formaat is als volgt:
$ kubectl explain resource[.field]...Het team zal de specificatie van de gevraagde bron of het veld weergeven. De weergegeven informatie is identiek aan die in de API-handleiding.
Standaard kubectl explain toont alleen het eerste niveau van geneste velden.
Bekijk hoe het eruit ziet .
Je kunt de volledige boom weergeven door de optie toe te voegen --recursive:
$ kubectl explain deployment.spec --recursiveAls je niet precies weet welke bronnen je nodig hebt, kun je ze allemaal weergeven met het volgende commando:
$ kubectl api-resources Dit commando toont de namen van bronnen in meervoudsvorm, bijvoorbeeld, deployments in plaats van deployment. Het toont ook de korte naam, bijvoorbeeld deploy, voor die bronnen waarvoor deze bestaat. Maak je geen zorgen over deze verschillen. Al deze naamvarianten zijn gelijkwaardig voor kubectl. Dat wil zeggen, je kunt een van hen gebruiken voor kubectl explain.
Alle onderstaande commando's zijn gelijkwaardig:
$ kubectl explain deployments.spec
# of
$ kubectl explain deployment.spec
# of
$ kubectl explain deploy.spec
3. Gebruik een aangepast opmaakformaat voor kolommen
Standaard is het uitvoerformaat van het commando kubectl get:
$ kubectl get pods
NAME                     READY    STATUS    RESTARTS  AGE
engine-544b6b6467-22qr6   1/1     Running     0       78d
engine-544b6b6467-lw5t8   1/1     Running     0       78d
engine-544b6b6467-tvgmg   1/1     Running     0       78d
web-ui-6db964458-8pdw4    1/1     Running     0       78d
Dit formaat is handig, maar bevat een beperkte hoeveelheid informatie. In vergelijking met het volledige formaat van de resource-definitie worden hier slechts enkele velden weergegeven.
In dit geval kan een aangepast opmaakformaat voor kolommen worden gebruikt. Hiermee kun je bepalen welke gegevens worden weergegeven. Je kunt elk veld van de resource in een aparte kolom weergeven.
Het gebruik van een aangepast formaat wordt bepaald met behulp van opties:
-o custom-columns=:[,:]... Je kunt elke uitvoerkolom definiëren met het paar <jsonpath> — een uitdrukking die het veld van de resource definieert.
Laten we kijken naar een eenvoudig voorbeeld:
$ kubectl get pods -o custom-columns='NAME:metadata.name'

NAME
engine-544b6b6467-22qr6
engine-544b6b6467-lw5t8
engine-544b6b6467-tvgmg
web-ui-6db964458-8pdw4
De uitvoer bevat één kolom met de namen van de pods.
De uitdrukking in de optie selecteert de namen van de pods uit het veld metadata.name. Dit komt omdat de naam van de pod wordt gedefinieerd in het onderliggende veld name van het metadata in de resourcebeschrijving van de pod. Meer details zijn te vinden in de of typ het commando kubectl explain pod.metadata.name.
Stel nu dat u een extra kolom wilt toevoegen aan de uitvoer, bijvoorbeeld om de node weer te geven waarop elke pod draait. Hiervoor kunt u eenvoudig de bijbehorende kolomspecificatie toevoegen aan de optie voor aangepaste kolommen:
$ kubectl get pods
  -o custom-columns='NAME:metadata.name,NODE:spec.nodeName'

NAME                       NODE
engine-544b6b6467-22qr6    ip-10-0-80-67.ec2.internal
engine-544b6b6467-lw5t8    ip-10-0-36-80.ec2.internal
engine-544b6b6467-tvgmg    ip-10-0-118-34.ec2.internal
web-ui-6db964458-8pdw4     ip-10-0-118-34.ec2.internal
De expressie selecteert de naam van de node uit spec.nodeName — wanneer een pod aan een node wordt toegewezen, wordt de naam ervan vastgelegd in het veld spec.nodeName resource specificatie van de pod. Meer gedetailleerde informatie is te vinden in de uitvoer van kubectl explain pod.spec.nodeName.
Houd er rekening mee dat de Kubernetes resourcevelden hoofdlettergevoelig zijn.
U kunt elk resourceveld als een kolom bekijken. Bekijk gewoon de resource specificatie en experimenteer met elk veld dat u wilt.
Maar laten we eerst dieper ingaan op de expressies voor het selecteren van velden.
JSONPath-expressies
Expressies voor het selecteren van resourcevelden zijn gebaseerd op .
JSONPath is een taal voor het ophalen van gegevens uit JSON-documenten. Het selecteren van één veld is de eenvoudigste gebruiksvariant van JSONPath. Het biedt veel meer , inclusief selectors, filters, enzovoort.
Kubectl explain ondersteunt een beperkte set mogelijkheden van JSONPath. Hieronder staan de mogelijkheden en voorbeelden van hun gebruik:
# Выбрать все элементы списка
$ kubectl get pods -o custom-columns='DATA:spec.containers[*].image'
# Выбрать специфический элемент списка
$ kubectl get pods -o custom-columns='DATA:spec.containers[0].image'
# Выбрать элементы списка, попадающие под фильтр
$ kubectl get pods -o custom-columns='DATA:spec.containers[?(@.image!="nginx")].image'
# Выбрать все поля по указанному пути, независимо от их имени
$ kubectl get pods -o custom-columns='DATA:metadata.*'
# Выбрать все поля с указанным именем, вне зависимости от их расположения
$ kubectl get pods -o custom-columns='DATA:..image'
De operator [] heeft een speciale betekenis. Veel resourcevelden in Kubernetes zijn lijsten, en deze operator maakt het mogelijk om elementen uit deze lijsten te selecteren. Het wordt vaak gebruikt met een wildcard zoals [*] om alle elementen van de lijst te selecteren.
Voorbeelden van toepassingen
De mogelijkheden om een aangepast formaat voor kolomuitvoer te gebruiken zijn eindeloos, omdat u elk veld of een combinatie van velden van de resource in de uitvoer kunt weergeven. Hier zijn enkele voorbeelden van toepassingen, maar voel u vrij om zelf te verkennen en nuttige toepassingen te vinden.
- Weergeven van containerafbeeldingen voor pods:
$ kubectl get pods
  -o custom-columns='NAME:metadata.name,IMAGES:spec.containers[*].image'

NAME                        IMAGES
engine-544b6b6467-22qr6     rabbitmq:3.7.8-management,nginx
engine-544b6b6467-lw5t8     rabbitmq:3.7.8-management,nginx
engine-544b6b6467-tvgmg     rabbitmq:3.7.8-management,nginx
web-ui-6db964458-8pdw4      wordpress
Deze opdracht toont de namen van de containerafbeeldingen voor elke pod.
Houd er rekening mee dat een pod meerdere containers kan bevatten, en de namen van de images worden in één regel gescheiden door komma's weergegeven.
- Weergave van de beschikbaarheidszones van nodes:
$ kubectl get nodes
  -o
custom-columns='NAME:metadata.name,ZONE:metadata.labels.failure-domain.beta.kubernetes.io/zone'

NAME                          ZONE
ip-10-0-118-34.ec2.internal   us-east-1b
ip-10-0-36-80.ec2.internal    us-east-1a
ip-10-0-80-67.ec2.internal    us-east-1b
Dit commando is handig als je cluster zich in een openbaar cloud bevindt. Het toont de beschikbaarheidszone voor elke node.
Een beschikbaarheidszone is een cloudconcept dat de replicatie naar een geografische regio beperkt.
De beschikbaarheidszones voor elke node worden verkregen via een speciale label — . Als het cluster in een openbaar cloud wordt uitgevoerd, wordt dit label automatisch aangemaakt en ingevuld met de namen van de beschikbaarheidszones voor elke node.
Labels maken geen deel uit van de specificatie van Kubernetes-resources, dus je zult geen informatie hierover vinden in . Maar je kunt ze zien (net als andere labels), als je informatie over de nodes opvraagt in YAML- of JSON-formaat:
$ kubectl get nodes -o yaml
# of
$ kubectl get nodes -o json
Dit is een geweldige manier om meer te leren over resources, naast het bestuderen van de resource-specificaties.
4. Eenvoudige overschakeling tussen clusters en namespaces
Wanneer kubectl een verzoek indient aan de Kubernetes API, leest het eerst het kubeconfig-bestand om alle benodigde parameters voor de verbinding te verkrijgen.
Standaard is het kubeconfig-bestand — ~/.kube/config. Gewoonlijk wordt dit bestand aangemaakt of bijgewerkt met een speciaal commando.
Wanneer je met meerdere clusters werkt, bevat je kubeconfig-bestand de verbindingsparameters voor al deze clusters. Je hebt een manier nodig om aan het kubectl-commando aan te geven met welk cluster je werkt.
Binnen een cluster kun je verschillende namespaces maken — een soort virtueel cluster binnen een fysiek cluster. Kubectl bepaalt welke namespace te gebruiken ook op basis van de gegevens van het kubeconfig-bestand. Dat betekent dat je ook een manier nodig hebt om aan het kubectl-commando aan te geven met welke namespace je werkt.
In dit hoofdstuk leggen we uit hoe dit werkt en hoe je efficiënt kunt werken.
Houd er rekening mee dat u meerdere kubeconfig-bestanden kunt hebben die zijn vermeld in de omgevingsvariabele KUBECONFIG. In dat geval worden al deze bestanden samengevoegd tot één gezamenlijke configuratie tijdens de uitvoering. U kunt ook het standaard kubeconfig-bestand wijzigen door kubectl te starten met de parameter --kubeconfig. Zie .
Kubeconfig-bestanden
Laten we eens bekijken wat er precies in het kubeconfig-bestand staat:
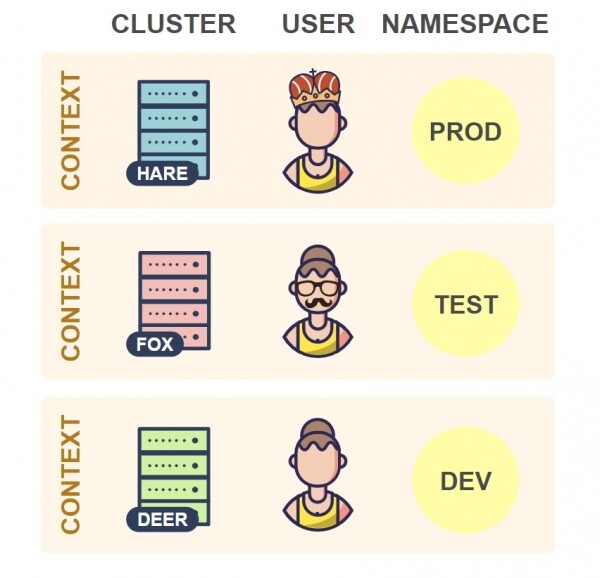
Zoals u ziet, bevat het kubeconfig-bestand een reeks contexten. Een context bestaat uit drie elementen:
- Cluster — de URL van de API-server van de cluster.
- User — de authenticatie-inloggegevens van de gebruiker in de cluster.
- Namespace — de space die wordt gebruikt bij het verbinden met de cluster.
In de praktijk wordt vaak één context per cluster in uw kubeconfig-bestand gebruikt. U kunt echter meerdere contexten voor een cluster hebben, die verschillen in gebruiker of namespace. Een dergelijke configuratie met meerdere contexten komt echter niet vaak voor, dus er is meestal een op elkaar afgestemde relatie tussen clusters en contexten.
Op elk moment is een van de contexten de huidige:
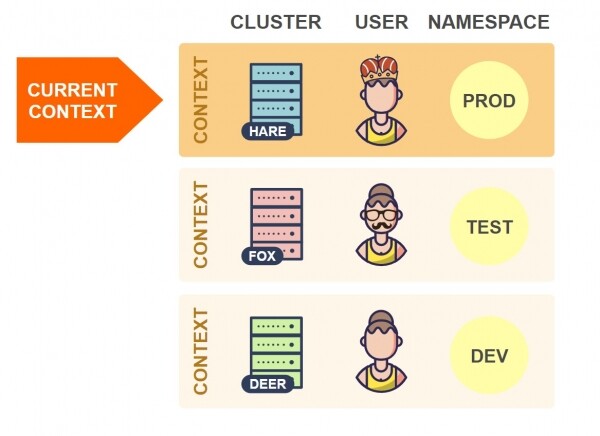
Wanneer kubectl het configuratiebestand leest, worden altijd de gegevens uit de huidige context genomen. In het bovenstaande voorbeeld zal kubectl verbinding maken met de cluster Hare.
Om over te schakelen naar een andere cluster, moet u de huidige context in het kubeconfig-bestand wijzigen:
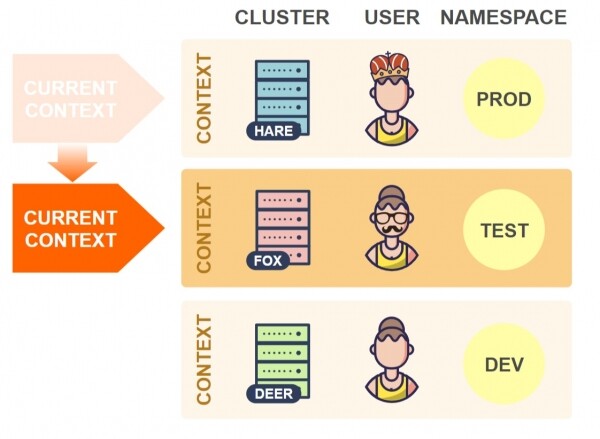
Nu zal kubectl verbinding maken met de cluster Fox.
Om over te schakelen naar een andere namespace in dezelfde cluster, moet u de waarde van het namespace-element voor de huidige context wijzigen:
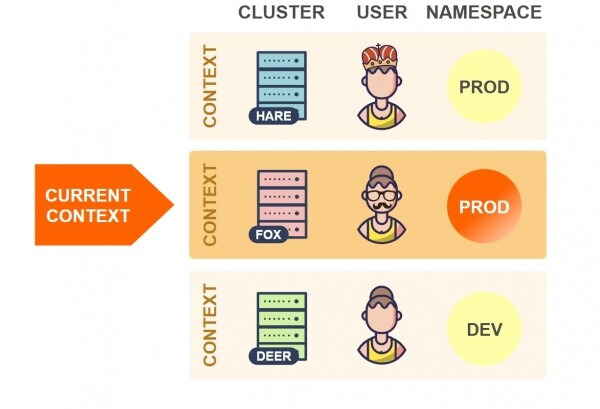
In het bovenstaande voorbeeld zal kubectl de namespace Prod van de cluster Fox gebruiken (voorheen was de namespace Test ingesteld).
Houd er rekening mee dat kubectl ook parameters biedt --cluster, --user, --namespace en --context, waarmee specifieke elementen en de huidige context kunnen worden overschreven, ongeacht wat er in het kubeconfig-bestand is ingesteld. Zie kubectl opties.
Theoretisch kunt u handmatig parameters in het kubeconfig-bestand wijzigen. Maar dat is onhandig. Voor het vereenvoudigen van deze bewerkingen zijn er verschillende hulpprogramma's beschikbaar die het mogelijk maken om parameters automatisch te wijzigen.
Gebruik kubectx
Een zeer populair hulpprogramma voor het schakelen tussen clusters en namespaces.
Het hulpprogramma biedt de opdrachten kubectx en kubens om de huidige context en naamruimte respectievelijk te wijzigen.
Zoals eerder vermeld, betekent het wijzigen van de huidige context het wijzigen van de cluster, als u slechts één context per cluster heeft.
Hier is een voorbeeld van het uitvoeren van deze commando's:
In wezen bewerken deze commando's gewoon het kubeconfig-bestand, zoals hierboven beschreven.
Om te installeren kubectx, volg de instructies op
Beide commando's ondersteunen het automatisch aanvullen van naamruimten en contextnamen, waardoor u ze niet volledig hoeft in te voeren. Instructies voor het instellen van automatisch aanvullen .
Een andere nuttige functie kubectx is . Het werkt samen met de tool , die apart moet worden geïnstalleerd. Het installeren van fzf maakt de interactieve modus automatisch beschikbaar in kubectx. In de interactieve modus kunt u context en naamruimte kiezen via de interactieve vrijzoekinterface die door fzf wordt geboden.
Gebruik van shell-aliases
U heeft geen aparte tools nodig om de huidige context en naamruimte te wijzigen, omdat kubectl ook commando's hiervoor biedt. Zo geeft het commando kubectl config subcommando's om kubeconfig-bestanden te bewerken.
Hier zijn enkele daarvan:
kubectl config get-contexts: laat alle contexten zien;kubectl config current-context: verkrijg de huidige context;kubectl config use-context: wijzig de huidige context;kubectl config set-context: wijzig het contextelement.
Het is echter niet erg handig om deze commando's rechtstreeks te gebruiken, omdat ze lang zijn. U kunt shell-aliases maken die gemakkelijk uit te voeren zijn.
Ik heb een set alias gemaakt op basis van deze commando's die functionaliteit biedt die vergelijkbaar is met kubectx. Hier kunt u hun werking zien:
Houd er rekening mee dat de alias fzf gebruikt om een interactieve vrijzoekinterface te bieden (zoals in de interactieve modus van kubectx). Dit betekent dat u , om deze aliasen te gebruiken.
Hier zijn de definitie van de alias:
# Получить текущий контекст
alias krc='kubectl config current-context'
# Список всех контекстов
alias klc='kubectl config get-contexts -o name | sed "s/^/  /;|^  $(krc)$|s/ /*/"'
# Изменить текущий контекст
alias kcc='kubectl config use-context "$(klc | fzf -e | sed "s/^..//")"'

# Получить текущее пространство имен
alias krn='kubectl config get-contexts --no-headers "$(krc)" | awk "{print $5}" | sed "s/^$/default/"'
# Список всех пространств имен
alias kln='kubectl get -o name ns | sed "s|^.*/|  |;|^  $(krn)$|s/ /*/"'
# Изменить текущее пространство имен
alias kcn='kubectl config set-context --current --namespace "$(kln | fzf -e | sed "s/^..//")"'
Om deze aliasen in te stellen, moet u de bovenstaande definities aan uw bestand toevoegen ~/\.bashrc of ~/ .zshrc en uw shell herstarten.
Gebruik van plugins
Kubectl stelt u in staat om plugins te laden die worden uitgevoerd zoals de basiscommando's. U kunt bijvoorbeeld de plugin kubectl-foo installeren en deze uitvoeren door het commando uit te voeren kubectl foo.
Het zou handig zijn om de context en namespace op deze manier te veranderen, bijvoorbeeld door te starten met kubectl ctx om de context te veranderen en kubectl ns om de namespace te veranderen.
Ik heb twee plugins geschreven die dit doen:
De werking van de plugins is gebaseerd op de aliassen uit de voorgaande sectie.
Zo werken ze:
Let op, de plugins gebruiken fzf voor het bieden van een interactieve zoekinterface (zoals in de interactieve modus van kubectx). Dit betekent dat je moet, om deze aliasen te gebruiken.
Om de plugins te installeren, moet je de shell-scripts met de namen en in een map in je PATH plaatsen en ze uitvoerbaar maken, bijvoorbeeld met chmod +x. Direct daarna kun je gebruiken kubectl ctx en kubectl ns.
5. Invoer verkorten met auto-aliases
Shell-aliases zijn een goede mogelijkheid om invoer te versnellen. Het project bevat ongeveer 800 verkortingen voor de basiscommando's van kubectl.
Je vraagt je misschien af — hoe moet je 800 aliasen onthouden? Maar je hoeft ze niet allemaal te onthouden, want ze zijn opgebouwd volgens een eenvoudig schema dat hieronder wordt gegeven:
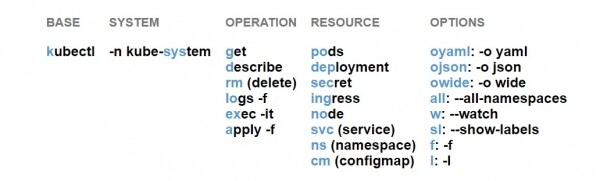
Bijvoorbeeld:
- kgpooyaml — kubectl get pods oyaml
- ksysgsvcw — kubectl -n kube-system get svc w
- ksysrmcm — kubectl -n kube-system rm cm
- kgdepallsl — kubectl get deployment all sl
Zoals je ziet, bestaan aliassen uit componenten, waarvan elke een bepaald onderdeel van het kubectl-commando aanduidt. Elke alias kan één component hebben voor het basiscommando, de actie en de bron, en meerdere componenten voor de parameters. Je 'vult' deze componenten gewoon in van links naar rechts volgens het bovenstaande schema.
De huidige gedetailleerde schema is te vinden op . Daar kun je ook een.
Bijvoorbeeld, de alias kgpooyamlall is gelijk aan het commando kubectl get pods -o yaml --all-namespaces.
De relatieve volgorde van opties is niet belangrijk: het commando kgpooyamlall is equivalent aan het commando kgpoalloyaml.
Je hoeft niet alle componenten als aliassen te gebruiken. Bijvoorbeeld k, kg, klo, ksys, kgpo kun je ook gebruiken. Bovendien kun je aliassen en gewone commando's of opties in de opdrachtregel combineren:
Bijvoorbeeld:
- In plaats van
kubectl proxykan geschreven worden alsk proxy. - In plaats van
kubectl get roleskan geschreven worden alskg roles(momenteel bestaat er geen alias voor de rolbronnen). - Om gegevens van een specifieke pod te krijgen, kun je het commando gebruiken
kgpo my-pod — kubectl get pod my-pod.
Houd er rekening mee dat sommige aliassen een argument in de opdrachtregel vereisen. Bijvoorbeeld, de alias kgpol , dat het pakket eruit ziet als volgt (voor de eenvoud gaan we ervan uit dat er geen VLAN-tags in het pakket zijn): kubectl get pods -l. Optie -l vereist een argument - de specificatie van het label. Als je een alias gebruikt, ziet deze eruit als kgpol app=ui.
Omdat sommige aliassen argumenten vereisen, moeten de aliassen a, f en l als laatste worden gebruikt.
Over het algemeen, zodra je dit schema onder de knie hebt, kun je intuïtief aliassen afleiden van de commando's die je wilt uitvoeren, waardoor je veel tijd bespaart bij het invoeren.
Installatie
Om kubectl-aliases te installeren, moet je het bestand downloaden van GitHub en het opnemen in het bestand ~/\.bashrc of ~/ .zshrc:
source ~/.kubectl_aliasesAutocompletion
Zoals we al zeiden, voeg je vaak extra woorden toe aan de alias in de opdrachtregel. Bijvoorbeeld:
$ kgpooyaml test-pod-d4b77b989Als je autocompletion voor het kubectl-commando gebruikt, heb je waarschijnlijk autocompletion gebruikt voor dingen zoals resource-namen. Maar kan dit ook met aliassen?
Dit is een zeer belangrijke vraag, want als autocompletion niet werkt, mis je een deel van de voordelen van aliassen.
Het antwoord hangt af van welke shell je gebruikt:
- Voor Zsh werkt autocompletion voor aliassen ‘out of the box’.
- Voor Bash zijn er helaas enkele stappen nodig om autocompletion aan de praat te krijgen.
Autocompletion inschakelen voor aliassen in Bash
Het probleem met Bash is dat het probeert te voltooien (elke keer als je Tab indrukt) de alias, en niet het commando waar de alias naar verwijst (zoals Zsh doet). Aangezien je geen autocompletion-scripts voor alle 800 aliassen hebt, werkt autocompletion niet.
Project biedt een algemene oplossing voor dit probleem. Het maakt verbinding met het autocompletion-mechanisme voor aliassen, voltooit intern de alias naar het commando en retourneert de autocompletion-opties voor het volledige commando. Dit betekent dat de autocompletion voor de alias zich precies hetzelfde gedraagt als voor het volledige commando.
Eerst zal ik uitleggen hoe je complete-alias installeert, en daarna hoe je het configureert om autocompletion voor alle kubectl-aliassen in te schakelen.
Instelling van complete-alias
Allereerst is complete-alias afhankelijk van . Zorg er daarom voor dat bash-completion is geïnstalleerd voordat je complete-alias installeert. Installatie-instructies werden eerder gegeven voor Linux en MacOS.
Belangrijke opmerking voor MacOS-gebruikers: net als het autocompletion-script voor kubectl werkt complete-alias niet met Bash 3.2, dat standaard wordt gebruikt in MacOS. In het bijzonder is complete-alias afhankelijk van bash-completion v2 (brew install bash-completion@2), waarvoor minstens Bash 4.1 vereist is. Dit betekent dat je een nieuwere versie van Bash moet installeren om complete-alias op MacOS te gebruiken.
Je moet het script downloaden uit en het opnemen in je bestand ~/\.bashrc:
source ~\/bash_completion.shNa het opnieuw opstarten van de shell is complete-alias volledig geïnstalleerd.
Autocompletion inschakelen voor kubectl-aliasen
Technisch gezien biedt complete-alias een shellfunctie _complete_alias. Deze functie controleert de alias en geeft autocompletion-suggesties voor de alias-commando.
Om de functie aan een specifieke alias te koppelen, moet je de ingebouwde Bash-mechanisme gebruiken , om in te stellen _complete_alias als de autocompletionfunctie van de alias.
Als voorbeeld nemen we de alias k, die de kubectl-opdracht vertegenwoordigt. Om in te stellen _complete_alias als de autocompletionfunctie voor deze alias, moet je de volgende opdracht uitvoeren:
$ complete -F _complete_alias k Het resultaat is dat elke keer dat je de alias k autocompleet, de functie _complete_alias, die de alias controleert en autocompletion-suggesties voor het commando teruggeeft, wordt aangeroepen. kubectl.
Als een tweede voorbeeld nemen we de alias kg, die vertegenwoordigt kubectl get:
$ complete -F _complete_alias kg Net als in het vorige voorbeeld, wanneer je kg autocompleet, krijg je dezelfde autocompletiesuggesties die je voor zou krijgen kubectl get.
Let op dat je complete-alias zo voor elke alias in je systeem kunt gebruiken.
Daarom, om autocompletion voor alle kubectl-aliasen in te schakelen, moet je de bovenstaande opdracht voor elk van hen uitvoeren. Het volgende fragment doet precies dat, ervan uitgaande dat je kubectl-aliases hebt geïnstalleerd in ~\/ .kubectl-aliases:
for _a in $(sed '\/^alias \/!d;s\/^alias \/\/;s\/=.*$\/\/ ' ~\/ .kubectl_aliases);
do
  complete -F _complete_alias "$_a"
done
Dit stukje code moet je in je ~/\.bashrc, de shell opnieuw opstarten en autocompletion voor alle 800 kubectl-aliasen zal beschikbaar zijn.
6. Kubectl uitbreiden met plugins
Beginning met , ondersteunt kubectl , dat het mogelijk maakt om zijn functionaliteit uit te breiden met extra commando's.
Als je bekend bent met , dan zijn de kubectl-plugins op dezelfde basis gebouwd.
In dit hoofdstuk leggen we uit hoe je plugins installeert, waar je ze kunt vinden en hoe je je eigen plugins kunt maken.
Plugins installeren
Kubectl-plugins worden verspreid als eenvoudige uitvoerbare bestanden met een naam in de vorm van kubectl-x. Het voorvoegsel kubectl- is verplicht, gevolgd door een nieuwe subcommando kubectl dat het aanroepen van de plugin mogelijk maakt.
Bijvoorbeeld, de hello-plugin wordt verspreid als een bestand met de naam kubectl-hello.
Om de plugin te installeren, moet je het bestand kopiëren kubectl-x naar een directory in je PATH-variabele en het uitvoerbaar maken, bijvoorbeeld met chmod +x. Direct daarna kun je de plugin aanroepen met kubectl x.
Je kunt de volgende commando gebruiken om een lijst te tonen van alle plugins die momenteel op je systeem zijn geïnstalleerd:
$ kubectl plugin listDit commando toont ook waarschuwingen als je meerdere plugins met dezelfde naam hebt, of als er een plugins-bestand is dat niet uitvoerbaar is.
Zoeken en installeren van plugins met Krew
Kubectl-plugins zijn geschikt voor samenwerking of hergebruik, net als softwarepakketten. Maar waar kun je plugins vinden die door anderen zijn gedeeld?
is gericht op het bieden van een uniforme oplossing voor het delen, zoeken, installeren en beheren van kubectl-plugins. Het project noemt zichzelf "pakketbeheerder voor kubectl-plugins" (Krew lijkt op ).
Krew is een lijst van kubectl-plugins die je kunt kiezen en installeren. Tegelijkertijd is Krew ook een plugin voor kubectl.
Dit betekent dat de installatie van Krew in wezen werkt als de installatie van elke andere kubectl-plugin. Je kunt gedetailleerde instructies vinden op .
De belangrijkste Krew-commando's:
# Поиск в списке плагинов
$ kubectl krew search [<query>]
# Посмотреть информацию о плагине
$ kubectl krew info <plugin>
# Установить плагин
$ kubectl krew install <plugin>
# Обновить все плагины до последней версии
$ kubectl krew upgrade
# Посмотреть все плагины, установленные через Krew
$ kubectl krew list
# Деинсталлировать плагин
$ kubectl krew remove <plugin>
Houd er rekening mee dat de installatie van plugins met Krew de installatie van plugins op de reguliere manier, zoals hierboven beschreven, niet tegenwerkt.
Let op dat de opdracht kubectl krew list toont alleen die plugins die zijn geïnstalleerd met Krew, terwijl het commando kubectl plugin list alle plugins vermeldt, dus die plugins die zijn geïnstalleerd met Krew en die welke op andere manieren zijn geïnstalleerd.
Zoeken naar plugins op andere plaatsen
Krew is een jong project, momenteel heeft het in zijn ongeveer 30 plugins. Als je niet kunt vinden wat je zoekt, kun je plugins op een andere plaats vinden, bijvoorbeeld op GitHub.
Ik raad aan om de GitHub-sectie te bekijken . Daar vind je een paar tientallen beschikbare plugins die het waard zijn om te bekijken.
Je eigen plugins schrijven
Je kunt zelf is niet moeilijk. Je moet een uitvoerbaar bestand maken dat doet wat nodig is, het noemen als kubectl-x en het installeren zoals hierboven beschreven.
Het bestand kan een bash-script, python-script of een gecompileerde go-applicatie zijn - dat maakt niet uit. De enige vereiste is dat het rechtstreeks in het besturingssysteem kan worden uitgevoerd.
Laten we nu een voorbeeldplugin maken. In het vorige gedeelte heb je het kubectl-commando gebruikt om een lijst van containers voor elke pod weer te geven. Je kunt dit commando gemakkelijk omzetten in een plugin die je kunt aanroepen, bijvoorbeeld met kubectl img.
Maak een bestand aan kubectl-img met de volgende inhoud:
#!/bin/bash
kubectl get pods -o custom-columns='NAME:metadata.name,IMAGES:spec.containers[*].image'
Maak het bestand nu uitvoerbaar met chmod +x kubectl-img en verplaats het naar een directory in je PATH. Direct daarna kun je de plugin gebruiken kubectl img.
Zoals eerder vermeld, kunnen kubectl-plugins in elke programmeertaal of script worden geschreven. Als je scripts in de shell gebruikt, is er het voordeel dat je kubectl gemakkelijk vanuit de plugin kunt aanroepen. Maar je kunt ook complexere plugins schrijven in echte programmeertalen, met behulp van . Als je Go gebruikt, kun je ook gebruikmaken van , die speciaal is ontworpen voor het schrijven van kubectl-plugins.
Hoe je je plugins kunt delen
Als je denkt dat je plugins nuttig kunnen zijn voor anderen, voel je vrij om ze op GitHub te delen. Vergeet niet ze aan de discussie toe te voegen .
Je kunt ook om toevoeging van je plugin vragen aan . Instructies hiervoor zijn beschikbaar in .
Autocompletion voor commando's
Op dit moment ondersteunen plugins geen autocompletion. Dat betekent dat je de volledige naam van de plugin en de volledige namen van de argumenten moet invoeren.
In de GitHub-repository van kubectl is er voor deze functie . Dus het is mogelijk dat deze functie in de toekomst ooit wordt gerealiseerd.
Veel succes!!!
Wat verder te lezen over dit onderwerp:
- .
- .
- .
Bron: habr.com
