

We live in an amazing time where you can quickly and easily connect several ready-made open tools, configure them with a 'disconnected mindset' based on advice from Stack Overflow, without delving into 'technical jargon', and launch them into commercial operation. And when it comes time to update/expand or if someone accidentally restarts a couple of machines — realize that a nightmarish situation has begun, everything has suddenly become incredibly complicated, there's no turning back, the future is uncertain, and instead of programming, one might as well keep bees and make cheese.
It’s no wonder that more experienced colleagues, with their hair turning gray from debugging, watch the unbelievably fast deployment of 'containers' in 'cubes' across dozens of servers using 'fashionable languages' with built-in support for asynchronous non-blocking I/O — they smile modestly. And silently continue to reread 'man ps', delving into the sources of 'nginx' until their eyes bleed, while writing unit tests. Colleagues know the most interesting challenges are ahead, especially when 'all this' becomes a chaotic nightmare during the New Year celebrations. Only a deep understanding of Unix fundamentals, memorized TCP/IP state tables, and basic sorting-search algorithms can help them revive the system as the clock strikes midnight.
Ah yes, I got a bit distracted, but I hope I conveyed the feeling of anticipation.
Today, I want to share our experience of deploying a convenient and inexpensive stack for a DataLake, which addresses most analytical tasks in the company for various departments.
Some time ago, we came to realize that companies need the results of both product and technical analytics more than ever (not to mention the cherry on top in the form of machine learning), and to understand trends and risks, it's necessary to gather and analyze more and more metrics.
Basic technical analytics in 'Bitrix24'
Enkele jaren geleden, gelijktijdig met de lancering van de service 'Bitrix24', hebben we actief tijd en middelen geïnvesteerd in het creëren van een eenvoudig en betrouwbaar analysetool dat helpt bij het snel identificeren van problemen in de infrastructuur en het plannen van de volgende stappen. Uiteraard wilden we kant-en-klare, eenvoudige en begrijpelijke tools gebruiken. Uiteindelijk hebben we gekozen voor Nagios voor monitoring en Munin voor analyse en visualisatie. Nu hebben we duizenden controles in Nagios, honderden grafieken in Munin, en collega’s maken er dagelijks met succes gebruik van. De statistieken zijn duidelijk, de grafieken zijn helder, het systeem werkt al vele jaren betrouwbaar en er worden regelmatig nieuwe tests en grafieken toegevoegd: bij het in gebruik nemen van een nieuwe service voegen we een aantal tests en grafieken toe. Een goede reis.
Vinger aan de pols — uitgebreide technische analyse
De wens om informatie over problemen 'zo snel mogelijk' te ontvangen, leidde ons tot actieve experimenten met eenvoudige en begrijpelijke tools — Pinba en XHProf.
Pinba stuurde ons in UDP-pakketten statistieken over de snelheid van verschillende delen van webpagina's op PHP en we konden in realtime zien in de MySQL-opslag (Pinba heeft zijn eigen MySQL-engine voor snelle gebeurtenisanalyse) een korte lijst met problemen en daarop reageren. Daarnaast stelde XHProf ons in staat om automatisch de uitvoeringsgrafieken van de langzaamste PHP-pagina's van klanten te verzamelen en te analyseren wat daartoe had geleid — rustig, met een kopje thee of iets sterkers.
Een tijdje geleden is onze toolkit aangevuld met nog een vrij eenvoudige en begrijpelijke engine op basis van het omgekeerde indexeringsalgoritme, schitterend geïmplementeerd in de legendarische bibliotheek Lucene — Elastic/Kibana. Het eenvoudige idee van meervoudige documentenschrijvingen in de omgekeerde index van Lucene op basis van gebeurtenissen in logs en snelle zoekopdrachten met behulp van facetverdeling — bleek inderdaad nuttig.
Ondanks de technische uitstraling van de visualisaties in Kibana met 'opwaarts doorlekken' van laagdrempelige concepten zoals 'bucket' en de opnieuw uitgevonden taal van de nog niet vergeten relationele algebra — bleek de tool goed te helpen bij de volgende taken:
- Hoeveel PHP-fouten had de Bitrix24-klant op het portaal p1 in het afgelopen uur en welke? Begrijpen, vergeven en snel corrigeren.
- Hoeveel video-oproepen zijn er in de afgelopen 24 uur uitgevoerd op de portalen in Duitsland, met welke kwaliteit en waren er problemen met de kanaal/netwerk?
- Hoe goed werkt de systeemfunctionaliteit (onze uitbreiding in C voor PHP), die is gecompileerd uit de broncode in de laatste update van de dienst en uitgerold naar de klanten? Zijn er geen segfaults?
- Worden de gegevens van klanten in PHP-geheugen geplaatst? Zijn er geen fouten met betrekking tot het overschrijden van het toegewezen geheugen voor processen: "out of memory"? Zoek en elimineer dat.
Hier is een specifiek voorbeeld. Ondanks grondig en veelvuldig testen, verscheen er bij de klant, in een zeer ongebruikelijke casus met beschadigde invoergegevens, een vervelende en onverwachte fout, er ging een sirene af en het proces van snelle correctie begon:
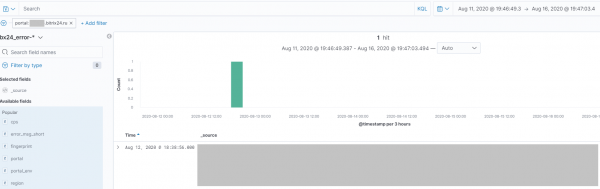
Bovendien maakt Kibana het mogelijk om meldingen in te stellen voor opgegeven gebeurtenissen en binnen korte tijd begonnen tientallen medewerkers uit verschillende afdelingen het hulpmiddel te gebruiken — van de klantenservice en ontwikkeling tot QA.
De activiteit van elke afdeling binnen het bedrijf is nu gemakkelijk te volgen en te meten — in plaats van handmatige analyse van logs op servers, is het voldoende om één keer het parseren van logs en hun verzending naar het elastic cluster in te stellen, om bijvoorbeeld te genieten van het bekijken van het aantal verkochte tweekopige kittens, afgedrukt op een 3D-printer, in de afgelopen maanmaand op het Kibana-dashboard.
Basis zakelijke analyse
Iedereen weet dat zakelijke analyse in bedrijven vaak begint met extreem actief gebruik, ja, ja, Excel. Maar, het belangrijkste is dat het daar niet eindigt. Ook de cloud Google Analytics gooit olie op het vuur — je went snel aan het goede.
In ons harmonieus ontwikkelende bedrijf verschijnen, hier en daar, 'profeten' die meer intensief met grotere data willen werken. Regelmatig ontstond de behoefte aan diepgaandere en veelzijdigere rapporten en met inzet van de collega's uit verschillende afdelingen werd enige tijd geleden een eenvoudige en praktische oplossing georganiseerd — de koppeling van ClickHouse en PowerBI.
Een behoorlijke tijd heeft deze flexibele oplossing uitstekend geholpen, maar geleidelijk werd duidelijk dat ClickHouse niet elastisch is en dat je er niet zo mee om kunt gaan.
Het is belangrijk om goed te begrijpen dat ClickHouse, net als Druid, Vertica en Amazon RedShift (dat op PostgreSQL is gebaseerd), analytics engines zijn die geoptimaliseerd zijn voor vrij gebruiksvriendelijke analyses (zoals sommen, aggregaties, minimum-maximum per kolom en een beetje joins), omdat ze georganiseerd zijn voor efficiënte opslag van kolommen in relationele tabellen, in tegenstelling tot het bekende MySQL en andere (row-oriented) databases.
In wezen is ClickHouse gewoon een grotere 'database', met een niet al te gebruiksvriendelijke puntinsertie (zoals het bedoeld is, alles ok), maar met aangename analytische mogelijkheden en een reeks interessante krachtige functies voor data-analyse. Ja, je kunt zelfs een cluster creëren - maar je begrijpt dat het niet helemaal juist is om spijkers met een microscoop te slaan en we zijn op zoek gegaan naar andere oplossingen.
Vraag naar Python en analisten
In ons bedrijf zijn er veel ontwikkelaars die bijna elke dag gedurende 10-20 jaar code schrijven in PHP, JavaScript, C#, C/C++, Java, Go, Rust, Python, Bash. Ook zijn er veel ervaren systeembeheerders die verschillende ongelooflijke rampen hebben overleefd die niet in de statistieken passen (bijvoorbeeld wanneer de meeste schijven in een RAID-10 worden vernietigd door een zware blikseminslag). In een dergelijke omgeving was het lange tijd onduidelijk wat een 'analist in Python' zou zijn. Python is namelijk zoals PHP, alleen is de naam iets langer en zijn er iets minder sporen van bewustzijnsveranderende stoffen in de broncode van de interpreter. Maar naarmate er steeds meer analytische rapporten werden gemaakt, begonnen ervaren ontwikkelaars zich steeds meer bewust te worden van het belang van specialisatie in tools zoals numpy, pandas, matplotlib, seaborn.
Waarschijnlijk heeft de plotselinge flauwvallen van medewerkers bij de combinatie van de woorden 'logistische regressie' en de demonstratie van het effectieve opstellen van rapporten op grote datasets via ja, ja, pyspark een cruciale rol gespeeld.
Apache Spark en zijn functionele paradigma, waarop relationele algebra uitstekend past, maakten zo'n indruk op ontwikkelaars die gewend waren aan MySQL, dat de noodzaak om de gelederen te versterken met ervaren analisten duidelijk werd als de dag.
Verdere pogingen van Apache Spark/Hadoop om op te stijgen en wat niet helemaal volgens plan verliep
Het werd echter al snel duidelijk dat er met Spark blijkbaar iets fundamental niet in orde was, of dat je gewoon je handen beter moest wassen. Als er voor de stack Hadoop/MapReduce/Lucene eigenlijk ervaren programmeurs aan het werk waren, wat duidelijk wordt als je kritisch naar de Java-broncode of de ideeën van Doug Cutting in Lucene kijkt, dan is Spark plotseling geschreven in een zeer controversiële en momenteel niet ontwikkelende exotische taal, Scala. De regelmatige crashes van berekeningen op de Spark-cluster als gevolg van de onlogische en niet erg transparante manier waarop geheugentoewijzing voor reduce-operaties wordt uitgevoerd (er komen ineens veel sleutels binnen) - heeft een aura gecreëerd van iets dat nog veel ruimte heeft om te groeien. Bovendien werd de situatie verergerd door het grote aantal vreemde open poorten, tijdelijke bestanden die op de meest onbegrijpelijke plaatsen groeiden en de avalanche van jar-afhankelijkheden — wat bij systeembeheerders één goed bekend gevoel opriep: intense haat (misschien was het nodig om de handen met zeep te wassen).
Uiteindelijk hebben we verschillende interne analytische projecten "overleefd", die actief gebruikmaakten van Apache Spark (inclusief Spark Streaming, Spark SQL) en het Hadoop-ecosysteem (enzovoort). Ondanks dat we na verloop van tijd erin zijn geslaagd om "het" behoorlijk goed voor te bereiden en te monitoren, en "het" praktisch niet meer ineens viel als gevolg van veranderingen in de aard van de data en ongelijkheid in de uniforme hashing van RDD, groeide de wens om iets kant-en-klaars, up-to-date en beheersbaar ergens in de cloud te gebruiken steeds sterker. Precies in die tijd hebben we geprobeerd een kant-en-klare cloudoplossing van Amazon Web Services te gebruiken — en probeerden vervolgens om problemen op deze manier op te lossen. EMR is de door Amazon bereide Apache Spark met extra software uit het ecosysteem, ongeveer zoals de Cloudera/Hortonworks-assemblages.
Een 'rubber' bestandsopslag voor analytics - een dringende behoefte
De ervaring met het 'bereiden' van Hadoop/Spark met brandwonden op verschillende lichaamsdelen is niet voor niets geweest. De noodzaak om een enkele, goedkope en betrouwbare bestandsopslag te creëren die bestand is tegen hardwarestoringen en waarin bestanden in verschillende formaten van verschillende systemen konden worden opgeslagen, en waarvoor effectieve en tijdig uitvoerbare selecties voor rapporten konden worden gemaakt, werd steeds duidelijker.
Ook wilden we dat het updaten van de software op dit platform geen nachtmerrie op oudejaarsavond zou worden, met het lezen van 20 pagina's Java-traces en het analyseren van kilometerslange gedetailleerde logs van de clusterwerking met behulp van Spark History Server en een vergrootglas. We wilden een eenvoudig en transparant hulpmiddel, dat geen regelmatige duik onder de motorkap vereist, wanneer een ontwikkelaar geen standaard MapReduce-query meer uitvoert door het uitvallen van het geheugen van de reduce-werknemer bij een niet zo gelukkig gekozen algoritme voor de partitionering van de oorspronkelijke gegevens.
Amazon S3 — kandidaat voor DataLake?
Onze ervaring met Hadoop/MapReduce heeft ons geleerd dat er een schaalbaar betrouwbaar bestandssysteem nodig is, met daarop schaalbare werknemers die dichterbij de gegevens komen, zodat we geen gegevens over het netwerk hoeven te verplaatsen. Werknemers moeten gegevens in verschillende formaten kunnen lezen, maar idealiter geen onnodige informatie lezen, en we moeten gegevens ook van tevoren in praktische formaten voor werknemers kunnen opslaan.
Nogmaals — het belangrijkste idee. Er is geen wens om grote gegevens in één enkele cluster-analytische engine te 'gooien', die toch vroeg of laat zal verzuipen en die we lelijk zullen moeten sharden. We willen bestanden opslaan, gewoon bestanden, in een begrijpelijk formaat en efficiënte analytische queries op hen uitvoeren met verschillende, maar begrijpelijke hulpmiddelen. En er zullen steeds meer bestanden in verschillende formaten zijn. Het is beter om niet de engine te sharden, maar de oorspronkelijke gegevens. We hebben besloten dat we een schaalbare en veelzijdige DataLake nodig hebben...
Wat als we bestanden opslaan in het bekende en voor velen bekende schaalbare cloudopslag van Amazon S3, zonder zelf het bekende bereiding van Hadoop te hoeven doen?
Het is duidelijk, persoonlijke gegevens 'mag niet', maar andere gegevens als we die daarheen brengen en 'efficiënt laten draaien'?
Cluster-big data-analytische ecosysteem van Amazon Web Services — in zeer eenvoudige bewoordingen
Op basis van onze ervaring met AWS, wordt daar al lang en actief onder verschillende sauces Apache Hadoop/MapReduce gebruikt, bijvoorbeeld in de service DataPipeline (ik ben jaloers op mijn collega's, zij hebben geleerd het goed te bereiden). Hier hebben we back-ups ingesteld van verschillende diensten vanuit DynamoDB-tabellen:
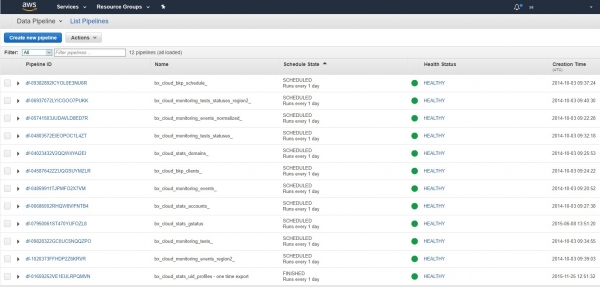
En ze worden al enkele jaren regelmatig uitgevoerd op de ingebouwde clusters van Hadoop/MapReduce als een klok. 'Instellen en vergeten':
Bovendien kun je effectief datascience beoefenen door Jupiter-notebooks in de cloud te gebruiken voor analisten en AI-modellen te trainen en implementeren via de AWS SageMaker-service. Zo ziet het bij ons uit:
Ja, je kunt ook een notebook in de cloud opzetten of één voor de analist verbinden met een Hadoop/Spark-cluster, alles berekenen en vervolgens ‘afmaken’:
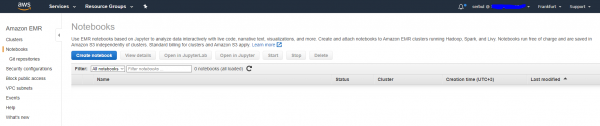
Het is echt handig voor afzonderlijke analytische projecten en voor enkele daarvan hebben we met succes de EMR-service gebruikt voor grootschalige berekeningen en analyses. Maar hoe zit het met een systeemoplossing voor DataLake? Zou dat lukken? Op dat moment stonden we op de rand van hoop en wanhoop en bleven we zoeken.
AWS Glue is netjes verpakt Apache Spark ‘op steroïden’
Het bleek dat AWS een ‘eigen’ versie van de stack ‘Hive/Pig/Spark’ heeft. De rol van Hive, dat wil zeggen het catalogiseren van bestanden en hun types in de DataLake, wordt vervuld door de ‘Data catalog’ service, die ook niet verbergt dat het compatibel is met het Apache Hive-formaat. In deze service moet je informatie toevoegen over waar je bestanden zijn opgeslagen en in welk formaat. Gegevens kunnen niet alleen in s3 staan, maar ook in een database, maar daar gaat deze post niet over. Zo is onze DataLake-datacatalogus georganiseerd:
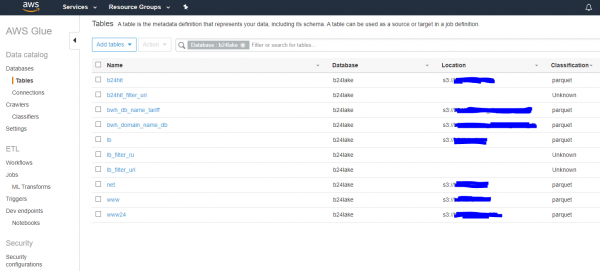
Bestanden zijn geregistreerd, geweldig. Als de bestanden zijn bijgewerkt, starten we ofwel handmatig of volgens schema crawlers die de informatie uit het meer bijwerken en opslaan. Vervolgens kunnen de gegevens uit het meer worden verwerkt en de resultaten ergens naartoe worden geëxporteerd. In het eenvoudigste geval exporteren we ook naar s3. Gegevensverwerking kan overal plaatsvinden, maar het wordt aanbevolen om het verwerkingsproces in te stellen op een Apache Spark-cluster met uitgebreide mogelijkheden via de AWS Glue API. In wezen kun je de oude en vertrouwde code in Python met behulp van de bibliotheek pyspark nemen en deze laten draaien op N knooppunten van een cluster met een bepaalde capaciteit met monitoring, zonder te graven in de ingewanden van Hadoop en het slepen van Docker-containers en het oplossen van afhankelijkheidsconflicten.
Nogmaals: een eenvoudig idee. Je hoeft Apache Spark niet in te stellen, je hoeft alleen code in Python te schrijven voor pyspark, deze lokaal op je desktop te testen en vervolgens op een groot cluster in de cloud te starten, waarbij je aangeeft waar de brondgegevens zijn opgeslagen en waar je het resultaat wilt opslaan. Soms is dit nodig en nuttig en zo is het bij ons ingesteld:
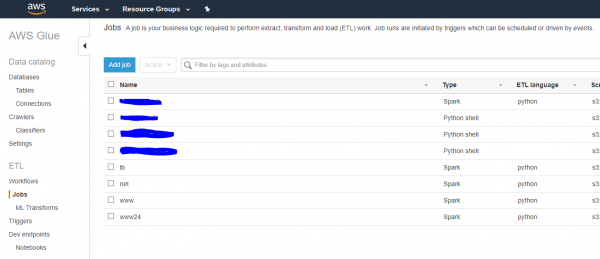
Dus als je iets wilt berekenen op een Spark-cluster met gegevens in s3, schrijf je code in Python/pyspark, test je het en ga je met een gerust hart naar de cloud.
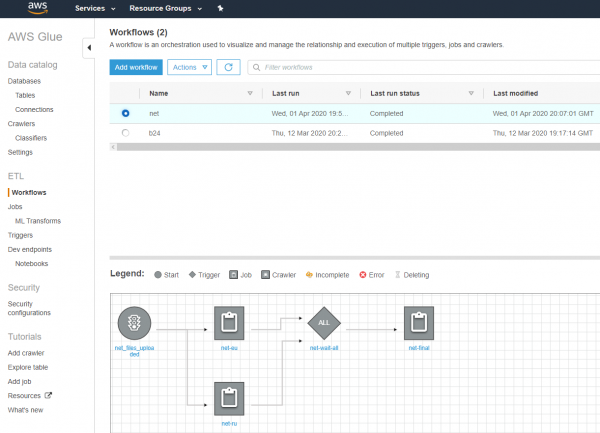
En wat is er met de orkestratie? En als de taak faalt en verdwijnt? Ja, er wordt voorgesteld om een mooie pipeline te maken in de stijl van Apache Pig en we hebben ze zelfs geprobeerd, maar we hebben besloten om voorlopig onze diep gepersonaliseerde orkestratie in PHP en JavaScript te gebruiken (ik begrijp dat er cognitieve dissonantie ontstaat, maar het werkt al jaren en zonder fouten).
Het formaat van de bestanden die in het meer worden opgeslagen, is de sleutel tot de prestaties.
Het is heel, heel belangrijk om nog twee belangrijke punten te begrijpen. Om ervoor te zorgen dat gegevensverzoeken op de bestanden in het meer zo snel mogelijk worden uitgevoerd en dat de prestaties niet verslechteren bij het toevoegen van nieuwe informatie, is het nodig:
- De kolommen van de bestanden apart op te slaan (zodat je niet alle rijen hoeft te lezen om te begrijpen wat er in de kolommen staat). Hiervoor hebben we het Parquet-formaat met compressie gekozen.
- Het is zeer belangrijk om bestanden te sharden in mappen in de geest van: taal, jaar, maand, dag, week. Engines die dit type sharding begrijpen, zullen alleen in de juiste mappen kijken, zonder door alle gegevens heen te hoeven graven.
In wezen leg je op deze manier de oorspronkelijke gegevens efficiënt bloot voor de analytische engines die hier bovenop komen, en die kunnen selectief de sharded mappen binnenkomen en alleen de benodigde kolommen uit de bestanden lezen. Je hoeft niets ergens ‘op te laden’ (de opslag zou immers gewoon exploderen) — leg ze gewoon verstandig direct in het bestandssysteem in het juiste formaat. Natuurlijk moet het duidelijk zijn dat het niet erg doelmatig is om een enorme CSV-bestand in DataLake op te slaan, dat je eerst rij voor rij met een cluster moet lezen om de kolommen eruit te halen. Denk nog eens na over de twee bovenstaande punten als het nog niet duidelijk is waarom dit allemaal nodig is.
AWS Athena — de 'geest' uit de doos.
En hier, terwijl we het meer aan het creëren waren, stuitten we zomaar op Amazon Athena. Het bleek plotseling dat, door onze enorme logbestanden netjes in sharded mappen in het juiste (parquet) kolomformaat te organiseren, we heel snel zeer informatieve selecties konden maken en rapporten konden opstellen ZONDER, zonder een Apache Spark/Glue-cluster.
De Athena-engine, die op gegevens in s3 werkt, is gebaseerd op de legendarische — vertegenwoordiger van de MPP (massive parallel processing) benaderingen voor gegevensverwerking, die gegevens pakt waar ze zich bevinden, van s3 en Hadoop tot Cassandra en normale tekstbestanden. Je hoeft alleen maar Athena te vragen om een SQL-query uit te voeren, en verder werkt alles 'snel en automatisch'. Het is belangrijk op te merken dat Athena 'slim' is, alleen de benodigde geshardde mappen doorzoekt en alleen de noodzakelijke kolommen in de query leest.
De verzoeken naar Athena worden ook interessant gefactureerd. We betalen voor . Dat wil zeggen, niet per aantal machines in het cluster per minuut, maar… voor de daadwerkelijk gescande gegevens op 100-500 machines die noodzakelijk zijn voor het uitvoeren van de query.
Door alleen de benodigde kolommen uit de juiste geshardde mappen op te vragen, bleek dat de Athena-service ons honderden dollars per maand kost. Geweldig, toch, bijna gratis, vergeleken met analytics op clusters!
Zo scharden wij onze gegevens in s3:
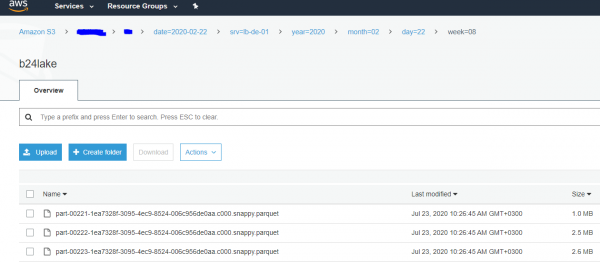
Als gevolg hiervan begonnen verschillende afdelingen binnen het bedrijf, van informatiebeveiliging tot analytics, actief verzoeken te doen aan Athena en snel, binnen enkele seconden, nuttige antwoorden uit de 'grote' gegevens te krijgen over behoorlijk lange periodes: maanden, een half jaar, enz.
Maar we gingen verder en begonnen antwoorden in de cloud op te zoeken : een analist schrijft in de vertrouwde console een SQL-query, die op 100-500 machines 'voor een schijntje' gegevens in s3 doorzoekt en meestal binnen enkele seconden een antwoord terugbrengt. Handig. En snel. Het blijft nog steeds onwerkelijk.
Als resultaat, na de beslissing om gegevens in s3 op te slaan, in een efficiënt kolomformaat en met een verstandige sharding van gegevens per map… hebben we een DataLake en een snelle en goedkope analytische motor gekregen — gratis. En het werd erg populair binnen het bedrijf, omdat het SQL begrijpt en veel sneller werkt dan via het opstarten/stoppen/configureren van clusters. 'Als het resultaat hetzelfde is, waarom dan meer betalen?'
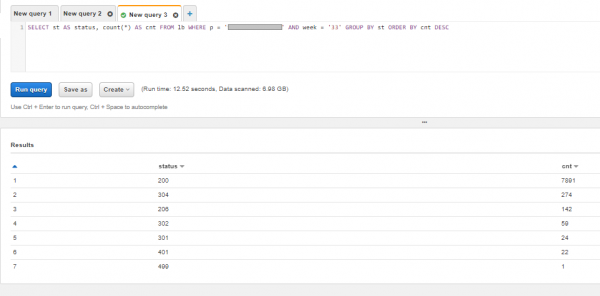
Een verzoek aan Athena ziet er ongeveer zo uit. Indien gewenst, kan men natuurlijk een vrij , maar we beperken ons tot een eenvoudige groepering. Laten we kijken welke antwoordcodes de klant enkele weken geleden had in de logs van de webserver en verifiëren dat er geen fouten zijn:
Conclusies
Na een niet al te lange, maar toch pijnlijke weg, waarin we voortdurend de risico's, de moeilijkheidsgraad en de ondersteuningskosten hebben geëvalueerd, hebben we een oplossing gevonden voor DataLake en analyse die ons blijft verrassen met zowel snelheid als eigendomskosten.
Het blijkt dat het mogelijk is om een efficiënte, snelle en goedkope DataLake op te bouwen voor de behoeften van heel verschillende afdelingen van het bedrijf — zelfs voor ervaren ontwikkelaars die nooit als architecten hebben gewerkt en die niet weten hoe ze vierkantjes moeten tekenen met pijltjes, met 50 termen uit het Hadoop-ecosysteem.
Aan het begin van de reis had ik het gevoel dat mijn hoofd barstte van de vele vreemde zoos van open en gesloten software en het besef van de verantwoordelijkheidslast tegenover toekomstige generaties. Begin gewoon met het bouwen van je DataLake met eenvoudige tools: nagios/munin -> elastic/kibana -> Hadoop/Spark/s3 ..., verzamel feedback en begrijp de fysica van de processen grondig. Geef alles wat complex en onduidelijk is aan je vijanden en concurrenten.
Als je niet naar de cloud wilt en het leuk vindt om open source-projecten te onderhouden, bij te werken en te patchen, kun je een vergelijkbaar schema lokaal opbouwen, op goedkope kantoorcomputers met Hadoop en Presto erbovenop. Het belangrijkste is om niet stil te staan, vooruit te gaan, te rekenen, naar eenvoudige en duidelijke oplossingen te zoeken, en alles zal zeker goedkomen! Veel succes iedereen en tot ziens!
Bron: habr.com
