

Hallo, Habr! De laatste paar maanden hebben we in een zeer interessante situatie geleefd, en ik wilde onze geschiedenis van infrastructuurschaalvergroting delen. In deze tijd is SberMarket vier keer gegroeid in bestellingen en heeft het diensten gelanceerd in 17 nieuwe steden. De explosieve groei in de vraag naar levensmiddelenlevering vereiste dat we onze infrastructuur schalen. Lees meer over de meest interessante en nuttige conclusies hieronder.
Mijn naam is Dima Bobylev, ik ben de technische directeur van SberMarket. Aangezien dit de eerste post in onze blog is, wil ik een paar woorden over mezelf en het bedrijf zeggen. Vorige herfst nam ik deel aan de wedstrijd voor jonge leiders van Runet. Voor de wedstrijd heb ik over hoe wij bij SberMarket de interne cultuur en de benadering van de ontwikkeling van de dienst zien. En hoewel ik de wedstrijd niet heb gewonnen, heb ik toch de belangrijkste principes voor de ontwikkeling van het IT-ecosysteem voor mezelf geformuleerd.
Bij het managen van een team is het belangrijk om een balans te vinden tussen wat het bedrijf nodig heeft en de behoeften van elke specifieke ontwikkelaar. Momenteel groeit SberMarket met 13 keer jaar op jaar, en dit heeft invloed op het product, wat vereist dat we constant de volumes en de snelheid van ontwikkeling verhogen. Desondanks besteden we voldoende tijd aan ontwikkelaars voor een grondige analyse en het kwalitatief schrijven van code. De geformuleerde aanpak helpt niet alleen bij het creëren van een werkend product, maar ook bij de verdere schaalvergroting en ontwikkeling ervan. Als gevolg van deze groei is SberMarket al een leider geworden onder de levensmiddelenleveringsservices: we bezorgen dagelijks ongeveer 18.000 bestellingen, terwijl dat er begin februari nog ongeveer 3.500 waren.
Op een dag vroeg een klant aan de koerier van SberMarket om de producten contactloos te bezorgen — rechtstreeks op het balkon.
Maar laten we naar de details gaan. De afgelopen paar maanden hebben we actief gewerkt aan het schalen van de infrastructuur van ons bedrijf. Deze behoefte werd veroorzaakt door interne en externe factoren. Tegelijkertijd met de uitbreiding van onze klantenbasis is het aantal aangesloten winkels gestegen van 90 aan het begin van het jaar tot meer dan 200 medio mei. We hebben ons natuurlijk voorbereid, de belangrijkste infrastructuur gereserveerd en rekening gehouden met de mogelijkheid van verticale en horizontale schaalvergroting van alle virtuele machines die in de cloud van Yandex zijn geplaatst. De praktijk heeft echter aangetoond: "Alles wat mis kan gaan, zal misgaan." Vandaag wil ik de meest interessante situaties delen die zich in deze weken hebben voorgedaan. Ik hoop dat onze ervaringen nuttig voor u zullen zijn.
Slave is in volledige gevechtsklaarheid
Al voordat de pandemie begon, zagen we een stijging in het aantal aanvragen voor onze backend-servers. De trend om producten thuis te laten bezorgen begon steeds meer terrein te winnen, en met de invoering van de eerste maatregelen voor zelfisolatie in verband met COVID-19, nam de belasting dramatisch toe gedurende de hele dag. Er ontstond een behoefte om de masterservers van de hoofd-DATABASE snel te ontlasten en een deel van de leesverzoeken naar de replica-servers (slave) te verplaatsen.
We maakten ons van tevoren klaar voor deze stap, en voor deze manoeuvre waren al 2 slave-servers opgezet. Hierop werden vooral batch-taken uitgevoerd voor het genereren van informatiefeeds voor gegevensuitwisseling met partners. Deze processen veroorzaakten een onnodige belasting en werden helemaal terecht "buiten beschouwing gelaten" een paar maanden eerder.
Aangezien op de Slave replicatie plaatsvond, hielden we ons aan het concept dat applicaties alleen in read-only modus met hen konden werken. Het Disaster Recovery Plan voorzag erin dat we in geval van een ramp eenvoudig de Slave op de plaats van de Master konden monteren en alle schrijf- en leesverzoeken naar de Slave konden omleiden. We wilden echter ook de replicates gebruiken voor de behoeften van de analytics-afdeling, dus de servers werden niet volledig in read-only-status gezet, en op elke host was er een eigen set gebruikers, waarvan sommige schrijfrechten hadden om tussenresultaten van berekeningen op te slaan.
Tot een bepaald niveau van belasting was de master voldoende voor zowel schrijven als lezen bij het verwerken van http-verzoeken. Medio maart, net toen Sbermarket besloot volledig over te stappen op thuiswerken, begon onze RPS een exponentiële groei. Steeds meer van onze klanten gingen in zelfisolatie of werkten vanuit huis, wat de belastingspieken beïnvloedde.
De prestaties van de ‘master’ waren niet langer voldoende, dus begonnen we een deel van de zwaarste leesverzoeken naar de replicatie te verplaatsen. Voor een transparante doorsturing van schrijfverzoeken naar de master en leesverzoeken naar de slave, gebruikten we de Ruby-gem ““ We creëerden een speciale gebruiker met de suffix _readonly zonder schrijfrechten. Maar door een configuratiefout op een van de hosts werden enkele schrijfverzoeken als de gebruiker met de juiste rechten naar de slave-server gestuurd.
Het probleem deed zich niet meteen voor, omdat de verhoogde belasting de achterstand van de slaves vergrootte. De inconsistentie van de gegevens werd ontdekt in de ochtend, toen de slaves na de nachtelijke importen de master niet ‘haalde’. We schreven dit toe aan de hoge belasting van de service zelf en de import die verband hield met de lancering van nieuwe winkels. Maar het leveren van gegevens met een vertraging van meerdere uren was onacceptabel, dus schakelden we de processen over naar de tweede analytische slave, omdat deze grotere middelen had en niet belast was met leesverzoeken (wat we ook gebruikten om voor onszelf het gebrek aan replicatielaag te verklaren).groter publiek.Toen we de oorzaken van de ‘uitstrooiing’ van de primaire slave begrepen, was de analytische slave al om dezelfde reden buiten werking. Ondanks de aanwezigheid van twee extra servers, waaraan we de belasting in het geval van een storing van de master zouden overdragen, bleek het door een vervelende fout te zijn dat er op dat kritieke moment geen enkele beschikbaar was.
Maar aangezien we niet alleen een dump van de database maakten (de restore op dat moment kostte ongeveer 5 uur), maar ook een snapshot van de master-server, lukte het ons om de replicatie binnen 2 uur te starten. Het probleem was echter dat we daarna nog steeds te maken kregen met het inhalen van het replicatielog voor een aanzienlijke tijd (omdat het proces in een enkelvoudige thread werkt, maar dat is al een heel ander verhaal).
Maar omdat we niet alleen een dump van de database maakten (de restore op dat moment duurde ongeveer 5 uur), maar ook een snapshot van de masterserver, konden we de replica binnen 2 uur opstarten. Het was echter wel zo dat we daarna te maken kregen met het verwerken van het replicatielog gedurende een lange tijd (omdat het proces in enkelvoudige modus loopt, maar dat is weer een heel ander verhaal).
Uitvoer: Na aanleiding van dit voorval werd het duidelijk dat we moesten stoppen met de praktijk van het beperken van schrijfrechten voor gebruikers en de hele server als alleen-lezen moesten verklaren. Met deze aanpak kunnen we er zeker van zijn dat de replica's beschikbaar zijn op cruciale momenten.
De optimalisatie van zelfs één zware query kan de database 'weer tot leven brengen'.
Hoewel we de catalogus op de site voortdurend bijwerken, vertoonden de queries die we naar Slave-servers stuurden een kleine achterstand ten opzichte van de Master. De tijd die we nodig hadden om het probleem van de 'plotseling gestopte' slaves te identificeren en op te lossen was langer dan de 'psychologische drempel' (in die tijd kon er een prijsupdate hebben plaatsgevonden, en klanten zouden verouderde gegevens hebben gezien), en we waren genoodzaakt alle queries naar de primaire database server te verschuiven. Het gevolg was dat de site traag werkte... maar het werkte tenminste. En terwijl de Slave zich herstelde, hadden we niets anders te doen dan optimaliseren.
Terwijl de Slave-servers herstelden, sleepte de tijd zich langzaam voort, de Master bleef overbelast, en we zetten al onze inspanningen in op de optimalisatie van actieve taken volgens de 'Pareto-regel': we selecteerden de TOP-queries die het grootste deel van de belasting veroorzaakten en begonnen met tuning. Dit gebeurde live.
Een interessant effect was dat een tot de nok gevulde MySQL reageert op zelfs de kleinste verbetering van de processen. De optimalisatie van een paar queries die slechts 5% van de totale belasting veroorzaakten, toonde al een aanzienlijke verlichting van de CPU. Hierdoor konden we een aanvaardbare hoeveelheid middelen garanderen voor de werking van de Master met de database en de benodigde tijd verkrijgen voor het herstellen van de replica's.
Uitvoer: Zelfs een kleine optimalisatie maakt het mogelijk om 'te overleven' bij overbelasting gedurende enkele uren. Dit was precies wat we nodig hadden terwijl de servers met de replica's herstelden. Trouwens, de technische kant van het optimaliseren van queries zullen we in een van de volgende berichten bespreken. Dus abonneer je op onze blog als dat nuttig voor je kan zijn.
Organiseer de monitoring van de werking van partner-services.
Wij verwerken bestellingen van klanten en daarom communiceren onze diensten voortdurend met externe API's - dit zijn poorten voor het verzenden van SMS-berichten, betalingsplatforms, routeringssystemen, geocoders, de belastingdienst en vele andere systemen. En wanneer de druk snel toenam, stuitten we op de limieten van de API's van onze partnerdiensten, waar we eerder niet eens over hadden nagedacht.
Een onverwachte overschrijding van de quota van partnerdiensten kan leiden tot downtime van uw eigen service. Veel API's blokkeren klanten die de limieten overschrijden, en in sommige gevallen kan een overvloed aan verzoeken de productie bij de partner overbelasten.
Bijvoorbeeld, op het moment dat het aantal leveringen toenam, konden de ondersteunende diensten de taken van distributie en routebepaling niet aan. Als gevolg hiervan werden de bestellingen geplaatst, maar de service die de route genereert, werkte niet. Het moet gezegd worden dat onze logistiekers in deze omstandigheden praktisch het onmogelijke hebben gedaan, en de duidelijke samenwerking van het team hielp om de tijdelijke storingen van de diensten te compenseren. Maar zo'n hoeveelheid aanvragen kan niet constant handmatig worden verwerkt, en na enige tijd zouden we met een onacceptabele kloof tussen bestellingen en hun uitvoering worden geconfronteerd.
Er zijn een aantal organisatorische maatregelen genomen en de gecoördineerde inspanningen van het team hielpen ons tijd te winnen terwijl we afspraken maakten over nieuwe voorwaarden en wachtten op de modernisering van de diensten door enkele partners. Er zijn ook andere API's die zich onderscheiden door hun hoge veerkracht en exorbitante tarieven bij hoge verkeersvolumes. In het begin gebruikten we een bekende kaart-API om het adres van het afleverpunt te bepalen. Maar aan het einde van de maand kregen we een rekening van bijna 2 miljoen roebel. Daarop hebben we besloten het snel te vervangen. Ik zal geen reclame maken, maar ik kan zeggen dat onze kosten aanzienlijk zijn verminderd.
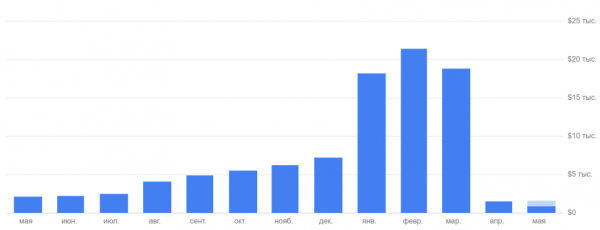
Uitvoer: Het is absoluut noodzakelijk om de bedrijfsvoorwaarden van alle partnerdiensten te monitoren en deze in gedachten te houden. Zelfs als het vandaag lijkt alsof ze 'met een flinke marge' aan de verwachtingen voldoen, betekent dat niet dat ze morgen geen belemmering voor groei kunnen vormen. En het is natuurlijk beter om van tevoren afspraken te maken over de financiële voorwaarden van toegenomen verzoeken aan de service.
Soms blijkt dat "" (c) helpt niet
We are used to experiencing "bottlenecks" in the main database or on application servers, but during scaling, issues can arise where you least expect them. For full-text search on the site, we use the Apache Solr engine. With increasing load, we noticed a decline in response times, and the server's CPU load reached 100%. What could be simpler—let's provide the Solr container with more resources.
Instead of the expected performance increase, the server simply "failed." It immediately loaded to 100% and responded even slower. Initially, we had 2 cores and 2 GB of RAM. We decided to do what usually helps—we gave the server 8 cores and 32 GB. Everything became much worse (how and why exactly will be explained in a separate post).
In just a few days, we understood the intricacies of this issue and achieved optimal performance with 8 cores and 32 GB of RAM. This configuration still allows us to continue increasing the load, which is very important because the growth is not only in customers but also in the number of connected stores—over the course of 2 months, their number doubled.
Uitvoer: Standard methods like "adding more hardware" do not always work. Therefore, when scaling any service, it's essential to understand how it utilizes resources and to test its operation under new conditions in advance.
Stateless—key to simple horizontal scaling.
Overall, our team adheres to the well-known approach: services should not maintain internal state (stateless) and should be independent of the runtime environment. This allowed us to handle load growth through simple horizontal scaling. However, we had one exception—a handler for long background tasks. It dealt with sending emails and SMS, processing events, generating feeds, importing prices and stock levels, and processing images. It happened that it depended on local file storage and existed as a single instance.
Toen het aantal taken in de wachtrij van de handler steeg (wat natuurlijk gebeurde met de toename van het aantal bestellingen), werd de prestaties van de host waar de handler en de opslag waren ondergebracht een beperkende factor. Hierdoor stopte de update van het assortiment en de prijzen, het verzenden van notificaties naar gebruikers en veel andere kritische functies die vastzaten in de wachtrij. Het Ops-team migreerde snel de opslag naar een S3-achtig netwerkopslag, waardoor we verschillende krachtige machines konden opzetten om de achtergrondverwerker te schalen.
Uitvoer: De Stateless-regel moet voor alle componenten zonder uitzondering worden nageleefd, ook als het lijkt alsof we daar zeker niet tegenaan zullen lopen. Het is beter om wat tijd te besteden aan de juiste organisatie van het werk van alle systemen dan later in alle haast de code opnieuw te moeten schrijven en de service te repareren die overbelast is.
7 principes voor intensieve groei
Ondanks de beschikbaarheid van extra capaciteit, zijn we tijdens het groeiproces tegen verschillende obstakels aangelopen. In deze periode is het aantal bestellingen meer dan vier keer toegenomen. Inmiddels bezorgen we al meer dan 17.000 bestellingen per dag in 62 steden en hebben we plannen om ons bereik nog verder uit te breiden — in de eerste helft van 2020 staat de lancering van de service door heel Rusland op de agenda. Om de groeiende belasting aan te kunnen, en met inachtneming van de eerder opgelopen schade, hebben we 7 kernprincipes voor werken onder constante groei vastgesteld:
- Incidentmanagement. We hebben een bord in Jira gemaakt, waar elk incident wordt weergegeven als een ticket. Dit zal helpen om feitelijk gerelateerde taken te prioriteren en uit te voeren. Het is immers niet erg om een fout te maken — het is erg om diezelfde fout twee keer te maken. Voor die gevallen waarin incidenten zich herhalen voordat we de oorzaak kunnen verhelpen, moet er een actieplan gereed zijn, omdat het tijdens grote belasting belangrijk is om razendsnel te reageren.
- Monitoring Dit is noodzakelijk voor alle infrastructuurelementen zonder uitzondering. Dankzij dit konden we de toename van de belasting voorspellen en de ‘flessenhalzen’ correct kiezen voor prioriteit bij het oplossen. Hoogstwaarschijnlijk zal bij hoge belasting alles waar je niet aan dacht, falen of beginnen te haperen. Daarom is het het beste om nieuwe waarschuwingen direct na de eerste incidenten aan te maken, om deze te monitoren en te anticiperen.
- Juiste waarschuwingen zijn absoluut noodzakelijk bij een plotselinge toename van de belasting. Ten eerste moeten ze melden wat precies is mislukt. Ten tweede mogen er niet te veel waarschuwingen zijn, want een overvloed aan niet-kritieke waarschuwingen leidt tot het negeren van alle meldingen.
- Toepassingen moeten stateless zijn. We hebben bevestigd dat voor deze regel geen uitzonderingen mogen zijn. Volledige onafhankelijkheid van de runtime-omgeving is nodig. Hiervoor kun je gedeelde gegevens opslaan in een database of bijvoorbeeld rechtstreeks in S3. En het is nog beter om de regels te volgen. Tijdens een plotselinge stijging van de belasting is er geen tijd om de code te optimaliseren en moet je de belasting aankunnen door simpelweg de rekenkracht en horizontale schaalbaarheid te verhogen.
- Quota en prestaties van externe diensten. Bij een snelle groei kan het probleem zich niet alleen in jouw infrastructuur voordoen, maar ook bij de externe dienst. Het is bijzonder frustrerend wanneer dit niet het gevolg is van een storing, maar door het bereiken van quota of limieten. Externe diensten moeten daarom net zo goed schalen als jijzelf.
- Scheide processen en wachtrijen. Dit helpt enorm wanneer er een bottleneck optreedt bij een van de gateways. We zouden geen vertragingen in gegevensoverdracht hebben ervaren als de volle wachtrijen voor het verzenden van SMS-berichten de uitwisseling van meldingen tussen informatiesystemen niet in de weg stonden. Bovendien zou het eenvoudiger zijn om het aantal werkers te verhogen als ze apart werkten.
- Financiële realiteiten. Wanneer er een explosieve groei van gegevensstromen plaatsvindt, is er geen tijd om na te denken over tarieven en abonnementen. Maar je moet ze in gedachten houden, vooral als je een klein bedrijf bent. Een hoge rekening kan worden gepresenteerd door elke API-eigenaar, evenals door je hostingprovider. Daarom moet je de contracten zorgvuldig lezen.
Conclusie
Hoewel we ons niet zonder verliezen hebben kunnen redden, hebben we deze fase overwonnen en proberen we vandaag de dag alle gevonden principes na te leven. Elke machine heeft de mogelijkheid om de prestaties met een factor 4 gemakkelijk te verhogen, zodat deze onverwachte situaties aankan.
In de volgende berichten zullen we onze ervaringen delen met het onderzoeken van prestatieverlies in Apache Solr. Ook zullen we vertellen over het optimaliseren van verzoeken en hoe samenwerking met de belastingdienst het bedrijf helpt kosten te besparen. Volg onze blog zodat je niets mist en laat in de reacties weten of je soortgelijke problemen hebt ervaren tijdens een verkeersgroei.
Alleen geregistreerde gebruikers kunnen deelnemen aan de enquête. , alstublieft.
Heb je vertraging of uitval van de service ervaren door een plotselinge toename van de belasting door:
55,6%Onmogelijkheden om snel rekencapaciteit toe te voegen.
16,7%Limieten van de infrastructuur van de hostingprovider.
33,3%Limieten van externe API's.
27,8%Schending van de stateless principes van je applicaties.
88,9%Onoptimale code van je eigen services.
18 gebruikers hebben gestemd. 6 gebruikers hebben zich onthouden.
Bron: habr.com
