

Mijn naam is Anton Baderin. Ik werk bij het Centrum voor Geavanceerde Technologie en ben system administrator. Een maand geleden hebben we onze bedrijfscorporatieconferentie afgerond, waar we onze opgebouwde ervaringen deelden met de IT-gemeenschap van onze stad. Ik sprak over het monitoren van webapplicaties. Het materiaal was bedoeld voor het junior of middle niveau, dat dit proces nog niet vanaf nul heeft opgebouwd.
De hoeksteen van elk monitorsysteem is het oplossen van zakelijke vraagstukken. Monitoren om te monitoren interesseert niemand. Wat wil het bedrijfsleven? Dat alles snel en zonder fouten werkt. Het bedrijfsleven wil proactiviteit, zodat wij zelf problemen in de werking van de service signaleren en deze zo snel mogelijk oplossen. Dit zijn in feite de vraagstukken die ik het afgelopen jaar op het project van een van onze klanten heb opgelost.
Over het project
Het project is een van de grootste loyaliteitsprogramma's in het land. We helpen detailhandelketens de verkoopfrequentie te verhogen met verschillende marketinginstrumenten zoals bonuskaarten. In totaal omvat het project 14 applicaties die op tien servers draaien.
Tijdens het voeren van interviews heb ik herhaaldelijk opgemerkt dat systeemadministrators niet altijd de juiste aanpak hanteren voor het monitoren van webapplicaties: velen stoppen nog steeds bij de metriek van het besturingssysteem en monitoren sporadisch de services.
In mijn geval lag er eerder een Icinga-systeem ten grondslag aan de monitoringssystemen van de klant. Dit loste de bovengenoemde vraagstukken totaal niet op. Vaak meldde de klant zelf de problemen aan ons en soms ontbraken ons gewoon de gegevens om de oorzaak te achterhalen.
Bovendien was er een helder inzicht in de uitzichtloosheid van verdere ontwikkeling. Ik denk dat degenen die bekend zijn met Icinga mij zullen begrijpen. Dus hebben we besloten het monitoringsysteem voor webapplicaties op het project volledig te herstructureren.
Prometheus
We kozen voor Prometheus, gebaseerd op drie belangrijke criteria:
- Een enorme hoeveelheid beschikbare metrische gegevens. In ons geval zijn dat er 60.000. Natuurlijk moet worden opgemerkt dat de overgrote meerderheid ervan (misschien ongeveer 95%) niet wordt gebruikt. Aan de andere kant zijn ze allemaal relatief goedkoop. Voor ons is dit de andere extremiteit, vergeleken met het eerder gebruikte Icinga. In dat systeem was het toevoegen van metrics bijzonder pijnlijk: de bestaande waren duur (alleen maar de broncode van een plugin bekijken is genoeg). Elke plugin was een script in Bash of Python, waarvan de uitvoering niet goedkoop is qua middelen.
- Dit systeem verbruikt relatief weinig middelen. Voor al onze metrics is 600 MB RAM, 15% van één kern en een paar tientallen IOPS voldoende. Natuurlijk moeten we exporters voor de metrics draaien, maar die zijn allemaal in Go geschreven en zijn ook niet bijzonder resource-intensief. Ik denk niet dat dit een probleem is in de huidige realiteit.
- Maakt overgang naar Kubernetes mogelijk. Gezien de plannen van de klant is de keuze voor de hand liggend.
ELK
Vroeger verzamelden en verwerkten we geen logs. De nadelen zijn voor iedereen duidelijk. We kozen voor ELK, omdat we al ervaring met dit systeem hadden. We bewaren daar alleen de logs van applicaties. De belangrijkste selectiecriteria waren full-text search en de snelheid daarvan.
Clickhouse
Aanvankelijk viel de keuze op InfluxDB. We waren ons bewust van de noodzaak om logs van Nginx te verzamelen, statistieken uit pg_stat_statements en historische gegevens van Prometheus op te slaan. We vonden Influx niet prettig, omdat het af en toe veel geheugen begon te verbruiken en vastliep. Bovendien wilden we verzoeken groeperen op remote_addr, maar groeperen in deze database is alleen mogelijk op tags. Tags zijn duur (geheugen) en hun aantal is voorwaardelijk beperkt.
We begonnen de zoektocht opnieuw. We hadden een analytische database nodig met minimaal middelenverbruik, bij voorkeur met gegevenscompressie op schijf.
Clickhouse voldoet aan al deze criteria, en we hebben onze keuze nooit betreurd. We schrijven geen opmerkelijke hoeveelheden gegevens naar deze database (het aantal inserties is ongeveer vijfduizend per minuut).
NewRelic
NewRelic is historisch gezien bij ons, omdat het de keuze van de klant was. Het wordt door ons gebruikt als APM.
Zabbix
Wij gebruiken Zabbix uitsluitend voor het monitoren van Black Box verschillende API's.
Het bepalen van de aanpak voor monitoring
We wilden de taak decomposeren en op die manier onze aanpak van monitoring systematiseren.
Daarom heb ik ons systeem in de volgende niveaus verdeeld:
- hardware en VMS;
- besturingssysteem;
- systeemdiensten, softwarestack;
- toepassing;
- bedrijfslogica.
Wat handig is aan deze aanpak:
- we weten wie verantwoordelijk is voor de werking van elk niveau en kunnen op basis daarvan waarschuwingen verzenden;
- we kunnen de structuur gebruiken bij het onderdrukken van waarschuwingen — het zou vreemd zijn om een waarschuwing voor een niet-beschikbare database te verzenden wanneer de hele virtuele machine niet beschikbaar is.
Omdat onze taak is om storingen in het systeem te detecteren, moeten we op elk niveau een bepaalde set metrics definiëren waarop we moeten letten bij het schrijven van alertregels. Laten we vervolgens de niveaus 'VMS', 'Besturingssysteem' en 'Systeemdiensten, softwarestack' doornemen.
Virtuele machines
Hosting maakt CPU, schijf, geheugen en netwerk voor ons vrij. En met de eerste twee hadden we problemen. Dus, metrics:
CPU stolen time — wanneer je een virtuele machine koopt op Amazon (bijvoorbeeld t2.micro), moet je begrijpen dat je niet een heel CPU-kern koopt, maar slechts een quotum van zijn tijd. En wanneer je dat opgebruikt, zullen ze je CPU beginnen af te nemen.
Deze metric stelt je in staat om dat soort momenten te volgen en beslissingen te nemen. Bijvoorbeeld, of je een zwaarder tarief moet nemen of de verwerking van achtergrondtaken en verzoeken in de API op verschillende de server.
IOPS + CPU iowait time — om de een of andere reden geven veel cloudhostingdiensten niet genoeg IOPS. Bovendien is een grafiek met lage IOPS voor hen geen argument. Daarom is het verstandig om ook CPU iowait te verzamelen. Met dit paar grafieken — met lage IOPS en hoge I/O-wacht — kun je al met de hosting praten en het probleem oplossen.
Besturingssysteem
Metrics van het besturingssysteem:
- aantal beschikbare geheugen in %;
- activiteit van gebruik van swap: vmstat swapin, swapout;
- aantal beschikbare inode en vrije ruimte op het bestandssysteem in %
- gemiddelde belasting;
- aantal verbindingen in de toestand tw;
- vulling van de conntrack-tabel;
- de kwaliteit van het netwerk kan worden gemonitord met de utility ss, via het pakket iproute2 — het verkrijgen van de RTT-verbindingen uit de uitvoer en groeperen op dest-poort.
Ook op het niveau van het besturingssysteem krijgen we zo'n entiteit als processen. Het is belangrijk om een set processen in het systeem te identificeren die een belangrijke rol spelen in de werking ervan. Als je bijvoorbeeld meerdere pgpool hebt, is het noodzakelijk om informatie over elk van hen te verzamelen.
De set metrics is als volgt:
- CPU;
- geheugen - in de eerste plaats residentieel;
- IO - bij voorkeur in IOPS;
- FileFd - open en limiet;
- significante paginafouten - zo kun je begrijpen welke processen worden geswapt.
Alle monitoring is in Docker opgezet, voor het verzamelen van metrische gegevens gebruiken we Cadvisor. Op de andere machines gebruiken we process-exporter.
Systeemservices, softwarestack
Elk applicatie heeft zijn eigen specificiteit, en het is moeilijk om een bepaalde set metrics te выделить.
De universele set bestaat uit:
- verzoekrate;
- aantal fouten;
- latentietijd;
- saturatie.
De meest opvallende voorbeelden van monitoring op dit niveau zijn voor ons - Nginx en PostgreSQL.
De meest belaste service in ons systeem is de database. Vroeger hadden we vaak problemen met het begrijpen waar de database mee bezig was.
We zagen hoge belasting op de schijven, maar de slow logs gaven niet veel informatie. Dit probleem hebben we opgelost met pg_stat_statements, een weergave waarin statistieken over verzoeken worden verzameld.
Dit is alles wat de admin nodig heeft.
We bouwen grafieken van de lees- en schrijfactiviteit:
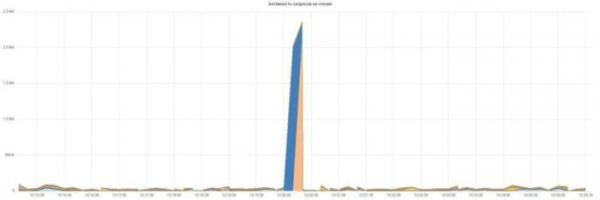
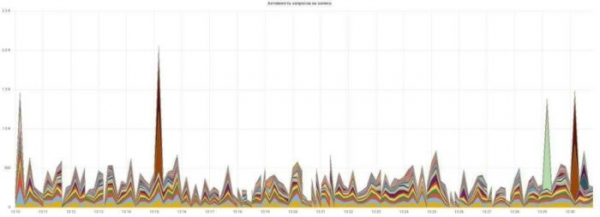
Alles is eenvoudig en duidelijk, elke aanvraag heeft zijn eigen kleur.
Een niet minder opvallend voorbeeld zijn de Nginx-logs. Het is niet verrassend dat weinig mensen ze parseren of ze in de lijst van vereisten opnemen. Het standaardformaat is niet erg informatief en moet worden uitgebreid.
Persoonlijk heb ik request_time, upstream_response_time, body_bytes_sent, request_length, request_id toegevoegd. We bouwen grafieken van responstijden en het aantal fouten:
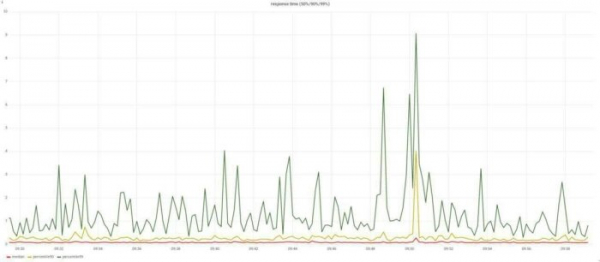
We bouwen grafieken van responstijden en het aantal fouten. Herinner je je dat ik over de zakelijke taken sprak? Om snel en zonder fouten? Met twee grafieken hebben we deze vragen al beantwoord. En we kunnen de on-call admins daarover al bellen.
Maar er bleef nog een probleem over - ervoor zorgen dat de oorzaken van incidenten snel worden verholpen.
Incidentverwerking
Het hele proces van identificatie tot oplossing van een probleem kan worden opgedeeld in een aantal stappen:
- problemen identificeren;
- de on-call administrator informeren;
- reageren op het incident;
- oorzaken verhelpen.
Het is belangrijk dat we dit zo snel mogelijk doen. En als we bij de stappen van probleemidentificatie en het versturen van de melding niet veel tijd kunnen winnen - deze zullen hoe dan ook twee minuten duren, dan is er veel ruimte voor verbetering in de daaropvolgende stappen.
Laten we ons gewoon voorstellen dat de telefoon van de wachtende dienst rinkelt. Wat zal hij doen? Antwoorden zoeken op de vragen – wat is er kapot, waar is het kapot, hoe te reageren? Dit is hoe we deze vragen beantwoorden:
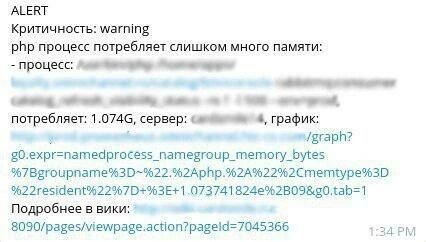
We voegen gewoon al deze informatie toe aan de tekst van de melding en geven daarin een link naar de wiki-pagina waar wordt beschreven hoe op dit probleem te reageren, hoe het op te lossen en te escaleren.
Ik heb tot nu toe niets gezegd over de applicatielaag en de zakelijke logica. Helaas hebben we in onze applicaties nog geen metrische gegevens verzameld. De enige bron van enige informatie van deze lagen zijn de logbestanden.
Een paar punten.
Ten eerste, schrijf gestructureerde logs. Inclusief de context in de tekst van het bericht is niet nodig. Dit bemoeilijkt de groepering en analyse. Logstash kost veel tijd om dit te normaliseren.
Ten tweede, gebruik de severity-niveaus correct. Elke taal heeft zijn eigen standaard. Persoonlijk onderscheid ik vier niveaus:
- geen fouten;
- fout aan de klantzijde;
- fout aan onze zijde, we verliezen geen geld, we lopen geen risico's;
- fout aan onze zijde, we verliezen geld.
Samenvattend. We moeten proberen de monitoring op basis van zakelijke logica op te bouwen. Probeer de applicatie zelf te monitoren en te werken met metrics zoals het aantal verkopen, het aantal nieuwe gebruikersregistraties, het aantal actieve gebruikers op dat moment, enzovoorts.
Als uw hele bedrijf slechts één knop in de browser is, moet u monitoren of deze wordt ingedrukt en goed werkt. Alles eromheen is niet belangrijk.
Als u dit niet heeft, kunt u proberen dit in de logbestanden van de applicatie, Nginx-logs, enzovoorts in te halen, zoals wij hebben gedaan. U moet zo dicht mogelijk bij de applicatie zijn.
Metrieken van het besturingssysteem zijn natuurlijk belangrijk, maar voor het bedrijf zijn ze niet interessant; we worden daar niet voor betaald.
Bron: habr.com
