

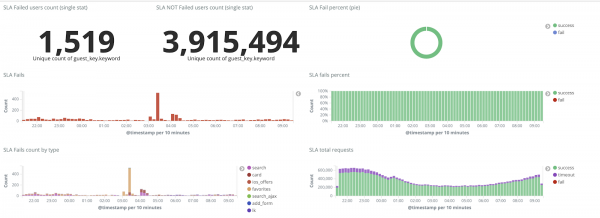
Hallo iedereen, mijn naam is Alexander, ik werk als ingenieur bij CIAN en houd me bezig met systeembeheer en de automatisering van infrastructuurprocessen. In de opmerkingen bij een van de eerdere artikelen vroegen ze ons te vertellen waar we dagelijks 4 TB logs vandaan halen en wat we ermee doen. Ja, we hebben veel logs, en voor hun verwerking hebben we een aparte infrastructuurcluster opgezet, die ons in staat stelt om problemen snel op te lossen. In dit artikel zal ik beschrijven hoe we het afgelopen jaar deze cluster hebben aangepast om om te gaan met de voortdurend groeiende datastroom.
Waar we mee zijn begonnen
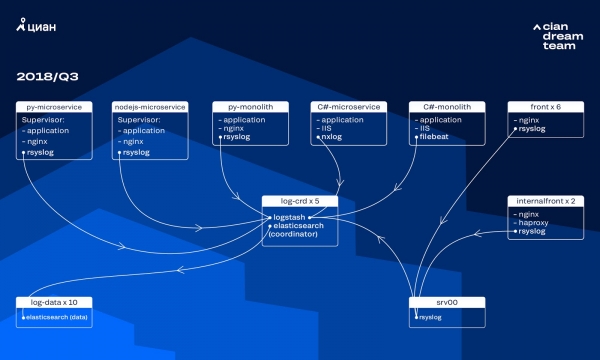
De afgelopen jaren groeide de druk op cian.ru zeer snel, en tegen het derde kwartaal van 2018 bereikte het aantal unieke gebruikers op de site 11,2 miljoen per maand. In kritieke momenten verloren we toen tot 40% van de logs, waardoor we niet snel op incidenten konden reageren en we veel tijd en moeite verloren bij het oplossen ervan. Bovendien konden we vaak de oorzaak van het probleem niet vinden, waardoor het zich na enige tijd weer voordeed. Dit was een hel waar we iets mee moesten doen.
Op dat moment gebruikten we een cluster van 10 data-nodes met ElasticSearch versie 5.5.2 met standaardindexinstellingen om logs op te slaan. Het werd meer dan een jaar geleden geïmplementeerd als een populaire en toegankelijke oplossing: toen was de stroom logs nog niet zo groot, dus er was geen reden om niet-standaard configuraties te bedenken.
De verwerking van binnenkomende logs werd verzorgd door Logstash op verschillende poorten op vijf ElasticSearch-coördinatoren. Eén index, ongeacht de grootte, bestond uit vijf shards. Er was een uurlijkse en dagelijkse rotatie georganiseerd, waardoor er elk uur ongeveer 100 nieuwe shards in de cluster verschenen. Zolang er nog niet al te veel logs waren, kon de cluster het aan en hadden we niemand aandacht besteed aan de instellingen.
Problemen van snelle groei
De hoeveelheid gegenereerde logs groeide zeer snel, omdat er zich twee processen op elkaar stapelden. Enerzijds nam het aantal gebruikers van de service toe. Anderzijds begonnen we actief over te stappen op een microservicesarchitectuur, waarbij we onze oude monolieten in C# en Python opsplitsten. Enkele tientallen nieuwe microdiensten die delen van de monoliet vervingen, genereerden aanzienlijk meer logs voor de infrastructuurcluster.
De schaling heeft ons ertoe geleid dat het cluster bijna onbeheerbaar werd. Toen de logs binnenkwamen met een snelheid van 20.000 berichten per seconde, verhoogde de frequente nutteloze rotatie het aantal shards tot 6.000, waardoor er meer dan 600 shards op één node kwamen.
Dit leidde tot problemen met de toewijzing van RAM, en bij een falende node begon een gelijktijdige verplaatsing van alle shards, wat het verkeer vermenigvuldigde en de andere nodes belastte, waardoor het praktisch onmogelijk werd om gegevens in het cluster te schrijven. En in deze periode waren we zonder logs. Bij een probleem met server verlozen we in principe 1/10 van het cluster. Het grote aantal kleine indexen voegde extra complicaties toe.
Zonder logs begrepen we de redenen voor het incident niet en konden we vroeg of laat weer in dezelfde val trappen, wat in de ideologie van ons team onacceptabel was, omdat al onze werkmechanismen gericht zijn op het tegenovergestelde — nooit dezelfde problemen opnieuw tegenkomen. Hiervoor hadden we een compleet volume aan logs nodig en de levering ervan bijna in realtime, aangezien het team van waakzame ingenieurs alert was op meldingen, niet alleen van metingen, maar ook van logs. Ter verduidelijking van de omvang van het probleem: op dat moment bedroeg het totale volume aan logs ongeveer 2 TB per dag.
We stelden ons een doel: volledig verlies van logs uitsluiten en de tijd voor levering aan het ELK-cluster tot maximaal 15 minuten verkorten in geval van noodsituaties (op deze cijfers baseerden we ons later als interne KPI).
Nieuwe rotatiemechanisme en hot-warm nodes
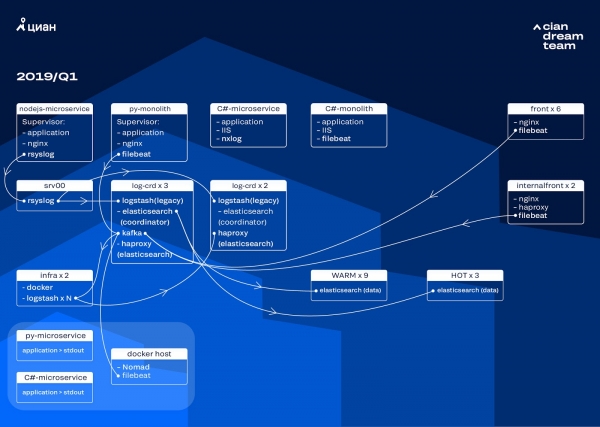
We begonnen de transformatie van het cluster met het upgraden van de versie van ElasticSearch van 5.5.2 naar 6.4.3. Ons cluster van versie 5 viel weer uit, en we besloten het af te sluiten en volledig te upgraden — er waren immers geen logs. Dit overgangsproces hebben we in een paar uur gerealiseerd.
De grootste transformatie in deze fase was de implementatie van Apache Kafka op drie nodes met een coördinator als tussenbuffer. De berichtbroker heeft ons geholpen om logverliezen te vermijden tijdens problemen met ElasticSearch. Tegelijkertijd hebben we 2 nodes aan de cluster toegevoegd en zijn we overgestapt op een hot-warm architectuur met drie 'hete' nodes, verspreid over verschillende rekken in het datacenter. Hierop hebben we op basis van een patroon de logs doorgeleid die we absoluut niet konden verliezen — nginx en de foutlogs van applicaties. De overige logs gingen naar de minder belangrijke nodes — debug, warning, enzovoort, en na 24 uur werden de 'belangrijke' logs van de 'hete' nodes verplaatst.
Om het aantal kleine indexen niet te laten toenemen, zijn we overgestapt van tijdrotatie naar een rollover-mechanisme. Op forums was er veel informatie dat rotatie op basis van indexgrootte erg onbetrouwbaar was, dus besloten we om rotatie op basis van het aantal documenten in de index te gebruiken. We hebben elke index geanalyseerd en vastgesteld hoeveel documenten nodig waren voordat de rotatie plaatsvond. Zo hebben we de optimale shard-grootte bereikt — niet meer dan 50 GB.
Clusteroptimalisatie
Echter, we waren niet volledig van de problemen af. Helaas bleven er toch kleine indexen bestaan: ze bereikten niet het vereiste volume, werden niet geroteerd en werden door een globale opschoning van indexen ouder dan drie dagen verwijderd, omdat we de rotatie op datum hebben verwijderd. Dit leidde tot gegevensverlies omdat de index volledig uit de cluster verdween, en de poging tot schrijven naar een niet-bestaande index de logica van de curator die we gebruikten voor beheer verstoorde. De alias voor schrijven werd omgevormd tot een index en verstoorde de logica van de rollover, wat leidde tot een ongecontroleerde groei van sommige indexen tot 600 GB.
Bijvoorbeeld, voor de rotatieconfiguratie:
curator-elk-rollover.yaml

---
actions:
  1:
    action: rollover
    options:
      name: "nginx_write"
      conditions:
        max_docs: 100000000
  2:
    action: rollover
    options:
      name: "python_error_write"
      conditions:
        max_docs: 10000000
Bij afwezigheid van rollover-alias trad de fout op:
ERROR     alias "nginx_write" not found.
ERROR     Failed to complete action: rollover.  <type 'exceptions.ValueError'>: Unable to perform index rollover with alias "nginx_write".
We left the solution to this problem for the next iteration and focused on another issue: we switched to a pull logic for Logstash, which handles the processing of incoming logs (removing unnecessary information and enrichment). We placed it in Docker, which we run via Docker Compose, and we also set up the logstash-exporter there, which sends metrics to Prometheus for real-time monitoring of the log stream. This allowed us to smoothly change the number of Logstash instances responsible for processing each type of log.
While we were improving the cluster, traffic to cian.ru grew to 12.8 million unique users per month. As a result, our transformations slightly lagged behind changes in production, and we faced the issue that the 'warm' nodes could not handle the load, slowing down the entire log delivery process. We received 'hot' data without failures, but we had to manually intervene in the delivery of others and perform a manual rollover to evenly distribute the indices.
At the same time, scaling and adjusting the configurations of Logstash instances in the cluster was complicated by the fact that this was a local Docker Compose setup, and all actions were performed manually (to add new endpoints, it was necessary to manually go through all servers and run docker-compose up -d everywhere).
Redistribution of logs
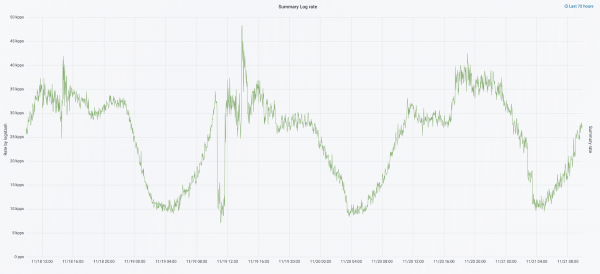
In September of this year, we were still continuing to dismantle the monolith, the load on the cluster was increasing, and the log flow was approaching 30,000 messages per second.
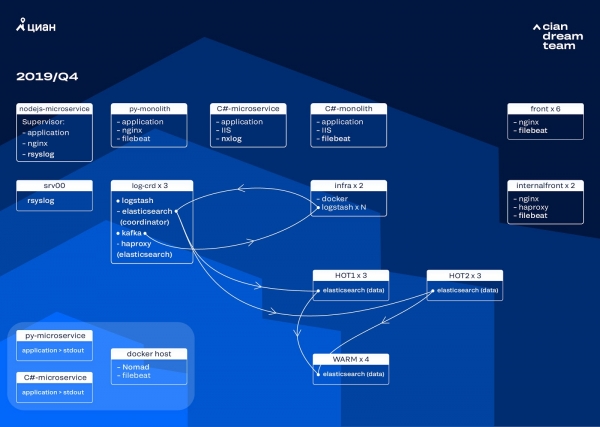
We began the next iteration with an upgrade of the hardware. We reduced from five coordinators to three, replaced the data nodes, and achieved savings in both cost and storage volume. For the nodes, we use two configurations:
- For 'hot' nodes: E3-1270 v6 / 960Gb SSD / 32 Gb x 3 x 2 (3 for Hot1 and 3 for Hot2).
- For 'warm' nodes: E3-1230 v6 / 4Tb SSD / 32 Gb x 4.
In this iteration, we moved the index with access logs of microservices, which occupies as much space as the logs from the front-end Nginx, to the second group of three 'hot' nodes. We now store data on 'hot' nodes for 20 hours, after which we transfer it to 'warm' nodes along with the other logs.
Wij hebben het probleem van het verdwijnen van kleine indexen opgelost door hun rotatie opnieuw in te stellen. Nu worden de indexen in ieder geval elke 23 uur geroteerd, zelfs als daar weinig data is. Dit heeft het aantal shards iets verhoogd (er zijn nu ongeveer 800), maar vanuit het oogpunt van de prestaties van het cluster is dit aanvaardbaar.
Als gevolg hiervan hebben we zes 'hot' en slechts vier 'warm' nodes in het cluster. Dit veroorzaakt een kleine vertraging bij verzoeken over lange tijdsintervallen, maar een toename van het aantal nodes in de toekomst zal dit probleem oplossen.
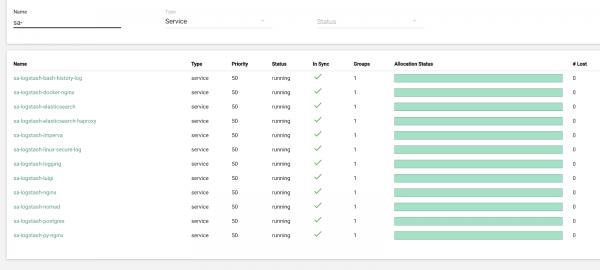
In deze iteratie hebben we ook het probleem van het ontbreken van semi-automatische schaling opgelost. Hiervoor hebben we een infrastructuur-Nomad-cluster uitgerold, vergelijkbaar met datgene dat al in onze productieomgeving is uitgerold. Tot nu toe verandert het aantal Logstash-instanties automatisch nog niet op basis van de belasting, maar daar zullen we ook aan werken.
Toekomstplannen
De gerealiseerde configuratie schaalt uitstekend en momenteel slaan we 13,3 TB aan data op - alle logs over een periode van 4 dagen, wat noodzakelijk is voor urgente analyse van alerts. Een deel van de logs transformeren we naar metrics, die we opslaan in Graphite. Om het werk van de ingenieurs te vergemakkelijken, hebben we metrics voor het infrastructuurcluster en scripts voor semi-automatische reparatie van veelvoorkomende problemen. Na de verhoging van het aantal data-nodes, die gepland staat voor volgend jaar, zullen we de opslagperiode van data uitbreiden van 4 naar 7 dagen. Dit is voldoende voor een effectieve werking, omdat we altijd proberen incidenten zo snel mogelijk te onderzoeken, terwijl we voor langdurige onderzoeken afhankelijk zijn van telemetriegegevens.
In oktober 2019 groeide de bezoekersaantallen van cian.ru al tot 15,3 miljoen unieke gebruikers per maand. Dit was een serieuze test voor de architecturale oplossing voor het leveren van logs.
Momenteel bereiden we ons voor op de update van ElasticSearch naar versie 7. Echter, hiervoor moeten we de mapping van veel indexen in ElasticSearch bijwerken, aangezien ze zijn overgezet van versie 5.5 en als deprecated zijn gemarkeerd in versie 6 (in versie 7 zijn ze gewoon niet meer aanwezig). Dit betekent dat er tijdens het updateproces ongetwijfeld een overmachtsituatie zal optreden, waardoor we tijdelijk zonder logs komen te zitten. Van versie 7 verwachten we vooral Kibana met een verbeterde interface en nieuwe filters.
We have achieved our main goal: we stopped losing logs and reduced infrastructure cluster downtime from 2-3 incidents per week to a couple of hours of maintenance per month. All this work in production is almost unnoticed. However, now we can accurately determine what is happening with our service, quickly do this in a calm manner, and not worry about losing logs. Overall, we are satisfied, happy, and preparing for new achievements that we will share later.
Bron: habr.com
