

Iedereen houdt van verhalen. We zitten graag bij het kampvuur en vertellen over onze eerdere overwinningen, gevechten of gewoon over onze werkervaring.
Vandaag is zo'n dag. En hoewel je misschien niet bij het kampvuur zit, hebben we toch een verhaal voor je. Een verhaal over hoe we begonnen te werken met opslag in Tarantool.
Lang geleden had ons bedrijf een paar 'monolieten' en één gezamenlijke 'plafond' waaraan deze monolieten langzaam maar zeker naderden, waardoor de groei van ons bedrijf beperkt werd. En er was duidelijk begrip: op een dag zouden we hard tegen dat plafond oplopen.
Tegenwoordig heerst de ideologie van het splitsen van alles en nog wat, van apparatuur tot bedrijfslogica. Hierdoor hebben we bijvoorbeeld twee datacenters die op netwerkniveau praktisch onafhankelijk zijn. Toen was alles echter heel anders.
Tegenwoordig zijn er tal van tools en middelen beschikbaar voor wijzigingen zoals CI/CD, K8S, enzovoort. In de 'monolithische' tijd hadden we echter niet zoveel vreemde woorden nodig. Het was voldoende om gewoon de 'database' aan te passen.
Maar de tijd ging vooruit en het aantal verzoeken nam gelijktijdig toe, met RPS die soms onze mogelijkheden overstegen. Toen we de markt in de GOS-landen betreden, bleef de belasting op de database-processor van de eerste monolith onder de 90% en de RPS bleef rond de 2400. Dit waren niet zomaar kleine selecties, maar grote verzoeken met talrijke controles en JOINs die bijna door de helft van de gegevens moesten lopen met een hoge IO.
Toen er echte uitverkoopdagen tijdens 'Black Friday' begonnen te verschijnen, en Wildberries een van de eersten in Rusland was die dit deed, werd de situatie nog treuriger. Tijdens zulke dagen verhoogt de belasting namelijk met drie keer.
Oh, die 'monolithische tijden'! Ik weet zeker dat jullie soortgelijke situaties hebben meegemaakt en nog steeds niet begrijpen hoe dit jullie kon overkomen.
Wat moet je doen? Mode is ook inherent aan technologieën. Vijf jaar geleden moesten we een van deze trends heroverwegen in de vorm van een bestaande website op .NET en MS SQL-server, die de hele logica van de website zorgvuldig bewaarde. Hij bewaarde het zo zorgvuldig dat het opsplitsen van zo'n monoliet een langdurige en uiterst ingewikkelde onderneming bleek te zijn.
Een kleine opmerking.
Bij verschillende evenementen zeg ik: "als je de monolith niet hebt opgedeeld, ben je niet gegroeid!" Ik ben benieuwd naar jouw mening hierover, laat deze alsjeblieft achter in de reacties.
En daar kwam de donder.
Laten we terugkeren naar onze 'kachel'. Om de belasting van de 'monolithische' functionaliteit te verdelen, hebben we besloten het systeem op te splitsen in microservices gebaseerd op opensource-technologieën. Want, om te beginnen, zijn ze goedkoper schaalbaar. En we waren ons er 100% van bewust dat we moesten schalen (en dat zou niet weinig zijn). Want op dat moment hadden we al markten in buurlanden bereikt, en het aantal registraties, evenals het aantal bestellingen, begon nog sterker te groeien.
Na het analyseren van de eerste kandidaten voor de overgang van de monolith naar microservices, begrepen we dat 80% van de gegevens in hen voor 99% uit backoffice-systemen komen, terwijl de leesoperaties uit de frontlinie komen. Dit betrof in de eerste plaats een paar belangrijke subsystemen voor ons — gebruikersgegevens en het systeem voor de berekening van de uiteindelijke kosten van producten op basis van informatie over aanvullende klantkortingen en coupons.
Terzijde. Het is eng voor te stellen, maar naast de hierboven genoemde subsystemen werden ook productcatalogi, de gebruikersmand, het systeem voor productzoekopdrachten, het filtersysteem voor productcatalogi en verschillende aanbevelingssystemen uit onze monolith gehaald. Voor elk van hen zijn er aparte klassen van smal gerichte systemen, maar ooit leefden ze allemaal in één ‘huisje’.
We planden direct om klantgegevens onder te brengen in een geshard systeem. De functionaliteit voor het berekenen van de uiteindelijke kosten van producten vereiste echter goede schaalbaarheid voor leesoperaties, omdat dit de grootste belasting op RPS creëerde en het het moeilijkst uit te voeren was voor de database (erg veel gegevens zijn betrokken bij het rekenproces).
Als gevolg hiervan ontstond er een schema dat goed samengaat met Tarantool.
In die tijd werden voor de werking van de microservices schema's gekozen die werkten met meerdere datacenters op virtuele en fysieke machines. Zoals weergegeven in de afbeeldingen, werden er replicatievarianten van Tarantool toegepast, zowel in master-master modus als master-slave.
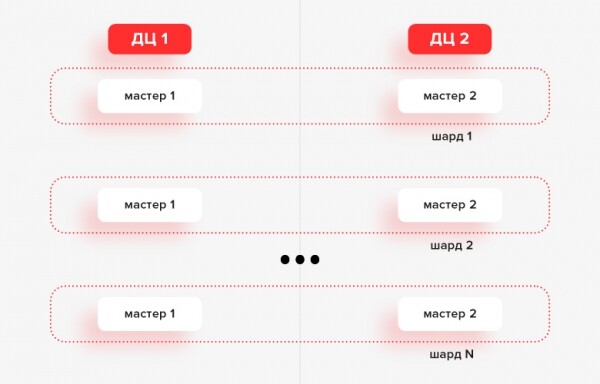
Architectuur. Optie 1. Gebruikersservice.
Op dit moment zijn er 24 shards, elk met 2 instanties (één in elk datacenter), allemaal in master-master modus.
Boven de database bevinden zich applicaties die toegang hebben tot de database-replicas. De applicaties communiceren met Tarantool via onze aangepaste bibliotheek, die de interface van de Go-driver voor Tarantool implementeert. Deze ziet alle replicas en kan met de master werken voor zowel lezen als schrijven. In feite implementeert het een replica set-model, waarin logica voor replica-selectie, retry-beleid, circuit breaker en rate limiting is toegevoegd.
Daarnaast is het mogelijk om het beleid voor het selecteren van replicas per shard te configureren. Bijvoorbeeld met round-robin.
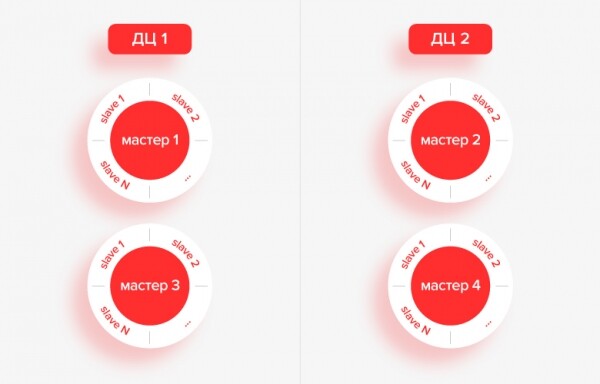
Architectuur. Optie 2. Dienst voor het berekenen van de uiteindelijke prijs van een product.
Enkele maanden geleden verplaatst een groot deel van de verzoeken voor het berekenen van de uiteindelijke prijs van producten naar een nieuwe dienst, die in principe zonder databases werkt, maar een tijd geleden werden al deze 100% verwerkt door de Tarantool-service op de achtergrond.
De database van de dienst bestaat uit 4 masters, waarin de synchronisator gegevens verzamelt, en elke master distribueert gegevens naar readonly-replicas via replicatie. Elke master heeft ongeveer 15 van zulke replicas.
In zowel het eerste als het tweede schema, wanneer één datacenter niet beschikbaar is, kan de applicatie gegevens ontvangen uit het tweede datacenter.
Het is vermeldenswaard dat replicatie in Tarantool vrij flexibel is en in runtime kan worden geconfigureerd. In andere systemen kunnen er complicaties optreden. Bijvoorbeeld, het wijzigen van de parameters max_wal_senders en max_replication_slots in PostgreSQL vereist een herstart van de master, wat in sommige gevallen kan leiden tot verbroken verbindingen tussen de applicatie en de database.
Zoek en gij zult vinden!
Waarom hebben we het niet op de 'normale manier' gedaan, maar voor een ongewone aanpak gekozen? Wat als normaal wordt beschouwd, hangt af van de definitie. Veel mensen maken überhaupt een cluster van Mongo en verspreiden het over drie geografisch verspreide datacenters.
In die tijd hadden we al twee projecten op Redis. De eerste was een cache, en de tweede fungeerde als een persistentie-opslag voor minder kritische gegevens. Dit veroorzaakte echter enige problemen, deels door onze eigen schuld. Soms stonden er behoorlijk grote hoeveelheden in de sleutel, en af en toe ging het niet goed met de site. We gebruikten dit systeem in een master-slave-configuratie. En er waren veel gevallen waarin er iets met de master gebeurde en de replicatie faalde.
Redis is geschikt voor stateless-taken en niet voor stateful-taken. In principe kon het de meeste taken oplossen, maar alleen als het ging om key-value-oplossingen met een paar indexen. Echter, Redis had toen nogal wat problemen met persistentie en replicatie. Bovendien waren er klachten over de prestaties.
We hebben gedacht aan MySQL en PostgreSQL. Maar de eerste heeft niet echt bij ons gewerkt, en de tweede is op zichzelf een vrij geavanceerd product, waardoor het niet praktisch zou zijn om hiermee eenvoudige services te bouwen.
We hebben RIAK, Cassandra, en zelfs grafische databases geprobeerd. Dit zijn allemaal redelijk niche-oplossingen die niet geschikt waren als algemeen veelzijdig instrument voor het creëren van services.
Uiteindelijk hebben we gekozen voor Tarantool.
We hebben het aangesproken toen het in versie 1.6 was. Wat ons aantrok was de symbiose van key-value en de functionaliteit van een relationele database. Er zijn secundaire indexen, transacties en spaces, dat zijn net tabellen, maar niet simpel; je kunt verschillende aantallen kolommen opslaan. Maar de belangrijkste functie van Tarantool waren de secundaire indexen gecombineerd met key-value en transactionele mogelijkheden.
Ook speelde de responsieve Nederlandstalige gemeenschap een rol, die bereid was om in de chat hulp te bieden. We hebben hiervan actief gebruikgemaakt en leefden werkelijk in de chat. En laten we vooral de behoorlijke persistentie met minimale fouten niet vergeten. Als we onze geschiedenis met Tarantool bekijken, hebben we veel pijn en problemen gehad met replicatie, maar we hebben nooit gegevens verloren door zijn schuld!
De implementatie begon moeizaam.
Op dat moment was onze belangrijkste ontwikkelstack .NET, waarvoor er geen connector voor Tarantool was. We zijn meteen begonnen met iets op Go. Met Lua ging het ook redelijk goed. Het grootste probleem toen was de debugging: .NET was hierin geweldig, maar daarna in de wereld van embedded Lua duiken, waar je, behalve logs, geen debugging hebt, was uitdagend. Bovendien viel de replicatie soms uit, waardoor het noodzakelijk was om dieper in de opbouw van de Tarantool-engine te duiken. De chat hielp hierbij, en in mindere mate de documentatie; soms keken we naar de code. Op dat moment was de documentatie niet geweldig.
Zo hebben we enkele maanden ervaring opgedaan en waardige resultaten geboekt met Tarantool. We hebben de standaardontwikkelingen in git vastgelegd, die hielpen bij het opzetten van nieuwe microservices. Bijvoorbeeld, wanneer er een taak opdook: maak weer een microservice, dan keek de ontwikkelaar naar de broncode van de standaardoplossing in de repository, en het maken van een nieuwe kostte niet meer dan een week.
Het waren bijzondere tijden. In die tijd kon je naar de admin aan de naastgelegen tafel gaan en vragen: "Geef me een virtual machine". Na ongeveer dertig minuten had je de machine al. Je verbond zelf, installeerde alles en ze stuurden verkeer naar je toe.
Vandaag de dag gaat dat niet meer zo: je moet monitoring, logging instellen, functionaliteit testen, een virtual machine of levering in Kubernetes aanvragen enzovoorts. Over het geheel genomen zal dat beter zijn, hoewel het langer duurt en meer gedoe met zich meebrengt.
Verdeel en heers. Hoe gaat het met Lua?
Er was een serieuze dilemma: sommige teams kregen het niet voor elkaar om veranderingen betrouwbaar uit te rollen in de service met veel logica op Lua. Vaak leidde dit tot het niet functioneren van de service.
Dat wil zeggen, de ontwikkelaars bereiden een wijziging voor. Tarantool begint met de migratie, terwijl de replica nog de oude code heeft; daar komt via replicatie een of andere DDL binnen, nog wat anders, en de code valt gewoon uit elkaar omdat dit niet in overweging is genomen. Als gevolg daarvan was de updateprocedure voor de admins op een A4-tje geschreven: stop de replicatie, werk dit bij, zet de replicatie weer aan, stop hier, werk daar bij. Een nachtmerrie!
Uiteindelijk proberen we nu meestal om niets op Lua te doen. Gewoon met iproto (binaire protocol voor interactie met de server), en dat is alles. Misschien is het een gebrek aan kennis bij de ontwikkelaars, maar vanuit dat perspectief is het systeem complex.
We volgen dit scenario niet altijd blindelings. Vandaag de dag hebben we geen zwart-wit meer: of alles is op Lua, of alles is op Go. We begrijpen al hoe we dingen kunnen combineren om later geen migratieproblemen te krijgen.
Waar is Tarantool nu aanwezig?
Tarantool wordt gebruikt in de dienst voor het berekenen van de uiteindelijke prijs van producten met inachtneming van kortingsbonnen, ook wel de "Promotizer" genoemd. Zoals eerder vermeld, wordt hij momenteel vervangen: er is een nieuwe catalogusdienst met vooraf berekende prijzen. Maar nog een half jaar geleden werden alle berekeningen uitgevoerd in de "Promotizer". Eerder was de helft van zijn logica geschreven in Lua. Twee jaar geleden werd de dienst een opslag en werd de logica herschreven in Go, omdat de mechanics van kortingen enigszins veranderd zijn en de dienst niet genoeg prestaties had.
Een van de meest kritische diensten is het gebruikersprofiel. Dit betekent dat alle gebruikers van Wildberries zijn opgeslagen in Tarantool, en dat zijn er ongeveer 50 miljoen. Een geshard systeem op gebruikers-ID, verspreid over verschillende datacenters met Go-diensten eromheen.
Vroeger was "Promotizer" de leider qua RPS, met maximaal 6.000 verzoeken. Op een gegeven moment hadden we 50-60 exemplaren. Tegenwoordig is de leider qua RPS het gebruikersprofiel, met ongeveer 12.000. In deze dienst wordt een aangepaste shardering toegepast met splitsing op basis van gebruikers-ID-ranges. De dienst bedient meer dan 20 machines, maar dat is te veel; we zijn van plan de toegewezen middelen te verminderen, omdat 4-5 machines voldoende capaciteit kunnen bieden.
De sessiedienst is onze eerste dienst op vshard en Cartridge. Het opzetten van vshard en het updaten van Cartridge vereisten bepaalde inspanningen van ons, maar uiteindelijk is alles goed gekomen.
De dienst voor het weergeven van verschillende banners op de website en in de mobiele applicatie was een van de eerste die onmiddellijk op Tarantool werd uitgebracht. Deze dienst is opmerkelijk omdat hij al 6-7 jaar bestaat, nog steeds operationeel is en nooit opnieuw is opgestart. Master-master replicatie werd toegepast. Er is nooit iets kapot gegaan.
Er is een voorbeeld van het gebruik van Tarantool voor de functionaliteit van snelle gidsen in het magazijnsysteem, om bepaalde informatie snel te verifiëren. We probeerden hiervoor Redis te gebruiken, maar de gegevens in het geheugen namen meer ruimte in beslag dan in Tarantool.
Diensten voor wachtrijen, klantabonnementen, trendy stories en uitgestelde producten maken ook gebruik van Tarantool. De laatste dienst neemt ongeveer 120 GB in het geheugen in beslag. Dit is de meest omvangrijke dienst van de bovengenoemde.
Conclusie
Door secundaire indexen in combinatie met key-value en transactiecapaciteit is Tarantool uitstekend geschikt voor op microservices gebaseerde architecturen. We ondervonden echter moeilijkheden bij het doorvoeren van wijzigingen in diensten met veel logica in Lua - de diensten stopten vaak met werken. We zijn er niet in geslaagd dit op te lossen, en in de loop der tijd kwamen we tot verschillende combinaties van Lua en Go: we weten waar we de ene taal moeten gebruiken en waar de andere.
Wat verder te lezen over dit onderwerp
- Wij creëren vanaf nul een hoogbelast applicatie op Tarantool
- Betrouwbare keuze van de leider in Tarantool Cartridge
- Telegram-kanaal Tarantool met nieuws over het product
- Bespreek Tarantool in de community-chat
Bron: habr.com
